Kreditrisiko mit der Rimay Quantum Feature Extraction von Kipu Quantum klassifizieren
Qiskit Functions sind ein experimentelles Feature, das nur für Nutzer des IBM Quantum® Premium Plans, Flex Plans und On-Prem Plans (über die IBM Quantum Platform API) verfügbar ist. Sie befinden sich im Preview-Status und können sich ändern.
Geschätzte Nutzung: 2 Minuten auf einem Nighthawk-r2-Prozessor. (HINWEIS: Dies ist nur eine Schätzung. Deine Laufzeit kann abweichen.)
Lernziele
-
Tabellendaten mit kategorialen und numerischen Spalten für die Rimay Qiskit Function vorbereiten.
-
Eine Quanten-Feature-Abbildung auf Trainingsdaten anpassen und die Testdaten im selben Lauf abbilden.
-
Klassische Modelle auf quantentransformierten Features trainieren, allein und kombiniert mit den ursprünglichen Features.
-
Die Ergebnisse mit einer rein klassischen Baseline vergleichen.
Voraussetzungen
Bevor du dieses Tutorial beginnst, solltest du mit den folgenden Themen vertraut sein:
-
Überwachte Klassifikation mit scikit-learn
Hintergrund
Viele Probleme des maschinellen Lernens in der Industrie betreffen kleine bis mittelgroße tabellarische Datensätze, bei denen das Hinzufügen weiterer Daten keine Option ist und die Modellgenauigkeit stagniert. Die Kreditrisikobewertung ist ein typisches Beispiel. Ein Kreditgeber nutzt einige Dutzend Attribute, um zu entscheiden, ob der Antragsteller den Kredit voraussichtlich zurückzahlen wird.
Rimay, eine Qiskit Function von Kipu Quantum, fügt einer solchen Pipeline einen Quanten-Vorverarbeitungsschritt hinzu. Sie implementiert den Algorithmus der digitalisierten kontradiabatischen Quanten-Merkmalsextraktion [1]. Jedes Eingabemerkmal wird auf ein Qubit abgebildet. Die Merkmalswerte und die gegenseitige Information zwischen den Merkmalen legen die lokalen Felder und Kopplungen eines Spinglas-Hamiltonoperators fest. Die kontradiabatische Dynamik entwickelt das Quantensystem dann in Richtung seiner niederenergetischen Zustände, und die am Ende gemessenen Ein- und Zweikörper-Erwartungswerte werden zu den neuen, quantentransformierten Merkmalen. Diese Merkmale erfassen nichtlineare Korrelationen zwischen den Eingaben, und du kannst sie in jedes klassische Modell einspeisen.
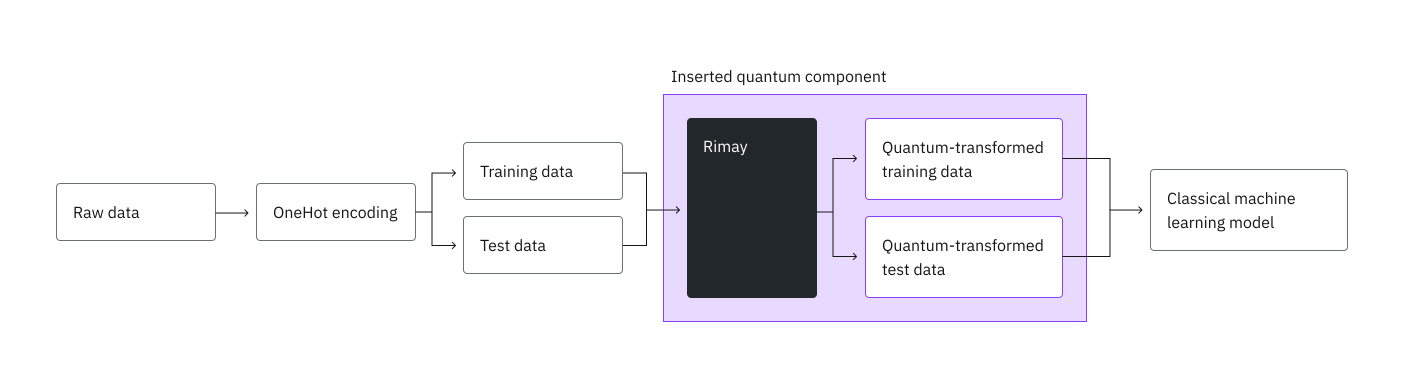
Dieses Tutorial verwendet den German-Credit-Datensatz von OpenML [2] mit 1000 Antragstellern und 20 Attributen, um einen Random-Forest-Klassifikator zu trainieren. Zuerst legst du eine klassische Baseline fest, dann sendest du die Daten an Rimay und trainierst schließlich dasselbe Modell auf den quantentransformierten Merkmalen, allein und kombiniert mit den ursprünglichen Merkmalen.
Voraussetzungen
Bevor du mit diesem Tutorial beginnst, stelle sicher, dass die folgenden Pakete installiert sind:
-
IBM Quantum Compute Client (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Du benötigst außerdem Zugriff auf die Rimay-Function aus dem Qiskit Functions Catalog.
Einrichtung
Importiere die Pakete und definiere zwei Hilfsfunktionen: eine, die einen Random Forest trainiert, und eine, die die im gesamten Tutorial verwendeten Metriken berechnet.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
IBM Quantum-Zugangsdaten konfigurieren
Authentifiziere dich mit deinem IBM Quantum Platform API-Schlüssel, lade die Rimay-Function und wähle den am wenigsten ausgelasteten Quantenprozessor, der für deine Instanz verfügbar ist.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Rimay bildet jedes numerische Eingabemerkmal auf ein Qubit ab, daher besteht der erste Schritt darin, die Rohtabelle in numerische Merkmale umzuwandeln.
Den Datensatz laden
Lade den German-Credit-Datensatz direkt von OpenML. Die Spalte class enthält das Label: good für Antragsteller, die ihren Kredit zurückgezahlt haben, und bad für diejenigen, die das nicht getan haben.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Die Merkmale kodieren
Wandle das Label in einen binären Wert um und kodiere die 13 kategorialen Spalten per One-Hot-Encoding. Der Code entfernt die erste Kategorie jeder Spalte, um redundante Merkmale zu vermeiden, was zu 48 numerischen Merkmalen führt.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
In Trainings- und Testdaten aufteilen
Halte 20 % der Antragsteller als Testdatensatz zurück. Eine stratifizierte Aufteilung sorgt dafür, dass der Anteil guter und schlechter Kredite in beiden Datensätzen gleich ist.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Eine klassische Baseline festlegen
Trainiere einen Random Forest auf den klassischen Merkmalen. In Schritt 4 vergleichst du die quantentransformierten Merkmale mit seinen Metriken.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Die Daten zu Rimay hochladen
Rimay liest seine Eingaben aus CSV-Dateien, die du zur Function hochlädst. Die Merkmale und die Labels kommen in separate Dateien. Du lädst auch den Testdatensatz hoch, damit Rimay ihn mit derselben Abbildung transformiert, die es auf dem Trainingsdatensatz anpasst.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Schritt 2: Das Problem für die Ausführung auf Quantenhardware optimieren
Rimay erstellt und transpiliert die Circuits für den von dir gewählten Prozessor, daher gibt es keinen Circuit, den du von Hand optimieren müsstest. Gib die Anzahl der Shots pro Circuit innerhalb der folgenden Einschränkungen an:
-
Jedes Merkmal benötigt ein Qubit, daher muss der Prozessor mindestens so viele Qubits haben, wie der Datensatz Merkmale hat.
-
Rimay führt einen Circuit pro Zeile aus, Trainings- und Testzeilen zusammen. Ein einzelner Job kann höchstens 10 Millionen Ausführungen anfordern, daher muss die Anzahl der Zeilen mal
shotsinnerhalb dieses Budgets bleiben.
Prüfe beide Grenzen, bevor du den Job absendest.
Ein Job muss außerdem innerhalb von 24 Stunden abgeschlossen sein, einschließlich der Zeit, die seine Circuits in der Warteschlange warten, sonst wird er ohne Ergebnis gestoppt.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Die Function-Größe berechnen
Jeder Job läuft mit einer Function-Größe, S, M oder L, die die Rechenressourcen auswählt, auf denen er läuft. Bei Rimay hängt die Größe von der Anzahl der Zeilen ab, die ein Job abbildet, Trainings- und Testzeilen zusammen. Wenn du eine zu kleine Größe anforderst, schlägt der Job mit dem Fehler 4600 fehl. Die Größen und ihre Grenzen findest du unter Function sizes im Rimay-Leitfaden.
Die folgende Zelle definiert den Größenrechner. Er läuft auf deinem Rechner, liest nur die Daten, die du ihm übergibst, und sendet nichts ab.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Übergib die Datensätze in derselben Reihenfolge wie die Dateien in input_file, zusammen mit dem Modus des Laufs:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Schritt 3: Mit Qiskit-Primitives ausführen
Führe Rimay im Modus fit-transform aus. Es passt eine quantenbasierte Merkmalsabbildung an x_train.csv und y_train.csv an und bildet damit sowohl den Trainings- als auch den Testdatensatz ab. Die Reihenfolge der Dateien in input_file ist wichtig. Gib zuerst die Trainingsmerkmale an, dann die Trainingslabels und schließlich die optionalen Testmerkmale. Übergib die Größe, die du berechnet hast, als function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Den Job überwachen
Prüfe den Status des Jobs, während er läuft. job.result() blockiert, bis der Job abgeschlossen ist.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Das Ergebnis enthält eine mapping_id, die die Abbildung identifiziert, die dieser Lauf angepasst hat. Du brauchst sie in diesem Tutorial nicht, weil der Testdatensatz im selben Lauf abgebildet wurde. Notiere dir diese ID, wenn du später neue Zeilen mit mode="transform" abbilden möchtest. Sie ist der einzige Weg, auf die angepasste Abbildung zuzugreifen, und ohne sie musst du eine neue anpassen und bezahlen. Die Abbildung wird für das Qubit-Layout dieses Prozessors erstellt, daher muss ein späterer transform-Lauf denselben backend_name übergeben.
mapping_id = result["mapping_id"]
Schritt 4: Nachverarbeiten und das Ergebnis im gewünschten klassischen Format zurückgeben
Die quantentransformierten Merkmale herunterladen
Lade die Dateien herunter, die der Job geschrieben hat, indem du die Namen in output_files verwendest. Jeder Name beginnt mit der Job-ID, sodass die Dateien dieses Laufs auch nach späteren Läufen verfügbar bleiben. Übergib target_name, damit jede Datei unter ihrem eigenen Namen gespeichert wird.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Auf den quantentransformierten Merkmalen trainieren
Trainiere einen Random Forest allein auf den quantentransformierten Merkmalen.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Auf klassischen und Quantenmerkmalen kombiniert trainieren
Stapele die ursprünglichen und die quantentransformierten Merkmale und trainiere dasselbe Modell auf der Kombination.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Die Ergebnisse vergleichen
Vergleiche die drei Modelle auf dem Testdatensatz.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

Die AUC misst, wie gut ein Modell gute Kredite über schlechte einstuft, unabhängig von einem Entscheidungsschwellenwert, und ist damit die aussagekräftigste Metrik für diesen unausgewogenen Datensatz (70 % gute Kredite). In den Benchmarks von Kipu Quantum erreichten die quantentransformierten Merkmale allein eine AUC, die der klassischen Baseline ähnelt, und das Hybridmodell, das beide kombiniert, erreichte die höchste AUC und den höchsten F1-Score. Die quantentransformierten Merkmale liefern also Informationen, die die klassischen Merkmale allein nicht bieten.
Aufräumen (optional)
Eine angepasste Abbildung bleibt verfügbar, bis du sie löschst. Wenn du keine weiteren Daten damit abbilden möchtest, lösche sie. Ein Löschen leistet keine Quantenarbeit, verbraucht keine QPU-Zeit und kann nicht rückgängig gemacht werden.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Fazit
Was du erreicht hast
In diesem Tutorial hast du Folgendes erreicht:
-
Einen realen Kreditrisiko-Datensatz mit kategorialen und numerischen Attributen für die Quanten-Merkmalsextraktion vorbereitet.
-
Eine klassische Random-Forest-Baseline festgelegt.
-
Rimay verwendet, um eine quantenbasierte Merkmalsabbildung auf Quantenhardware anzupassen und den Trainings- und den Testdatensatz in einem Lauf abzubilden.
-
Dasselbe Modell auf quantentransformierten und auf kombinierten Merkmalen trainiert und mit der Baseline verglichen.
Wichtigste Erkenntnisse
-
Rimay fügt sich als zusätzlicher Vorverarbeitungsschritt in eine bestehende Machine-Learning-Pipeline ein. Du behältst deine Datenaufbereitung und dein klassisches Modell.
-
Die Anzahl der Qubits begrenzt die Anzahl der Eingabemerkmale, und die Anzahl der Zeilen mal
shotsbegrenzt die Größe eines einzelnen Jobs. -
Verwende standardmäßig die quantentransformierten Merkmale kombiniert mit den ursprünglichen Merkmalen, weil das Modell beide nutzen kann.
Nächste Schritte
- Lies den Rimay-Leitfaden, um alle Eingaben kennenzulernen, neue Daten mit
mode="transform"abzubilden und weitere Benchmarks zu sehen. - Lies, wie die Quanten-Merkmalsextraktion auf die Klassifikation von Satellitenbildern angewendet wurde [3].
Referenzen
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.