Rimay Quantum Feature Extraction - eine Qiskit Function von Kipu Quantum
Siehe die API-Referenz.
Qiskit Functions sind eine experimentelle Funktion, die nur für Nutzer des IBM Quantum® Premium Plans, Flex Plans und On-Prem-Plans (über die IBM Quantum Platform API) verfügbar ist. Sie befinden sich im Preview-Status und können sich ändern.
Überblick
Rimay erweitert klassische Machine-Learning-Pipelines um Features, die auf Quantenhardware erzeugt werden. Die Function nimmt klassische tabellarische Daten entgegen und gibt eine Menge quantentransformierter Features zurück. Wenn ein Quantensystem die Daten verarbeitet, erzeugt es reichhaltige Features, die nichtlineare Zusammenhänge zwischen den Eingaben erfassen. Du kannst die erzeugten Features allein oder zusammen mit deinen ursprünglichen Features verwenden, um ein beliebiges klassisches Modell zu trainieren. Bei kleinen und mittelgroßen Datensätzen können quantentransformierte Features die Vorhersagequalität im Vergleich zu rein klassischen Baselines verbessern.
Diese Function ist für die folgenden Nutzer gedacht:
-
Data-Science-Teams mit einer bestehenden Machine-Learning-Pipeline für kleine und mittelgroße tabellarische Datensätze, bei denen die Vorhersagequalität stagniert. Du fügst Rimay als einen zusätzlichen Vorverarbeitungsschritt hinzu, ohne selbst Quantum Circuits zu bauen.
-
Forschende, die Quantenmethoden für Machine-Learning-Aufgaben erkunden.
Beschreibung
Der Algorithmus zur Quantum Feature Extraction [1] kombiniert zwei Prinzipien des Quantum Machine Learning. Das erste sind Quantum Feature Maps, die Daten in einen hochdimensionalen Hilbert-Raum einbetten und dadurch ausdrucksstärkere Repräsentationen erzeugen. Das zweite ist Quantum Reservoir Computing, das die Dynamik eines quantenmechanischen Vielteilchensystems als nichtlineare Transformation der Eingabe nutzt.
Rimay kodiert die Feature-Werte und die gegenseitige Information zwischen den Features in die lokalen Felder und die Kopplungskoeffizienten eines Spinglas-Hamiltonians. Counterdiabatische Quantendynamik entwickelt das System hin zu seinen Zuständen niedriger Energie, die nichtlineare Mischungen der Korrelationen in den Eingabedaten enthalten. Rimay extrahiert diese Korrelationen, indem es Ein- und Zweikörper-Erwartungswerte misst. Die Erwartungswerte sind die quantentransformierten Features, die du in dein Machine-Learning-Modell einspeist.
Workflow
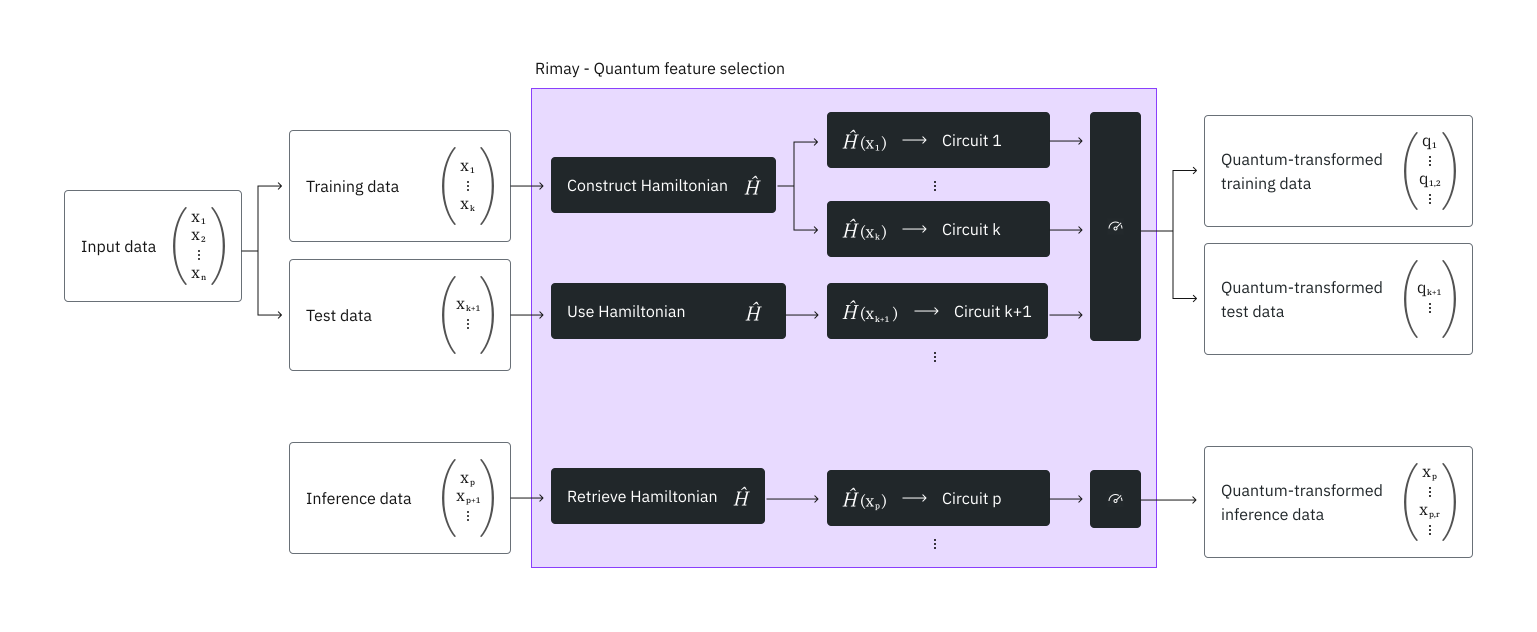
-
Bereite deine Tabellendaten so vor, wie du es für klassisches Machine Learning tun würdest. Rimay benötigt numerische Features, wandle kategoriale Features also in numerische um, zum Beispiel mit dem
OneHotEncodervon scikit-learn. -
Teile die Daten in einen Trainings- und einen Testdatensatz auf und lade beide in die Funktion hoch, wie im Abschnitt Beispiel gezeigt.
-
Rimay verwendet die Trainingsdaten, um den Hamiltonian zu konstruieren, der die Daten darstellt. Jedes Feature entspricht einem Qubit, und der gesamte Trainingsdatensatz bestimmt, welche Features und damit welche Qubits miteinander wechselwirken. Rimay speichert diese Struktur, sodass die Testdaten und spätere Inferenzdaten mit demselben Hamiltonian abgebildet werden.
-
Für jedes Sample legen die Feature-Werte die lokalen Felder des Hamiltonian fest, und die gegenseitige Information zwischen den Features legt die Kopplungskoeffizienten der Struktur aus Schritt 3 fest. Rimay digitalisiert die counterdiabatische Entwicklung dieses Hamiltonian zu einem Circuit und führt die Circuits auf der QPU aus.
-
Rimay misst die resultierenden Bitstrings und berechnet anschließend die Ein-Körper-Erwartungswerte und die Zwei-Körper-Erwartungswerte physikalisch gekoppelter Qubits.
-
Du lädst die Erwartungswerte in einer Form herunter, die du direkt in dein Modell einspeisen oder mit deinen ursprünglichen Features kombinieren kannst.
Aufgrund dieser Struktur entspricht die Anzahl der Qubits, die ein Lauf benötigt, der Anzahl der Features, und die Anzahl der Circuits, die er einreicht, der Anzahl der Samples.
Nachdem du ein Mapping angepasst hast, kannst du neue Daten damit abbilden, zum Beispiel für die Inferenz. Rimay ruft dann den Hamiltonian ab, den es während des Fits erstellt hat, und baut daraus die Circuits für die neuen Samples.
Rimay in deine Machine-Learning-Pipeline integrieren
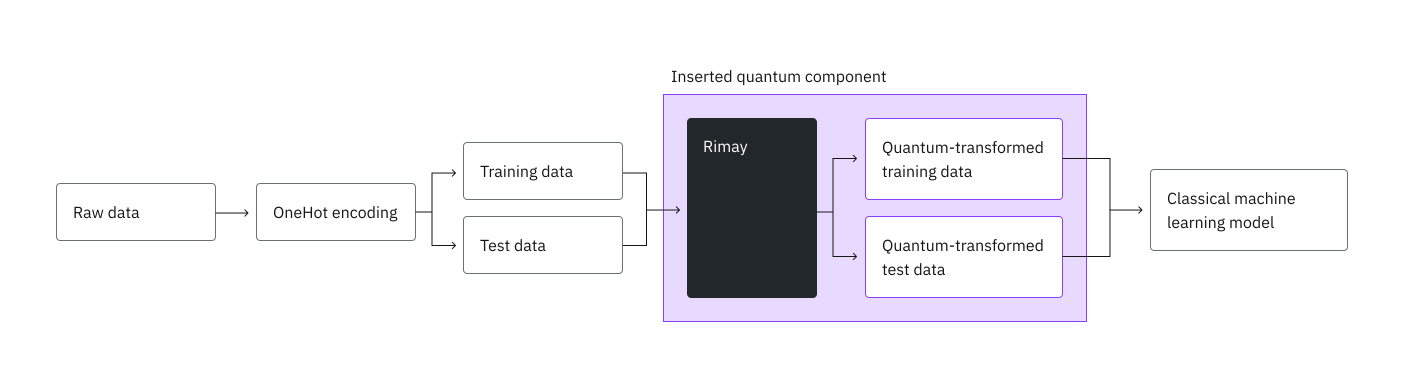
Wie in einer klassischen Pipeline beginnst du mit der Vorverarbeitung der Rohdaten, zum Beispiel durch One-Hot-Kodierung der kategorialen Features, und teilst sie in einen Trainings- und einen Testdatensatz auf. Anstatt beide Datensätze direkt in dein Modell einzuspeisen, gibst du sie zuerst in Rimay und trainierst dein Modell dann auf den quantentransformierten Features.
Benchmarks
Kipu Quantum hat Rimay am German-Credit-Datensatz von OpenML [2] getestet, der 1000 Kreditantragsteller als gute oder schlechte Kreditrisiken klassifiziert. Er hat 13 kategoriale und sieben numerische Attribute. Die One-Hot-Kodierung der kategorialen Attribute ergibt 48 numerische Features. Der Benchmark hält 20 % der Samples als Testdatensatz zurück.
Als Baseline wurden mehrere klassische Modelle auf den klassischen Features trainiert. Mit Rimay wurde ein Random Forest auf zwei Arten trainiert: allein auf den quantentransformierten Features (Random forest Q) und auf den quantentransformierten Features kombiniert mit den klassischen (Random forest H, für hybrid). Die Tabelle zeigt nur den Random Forest, weil er auf den quantentransformierten Features am besten abschnitt.
| Modell | Features | Accuracy | AUC | F1-Score | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Klassisch | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Klassisch | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Klassisch | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Klassisch | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quanten | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Die hybriden Features verbessern alle Metriken des Random Forest außer der Precision, und der hybride Random Forest erreicht einen höheren AUC, F1-Score und Recall als CatBoost auf den klassischen Features. Der größte Effekt zeigt sich beim Recall, der von 0.921 auf 0.957 steigt. Die quantentransformierten Features allein erreichen nicht die Precision der klassischen Modelle.
Der Testdatensatz enthält nur 200 Samples, sodass die korrekte Vorhersage eines weiteren Samples die Accuracy um 0.005 verändert. Verstehe die Unterschiede als Trend, der weiter überprüft werden muss, nicht als signifikanten Effekt. Die Vorhersagegenauigkeit kann außerdem vom hardwarebedingten Rauschen der extrahierten Features abhängen. Verwende daher genügend Shots, damit das Shot-Rauschen das Ergebnis nicht begrenzt.
Der Benchmark verwendete die folgenden Ressourcen:
| Beispiel | Anzahl der Qubits | Anzahl der Samples | Anzahl der Shots | Gesamtzeit (Min.) | QPU-Nutzung (Min.) | Prozessor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Die Anzahl der Samples, die der Anzahl der Circuits entspricht, bestimmt die QPU-Zeit. Verwende den Prozessortyp Nighthawk r2, weil er die benötigte QPU-Zeit stark reduziert.
Eingaben
Der mode bestimmt, welche Parameter ein Lauf benötigt. Eine Beschreibung aller Eingabeparameter findest du in der API-Referenz.
Eingabedateien
-
Lade jede Datei mit
catalog.file_upload()hoch, bevor du die Funktion ausführst. -
Ein Upload ersetzt jede frühere Datei mit demselben Namen, auch für einen Job, den du eingereicht hast, der aber noch nicht gestartet ist. Um mehrere Jobs gleichzeitig auszuführen, gib den Dateien jedes Jobs eigene Namen, zum Beispiel
run1_x_train.csvundrun2_x_train.csv. -
Jede Datei ist eine CSV-Datei mit einer Kopfzeile. Jede Spalte einer Feature-Datei ist ein Feature, und jeder Wert muss numerisch sein.
-
y_trainenthält genau eine numerische Spalte mit einem Label pro Zeile vonx_train. Bilde kategoriale Labels auf Zahlen ab, zum Beispiel gut und schlecht auf 1 und 0. -
x_testundx_inferencemüssen dieselben Spalten in derselben Reihenfolge wiex_trainhaben.
Die mapping_id ist der einzige Weg, das Mapping zu erreichen, das dein Fit erzeugt hat, und sie kann weder nachgeschlagen noch wiederhergestellt werden. Sie berechtigt zur Nutzung dieses Mappings, behandle sie also wie ein Credential und gib sie nicht weiter. Wenn du sie verlierst, musst du ein neues Mapping anpassen, was einen weiteren Lauf auf Quantenhardware kostet. Notiere außerdem den backend_name des Fits, weil das Mapping nur auf diesem Prozessor läuft.
Limits
-
Jedes Feature wird auf ein Qubit abgebildet, daher muss der Prozessor mindestens so viele Qubits haben, wie deine Daten Features haben. Wenn du mehr Features hast, reduziere sie zuerst mit einer Feature-Selection-Technik.
-
Jedes Sample wird zu einem Circuit, und ein Lauf zählt Trainings- und Test-Samples zusammen. Ein Lauf kann höchstens 15.000 Samples enthalten.
-
Ein einzelner Job kann höchstens 10 Millionen Ausführungen anfordern, daher darf die Anzahl der Samples mal
shots10 Millionen nicht überschreiten. -
Ein Job muss innerhalb von 24 Stunden abgeschlossen sein, einschließlich der Zeit, die seine Circuits in der Warteschlange des Prozessors warten. Ein Job, der länger läuft, wird ohne Ergebnis gestoppt. Halte große Datensätze auf einem ausgelasteten Prozessor deutlich unter diesen Limits.
Ausgaben
job.result() gibt ein Dictionary zurück. Die quantentransformierten Features selbst werden in CSV-Dateien geschrieben, die du mit catalog.file_download() herunterlädst. Eine Beschreibung jedes Schlüssels des Dictionarys findest du in der API-Referenz. Die Zeit, die jede Ausführungsphase benötigt hat, findest du unter Lauf-Metadaten.
Jede Ausgabedatei enthält eine Zeile pro Eingabezeile, in der Reihenfolge der Eingabedatei, und eine Spalte pro quantentransformiertem Feature. Die Spalten, deren Namen mit corr_ beginnen, sind die Zwei-Körper-Erwartungswerte. Die Dateien enthalten keine Label-Spalte. Die Labels deiner Trainingsdaten bleiben in deiner Datei y_train.
Lauf-Metadaten
resource_usage enthält einen Eintrag für jede Ausführungsphase, die der Lauf durchlaufen hat: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" und auf einer QPU in der Regel "RUNNING: WAITING_FOR_QPU". Jeder Eintrag enthält CPU_TIME, die Wanduhrzeit der Phase in Sekunden, und QPU_TIME, die QPU-Zeit in Sekunden. Auf einer QPU wird die von IBM abgerechnete QPU-Zeit unter "RUNNING: MAPPING" erfasst, der Phase, in der die Circuits liefen.
"RUNNING: WAITING_FOR_QPU" ist die Zeit, die deine Jobs in der IBM-Warteschlange gewartet haben. Der Lauf entnimmt diese Zeit den IBM-Job-Zeitstempeln und zählt sie nicht zu "RUNNING: MAPPING". Wenn IBM diese Zeitstempel nicht für jeden Job meldet, fehlt der Eintrag, und die Wartezeit ist Teil von "RUNNING: MAPPING".
IBM® schließt seine Nutzungsberechnung einige Zeit nach dem Ende eines Jobs ab. Der Lauf wartet bis zu etwa eine Minute darauf. Nutzung, die nach dieser Zeit noch berechnet wird, ist nicht in QPU_TIME enthalten, und die endgültige Nutzung wird auf IBM Quantum Platform angezeigt. Wenn der Lauf die Nutzung nicht von IBM lesen kann, ist QPU_TIME gleich None.
Zum Beispiel:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Erste Schritte
Authentifiziere dich mit deinem IBM Quantum Platform API-Schlüssel und wähle die Qiskit Function wie folgt aus:
Der folgende Code setzt voraus, dass du deine Zugangsdaten gespeichert hast. Falls nicht, folge den Anweisungen unter Den Qiskit Functions Catalog-Client installieren, um dein Konto mit deinem API-Schlüssel zu speichern.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Function-Größen
Jeder Job läuft in einer Größe: S, M oder L. Ist die angegebene Größe zu klein, wird der Job abgelehnt. Ist die Größe größer als nötig, läuft er auf einem größeren Compute-Profil, als die Arbeit erfordert.
Die Größe eines Rimay-Jobs hängt von der Anzahl der Samples ab, die er abbildet: die Zeilen von x_train und x_test für fit-transform und die Zeilen von x_inference für transform. Die Labels in y_train zählen nicht mit, und ein delete-Lauf bildet keine Samples ab.
| Größe | Samples pro Job | Compute-Profil | vCPU | RAM |
|---|---|---|---|---|
S | Bis zu 2.999 | 8x32 | 8 | 32 GB |
M | 3.000 bis 9.999 | 8x32 | 8 | 32 GB |
L | 10.000 bis 15.000 | 16x128 | 16 | 128 GB |
Die Anzahl der Samples ist das einzige Kriterium. Eine Größe ändert nichts außer dem Compute-Profil: Die Limits für Features, Samples und Shots sind für jede Größe gleich. S und M laufen auf demselben Compute-Profil und unterscheiden sich in der Anzahl der Samples, die jeweils abgedeckt werden.
Der Standard ist M, der verwendet wird, wenn ein Job keine Größe anfordert. Ein Job mit mehr als 9.999 Samples muss daher L anfordern.
Du kannst das Mapping auch mit rimay.sizes_map direkt aus der Funktion auslesen, und die Größe, in der ein Job läuft, wenn er keine anfordert, mit rimay.default_size.
Die Größe vor dem Einreichen berechnen
Führe dies mit deinen eigenen Eingaben aus. Es liest sie nur und tut sonst nichts: Es wird kein Job eingereicht und nichts reserviert, daher kannst du es so oft aufrufen, wie du möchtest.
Übergib die Datensätze selbst, nicht ihre Dateinamen, in derselben Reihenfolge wie input_file, zusammen mit dem mode des Laufs. Schritt 2 des Beispiels zeigt den Aufruf.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Ist die Größe zu klein, schlägt der Job mit dem Fehler 4600 fehl, und die Meldung nennt die stattdessen zu verwendende Größe. Ist sie größer als nötig, läuft der Job normal und erfasst ein Hinweisereignis 4601.
Beispiel
Dieses Beispiel zeigt, wie du Daten hochlädst, die Funktion ausführst und die quantentransformierten Features abrufst. Ein durchgängiges Beispiel, das die Vorverarbeitung und das Training des klassischen Modells enthält, findest du im Tutorial.
1. Die Daten hochladen
Dieses Beispiel verwendet einen kleinen synthetischen Datensatz mit vier numerischen Features und einem binären Label, sodass ein Lauf nur vier Qubits benötigt und schnell abgeschlossen ist. Die nächste Zelle schreibt ihn in vier CSV-Dateien: die Trainings-Features, die Trainings-Labels, die Test-Features und die Features für Schritt 4 dieses Beispiels. Um deine eigenen Daten zu verwenden, schreibe stattdessen deine vorverarbeiteten Trainings- und Testdatensätze mit demselben Layout in Dateien.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Lade die Trainings- und Testdateien hoch. x_inference.csv lädst du in Schritt 4 hoch.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Die Funktion ausführen
Berechne die Größe des Laufs aus den hochgeladenen Daten mit dem Rechner aus Function-Größen.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Wähle einen Prozessor mit mindestens so vielen Qubits, wie deine Daten Features haben, und führe die Funktion im Modus fit-transform mit dieser Größe aus. Die Beispieldaten haben vier Features, daher kann jeder IBM Quantum-Prozessor sie ausführen.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Prüfe den Status des Workloads oder gib die Ergebnisse wie folgt zurück:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Die Ergebnisse abrufen
Lade die quantentransformierten Features herunter. Übergib target_name, damit jede Datei unter ihrem eigenen Namen gespeichert wird.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Neue Daten abbilden
Nachdem du dein Modell trainiert hast, bilde neue Daten mit dem angepassten Mapping ab, zum Beispiel für die Inferenz. Dieses Beispiel bildet x_inference.csv ab, die die erste Zelle dieses Beispiels geschrieben hat. Übergib die mapping_id, die der Fit zurückgegeben hat, damit die neuen Zeilen mit demselben Mapping statt mit einem neuen abgebildet werden.
Ein Mapping wird für das Qubit-Layout eines Prozessors erstellt, übergib daher denselben backend_name wie beim Fit, den der Fit in result["backend_name"] zurückgegeben hat. Verwende nicht least_busy(), um den Prozessor auszuwählen, weil es einen anderen zurückgeben könnte. Rimay lehnt jeden anderen Prozessor ab, bevor es etwas einreicht. Auch die Anzahl der Shots stammt aus dem Fit.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Ein Mapping löschen
Wenn du ein angepasstes Mapping nicht mehr benötigst, lösche es. Ein delete-Lauf führt keine Quantenarbeit aus, daher benötigt er keinen Prozessor, keine Shots und keine Function-Größe. Ein Löschen kann nicht rückgängig gemacht werden. Nach dem Löschen verweist die mapping_id auf nichts mehr, und ein transform-Lauf damit schlägt fehl.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Fehlermeldungen abrufen
Wenn der Status deines Workloads ERROR ist, rufe die Fehlermeldung mit job.error_message() wie folgt ab:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Jeder Fehler, den Rimay meldet, enthält einen Code aus den IBM Quantum-Fehlercodes, eine Meldung und eine Lösung, die den von dir übergebenen und den zulässigen Wert nennt. Die folgende Tabelle listet die häufigsten Fehler auf:
| Code | Ursache |
|---|---|
1221 | Ein Parameter fehlt oder hat den falschen Typ, mode ist ungültig, eine in input_file genannte Datei wurde nicht hochgeladen, die Dateien passen nicht zueinander, ein Feature ist nicht numerisch, oder die mapping_id entspricht keinem gespeicherten Mapping. |
1221 | Ein "transform"-Lauf nennt einen anderen backend_name als der Fit, der sein Mapping erzeugt hat. |
1216 | Deine Instanz hat keinen Prozessor mit dem backend_name, den du übergeben hast. Die Lösung listet die Prozessoren auf, die sie hat. |
1200 | Dein API-Schlüssel hat keinen Zugriff auf die Instanz, unter der der Job läuft. |
3200 | backend_name beginnt nicht mit ibm_. |
4500 | Die Daten haben mehr Features, als der Prozessor Qubits hat. |
6000 | Die Anzahl der Samples mal shots überschreitet 10 Millionen Ausführungen. |
6001 | shots ist kleiner als 1. |
6002 | Die Daten haben mehr Samples, als ein Lauf erlaubt. |
Anwendungsfälle
Bei der tabellarischen Klassifikation auf kleinen und mittelgroßen Datensätzen hat Kipu Quantum die Quantum-Feature-Extraktion auf Folgendes angewendet:
Über Tabellendaten hinaus können eingefrorene neuronale Netze Bilder in numerische Features umwandeln, die die Quantum-Feature-Extraktion dann auf quantentransformierte Features abbildet:
Support erhalten
Wenn du Support benötigst, wende dich an support@kipu-quantum.com.
Nächste Schritte
-
Besuche die API-Referenz für diese Qiskit Function.
-
Probiere das Tutorial Kreditrisiko mit Kipu Quantums Rimay Quantum-Feature-Extraktion klassifizieren aus.
Referenzen
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Zusätzliche Informationen
Rimay ist ein Quechua-Wort und bedeutet „erklären“.