Optimization Solver: Eine Qiskit Function von Q-CTRL Fire Opal
Siehe die API-Referenz
Qiskit Functions sind ein experimentelles Feature, das ausschließlich Nutzerinnen und Nutzern des IBM Quantum® Premium Plan, Flex Plan und On-Prem (über IBM Quantum Platform API) Plan zur Verfügung steht. Sie befinden sich im Preview-Release-Status und können sich noch ändern.
Package versions
Der Code auf dieser Seite wurde mit den folgenden Anforderungen entwickelt. Wir empfehlen, diese Versionen oder neuere zu verwenden.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
Überblick
Mit dem Fire Opal Optimization Solver kannst du Optimierungsprobleme im Utility-Scale auf Quantenhardware lösen, ohne Quantenexpertise zu benötigen. Gib einfach die übergeordnete Problemdefinition ein, und der Solver übernimmt den Rest. Der gesamte Workflow ist rauschbewusst und nutzt intern Fire Opals Performance Management. Der Solver liefert zuverlässig genaue Lösungen für klassisch anspruchsvolle Probleme, auch im vollen Geräteumfang auf den größten IBM® QPUs.
Der Solver ist flexibel und kann eingesetzt werden, um kombinatorische Optimierungsprobleme zu lösen, die als Zielfunktionen oder beliebige Graphen definiert sind. Probleme müssen nicht auf die Gerätetopologie abgebildet werden. Sowohl unbeschränkte als auch beschränkte Probleme sind lösbar, wobei Einschränkungen als harte Hamming-Gewicht-1-Constraints statt als Strafterme durchgesetzt werden. Die in diesem Leitfaden enthaltenen Beispiele zeigen, wie man ein unbeschränktes und ein beschränktes Optimierungsproblem im Utility-Scale mit verschiedenen Solver-Eingabetypen löst. Das erste Beispiel umfasst ein Max-Cut-Problem, das auf einem 156-Knoten-3-regulären Graphen definiert ist, während das zweite Beispiel ein 50-Knoten-Graph-Partitionierungsproblem angeht, das durch eine Kostenfunktion definiert ist.
Um Zugang zum Optimization Solver zu erhalten, kontaktiere Q-CTRL.
Beschreibung der Function
Der Solver optimiert und automatisiert den gesamten Algorithmus vollständig – von der Fehlerunterdrückung auf Hardwareebene bis hin zu effizientem Problem-Mapping und geschlossener klassischer Optimierung. Im Hintergrund reduziert die Pipeline des Solvers Fehler auf jeder Stufe und ermöglicht so die verbesserte Leistung, die für eine bedeutungsvolle Skalierung erforderlich ist. Der zugrundeliegende Workflow ist vom Quantum Approximate Optimization Algorithm (QAOA) inspiriert, einem hybriden quanten-klassischen Algorithmus. Eine detaillierte Zusammenfassung des vollständigen Optimization-Solver-Workflows findest du im veröffentlichten Manuskript.
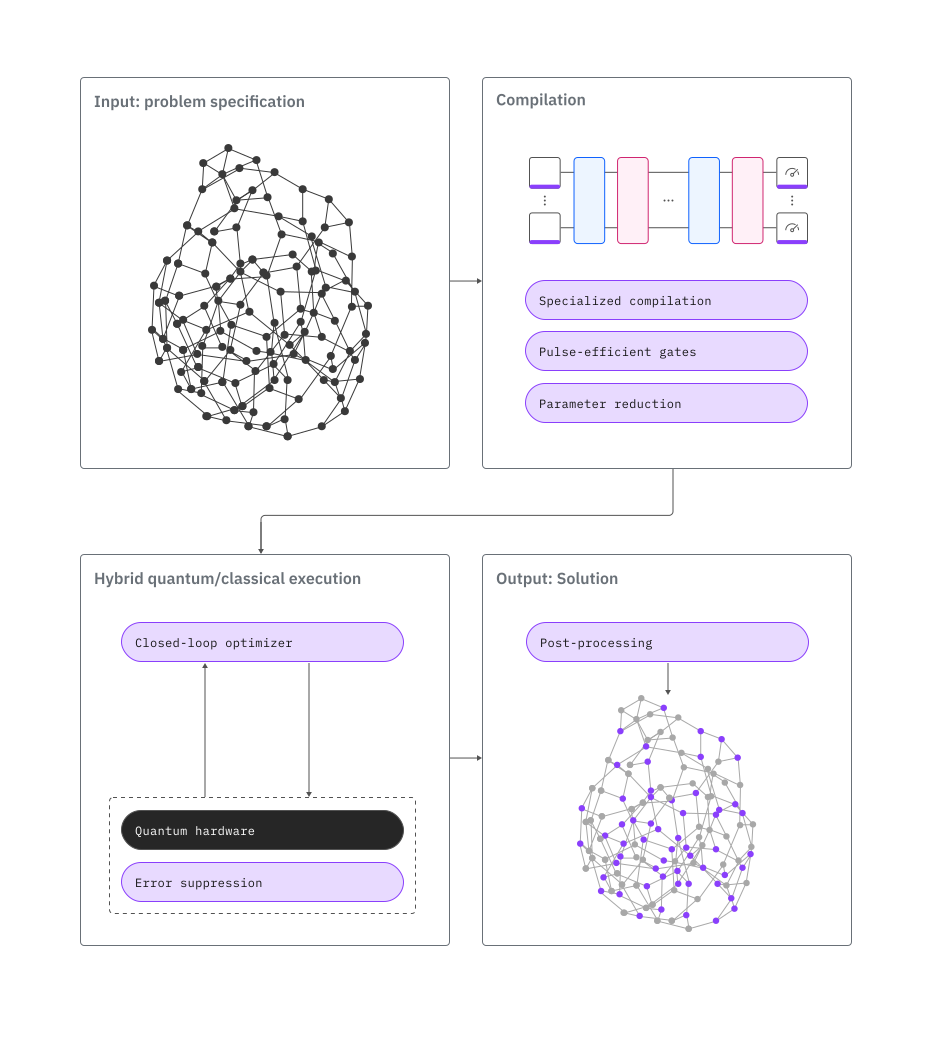
So löst du ein allgemeines Problem mit dem Optimization Solver:
- Definiere dein Problem als Zielfunktion, einen Graphen oder eine
SparsePauliOp-Spinkette. - Verbinde dich mit der Function über den Qiskit Functions Catalog.
- Führe das Problem mit dem Solver aus und rufe die Ergebnisse ab.
Akzeptierte Problemformate
-
Polynomielle Ausdrucksdarstellung einer Zielfunktion. Idealerweise in Python mit einem vorhandenen SymPy-Poly-Objekt erstellt und mit sympy.srepr in einen String formatiert.
-
Graphdarstellung eines bestimmten Problemtyps. Der Graph sollte mit der networkx-Bibliothek in Python erstellt werden. Er wird dann durch Verwendung der networkx-Funktion
nx.readwrite.json_graph.adjacency_datain einen String umgewandelt. -
Spinkettendarstellung eines bestimmten Problems. Die Spinkette sollte als
SparsePauliOp-Objekt dargestellt werden; weitere Details findest du in der Dokumentation.
Wenn du ein Backend verwenden möchtest, das diese Funktion derzeit nicht unterstützt, wende dich an Q-CTRL, um Support hinzuzufügen.
Benchmarks
Die Leistung kann sowohl von der Probleminstanz als auch von den nachfolgenden Verarbeitungsschritten abhängen. In manchen Fällen können klassische und quantengenerierte Stichproben nach vergleichbarer Nachbearbeitung eine ähnliche endgültige Lösungsqualität erreichen. Die Bewertung sollte daher den gesamten Optimierungsworkflow berücksichtigen.
Veröffentlichte Benchmarking-Ergebnisse zeigen, dass der Solver Probleme mit über 120 Qubits erfolgreich löst und dabei sogar zuvor veröffentlichte Ergebnisse auf Quanten-Annealing- und Trapped-Ion-Geräten übertrifft. Die folgenden Benchmark-Metriken geben einen groben Hinweis auf die Genauigkeit und Skalierung von Problemtypen anhand einiger Beispiele. Die tatsächlichen Metriken können je nach verschiedenen Problemeigenschaften variieren, wie z. B. der Anzahl der Terme in der Zielfunktion (Dichte) und deren Lokalität, der Anzahl der Variablen und der polynomiellen Ordnung.
Die angegebene „Anzahl der Qubits" ist keine absolute Begrenzung, sondern stellt ungefähre Schwellenwerte dar, bei denen du eine äußerst konsistente Lösungsgenauigkeit erwarten kannst. Größere Problemgrößen wurden erfolgreich gelöst, und Tests jenseits dieser Grenzen sind ausdrücklich erwünscht.
Beliebige Qubit-Konnektivität wird für alle Problemtypen unterstützt.
| Problemtyp | Anzahl der Qubits | Beispiel | Genauigkeit | Gesamtzeit (s) | Runtime-Nutzung (s) | Anzahl der Iterationen |
|---|---|---|---|---|---|---|
| Dünn verbundene quadratische Probleme | 156 | 3-reguläres max-cut | 100% | 1764 | 293 | 16 |
| Optimierung binärer Probleme höherer Ordnung | 156 | Ising-Spinglas-Modell | 100% | 1461 | 272 | 16 |
| Dicht verbundene quadratische Probleme | 50 | Vollständig verbundenes max-cut | 100% | 1758 | 268 | 12 |
| Beschränktes Problem mit harten Bedingungen | 50 | Gewichtete Graphpartitionierung mit 8 % Kantendichte | 100% | 1074 | 215 | 10 |
Erste Schritte
Authentifiziere dich zunächst mit deinem IBM Quantum API-Schlüssel. Wähle dann die Qiskit Function wie folgt aus. (Dieser Codeausschnitt setzt voraus, dass du dein Konto bereits in deiner lokalen Umgebung gespeichert hast.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"networkx": "networkx", "numpy": "numpy", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "sympy": "sympy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
Beispiel: Unbeschränkte Optimierung
Führe das Maximum-Cut-Problem (max-cut) aus. Das folgende Beispiel demonstriert die Fähigkeiten des Solvers an einem 156-Knoten-3-regulären ungewichteten Graphen-max-cut-Problem, du kannst aber auch gewichtete Graphenprobleme lösen.
Zusätzlich zu qiskit-ibm-catalog verwendest du in diesem Beispiel auch die folgenden Pakete: networkx und numpy. Du kannst diese Pakete installieren, indem du die folgende Zelle auskommentierst, wenn du dieses Beispiel in einem Notebook mit dem IPython-Kernel ausführst.
# %pip install networkx numpy
1. Das Problem definieren
Du kannst ein max-cut-Problem ausführen, indem du ein Graphenproblem definierst und problem_type='maxcut' angibst.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
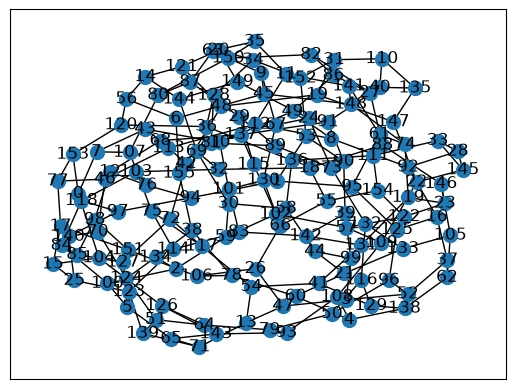
Der Solver akzeptiert einen String als Problemdefinitions-Eingabe.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. Das Problem ausführen
Wenn du die graphenbasierte Eingabemethode verwendest, gib den Problemtyp an.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Überprüfe den Status deiner Qiskit-Function-Arbeitslast oder rufe Ergebnisse wie folgt ab:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. Das Ergebnis abrufen
Rufe den optimalen Schnittwert aus dem Ergebnis-Dictionary ab.
Die Zuordnung der Variablen zum Bitstring kann sich geändert haben. Das Ausgabe-Dictionary enthält ein variables_to_bitstring_index_map-Unter-Dictionary, das hilft, die Reihenfolge zu überprüfen.
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
Du kannst die Genauigkeit des Ergebnisses überprüfen, indem du das Problem klassisch mit Open-Source-Solvern wie PuLP löst, sofern der Graph nicht dicht verbunden ist. Bei Problemen mit hoher Dichte sind möglicherweise fortgeschrittene klassische Solver erforderlich, um die Lösung zu validieren.
Beispiel: Beschränkte Optimierung
Das vorherige max-cut-Beispiel ist ein gängiges quadratisches unbeschränktes binäres Optimierungsproblem. Q-CTRLs Optimization Solver kann auch beschränkte Optimierungsprobleme lösen, indem harte Bedingungen direkt über die Eingabe constraint an den Solver übergeben werden, anstatt sie als Strafterme in der Zielfunktion zu kodieren. Der Solver unterstützt derzeit Hamming-Gewicht-1-Bedingungen: Jede Bedingung legt eine Gruppe von Variablen fest, bei der genau eine Variable gleich 1 und die übrigen gleich 0 sein müssen.
Das folgende Beispiel zeigt, wie eine Kostenfunktion und eine Reihe harter Bedingungen für ein beschränktes Optimierungsproblem, die Graphpartitionierung, konstruiert werden, indem jeder Knoten eines Graphen genau einer von mehreren Gruppen zugewiesen wird, während das Gesamtgewicht der Kanten minimiert wird, deren Endpunkte in derselben Gruppe liegen.
Zusätzlich zu den Paketen qiskit-ibm-catalog und qiskit verwendest du in diesem Beispiel auch die folgenden Pakete: numpy, networkx und sympy. Du kannst diese Pakete installieren, indem du die folgende Zelle auskommentierst, wenn du dieses Beispiel in einem Notebook mit dem IPython-Kernel ausführst.
# %pip install numpy networkx sympy
1. Das Problem definieren
Definiere ein zufälliges Graphpartitionierungsproblem, indem du einen Graphen mit zufällig gewichteten Knoten erzeugst.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
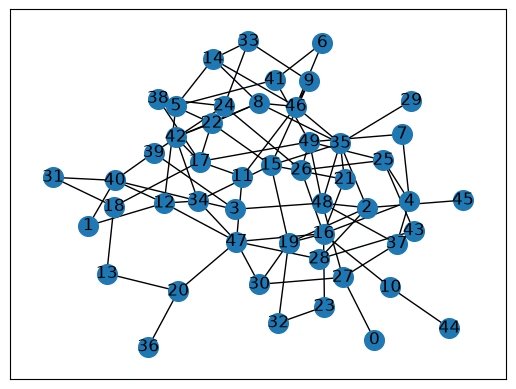
Ein Standardoptimierungsmodell für die gewichtete Graphpartitionierung lässt sich wie folgt formulieren. Teile die Knoten des Graphen in drei Gruppen auf, und setze , wenn Knoten der Gruppe zugewiesen ist, und andernfalls. Das Ziel besteht darin, das Gesamtgewicht der Kanten zu minimieren, deren Endpunkte derselben Gruppe zugewiesen sind, wobei das Gewicht einer Kante die kombinierte Gewichtung ihrer beiden Endpunkte ist, :
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
Jeder Knoten muss genau einer der drei Gruppen zugewiesen werden. Dies ist eine Hamming-Gewicht-1-Bedingung: Für jeden Knoten muss genau eine der Variablen gleich 1 sein, und die übrigen müssen gleich 0 sein:
Anstatt diese Anforderung als Strafterm in der Kostenfunktion zu kodieren, übergib sie direkt als harte Bedingung an den Solver, indem du die Eingabe constraint verwendest.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
Du musst nicht jede Variable zu constraint hinzufügen. Jede Variable, die im Dictionary fehlt, bleibt unbeschränkt, sodass du hart beschränkte Variablengruppen mit freien Variablen im selben Problem kombinieren kannst.
2. Das Problem ausführen
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Überprüfe den Status deiner Qiskit-Function-Arbeitslast oder rufe Ergebnisse wie folgt ab:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. Das Ergebnis abrufen
Rufe die Lösung ab und analysiere die Ergebnisse. Die Lösungskosten stellen das Gesamtgewicht der Kanten dar, deren Endpunkte in derselben Gruppe gelandet sind, sodass niedrigere Kosten eine bessere Partitionierung des Graphen anzeigen.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
Support erhalten
Bei Fragen oder Problemen wende dich an Q-CTRL.
Änderungsprotokoll
-
2026-08-10: Unterstützung für harte (Hamming-Gewicht-1) Bedingungen über die Eingabe
constrainthinzugefügt und das Beispiel für beschränkte Optimierung entsprechend aktualisiert. -
2026-02-11: Wir unterstützen jetzt
ibm_miami
Nächste Schritte
-
Beantrage Zugang zum Q-CTRL Optimization Solver.
-
Besuche die API-Referenz für diese Qiskit Function.
-
Probiere das Tutorial Löse Optimierungsprobleme binärer Probleme höherer Ordnung mit Q-CTRLs Optimization Solver aus.
-
Sieh dir die Mazda-Fallstudie an.
-
Sieh dir die Network Rail-Fallstudie an.
-
Sieh dir die Australian Army-Fallstudie an.
-
Sieh dir die Transport for New South Wales-Fallstudie an.