Performance Management: Eine Qiskit Function von Q-CTRL Fire Opal
Siehe die API-Referenz
Qiskit Functions sind ein experimentelles Feature, das ausschließlich Nutzerinnen und Nutzern des IBM Quantum® Premium Plan, Flex Plan und On-Prem (über die IBM Quantum Platform API) Plan zur Verfügung steht. Sie befinden sich im Preview-Status und können sich noch ändern.
Package versions
Der Code auf dieser Seite wurde mit den folgenden Anforderungen entwickelt. Wir empfehlen, diese Versionen oder neuere zu verwenden.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Überblick
Fire Opal Performance Management macht es für jeden einfach, mit Quantencomputern in großem Maßstab sinnvolle Ergebnisse zu erzielen – ohne Experte für Quantenhardware sein zu müssen. Beim Ausführen von Circuits mit Fire Opal Performance Management werden KI-gestützte Fehlerunterdrückungstechniken automatisch angewendet, sodass größere Probleme mit mehr Gates und Qubits skaliert werden können. Dieser Ansatz reduziert die Anzahl der benötigten Shots, um die richtige Antwort zu erhalten, ohne zusätzlichen Overhead – was zu erheblichen Einsparungen bei Rechenzeit und Kosten führt.
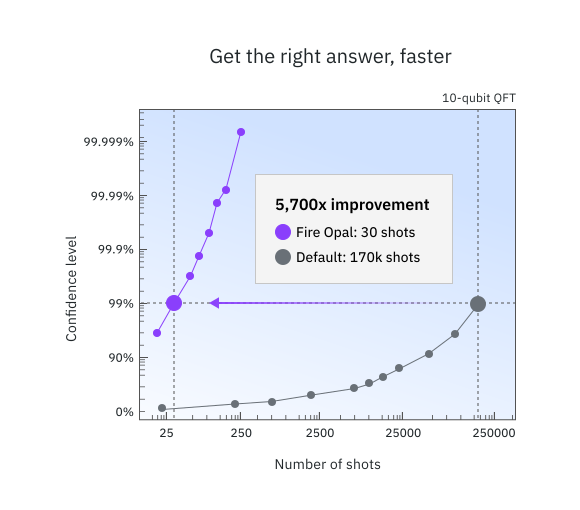
Performance Management unterdrückt Fehler und erhöht die Wahrscheinlichkeit, auf rauschbehafteter Hardware die richtige Antwort zu erhalten. Mit anderen Worten: Es verbessert das Signal-Rausch-Verhältnis. Das folgende Bild zeigt, wie die durch Performance Management ermöglichte höhere Genauigkeit den Bedarf an zusätzlichen Shots im Fall eines 10-Qubit Quantum Fourier Transform-Algorithmus reduzieren kann. Mit nur 30 Shots erreicht Q-CTRL die 99%-Konfidenzschwelle, während die Standardkonfiguration (QiskitRuntime Sampler, optimization_level=3 und resilience_level=1, ibm_sherbrooke) 170.000 Shots benötigt. Durch die schnellere Ermittlung der richtigen Antwort sparst du erhebliche Rechenzeit.
Die Performance Management Function kann für jeden Algorithmus verwendet werden und lässt sich problemlos an Stelle der Standard-IBM Quantum Primitives einsetzen. Im Hintergrund arbeiten mehrere Fehlerunterdrückungstechniken zusammen, um Fehler zur Laufzeit zu verhindern. Alle Methoden der Fire-Opal-Pipeline sind vorkonfiguriert und algorithmusunabhängig, sodass du stets ohne jede Konfiguration die beste Leistung erhältst.
Um Zugang zu Performance Management zu erhalten, kontaktiere Q-CTRL.
Beschreibung
Fire Opal Performance Management bietet zwei Ausführungsoptionen, die den IBM Quantum Primitives ähneln, sodass du den Q-CTRL Sampler und Estimator einfach austauschen kannst. Der allgemeine Arbeitsablauf bei der Verwendung der Performance Management Function ist:
- Definiere deinen Circuit (und Operatoren im Fall des Estimators).
- Führe den Circuit aus.
- Rufe die Ergebnisse ab.
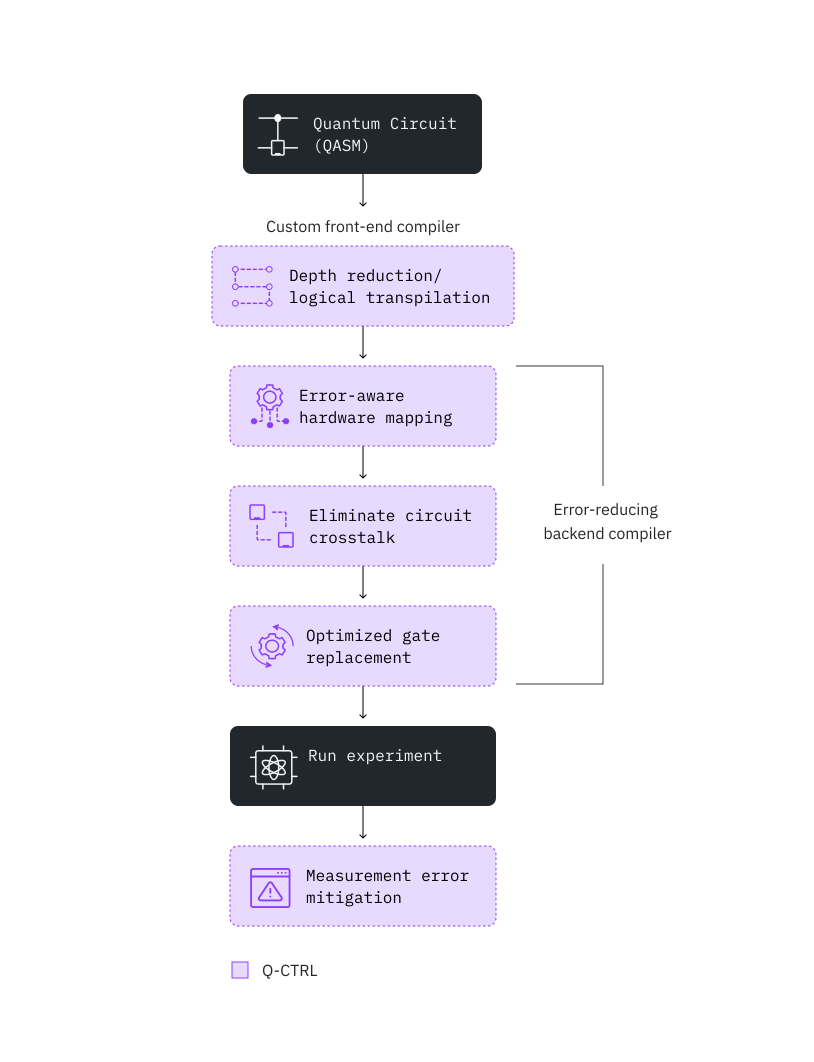
Um Hardware-Rauschen zu reduzieren, setzt Fire Opal eine Reihe von KI-gesteuerten Fehlerunterdrückungstechniken ein, die im folgenden Bild dargestellt sind. Mit Fire Opal ist die gesamte Pipeline vollständig automatisiert und erfordert keinerlei Konfiguration.
Fire Opals Pipeline beseitigt den Bedarf an zusätzlichem Overhead, wie erhöhter Quantenlaufzeit oder zusätzlichen physischen Qubits. Beachte, dass die klassische Verarbeitungszeit weiterhin ein Faktor ist (siehe den Abschnitt Benchmarks für Schätzwerte, wobei „Gesamtzeit" sowohl klassische als auch Quantenverarbeitung umfasst). Im Gegensatz zur Fehlerminderung, die Overhead in Form von Sampling erfordert, arbeitet Fire Opals Fehlerunterdrückung sowohl auf Gate- als auch auf Pulsebene, um verschiedene Rauschquellen anzugehen und die Wahrscheinlichkeit eines Fehlers zu verringern. Durch die Verhinderung von Fehlern entfällt der Bedarf an aufwändiger Nachverarbeitung.
Das folgende Bild zeigt die von Fire Opal Performance Management automatisierten Fehlerunterdrückungsmethoden.
Die Function bietet zwei Primitives – Sampler und Estimator – und die Ein- und Ausgaben beider erweitern die implementierte Spezifikation für IBM Quantum V2 Primitives.
Benchmarks
Veröffentlichte algorithmische Benchmarking-Ergebnisse zeigen signifikante Leistungsverbesserungen bei verschiedenen Algorithmen, darunter Bernstein-Vazirani, Quantum Fourier Transform, Grovers Suche, Quantum Approximate Optimization Algorithm und Variational Quantum Eigensolver. Der Rest dieses Abschnitts enthält weitere Details zu den Arten von Algorithmen, die du ausführen kannst, sowie zur erwarteten Leistung und den Laufzeiten.
Die folgenden unabhängigen Studien zeigen, wie Q-CTRLs Performance Management algorithmische Forschung in bisher unerreichter Größenordnung ermöglicht:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis – bis zu 50-Qubit-Quantum-Kernel-Learning
- Tensor-based quantum phase difference estimation for large-scale demonstration – bis zu 33-Qubit-Quantum-Phase-Estimation
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits – bis zu 21-Qubit-Quantum-Data-Loading
Die folgende Tabelle bietet eine grobe Orientierung zu Genauigkeit und Laufzeiten aus früheren Benchmarking-Läufen auf ibm_fez. Die Leistung auf anderen Geräten kann variieren. Die Nutzungszeit basiert auf der Annahme von 10.000 Shots pro Circuit. Die angegebene „Anzahl der Qubits" ist keine harte Begrenzung, sondern stellt grobe Schwellenwerte dar, bei denen du eine äußerst konsistente Lösungsgenauigkeit erwarten kannst. Auch größere Probleme wurden bereits erfolgreich gelöst, und Tests jenseits dieser Grenzen sind erwünscht.
| Beispiel | Anzahl der Qubits | Genauigkeit | Genauigkeitsmaß | Gesamtzeit (s) | Laufzeitnutzung (s) | Primitive (Modus) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | Erfolgsrate (Anteil der Läufe, bei denen die richtige Antwort den höchsten Zählwert hat) | 10 | 8 | Sampler |
| Quantum Fourier Transform | 30Q | 100% | Erfolgsrate (Anteil der Läufe, bei denen die richtige Antwort den höchsten Zählwert hat) | 10 | 8 | Sampler |
| Quantum Phase Estimation | 30Q | 99,9998% | Genauigkeit des gefundenen Winkels: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Quantensimulation: Ising-Modell (15 Schritte) | 20Q | 99,775% | (unten definiert) | 60 (pro Schritt) | 15 (pro Schritt) | Estimator |
| Quantensimulation 2: Molekulardynamik (20 Zeitpunkte) | 34Q | 96,78% | (unten definiert) | 10 (pro Zeitpunkt) | 6 (pro Zeitpunkt) | Estimator |
Definition der Genauigkeit der Messung eines Erwartungswerts – die Metrik ist wie folgt definiert:
wobei = idealer Erwartungswert, = gemessener Erwartungswert, = idealer Maximalwert und = idealer Minimalwert. ist schlicht der Durchschnitt des Werts über mehrere Messungen.
Diese Metrik wird verwendet, weil sie gegenüber globalen Verschiebungen und Skalierungen im Bereich der erreichbaren Werte invariant ist. Anders ausgedrückt: Egal ob du den Bereich möglicher Erwartungswerte nach oben oder unten verschiebst oder die Streuung erhöhst – der Wert von sollte konsistent bleiben.
Erste Schritte
Fire Opal Performance Management verwendet Qiskit v2.0.0, was die empfohlene Version ist. Unterstützte Versionen sind Qiskit >=v2.0.0.
Authentifiziere dich mit deinem IBM Quantum Platform API-Schlüssel und wähle die Qiskit Function wie folgt aus. (Dieses Snippet setzt voraus, dass du dein Konto bereits in deiner lokalen Umgebung gespeichert hast.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Wenn du ein Backend verwenden möchtest, das von dieser Function derzeit nicht unterstützt wird, wende dich an Q-CTRL, um Unterstützung hinzuzufügen.
Estimator-Primitive
Estimator-Beispiel
Verwende das Estimator Primitive von Fire Opal Performance Management, um den Erwartungswert eines einzelnen Circuit-Observable-Paares zu bestimmen.
Zusätzlich zu den Paketen qiskit-ibm-catalog und qiskit verwendest du in diesem Beispiel auch das Paket numpy. Du kannst dieses Paket installieren, indem du das Kommentarzeichen in der folgenden Zelle entfernst, wenn du das Beispiel in einem Notebook mit dem IPython-Kernel ausführst.
# %pip install numpy
1. Circuit erstellen
Generiere als Beispiel einen zufälligen hermiteschen Operator und ein Observable zur Eingabe in die Performance Management Function.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Circuit ausführen
Führe den Circuit aus und definiere optional das Backend und die Anzahl der Shots.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Du kannst die vertrauten Qiskit Serverless APIs verwenden, um den Status deiner Qiskit Function-Arbeitslast zu prüfen:
qctrl_estimator_job.status()
'QUEUED'
3. Ergebnis abrufen
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Die Ergebnisse haben dasselbe Format wie ein Estimator-Ergebnis:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Sampler Primitive
Sampler-Beispiel
Verwende das Sampler Primitive von Fire Opal Performance Management, um einen Bernstein–Vazirani-Circuit auszuführen. Dieser Algorithmus, der verwendet wird, um einen verborgenen String aus den Ausgaben einer Black-Box-Funktion zu finden, ist ein gängiger Benchmarking-Algorithmus, da es genau eine richtige Antwort gibt. 1. Circuit erstellen
Definiere die Lösung des Algorithmus – den verborgenen Bitstring – und den Bernstein–Vazirani-Circuit. Du kannst die Breite des Circuits einfach durch Ändern von circuit_width anpassen.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Circuit ausführen
Führe den Circuit aus und definiere optional das Backend und die Anzahl der Shots.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Prüfe den Status deiner Qiskit Function-Arbeitslast oder rufe Ergebnisse wie folgt ab:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Ergebnis abrufen
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. Die häufigsten Bitstrings darstellen
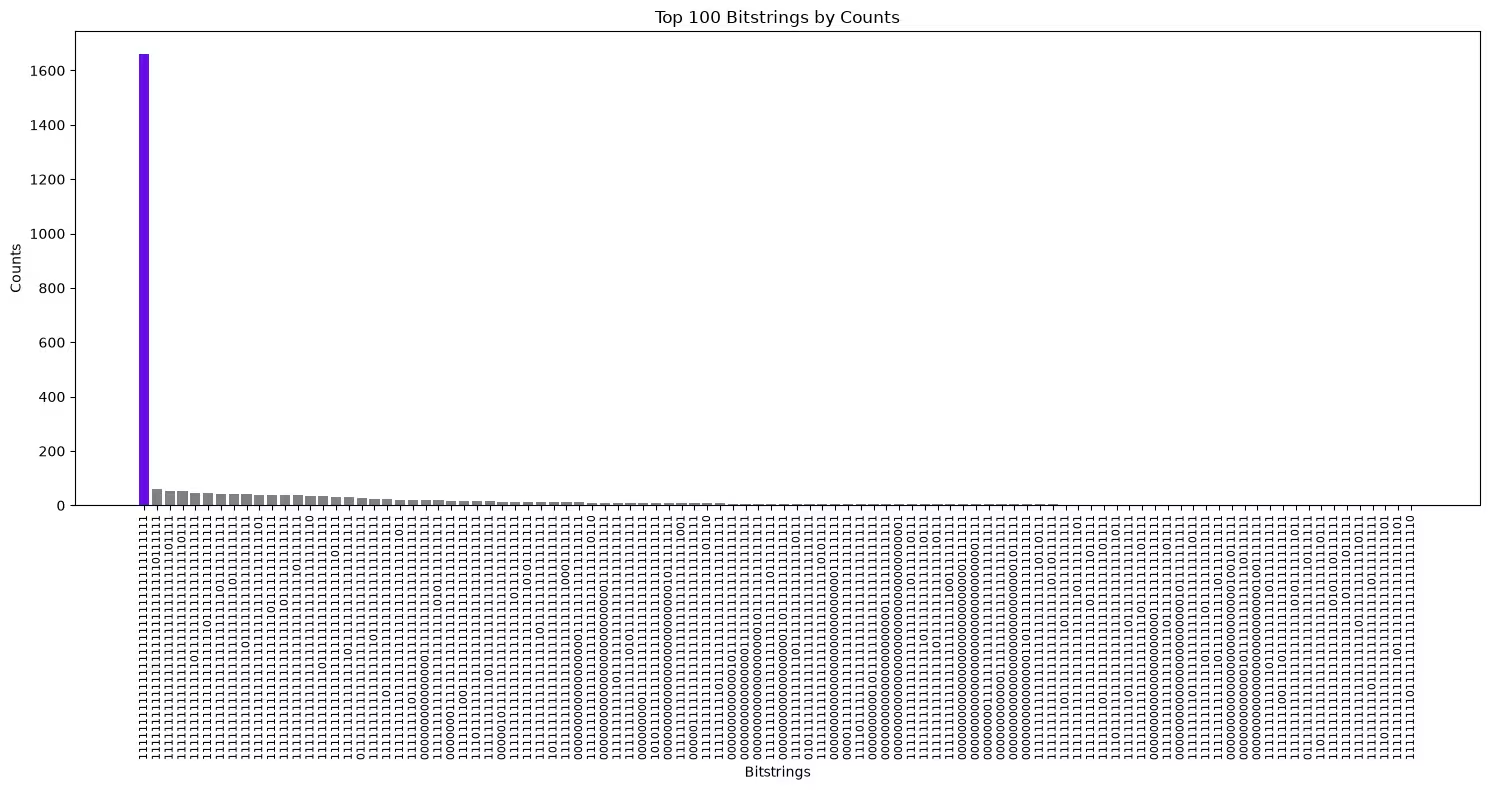
Stelle den Bitstring mit den höchsten Zählwerten dar, um zu prüfen, ob der verborgene Bitstring der Modalwert war.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
Der verborgene Bitstring ist lila hervorgehoben und sollte der Bitstring mit den meisten Zählwerten sein.
plot_top_bitstrings(counts, hidden_bitstring)
Änderungsprotokoll
-
2026-02-20: Hinweis zur Abkündigung - das Metadatenfeld
provider_job_idswird in 30 Tagen in Version 0.13.0 als veraltet markiert. Nutzerinnen und Nutzer können über die Methodejob_id()des Runtime-Dienstes auf die Job-ID zugreifen. -
2026-02-11: Unterstützung für
ibm_miamihinzugefügt, und Ausführungsmetadaten wurden zumPubResultergänzt.
Support erhalten
Bei Fragen oder Problemen kontaktiere Q-CTRL.
Nächste Schritte
-
Beantrage Zugang zu Q-CTRL Performance Management.
-
Sieh dir die API-Referenz für diese Qiskit Function an.
-
Probiere das Tutorial Transverse-Field Ising Model mit Q-CTRLs Performance Management aus.
-
Probiere das Tutorial Quantum Phase Estimation mit Q-CTRLs Qiskit Functions aus
-
Lies die Mitsubishi Chemical Corp Fallstudie.
-
Lies die Fallstudie einer anonymisierten Bank.
-
Lies die BlueQubit-Fallstudie.