QESEM: Eine Qiskit Function von Qedma
Siehe die API-Referenz
Paketversionen
Der Code auf dieser Seite wurde mit den folgenden Anforderungen entwickelt. Wir empfehlen, diese Versionen oder neuere zu verwenden.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Qiskit Functions sind ein experimentelles Feature, das ausschließlich Nutzern des IBM Quantum® Premium Plan, Flex Plan und On-Prem (über die IBM Quantum Platform API) Plan zur Verfügung steht. Sie befinden sich im Preview-Release-Status und können sich noch ändern.
Überblick
Obwohl Quantenprozessoren (QPUs) in den letzten Jahren erhebliche Fortschritte gemacht haben, bleiben Fehler durch Rauschen und Unvollkommenheiten in bestehender Hardware eine zentrale Herausforderung für Entwickler von Quantenalgorithmen. Da sich das Feld Quantenberechnungen im Utility-Maßstab nähert, die klassisch nicht mehr verifiziert werden können, gewinnen Lösungen zur fehlerfreien Berechnung mit garantierter Genauigkeit zunehmend an Bedeutung. Um dieser Herausforderung zu begegnen, hat Qedma Quantum Error Mitigation (QESEM) entwickelt, das nahtlos in die IBM Quantum Platform als Qiskit Function integriert ist.
Mit QESEM kannst du Quantenschaltkreise auf verrauschten QPUs ausführen und hochgenaue, fehlerfreie Ergebnisse mit sehr effizienten QPU-Zeit-Overheads erzielen, die nahe an fundamentalen Grenzen liegen. Dazu nutzt QESEM eine Reihe proprietärer Methoden von Qedma zur Charakterisierung und Reduktion von Fehlern. Fehlerreduktionstechniken umfassen Gate-Optimierung, rauschbewusste Transpilation, Error Suppression (ES) und unverzerrte Fehlermitigation (EM). Durch diese Kombination charakterisierungsbasierter Methoden kannst du zuverlässige, fehlerfreie Ergebnisse für generische großvolumige Quantenschaltkreise erzielen und so Anwendungen erschließen, die sonst nicht realisierbar wären.
Eine vollständige Beschreibung der zugrunde liegenden Komponenten sowie eine Demonstration im Utility-Maßstab findest du im Artikel Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Beschreibung
Du kannst die QESEM-Funktion von Qedma verwenden, um deine Schaltkreise mit Error Suppression und Mitigation einfach abzuschätzen und auszuführen und dabei größere Schaltkreisvolumen und höhere Genauigkeiten zu erreichen. Zur Nutzung von QESEM gibst du einen Quantenschaltkreis, eine Menge zu messender Observablen, eine statistische Zielgenauigkeit für jede Observable und einen gewählten QPU an. Bevor du den Schaltkreis auf die Zielgenauigkeit ausführst, kannst du die erforderliche QPU-Zeit auf Basis einer analytischen Berechnung schätzen, die keine Schaltkreisausführung erfordert. Sobald du mit der QPU-Zeitschätzung zufrieden bist, kannst du den Schaltkreis mit QESEM ausführen.
Bei der Ausführung eines Schaltkreises führt QESEM ein auf deinen Schaltkreis zugeschnittenes Gerätecharakterisierungsprotokoll durch, das ein zuverlässiges Rauschmodell für die im Schaltkreis auftretenden Fehler liefert. Auf Basis der Charakterisierung implementiert QESEM zunächst eine rauschbewusste Transpilation, um den Eingangsschaltkreis auf eine Menge physikalischer Qubits und Gates abzubilden, die das Rauschen bezüglich der Zielobservable minimiert. Dazu gehören die nativ verfügbaren Gates (CX/CZ auf IBM®-Geräten) sowie zusätzliche, von QESEM optimierte Gates, die den erweiterten Gate-Satz von QESEM bilden. QESEM führt dann eine Reihe charakterisierungsbasierter ES- und EM-Schaltkreise auf dem QPU aus und erfasst deren Messergebnisse. Diese werden anschließend klassisch nachverarbeitet, um einen unverzerrten Erwartungswert und einen Fehlerbalken für jede Observable entsprechend der angeforderten Genauigkeit bereitzustellen.
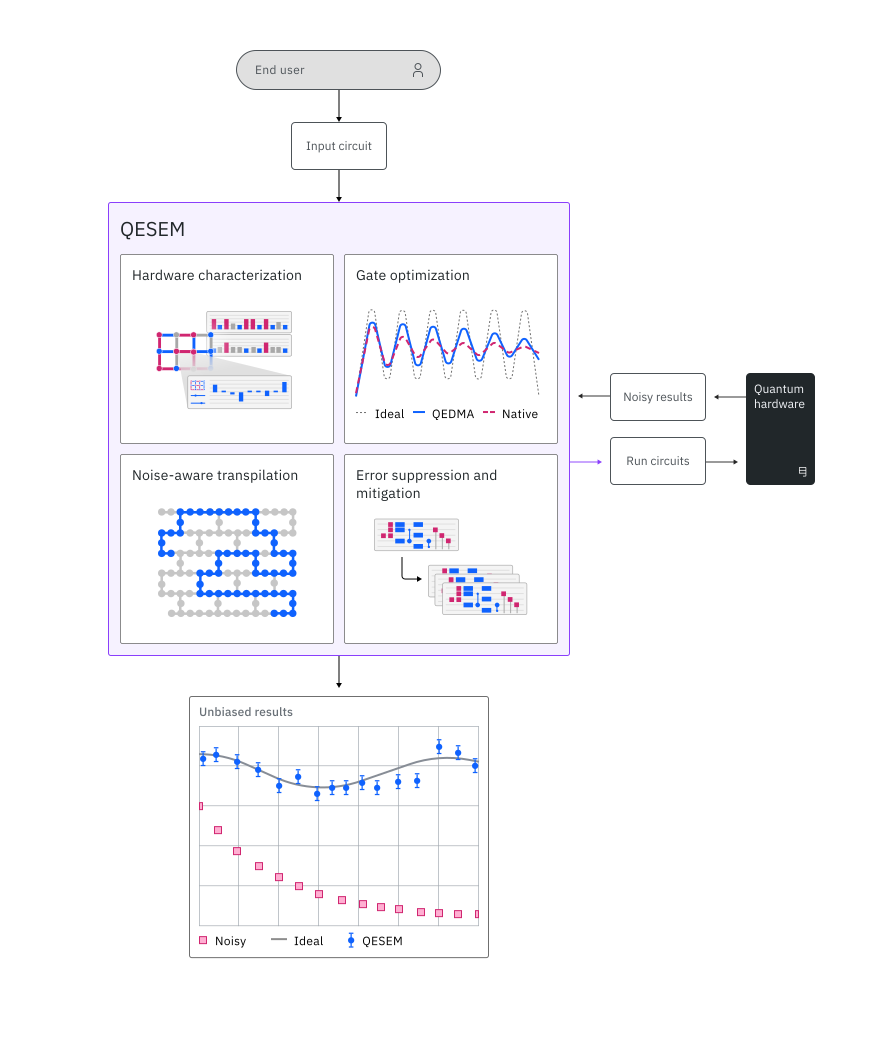 QESEM hat nachweislich hochgenaue Ergebnisse für eine Vielzahl von Quantenanwendungen und bei den größten heute erreichbaren Schaltkreisvolumen geliefert. QESEM bietet die folgenden nutzerorientierten Features, die im nachfolgenden Benchmarks-Abschnitt demonstriert werden:
- Garantierte Genauigkeit: QESEM liefert unverzerrte Schätzungen für Erwartungswerte von Observablen. Die EM-Methode ist mit theoretischen Garantien ausgestattet, die – zusammen mit Qedmas modernster Charakterisierung – sicherstellen, dass die Mitigation bis zur nutzerdefinierten Genauigkeit gegen die rauschfreie Schaltkreisausgabe konvergiert. Im Gegensatz zu vielen heuristischen EM-Methoden, die anfällig für systematische Fehler oder Verzerrungen sind, ist QESEMs garantierte Genauigkeit entscheidend für zuverlässige Ergebnisse bei generischen Quantenschaltkreisen und Observablen.
- Skalierbarkeit auf große QPUs: Die QPU-Zeit von QESEM hängt vom Schaltkreisvolumen ab, ist aber ansonsten unabhängig von der Anzahl der Qubits. Qedma hat QESEM auf den größten heute verfügbaren Quantengeräten demonstriert, darunter die IBM Quantum 127-Qubit Eagle- und 133-Qubit Heron-Geräte.
- Anwendungsunabhängig: QESEM wurde für eine Vielzahl von Anwendungen demonstriert, darunter Hamiltonian Simulation, VQE, QAOA und Amplitudenabschätzung. Nutzer können beliebige Quantenschaltkreise und Observablen eingeben und genaue, fehlerfreie Ergebnisse erhalten. Die einzigen Einschränkungen werden durch die Hardware-Spezifikationen und die zugewiesene QPU-Zeit bestimmt, die die zugänglichen Schaltkreisvolumen und Ausgabegenauigkeiten festlegen. Im Gegensatz dazu sind viele Fehlerreduktionstechniken anwendungsspezifisch oder beinhalten unkontrollierte Heuristiken, die sie für generische Quantenschaltkreise und Anwendungen ungeeignet machen.
- Erweiterter Gate-Satz: QESEM unterstützt Gates mit gebrochenen Winkeln und stellt Qedma-optimierte -Gates mit gebrochenen Winkeln auf IBM Quantum Heron- und Eagle-Geräten bereit. Dieser erweiterte Gate-Satz ermöglicht eine effizientere Kompilierung und erschließt Schaltkreisvolumen, die um einen Faktor von bis zu 2 größer sind als bei der Standard-CX/CZ-Kompilierung.
- Multibasige Observablen: QESEM unterstützt Eingabe-Observablen, die aus vielen nicht-kommutierenden Pauli-Strings bestehen, wie generische Hamiltonians. Die Wahl der Messbasen und die Optimierung der QPU-Ressourcenallokation (Shots und Schaltkreise) wird dann automatisch von QESEM durchgeführt, um die erforderliche QPU-Zeit für die angeforderte Genauigkeit zu minimieren. Diese Optimierung, die Hardware-Fidelities und Ausführungsraten berücksichtigt, ermöglicht es dir, tiefere Schaltkreise auszuführen und höhere Genauigkeiten zu erzielen.
Benchmarks
QESEM wurde für eine große Bandbreite von Anwendungsfällen getestet. Die folgenden Beispiele können dir helfen, einzuschätzen, welche Arten von Workloads du mit QESEM ausführen kannst.
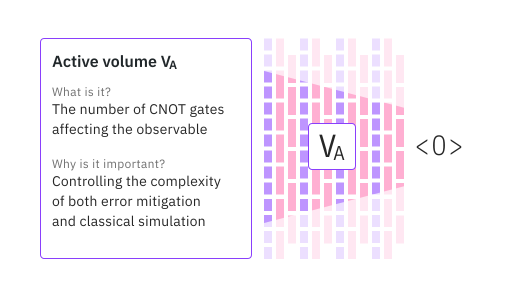
Eine wichtige Kennzahl zur Quantifizierung der Schwierigkeit von sowohl Error Mitigation als auch klassischer Simulation für einen gegebenen Schaltkreis und eine Observable ist das aktive Volumen: die Anzahl der CNOT-Gates, die die Observable im Schaltkreis beeinflussen. Das aktive Volumen hängt von der Schaltkreistiefe und -breite, dem Gewicht der Observable und der Schaltkreisstruktur ab, die den Lichtkegel der Observable bestimmt. Weitere Details findest du im Vortrag vom 2024 IBM Quantum Summit. QESEM bietet besonders großen Mehrwert im Hochvolumenbereich und liefert zuverlässige Ergebnisse für generische Schaltkreise und Observablen.
| Anwendung | Anzahl Qubits | Gerät | Schaltkreisbeschreibung | Genauigkeit | Gesamtzeit | Runtime-Nutzung |
|---|---|---|---|---|---|---|
| VQE-Schaltkreis | 8 | Eagle (r3) | 21 Gesamtschichten, 9 Messbasen, 1D-Kette | 98% | 35 Min. | 14 Min. |
| Kicked Ising | 28 | Eagle (r3) | 3 einzigartige Schichten x 3 Schritte, 2D Heavy-Hex-Topologie | 97% | 22 Min. | 4 Min. |
| Kicked Ising | 28 | Eagle (r3) | 3 einzigartige Schichten x 8 Schritte, 2D Heavy-Hex-Topologie | 97% | 116 Min. | 23 Min. |
| Trotterisierte Hamiltonian-Simulation | 40 | Eagle (r3) | 2 einzigartige Schichten x 10 Trotter-Schritte, 1D-Kette | 97% | 3 Std. | 25 Min. |
| Trotterisierte Hamiltonian-Simulation | 119 | Eagle (r3) | 3 einzigartige Schichten x 9 Trotter-Schritte, 2D Heavy-Hex-Topologie | 95% | 6,5 Std. | 45 Min. |
| Kicked Ising | 136 | Heron (r2) | 3 einzigartige Schichten x 15 Schritte, 2D Heavy-Hex-Topologie | 99% | 52 Min. | 9 Min. |
Die Genauigkeit wird hier relativ zum Idealwert der Observable gemessen: , wobei „" die absolute Präzision der Mitigation (vom Nutzer festgelegt) ist und den Erwartungswert der Observable im rauschfreien Schaltkreis bezeichnet. „Runtime-Nutzung" misst die Nutzung des Benchmarks im batch mode (Summe der Nutzung einzelner Jobs), während „Gesamtzeit" die Nutzung im session mode (Wall-Clock-Zeit des Experiments) misst, die zusätzliche klassische und Kommunikationszeiten einschließt. QESEM ist für die Ausführung in beiden Modi verfügbar, sodass Nutzer ihre verfügbaren Ressourcen optimal nutzen können.
Die 28-Qubit Kicked-Ising-Schaltkreise simulieren den von Shinjo et al. untersuchten Discrete Time Quasicrystal (siehe arXiv 2403.16718 und Q2B24 Tokyo) auf drei verbundenen Schleifen von ibm_kawasaki. Die hier verwendeten Schaltkreisparameter sind mit einem ferromagnetischen Anfangszustand . Die gemessene Observable ist der Absolutbetrag der Magnetisierung . Das Kicked-Ising-Experiment im Utility-Maßstab wurde auf den 136 besten Qubits von ibm_fez ausgeführt; dieser spezifische Benchmark wurde beim Clifford-Winkel ausgeführt, bei dem das aktive Volumen mit der Schaltkreistiefe langsam wächst – was zusammen mit den hohen Geräte-Fidelities eine hohe Genauigkeit bei kurzer Laufzeit ermöglicht.
Trotterisierte Hamiltonian-Simulations-Schaltkreise gelten für ein Transverse-Field-Ising-Modell bei gebrochenen Winkeln: und entsprechend (siehe Q2B24 Tokyo). Der Schaltkreis im Utility-Maßstab wurde auf den 119 besten Qubits von ibm_brisbane ausgeführt, während das 40-Qubit-Experiment auf der besten verfügbaren Kette ausgeführt wurde. Die Genauigkeit wird für die Magnetisierung angegeben; hochgenaue Ergebnisse wurden auch für höhergewichtige Observablen erzielt.
Der VQE-Schaltkreis wurde zusammen mit Forschern des Center for Quantum Technology and Applications am Deutschen Elektronen-Synchrotron (DESY) entwickelt. Die Zielobservable war hier ein Hamiltonian, der aus einer großen Anzahl nicht-kommutierender Pauli-Strings besteht, was QESEMs optimierte Leistung für multibasige Observablen unterstreicht. Die Mitigation wurde auf einen klassisch optimierten Ansatz angewendet; obwohl diese Ergebnisse noch unveröffentlicht sind, werden Ergebnisse gleicher Qualität für verschiedene Schaltkreise mit ähnlichen strukturellen Eigenschaften erzielt.
Erste Schritte
Authentifiziere dich mit deinem IBM Quantum Platform API-Schlüssel und wähle die QESEM Qiskit Function wie folgt aus. (Dieses Snippet setzt voraus, dass du dein Konto bereits in deiner lokalen Umgebung gespeichert hast.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Beispiele
Beispiel für einen Zeitabschätzungs-Job
Der Zeitabschätzungs-Job ist nützlich, um die für einen gegebenen pub und backend_name erforderliche QPU-Zeit abzuschätzen. backend_name kann auch auf ein beliebiges Simulator-Backend gesetzt werden, zum Beispiel fake_fez.
QESEM verwendet eine quasi-probabilistische, charakterisierungsbasierte EM-Methode. Diese Methode hat einen QPU-Zeit-Overhead, der ungefähr wie folgt skaliert:
Dabei ist das aktive Volumen des Schaltkreises, die Zielpräzision und die Infidelity der nativen Gates.
Beachte, dass "estimate_time_only": "empirical" einige Minuten QPU-Zeit verwendet, um die für den Job erforderliche Zeit abzuschätzen (wenn das Backend ein echtes Gerät ist; bei einem Simulator wird keine QPU-Zeit verwendet). Dies dauert in der Regel etwa 5 Minuten, aber nicht länger als 10 Minuten. Wenn sich die Infidelity zwischen dem empirischen Zeitabschätzungs-Job und dem Mitigations-Job drastisch ändert, ändert sich auch die QPU-Zeit drastisch.
Um loszulegen, probiere dieses grundlegende Beispiel zur Schätzung der erforderlichen QPU-Zeit für die Ausführung von QESEM für ein gegebenes pub:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
Das folgende Code-Snippet zeigt, wie verschiedene Ausführungsmetriken aus dem Zeitabschätzungs-Job abgerufen werden (wenn estimate_time_only gesetzt ist):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Wenn die empirische Zeitabschätzung aktiviert ist, führt QESEM eine kleine Anzahl von Schaltkreisen aus, um eine genauere QPU-Zeitschätzung zu liefern. Die Mitigationsergebnisse dieser Schaltkreise sind im Feld empirical_estimation_mitigation_results des Jobs verfügbar.
Da diese Ergebnisse aus einer begrenzten Stichprobe von Schaltkreisen abgeleitet werden, sind sie deutlich weniger genau als die endgültigen Ergebnisse des vollständigen QESEM-Mitigations-Jobs. Wenn der Schaltkreis jedoch klein ist oder die Zielpräzision niedrig ist, kann die während der empirischen Zeitabschätzung durchgeführte Mitigation ausreichen, um die gewünschte Präzision zu erreichen, sodass der vollständige Mitigations-Job möglicherweise nicht erforderlich ist.
Das Feld empirical_estimation_mitigation_results ist eine Liste von PrimitiveResult-Objekten pro Eingabeparameter. Wenn der Circuit nicht parametrisiert ist, hat die Liste die Länge 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Beispiel für einen QESEM-Mitigations-Job
Das folgende Beispiel führt einen QESEM-Job aus:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Eine detaillierte Beschreibung jedes Eingabefelds und jeder Option findest du in der QESEM-API-Referenz. Du kannst die vertrauten Qiskit Serverless APIs verwenden, um den Status deines Qiskit Function Workloads zu prüfen oder Ergebnisse abzurufen:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
Das folgende Code-Snippet demonstriert, wie die Mitigationsergebnisse und Ausführungsmetriken abgerufen werden. Diese enthalten wesentliche Daten, die ein tieferes Verständnis davon ermöglichen, wie verschiedene Parameter die QESEM-Ausführung beeinflussen. Sie können auch relevant sein, wenn du einen Artikel auf Basis deiner Forschung verfasst.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
In metadata["results"] werden die Ergebnisse zunächst nach Circuit-Instanz und dann nach Observable gruppiert.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Aufschlüsselung der Hauptergebnisse:
mitigated: der vollständig mitigierte QESEM-Erwartungswert.unmitigated: das rohe Ergebnis mit physikalischem Rauschen ohne Fehlermitigation.
QESEM-Ergebnisse der heuristischen Extrapolation
In einem Standard-QESEM-Lauf mit einem einzelnen precision-Float-Wert enthalten die Ergebnisse auch automatisch verfügbare Noise-Scaling-Punkte, die für die QESEM-Heuristik verwendet werden. Diese Punkte werden ohne zusätzliche QPU-Ressourcen berechnet.
Skala 1.0 steht für das physikalische Rauschniveau des Geräts mit Readout-Mitigation (REM), während Skala 2.0 der komplementäre, rauschverstärkte Punkt ist, ebenfalls mit REM. Diese Punkte werden verwendet, um das Ergebnis qesem_heuristic zu erzeugen.
-
qesem_heuristic: eine Schätzung im ZNE-Stil, berechnet aus den verfügbaren noise-skalierten Daten. Derzeit wird dafür exponentielle Extrapolation verwendet. -
noise_scaling.results_with_REM: Erwartungswerte bei unterschiedlichen Rauschskalen, alle mit Readout-Mitigation (REM).
Ein subtiles, aber wichtiges Detail ist, dass das Ergebnis bei Skala 1.0 nicht dasselbe ist wie das unmitigated-Ergebnis. Beide entsprechen dem physikalischen Rauschniveau des Geräts, aber der Punkt bei Skala 1.0 enthält Readout-Mitigation, während unmitigated dies nicht tut.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
Die folgenden Beispiele konzentrieren sich auf funktionsspezifische Eingaben und Ergebnisse, daher werden nicht jedes Mal die vollständigen Ausführungsmetriken ausgegeben. Die zuvor gezeigten übergeordneten Metadaten, wie total_qpu_time, gate_fidelities, total_shots, mitigation_shots und resource_usage, sind auch für diese Jobs verfügbar.
Einige Variablen aus den vorherigen Beispielen, darunter das Backend, die Observablen und die Basis-Circuit-Parameter, werden im Folgenden aus Gründen der Übersichtlichkeit wiederverwendet.
Alle folgenden Beispiele können auch mit empirischer Zeitschätzung ausgeführt werden. Um sie zu aktivieren, übergib "estimate_time_only": "empirical" in den Funktionsoptionen.
Beispiel für einen parametrisierten Circuit
Viele Algorithmen werten denselben Circuit bei mehreren Parameterwerten aus. Wenn du den parametrisierten Circuit als einen einzigen QESEM-Job sendest, kann QESEM die Charakterisierung und Kalibrierung über die Circuit-Instanzen hinweg gemeinsam nutzen, was den QPU-Zeit-Overhead im Vergleich zur Ausführung separater Jobs verringern kann.
Das Einreichen eines parametrisierten Schaltkreises erfordert die Verwendung der Transpilationsstufe "minimal_with_layout_opt".
Schaltkreise, die auf dieser Stufe eingereicht werden, sollten je nach Backend bereits mit dessen Basis-Gates ausgedrückt sein. Auf dieser Stufe hält QESEM die eingereichte Struktur so nah wie möglich am Eingabe-Schaltkreis, respektiert Barrieren während der Layerifizierung (Gruppierung von Operationen in Layer paralleler Zwei-Qubit-Gates) und übernimmt weiterhin automatisch das Hardware-Mapping auf Qubits mit hoher Fidelity sowie die Gerätekonnektivität.
In der Praxis bedeutet dies, dass du Schaltkreise vor dem Einreichen auf die Basis-Gates des Ziel-Backends transpilieren solltest. Ein einfaches Beispiel für die Basis-Gate-Transpilation ist unten dargestellt.
QESEM unterstützt derzeit nur ein Observable pro Parametersatz. Die beiden folgenden Parameterzeilen werden mit den beiden Observablen verknüpft: Die erste Zeile wird mit avg_magnetization gemessen und die zweite Zeile mit other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Multi-PUB-Beispiel
Die Multi-PUB-Ausführung ist nützlich, wenn du mehrere verwandte Schaltkreise in einem QESEM-Job ausführen möchtest. Wie bei der parametrisierten Ausführung kann dies den Overhead verringern, da QESEM die Charakterisierung und Kalibrierung über Schaltkreis-Instanzen hinweg gemeinsam nutzen kann, anstatt sie in separaten Jobs zu wiederholen.
Dies ist besonders nützlich für Schaltkreise mit einer gemeinsamen Layer-Struktur, wie zum Beispiel Trotter-artige Workloads, bei denen verschiedene Schaltkreise dieselben eindeutigen Layer wiederverwenden. In diesem Fall kann die gemeinsame Ausführung die Charakterisierungskosten im Vergleich zu unabhängigen QESEM-Jobs verringern.
Multi-PUB-Jobs erfordern "transpilation_level": "minimal_with_layout_opt". Wie im parametrisierten Beispiel sollten die Schaltkreise vor dem Einreichen auf die Basis-Gates des Ziel-Backends transpiliert werden. QESEM übernimmt anschließend intern die Gerätekonnektivität, das Layout und das Mapping auf Qubits mit hoher Fidelity.
Jeder PUB unten enthält einen Circuit und dieselben beiden Observablen, die zuvor im Notebook verwendet wurden, sodass das zurückgegebene PrimitiveResult ein PubResult pro Eingabe-Circuit enthält.
Das folgende Beispiel verwendet zwei einfache Trotter-Schaltkreise mit demselben Layer-Muster: circ_a hat einen Trotter-Layer, und circ_b wiederholt dasselbe Layer-Muster zweimal. Dies macht die gemeinsame Struktur explizit.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Beispiel für Quasi-Probabilistic Error Tuning (QET)
Quasi-Probabilistic Error Tuning (QET) fragt Erwartungswerte bei ausgewählten Rausch-Skalierungsfaktoren ab. Dies ist nützlich für individuelle Noise-Scaling-Studien und Zero-Noise-Extrapolation-Workflows. Skala 1.0 ist das physikalische Rauschniveau, Werte zwischen 0.0 und 1.0 reduzieren das Rauschen teilweise, und Werte über 1.0 verstärken das Rauschen.
Um QET mit der Qiskit Function zu verwenden, übergib ein Dictionary als PUB-Präzision. Das Dictionary ordnet jeder angeforderten Rauschskala ihre Zielpräzision zu. Die zurückgegebenen Skalierungsfaktor-Ergebnisse werden in noise_scaling.results_with_REM gespeichert und enthalten Readout-Mitigation. Der Punkt bei Skala 1.0 ist daher nicht identisch mit dem unmitigierten Wert, da 1.0 Readout-Mitigation enthält, während unmitigated dies nicht tut.
Wenn eine Skala angefordert wird, gibt QESEM auch die komplementäre Skala um 1.0 zurück, ohne zusätzliche QPU-Nutzung. Zum Beispiel kann das Anfordern von 0.5 auch 1.5 zurückgeben, und das Anfordern von 1.3 kann auch 0.7 zurückgeben. Die Präzision bei der komplementären Skala ist nicht garantiert.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Fehlermeldungen abrufen
Wenn der Status deines Workloads ERROR ist, verwende job.result(), um die Fehlermeldung wie folgt abzurufen:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Support erhalten
Das Qedma-Support-Team ist für dich da! Wenn du auf Probleme stößt oder Fragen zur Verwendung der QESEM Qiskit Function hast, zögere nicht, uns zu kontaktieren. Unser kompetentes und freundliches Support-Team steht dir bei technischen Anliegen oder Fragen jeder Art zur Verfügung.
Du kannst uns für Unterstützung unter support@qedma.com per E-Mail erreichen. Bitte gib so viele Details wie möglich zum aufgetretenen Problem an, damit wir dir schnell und präzise helfen können. Du kannst auch deinen dedizierten Qedma-POC-Ansprechpartner per E-Mail oder Telefon kontaktieren.
Um uns zu ermöglichen, dir effizienter zu helfen, stelle uns bitte folgende Informationen bereit, wenn du uns kontaktierst:
-
Eine detaillierte Beschreibung des Problems
-
Die Job-ID
-
Alle relevanten Fehlermeldungen oder -codes
Wir sind bestrebt, dir prompten und effektiven Support zu bieten, damit du mit unserer Qiskit Function die bestmögliche Erfahrung machst.
Wir sind stets bestrebt, unser Produkt zu verbessern, und freuen uns über deine Vorschläge! Wenn du Ideen hast, wie wir unsere Dienste oder Features verbessern können, sende uns deine Gedanken an support@qedma.com.
Nächste Schritte
-
Besuche die API-Referenz für diese Qiskit Function.
-
Probiere das Tutorial Simulate 2D tilted-field Ising with the QESEM function aus.