Parity Twine Optimizer: Eine Qiskit Function von ParityQC
Siehe die API-Referenz
Qiskit Functions sind ein experimentelles Feature, das nur Nutzern des IBM Quantum® Premium Plan, Flex Plan und On-Prem Plan (über die IBM Quantum Platform API) zur Verfügung steht. Sie befinden sich im Preview-Release-Status und können sich ändern.
Überblick
Der Parity Twine Optimizer ermöglicht es Nutzern, Optimierungsprobleme mit Quantencomputern mithilfe der Parity Twine-Methode zu lösen. Dieser Ansatz, der auf der Parity-Architektur aufbaut, nutzt den ParityQC-Compiler, um die für die Ausführung eines Quantenalgorithmus erforderliche Gate-Anzahl und Circuit-Tiefe zu minimieren und dabei die Konnektivität des Geräts zu berücksichtigen.
Diese Ressourcenreduktion ermöglicht die Lösung industrierelevanter Optimierungsprobleme in Größenordnungen, die mit standardmäßigen, SWAP-lastigen Transpilationsmethoden nicht durchführbar sind. Der Parity Twine Optimizer automatisiert Transpilationsschritte und kann mit minimalem Benutzeraufwand verwendet werden.
Der Parity Twine-Ansatz übertrifft alle anderen Kompilierungsmethoden bei der Reduzierung von Gate-Anzahlen und Circuit-Tiefen für Quantenalgorithmen wie den Quantum Approximate Optimization Algorithm (QAOA) und die Quantum Fourier Transform (QFT). Durch die Abstraktion von Quanteninformationen von den physischen Qubits werden nicht-lokale Interaktionen ohne SWAP-Gates implementiert. Stattdessen verteilen Parity Twine-Ketten (Sequenzen von CNOT-Gates) systematisch logische Paritätsinformationen zwischen Qubits.
Der Optimierer verwendet QAOA, um die Energie einer gegebenen Kostenfunktion zu minimieren. QAOA ist ein hybrider quantenklassischer Variationsalgorithmus, der entwickelt wurde, um kombinatorische Optimierungsprobleme zu lösen, indem er den Grundzustand eines Kosten-Hamiltonoperators () approximiert. Ein Mischterm () treibt Übergänge zwischen Zuständen an, um den Lösungsraum zu erkunden. Eine alternierende Sequenz dieser Terme, gesteuert durch die Parameter und , definiert den unitären Operator , der auf den Anfangszustand wirkt.
Die Kodierung des unitären Problemoperators, exp(), erfordert die Kodierung aller logischen -Körper-Rotationsoperatoren (exp()). Dies kann mithilfe von -Körper-Generatoren (Parity Twine-Netzwerken) erreicht werden, die die QAOA-Circuit-Tiefe und die Anzahl der Zwei-Qubit-Gates reduzieren.
Beschreibung
Die Eingabe des Parity Twine Optimizer besteht aus einem Optimierungsproblem, dem Namen der gewählten IBM Quantum-Hardware und zusätzlichen optionalen Argumenten, um die Transpilations- und Hardwareausführungseinstellungen anzupassen. Die Optimiererfunktion leitet die Problemdefinition an den Parity Twine Compiler weiter. Abbildung 1 zeigt eine Zusammenfassung des Funktions-Workflows.
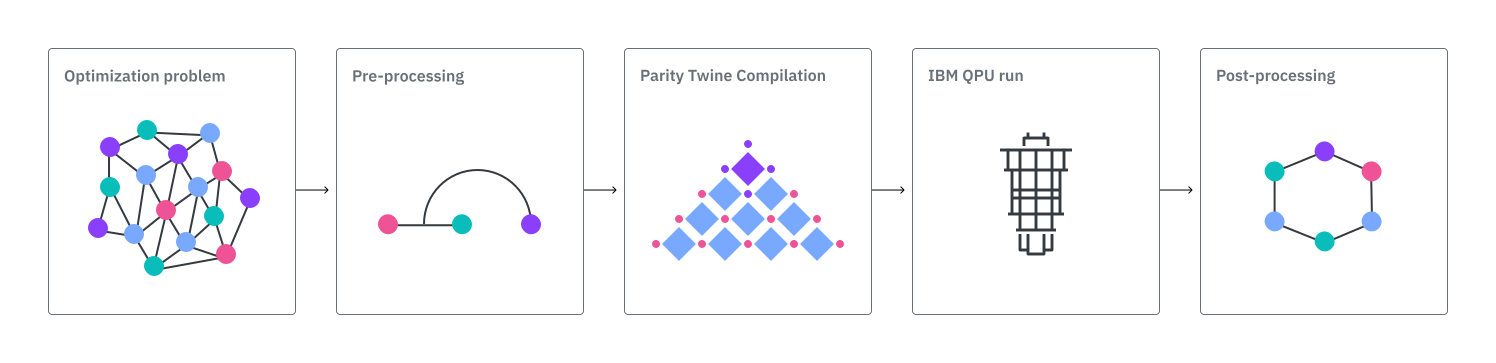
Das eingegebene Optimierungsproblem wird zu einem (normalisierten) Hamiltonoperator vorverarbeitet. Der ParityQC-Compiler konstruiert dann einen parametrisierten Parity Twine-Ansatz-Circuit, der zu einem logischen Ansatz transpiliert wird, der dem nativen Gate-Set der gewählten Hardware entspricht.
Die QAOA-Circuit-Parameter werden klassisch mithilfe des „Efficient Depth One“-Ansatzes optimiert und dem transpilierten Circuit zugewiesen. Da eine Runde von QAOA verwendet wird, werden optimale - und -Parameter mittels einer Rastersuche (Grid Search) auf einer CPU ermittelt, ohne dass eine aufwendige iterative Optimierung über viele Circuit-Aufrufe erforderlich ist. Dies minimiert die benötigte QPU-Laufzeit des Optimierers erheblich. Die Ausführungszeit pro Circuit wird größtenteils durch den konstanten Overhead zur Ausführung eines Jobs auf der QPU bestimmt. Mit den festgelegten Circuit-Parametern wird der Job an die angegebene IBM® QPU übermittelt.
Die Rohergebnisse werden anschließend nachbearbeitet. Dieser Schritt verwendet eine lokale Greedy-Suche, die zufällig durch den Lösungsstring iteriert und Bitwerte umkehrt, wenn dies den Wert der Kostenfunktion reduziert.
Benchmarks
Die Performance kann sowohl von der Probleminstanz als auch von den nachfolgenden Verarbeitungsschritten abhängen. In manchen Fällen können klassische Samples und quantengenerierte Samples nach äquivalenter Nachbearbeitung eine ähnliche finale Lösungsqualität erreichen. Die Bewertung sollte daher den gesamten Optimierungsworkflow berücksichtigen.
Sherrington-Kirkpatrick-Modell
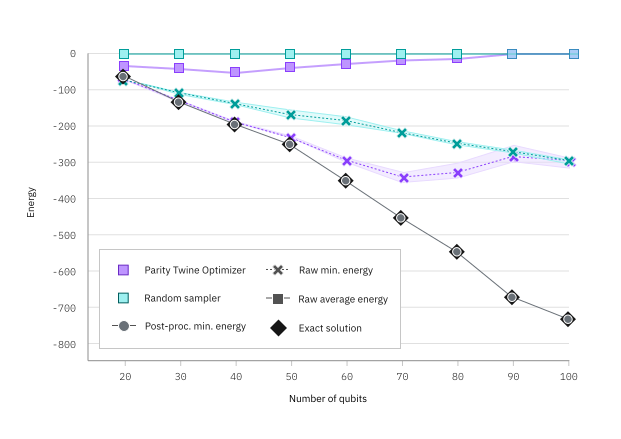
Abbildung 2 demonstriert die Effektivität des Parity Twine Optimizer. Diese vergleicht die mit dem Optimierer erzielten Ergebnisse mit Zufalls-Sampling für das Sherrington-Kirkpatrick-Modell bei zunehmender Qubit-Anzahl.
Die Nachbearbeitung sowohl der Zufalls- als auch der Optimierer-Ergebnisse führt zu exakten Grundzuständen, aber die rohe Minimalenergie-Ausgabe von Twine QAOA ist stets besser als Zufallswerte. Bei den größten betrachteten Qubit-Anzahlen (90 und 100) verschlechtert Hardware-Rauschen das Optimiererergebnis, sodass es auf Rohwerte zurückfällt, die dem Zufalls-Sampling entsprechen.
Siehe dieses Tutorial für eine Einführung in das Sherrington-Kirkpatrick-Modell und Details dazu, wie es mit dem Parity Twine Optimizer gelöst wird.
Market-Split-Problem
Tabelle 1 zeigt spezifische Leistungskennzahlen für den Parity Twine Optimizer, angewendet auf verschiedene Instanzen des Market-Split (MS)-Problems. Diese wurden aus der QOBLIB - Quantum Optimization Benchmarking Library gewonnen und entsprechen den Einreichungen, die mit dem Parity Twine Optimizer in der Bibliothek vorliegen.
MS-Violation ist eine Genauigkeitsmetrik, die misst, wie weit die Lösung davon entfernt ist, alle Constraints zu erfüllen, definiert als . Niedrigere Werte dieser Metrik deuten auf genauere Lösungen hin.
Tabelle 1 zeigt gemittelte Werte für fünf Durchläufe jeder Instanz mit dem Parity Twine Optimizer, wobei ibm_boston als Backend und 100.000 Shots verwendet wurden.
Es wird die minimale MS-Violation aus den Durchläufen jeder Instanz angegeben.
| Instanz | Qubits | Zwei-Qubit-Gates | Zwei-Qubit-Tiefe | MS-Violation | Mapping-Zeit (s) | QPU-Laufzeit (s) | Nachbearbeitungszeit (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tabelle 1: Leistungskennzahlen für verschiedene Instanzen des Market-Split-Problems. Die Instanznamen entsprechen den zugehörigen Beispielen in der QOBLIB-Problembibliothek. Wie bereits im Beschreibungsabschnitt erwähnt, ist die QPU-Zeit minimal und nahezu konstant, da nur eine Runde von QAOA mit optimalen, auf einer CPU ermittelten Circuit-Parametern verwendet wird.
Siehe dieses Tutorial für eine Einführung in das Market-Split-Problem und Details dazu, wie es mit dem Parity Twine Optimizer gelöst wird.
Maximum-Independent-Set-Problem
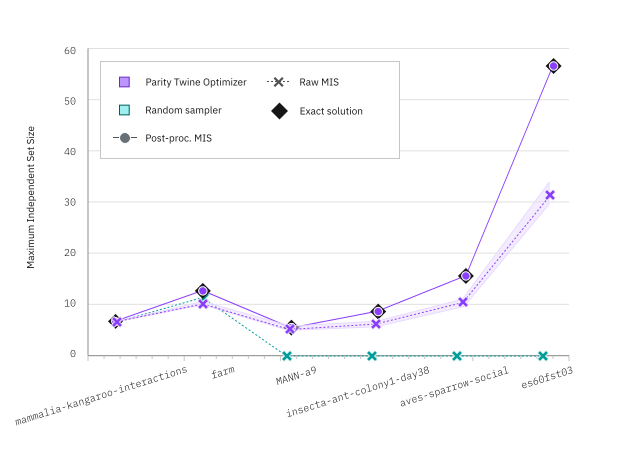
Abbildung 3 vergleicht die mit dem Parity Twine Optimizer erzielten Ergebnisse mit Zufalls-Sampling für das Maximum-Independent-Set-Problem anhand ausgewählter Instanzen, die aus der QOBLIB - Quantum Optimization Benchmarking Library stammen. Diese reichen von 18 (mammalia-kangaroo-interactions) bis 114 (es60fst03) Qubits.
Bei kleinen Instanzen sind die rohen Ergebnisse der Maximum-Independent-Set-Größe vom Optimierer und vom Zufalls-Sampling ähnlich, aber bei größeren Instanzen liefert der Optimierer deutlich bessere Ergebnisse. Die Nachbearbeitung sowohl der zufällig gesampelten als auch der Optimierer-Ergebnisse führt wiederum zu Mengengrößen, die mit den exakten Werten übereinstimmen.
Erste Schritte
Authentifiziere dich mit deinem IBM Quantum Platform API-Token und wähle die Qiskit Function wie folgt aus:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Beispiel
Der Parity Twine Optimizer kann wie folgt auf ein einfaches QUBO-Beispiel angewendet werden. Das Problem wird zunächst mithilfe eines Dictionary definiert:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Anschließend muss der Variablentyp als binary oder spin definiert werden:
variable_type = "spin"
Dies definiert die Zielfunktion , wobei .
Wähle ein Backend. Zum Beispiel:
backend_name = "ibm_phoenix"
Verwende catalog.backends(), um eine Liste der verfügbaren Backends aus dem Benutzerkonto/der Instance anzuzeigen.
Wenn kein Backend angegeben wird, wird automatisch das am wenigsten ausgelastete Backend (das mit der geringsten Anzahl ausstehender Jobs) ausgewählt.
Sobald der Optimierer geladen ist (siehe oben), kannst du ihn mit den Standardoptionen auf das Problem anwenden:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Überprüfe den Job-Status wie folgt:
# Monitor the job status
function_job.status()
Rufe die Ergebnisse wie folgt ab:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Das Ausgeben der Ergebnisse liefert Folgendes:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Das solution-Dictionary entspricht den im Problem definierten Qubits ( und ) und gibt deren optimierte Spin-Werte an.
Der objective_value gibt die Kosten bzw. Energie des Optimierungsproblems an. Er quantifiziert die Qualität der solution.
metadata liefert Informationen zur Transpilation (Zwei-Qubit-Gate-Anzahl/-Tiefe, verwendete Gates, aktive Qubits) sowie verschiedene Laufzeiten sowohl für Quanten- als auch für klassische Rechenzeit.
Zusätzlich gibt metadata einen Einblick in die interne Funktionsweise des Algorithmus. Du kannst die optimierten variationellen Parameter (beta und gamma) einsehen und nachvollziehen, wie sich die Verteilung der gemessenen Bitstrings verbessert hat, nachdem klassische Nachbearbeitung auf die rohen Quantenergebnisse angewendet wurde.
Alle Bitstrings in der Ergebnisausgabe können mithilfe des variable_mapping auf die Problemvariablen abgebildet werden.
Zum Beispiel kannst du 'solution_bitstring': '100' mit 'variable_mapping': {'0': 0, '1': 1, '2': 2} auf die binäre Lösung abbilden: {'0': 1, '1': 0, '2': 0}.
Da du das Problem in Bezug auf Spin-Variablen löst, musst du die Binär-zu-Spin-Transformation anwenden (0 -> 1, 1 -> -1 ).
Du gelangst dann zur endgültigen Lösung 'solution': {'0': -1, '1': 1, '2': 1}.
Siehe die API-Referenz für vollständige Details zur Eingabe und Ausgabe der Parity Twine Optimizer-Funktion.
Änderungsprotokoll
[1.0.2] - 2026-09-15
Notes
Dieses Release markiert die erste stabile Produktionsversion der Parity Twine Optimizer Qiskit Function. Zukünftige Releases werden voraussichtlich Folgendes einführen:
- Kompilierung von Problemen höherer Ordnung,
- zusätzliche Optimierungsalgorithmen und
- Verbesserungen bei der Vor- und Nachbearbeitung.
Funktionen
- Löse dünnbesetzte und dichte QUBO-Probleme mit dem effizienten Parity Twine Compiler.
Dokumentation
- Erste-Schritte-Benutzerhandbuch.
- Tutorials mit Beispielen für Market-Split- und Sherrington-Kirkpatrick-Probleme.
- API-Dokumentation.
Support erhalten
Kontaktiere ParityQC bei Fragen oder Problemen.
Nächste Schritte
- Fordere Zugriff auf die Funktion an, indem du dieses Formular ausfüllst.
- Besuche die API-Referenz für diese Qiskit Function.
- Probiere das Tutorial aus, um den Parity Twine Optimizer auf das Market-Split-Problem anzuwenden.
- Probiere das Tutorial aus, um den Parity Twine Optimizer auf das Sherrington-Kirkpatrick-Modell anzuwenden.
- Lies das ArXiv-Preprint Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).