QFT-Prozessfidelity mit Orbit benchmarken, einer Qiskit Function von Quantum Elements
Geschätzte Nutzungsdauer: 2 Minuten auf einem Heron-r3-Prozessor. (HINWEIS: Dies ist nur eine Schätzung. Deine tatsächliche Laufzeit kann abweichen.) Standardmäßig reicht dieses Tutorial einen Orbit-Function-Job über einen serverseitigen IBM Quantum Compute Service Runtime Batch mit drei untergeordneten Jobs, 300 PUBs pro untergeordnetem Job und insgesamt 921.600 Shots ein.
Warnung: Dynamische Circuits sind derzeit ein experimentelles Feature und unterliegen Einschränkungen in Quantum Compute [3], die zu Job-Fehlern führen können. Zum Beispiel zeigt der Fehler 6073 an, dass ein Job das Speicherlimit der klassischen Steuerungshardware überschritten hat [4]. Dieses Notebook verringert dieses Risiko, indem es die Circuit-Größen auf drei untergeordnete Jobs des Runtime Batch aufteilt [5]. Jeder Vergleich mit fester Größe bleibt in einem untergeordneten Job, während große und kleine Größen gepaart werden, um die Workloads der klassischen Steuerung der Jobs auszugleichen.
Lernziele
-
Bereite die Produktzustände vor, die vom gesampelten Prozessfidelity-Schätzer in Abbildung 2a von Ref. [1] verwendet werden.
-
Baue äquivalente unitäre und dynamische Implementierungen der Quanten-Fourier-Transformation gefolgt von einer Messung.
-
Wähle physische Qubits für die dynamischen Circuits anhand aktueller Kalibrierungs- und Konnektivitätsdaten aus.
-
Vergleiche Schätzungen der QFT-Prozessfidelity für die rohe unitäre, die rohe dynamische und die Orbit-verbesserte dynamische Variante mit wachsender Circuit-Größe.
-
Reiche eine Orbit-Workload über die batch mode API ein, wobei jeder Vergleich der drei Strategien bei fester Größe in einem child Job bleibt.
-
Überprüfe die Orbit-Metadaten, um zu bestätigen, ob Dynamical Decoupling (DD) und Measurement-Error-Mitigation (MEM) angewendet wurden.
Hintergrund
Abbildung 2a von Ref. [1] vergleicht die Prozessfidelity des idealen QFT+M-Kanals mit verrauschten unitären und dynamischen Implementierungen. Für ein gesampeltes Label in der Rechenbasis bereitet der Benchmark vor, wendet die verrauschte QFT+M-Implementierung an und schätzt die Wahrscheinlichkeit , die entsprechende ideale Ausgabe zu erhalten. Diese Inverse-QFT-Zustände sind separabel und können effizient mit Hadamard-Gates und virtuellen Phasenrotationen vorbereitet werden.
Für unabhängig gesampelte Labels verwendet das Notebook den unverzerrten Schätzer, der in Ref. [1] hergeleitet wird:
Die dynamische Konstruktion ersetzt die Controlled-Phase-Gates des unitären QFT+M durch Mid-Circuit-Messungen und klassisch bedingte Phasenrotationen [1]. Durch aufgeschobene Messung haben beide Circuits dieselbe ideale Ausgabeverteilung. Die unitäre Implementierung benötigt Zwei-Qubit-Gates zwischen allen Paaren und verursacht wegen lokaler Konnektivitätsbeschränkungen einen SWAP-Gate-Overhead von . Im Gegensatz dazu verwendet der dynamische Circuit nur Ein-Qubit-Gates und Mid-Circuit-Messungen, die in der Mitte lange Leerlaufzeiten einführen. Wenn man DD ganz außer Acht lässt, besteht der grundlegende Wettbewerb also zwischen verrauschten unitären Gates und verrauschten Mid-Circuit-Messungen. Sofern die Leerlaufzeiten während dieser Mid-Circuit-Messungen fehlerarm genug sind, übertrifft der dynamische Circuit die unitären Implementierungen, und wir zeigen unten, dass sich dies mit Orbit erreichen lässt.
Bezug zu Abbildung 2a. Dieses Notebook folgt dem im Paper beschriebenen Protokoll zur gesampelten Prozessfidelity, ist jedoch eine Orbit-fokussierte Tutorial-Adaption und keine Reproduktion. Während Abbildung 2a beispielsweise ibm_kyiv mit 2000 Shots verwendete, nutzen wir ein moderneres Gerät, ibm_aachen, mit einer kleineren Anzahl von 1024 Shots, um QPU-Zeit zu sparen.
Beispielergebnisse
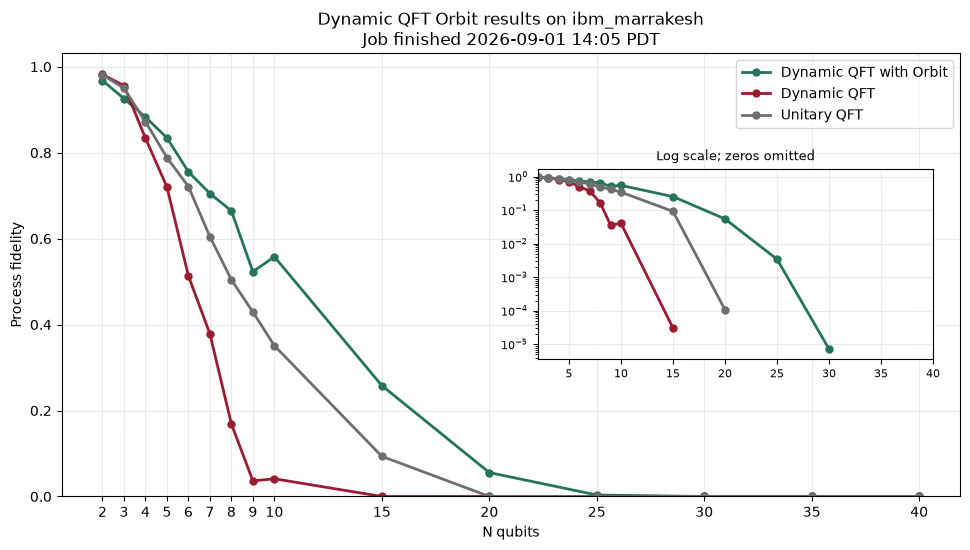
Der statische Plot unten zeigt die mittleren Prozessfidelity-Kurven aus drei aufeinanderfolgenden Entwicklungs-Jobs, die auf ibm_aachen mit dem unten beschriebenen Prozess ausgeführt wurden. Wie hier gezeigt wird, kann Orbit die Qualität dynamischer Circuits deutlich steigern; die dynamische QFT erreicht die Qualität veröffentlichter Benchmarks und zeigt eine Verbesserung gegenüber der standardmäßigen unitären QFT. Wie wir sehen werden, resultieren diese Ergebnisse aus einer automatisierten guten Wahl der Qubits, automatischer Einfügung von Dynamical Decoupling (nicht speziell für dieses Problem handoptimiert) und Measurement-Error-Mitigation. Zum Spaß solltest du diese Ergebnisse am Ende mit deinen eigenen Ergebnissen vergleichen, besonders wenn du ein anderes Backend wählst.
Hinweis: Diese Ergebnisse sind eine veranschaulichende Momentaufnahme eines früheren erfolgreichen Laufs mit Orbit und keine Leistungsgarantie. Die folgenden Ergebnisse sollten qualitativ ähnlich aussehen, aber die genauen Werte hängen vom gewählten Gerät und seinen Eigenschaften ab, insbesondere von Mess- und Idle-Fehlern zur Laufzeit.

# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
Voraussetzungen
Installiere die neuesten Versionen der folgenden Pakete, bevor du dieses Tutorial ausführst:
-
numpy -
matplotlib -
qiskit -
qiskit-ibm-runtime -
qiskit-ibm-catalog
pip install qiskit qiskit-ibm-runtime qiskit-ibm-catalog numpy matplotlib
Setup
Authentifiziere dich bei IBM Quantum® Platform, lade ibm_aachen und lade Quantum Elements Orbit aus dem Qiskit Functions Catalog.
N_VALUES ist die Liste der Circuit-Größen: Jeder Wert ist die Anzahl der logischen Qubits in einem QFT-Circuit. M ist die Anzahl unabhängig gesampelter Basislabels , die für jede Größe ausgewertet werden; im Fidelity-Schätzer ist dies das in der obigen Gleichung. Für jedes Paar (N, x) reicht das Notebook ein PUB für jede der drei Strategien ein, sodass eine feste Größe 3 * M PUBs und 3 * M * SHOTS Circuit-Shots beiträgt.
Der Standard-Sweep wertet daher 15 Circuit-Größen, 20 gesampelte Bitstrings pro Größe und drei Strategien aus. NUM_BATCH_PARTITIONS=3 legt die drei geordneten Runtime-Batch-Partitionen fest, und BATCH_MAX_PUBS_PER_JOB wird über orbit.run(...) als JSON-Konfiguration übergeben. Große N_VALUES erzeugen komplexere dynamische Circuits, während ein größeres M mehr PUBs in jeden untergeordneten Job legt; beides kann den Druck auf den Speicher der klassischen Steuerung des Backends erhöhen. Wenn ein einzelner untergeordneter Job mit dynamischen Circuits dieses Limit erreicht, verringere N_VALUES oder M, oder erhöhe NUM_BATCH_PARTITIONS. Verringere SHOTS, wenn das Ziel ist, die Ausführungsnutzung zu senken statt die Anzahl oder Komplexität der Circuits.
OPTIMIZATION_LEVEL=0 weist den Transpiler von Qiskit an, die erforderliche Übersetzung und das Routing mit minimaler Optimierung durchzuführen. Wir verwenden dies, um die explizit gewählten Layouts der dynamischen Circuits zu erhalten und die Rohvergleiche leichter interpretierbar zu machen. Die Stufen 1–3 sind gültige Experimente, können aber Circuits umschreiben oder vereinfachen und die gewählte Platzierung verändern; sie bieten hier wenig erwarteten Nutzen, da der dynamische Circuit keine Zwei-Qubit-Gates und keine Konnektivitätsbeschränkung hat. Wenn du die Stufe änderst, führe den Benchmark erneut aus und behandle die Ergebnisse als separaten Vergleich.
import warnings
from collections import Counter, defaultdict

import matplotlib.pyplot as plt
import numpy as np
from qiskit import (
    ClassicalRegister,
    QuantumCircuit,
    QuantumRegister,
    transpile,
)
from qiskit.circuit import IfElseOp
from qiskit.synthesis.qft import synth_qft_full
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from qiskit_ibm_runtime import QiskitRuntimeService

IBM_BACKEND_NAME = "ibm_marrakesh"  # Change to your preferred backend

# N_VALUES contains circuit sizes in logical qubits; M is samples per size.
N_VALUES = [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40]
M = 20
# Each sample is run with this many shots for each of the three strategies.
SHOTS = 1024
# Transpilation options.
OPTIMIZATION_LEVEL = 0  # Level 0 preserves the explicitly selected layouts and dynamic structure.
RNG_SEED = 12345  # Reproducible transpilation seed.
# Batch partitioning options.
NUM_BATCH_PARTITIONS = 3
STRATEGY_LABELS = ("unitary/raw", "dynamic/raw", "dynamic/orbit")

def balanced_n_groups(
    n_values: list[int], num_jobs: int = 3
) -> list[list[int]]:
    """Pair circuit sizes into balanced Runtime Batch partitions."""
    values = sorted(n_values)
    if len(set(values)) != len(values):
        raise ValueError("N_VALUES must not contain duplicates")
    if not 1 <= num_jobs <= len(values):
        raise ValueError(
            "NUM_BATCH_PARTITIONS must be between 1 and len(N_VALUES)"
        )

    max_group_size = (len(values) + num_jobs - 1) // num_jobs
    groups = [[] for _ in range(num_jobs)]
    loads = [0] * num_jobs
    pair_counts = [0] * num_jobs
    remaining = values.copy()

    while len(remaining) >= 2:
        candidates = [
            i
            for i, group in enumerate(groups)
            if len(group) + 2 <= max_group_size
        ]
        if not candidates:
            break
        smallest = remaining.pop(0)
        largest = remaining.pop()
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        pair = (
            [largest, smallest]
            if pair_counts[job_index] % 2 == 0
            else [smallest, largest]
        )
        groups[job_index].extend(pair)
        loads[job_index] += smallest + largest
        pair_counts[job_index] += 1

    while remaining:
        value = remaining.pop()
        candidates = [
            i for i, group in enumerate(groups) if len(group) < max_group_size
        ]
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        groups[job_index].append(value)
        loads[job_index] += value

    return groups

N_GROUPS = balanced_n_groups(N_VALUES, NUM_BATCH_PARTITIONS)

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend(IBM_BACKEND_NAME)
if "if_else" not in backend.target.operation_names:
    backend.target.add_instruction(IfElseOp, name="if_else")

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
quantum_elements_orbit = catalog.load("quantum-elements/orbit")
if quantum_elements_orbit is None:
    raise RuntimeError(
        "Quantum Elements Orbit is not enabled for this IBM Quantum instance."
    )

required_qubits = max(N_VALUES)
if backend.num_qubits < required_qubits:
    raise ValueError(
        f"Backend {backend.name} has {backend.num_qubits} qubits, "
        f"but this benchmark needs at least {required_qubits}."
    )

{
    "orbit version": quantum_elements_orbit.version,
    "backend": backend.name,
    "num_qubits": backend.num_qubits,
    "n_values": N_VALUES,
    "m": M,
    "shots": SHOTS,
    "num_function_jobs": 1,
    "num_runtime_batch_partitions": NUM_BATCH_PARTITIONS,
    "n_groups": N_GROUPS,
    "pubs_per_partition": [
        len(group) * M * len(STRATEGY_LABELS) for group in N_GROUPS
    ],
    "total_pubs": len(N_VALUES) * M * len(STRATEGY_LABELS),
    "total_shots": len(N_VALUES) * M * len(STRATEGY_LABELS) * SHOTS,
}
{'orbit version': '0.3.23',
 'backend': 'ibm_marrakesh',
 'num_qubits': 156,
 'n_values': [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40],
 'm': 20,
 'shots': 1024,
 'num_function_jobs': 1,
 'num_runtime_batch_partitions': 3,
 'n_groups': [[40, 2, 7, 15, 10], [35, 3, 6, 20, 9], [30, 4, 5, 25, 8]],
 'pubs_per_partition': [300, 300, 300],
 'total_pubs': 900,
 'total_shots': 921600}
QFT-Circuits erstellen
Für jede gesampelte ganze Zahl bereitet bit_inv_qft den Produktzustand mit Hadamard-Gates gefolgt von Phasenrotationen vor. Das Notebook hängt dann entweder die standardmäßige unitäre QFT oder ihr semiklassisches dynamisches QFT-Äquivalent an.
Beide Implementierungen lassen das abschließende Swap-Netzwerk weg. Die Anzeigereihenfolge der klassischen Bits in Qiskit macht daher den erwarteten gemessenen String zur Umkehrung der mit Nullen aufgefüllten Binärdarstellung von , die durch format(x, f"0{n}b")[::-1] kodiert wird.
def bit_inv_qft(circuit: QuantumCircuit, x: int, conv: str = "LSB") -> None:
    """Prepare QFT†|x⟩ as a product state on `circuit`."""
    num_qubits = circuit.num_qubits
    circuit.h(range(num_qubits))
    for j in range(num_qubits):
        phase = (
            2 * np.pi * x / 2 ** (num_qubits - j)
            if conv == "LSB"
            else 2 * np.pi * x / 2 ** (j + 1)
        )
        circuit.p(-phase, j)

def build_unitary_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    """Build a unitary QFT circuit for sampled basis label `x`."""
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"unitary_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    circuit.append(
        synth_qft_full(num_qubits, do_swaps=False), range(num_qubits)
    )
    circuit.measure(range(num_qubits), range(num_qubits))
    return circuit

def _warn_if_precision_loss(max_num_entanglements: int) -> None:
    """Warn when the smallest QFT rotation may lose float precision."""
    if max_num_entanglements > -np.finfo(float).minexp:
        warnings.warn(
            "precision loss in QFT."
            f" The rotation needed to represent {max_num_entanglements} entanglements"
            " is smaller than the smallest normal floating-point number.",
            category=RuntimeWarning,
            stacklevel=4,
        )

def synth_dynamic_qft(
    circuit: QuantumCircuit, *, do_swaps: bool = False
) -> QuantumCircuit:
    """Append semiclassical dynamic QFT operations to `circuit`."""
    num_qubits = circuit.num_qubits
    creg = circuit.cregs[0]
    _warn_if_precision_loss(num_qubits - 1)

    for j in reversed(range(num_qubits)):
        circuit.h(j)
        circuit.measure([j], [j])

        if j > 0:
            with circuit.if_test((creg[j], 1)):
                for k in reversed(range(j)):
                    circuit.p(np.pi * (2.0 ** (k - j)), k)

    if do_swaps:
        for i in range(num_qubits // 2):
            circuit.swap(i, num_qubits - i - 1)
    return circuit

def build_dynamic_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    """Build a dynamic QFT circuit for sampled basis label `x`."""
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"dynamic_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    synth_dynamic_qft(circuit, do_swaps=False)
    return circuit

def target_output_bitstring(x: int, n_qubits: int) -> str:
    """Return Qiskit's expected measured bitstring for basis label `x`."""
    return format(int(x), f"0{n_qubits}b")[::-1]

def process_fidelity_from_success_probabilities(
    success_probabilities: list[float],
) -> float:
    """Estimate process fidelity from sampled success probabilities."""
    m = len(success_probabilities)
    if m <= 1:
        raise ValueError(
            "m must be larger than 1 for the process-fidelity estimator"
        )
    succ = np.asarray(success_probabilities, dtype=float)
    return float(
        (m / (m - 1)) * (np.mean(np.sqrt(succ)) ** 2)
        - np.sum(succ) / (m * (m - 1))
    )
Physische Qubits für den dynamischen Circuit auswählen
Die dynamische Implementierung benötigt keine Zwei-Qubit-Gates, daher müssen ihre physischen Qubits keinen zusammenhängenden Teilgraphen bilden. Für jede Circuit-Größe bewertet der Selektor die aktuellen Backend-Qubits anhand eines Scores, der zu 80 % auf einen niedrigeren Readout-Fehler und zu je 10 % auf höhere - und -Werte gewichtet ist. Er wählt zunächst nach Möglichkeit hoch bewertete Qubits ohne direkte Kopplungen untereinander aus, was die Anfälligkeit für Nearest-Neighbor-Crosstalk verringern kann, und füllt dann verbleibende Positionen nach Score auf.
Die Varianten dynamic/raw und dynamic/orbit verwenden für eine gegebene Größe genau dasselbe ausgewählte Layout, wodurch ihr Vergleich layoutkontrolliert ist. Der Circuit unitary/raw wird stattdessen vom Transpiler gemappt und geroutet, da er Zwei-Qubit-Konnektivität benötigt. Diese kalibrierungsbasierte Auswahl zur Laufzeit ist spezifisch für dieses Tutorial; es handelt sich nicht um das feste 40-Qubit-Layout von ibm_kyiv, das für die Experimente zu Abbildung 2a im Paper verwendet wurde.
def value_from_property(raw):
    """Extract a numeric value from a backend property record."""
    if raw is None:
        return None
    if isinstance(raw, tuple):
        return raw[0]
    return getattr(raw, "value", raw)

def qubit_property_value(properties, qubit: int, *names: str) -> float | None:
    """Read the first available backend property for one qubit."""
    for name in names:
        try:
            value = value_from_property(
                properties.qubit_property(qubit, name)
            )
        except Exception:
            value = None
        if value is not None:
            return float(value)
    return None

def measurement_error(properties, qubit: int) -> float | None:
    """Return readout error, deriving it from asymmetric errors if needed."""
    readout = qubit_property_value(properties, qubit, "readout_error")
    if readout is not None:
        return readout
    p01 = qubit_property_value(properties, qubit, "prob_meas0_prep1")
    p10 = qubit_property_value(properties, qubit, "prob_meas1_prep0")
    if p01 is not None and p10 is not None:
        return 0.5 * (p01 + p10)
    return None

def coupling_edges(backend) -> list[tuple[int, int]]:
    """Return directed coupling-map edges as integer pairs."""
    coupling_map = getattr(backend, "coupling_map", None)
    if coupling_map is not None:
        try:
            return [(int(a), int(b)) for a, b in coupling_map.get_edges()]
        except Exception:
            pass
    built = backend.target.build_coupling_map()
    return [(int(a), int(b)) for a, b in built.get_edges()]

def neighbor_map(backend) -> dict[int, set[int]]:
    """Build an undirected neighboring-qubit map from backend connectivity."""
    neighbors = {qubit: set() for qubit in range(backend.num_qubits)}
    for a, b in coupling_edges(backend):
        neighbors[a].add(b)
        neighbors[b].add(a)
    return neighbors

def anchored_score(
    value: float | None, *, good: float, bad: float, higher_is_better: bool
) -> float:
    """Normalize a calibration value to a [0, 1] quality score."""
    if value is None:
        return 0.0
    if higher_is_better:
        low, high = sorted((bad, good))
        score = (value - low) / (high - low)
    else:
        low, high = sorted((good, bad))
        score = (high - value) / (high - low)
    return float(min(1.0, max(0.0, score)))

def qubit_metrics(backend) -> list[dict]:
    """Collect and rank calibration metrics for all backend qubits."""
    properties = backend.properties()
    rows = []
    for qubit in range(backend.num_qubits):
        t1 = qubit_property_value(properties, qubit, "T1", "t1")
        t2 = qubit_property_value(properties, qubit, "T2", "t2")
        meas_error = measurement_error(properties, qubit)
        measurement_score = anchored_score(
            meas_error, good=0.005, bad=0.05, higher_is_better=False
        )
        t1_score = anchored_score(
            t1, good=0.00025, bad=0.00005, higher_is_better=True
        )
        t2_score = anchored_score(
            t2, good=0.00025, bad=0.00005, higher_is_better=True
        )
        rows.append(
            {
                "qubit": qubit,
                "t1": t1,
                "t2": t2,
                "measurement_error": meas_error,
                "score": 0.8 * measurement_score
                + 0.1 * t1_score
                + 0.1 * t2_score,
            }
        )
    return sorted(rows, key=lambda row: row["score"], reverse=True)

def select_dynamic_qubits(backend, n_qubits: int) -> list[int]:
    """Choose high-scoring, preferably nonadjacent qubits for dynamic circuits."""
    ranked = qubit_metrics(backend)
    neighbors = neighbor_map(backend)
    selected = []
    blocked = set()
    for row in ranked:
        qubit = row["qubit"]
        if qubit in blocked:
            continue
        selected.append(qubit)
        blocked.add(qubit)
        blocked.update(neighbors.get(qubit, set()))
        if len(selected) == n_qubits:
            return selected

    for row in ranked:
        qubit = row["qubit"]
        if qubit not in selected:
            selected.append(qubit)
        if len(selected) == n_qubits:
            return selected
    raise RuntimeError(f"Could not select {n_qubits} physical qubits")

print("The top 3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[0:3])
print("Worst  3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[-3:])
The top 3 qubits (according to our scoring):
[{'qubit': 35, 't1': 0.0004024167194138543, 't2': 0.0003811132194981602, 'measurement_error': 0.003662109375, 'score': 1.0}, {'qubit': 92, 't1': 0.0003281277199162346, 't2': 0.0002414989126012369, 'measurement_error': 0.00390625, 'score': 0.9957494563006185}, {'qubit': 5, 't1': 0.0002919284700896914, 't2': 0.0002184196315970577, 'measurement_error': 0.00537109375, 'score': 0.9776125935763066}]
Worst  3 qubits (according to our scoring):
[{'qubit': 76, 't1': 7.65424382656864e-05, 't2': 3.438638139929193e-05, 'measurement_error': 0.05859375, 'score': 0.013271219132843196}, {'qubit': 26, 't1': 7.000219049917298e-06, 't2': 7.849466281257113e-06, 'measurement_error': 0.1009521484375, 'score': 0.0}, {'qubit': 82, 't1': 7.260327905277343e-06, 't2': 6.440762177221646e-06, 'measurement_error': 0.5048828125, 'score': 0.0}]
Die Benchmark-PUBs vorbereiten
Für jedes (N, x)-Paar transpiliert das Notebook zunächst die logischen Circuits und erstellt für jede Strategie ein Sampler-PUB:
-
unitary/raw: unitäre QFT auf dem vom Transpiler ausgewählten Layout, mit Routing nach Bedarf und ohne Orbit-DD oder -MEM. -
dynamic/raw: dynamische QFT auf den kalibrierungsbasiert ausgewählten physischen Qubits, ohne Orbit-DD oder -MEM. -
dynamic/orbit: derselbe transpilierte dynamische Circuit auf denselben physischen Qubits, mit aktiviertem Orbit-DD und -MEM.
Das Orbit-verbesserte PUB verwendet transpilation_mode="validate", da sein Mapping bereits festgelegt wurde. Orbit validiert den übergebenen physischen Circuit, anstatt ihn neu zu mappen, und wendet dann seine DD- und MEM-Pipeline an. Da nur die verbesserte dynamische Kurve MEM anfordert, sollte dies nicht als isolierter Vergleich von DD gegenüber keinem DD interpretiert werden.
Die PUBs, PUB-spezifischen Optionen und Ergebnisdatensätze werden in derselben Reihenfolge abgeflacht. Für jedes feste werden die PUBs unitary/raw, dynamic/raw und dynamic/orbit gemeinsam in einer Runtime-Batch-Partition gehalten. Der Gruppierungs-Helfer paart große und kleine Circuit-Größen, alterniert ihre Reihenfolge und gleicht die Summe von über die drei Partitionen hinweg als einfachen Proxy für die Workload der klassischen Steuerung aus.
strategy_options = {
    "unitary/raw": {"mode": "raw"},
    "dynamic/raw": {"mode": "raw"},
    "dynamic/orbit": {"mode": "orbit", "transpilation_mode": "validate"},
}
rng = np.random.default_rng(RNG_SEED)
pubs = []
pub_options = []
pub_records = []
layout_summary = {}

target_decimals_by_n = {
    n_qubits: [int(x) for x in rng.integers(0, 2**n_qubits, size=M)]
    for n_qubits in N_VALUES
}

for partition_index, n_group in enumerate(N_GROUPS):
    for n_qubits in n_group:
        dynamic_qubits = select_dynamic_qubits(backend, n_qubits)
        layout_summary[str(n_qubits)] = {"dynamic_qubits": dynamic_qubits}

        for x in target_decimals_by_n[n_qubits]:
            target_bitstring = target_output_bitstring(x, n_qubits)
            unitary_logical = build_unitary_qft_circuit(n_qubits, x)
            dynamic_logical = build_dynamic_qft_circuit(n_qubits, x)

            unitary_transpiled = transpile(
                unitary_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
            )
            dynamic_transpiled = transpile(
                dynamic_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
                initial_layout=dynamic_qubits,
            )

            circuits_by_label = {
                "unitary/raw": unitary_transpiled,
                "dynamic/raw": dynamic_transpiled,
                "dynamic/orbit": dynamic_transpiled,
            }
            for label in STRATEGY_LABELS:
                circuit = circuits_by_label[label]
                options = dict(strategy_options[label])
                pubs.append((circuit, None, SHOTS))
                pub_options.append(options)
                pub_records.append(
                    {
                        "partition_index": partition_index,
                        "n_qubits": n_qubits,
                        "target_decimal": x,
                        "target_bitstring": target_bitstring,
                        "label": label,
                        "pub_options": options,
                        "dynamic_qubits": (
                            dynamic_qubits
                            if label.startswith("dynamic/")
                            else None
                        ),
                        "transpiled_depth": circuit.depth(),
                        "transpiled_size": circuit.size(),
                    }
                )

BATCH_MAX_PUBS_PER_JOB = max(
    len(group) * M * len(STRATEGY_LABELS) for group in N_GROUPS
)

{
    "num_function_jobs": 1,
    "num_runtime_batch_partitions": len(N_GROUPS),
    "n_groups": {
        job_index: group for job_index, group in enumerate(N_GROUPS)
    },
    "n_load_per_job": {
        job_index: sum(group) for job_index, group in enumerate(N_GROUPS)
    },
    "pubs_per_partition": {
        partition_index: len(group) * M * len(STRATEGY_LABELS)
        for partition_index, group in enumerate(N_GROUPS)
    },
    "expected_executions_per_partition": {
        partition_index: len(group) * M * len(STRATEGY_LABELS) * SHOTS
        for partition_index, group in enumerate(N_GROUPS)
    },
    "first_pub_record": pub_records[0],
    "largest_dynamic_qubit_set": layout_summary[str(max(N_VALUES))][
        "dynamic_qubits"
    ],
}
{'num_function_jobs': 1,
 'num_runtime_batch_partitions': 3,
 'n_groups': {0: [40, 2, 7, 15, 10],
  1: [35, 3, 6, 20, 9],
  2: [30, 4, 5, 25, 8]},
 'n_load_per_job': {0: 74, 1: 73, 2: 72},
 'pubs_per_partition': {0: 300, 1: 300, 2: 300},
 'expected_executions_per_partition': {0: 307200, 1: 307200, 2: 307200},
 'first_pub_record': {'partition_index': 0,
  'n_qubits': 40,
  'target_decimal': 853235401719,
  'target_bitstring': '1110111111000000110100110001010101100011',
  'label': 'unitary/raw',
  'pub_options': {'mode': 'raw'},
  'dynamic_qubits': None,
  'transpiled_depth': 4778,
  'transpiled_size': 28259},
 'largest_dynamic_qubit_set': [35,
  92,
  5,
  141,
  75,
  147,
  1,
  152,
  12,
  10,
  128,
  107,
  21,
  8,
  15,
  98,
  33,
  134,
  154,
  53,
  78,
  109,
  112,
  149,
  120,
  55,
  3,
  132,
  85,
  49,
  115,
  101,
  95,
  64,
  136,
  71,
  90,
  56,
  18,
  44]}
Den Benchmark ausführen
Übergib die JSON-serialisierbare Batch-Konfiguration über orbit.run(...). Orbit erstellt den authentifizierten Runtime Batch innerhalb der Function, reicht die geordneten PUB-Partitionen ein, schließt den Batch nach dem Einreichen und gibt dem Aufrufer ein einziges zusammengeführtes Ergebnis zurück. Ein vom Aufrufer erstellter lokaler Batch kann einen asynchronen Qiskit-Function-Job nicht steuern.
Die geordnete PUB-Liste wird nach Qubit-Anzahl-Gruppen partitioniert, sodass alle drei Strategien für ein festes fair verglichen werden können: Alle 60 PUBs für ein festes — 20 gesampelte Eingaben mal drei Strategien — werden im selben untergeordneten Job des Runtime Batch ausgeführt. Die Standardgruppen kombinieren große und kleine Circuits und enthalten jeweils 300 PUBs, was die Wahrscheinlichkeit verringert, dass ein untergeordneter Job alle größten dynamischen Programme ansammelt, während Vergleiche innerhalb des Jobs erhalten bleiben.
job = quantum_elements_orbit.run(
    primitive="sampler",
    pubs=pubs,
    backend_name=backend.name,
    options={
        "pub_options": pub_options,
        "batch": {
            "max_pubs_per_job": BATCH_MAX_PUBS_PER_JOB,
            "max_time": "2h",
        },
        "save_backend_info": True,
    },
)

{
    "backend": backend.name,
    "function_job_id": job.job_id,
    "status": job.status(),
    "num_pubs": len(pubs),
    "max_pubs_per_runtime_job": BATCH_MAX_PUBS_PER_JOB,
    "n_groups": N_GROUPS,
}
{'backend': 'ibm_marrakesh',
 'function_job_id': '4b953302-afc3-4889-9ecf-e63d78b4e252',
 'status': 'QUEUED',
 'num_pubs': 900,
 'max_pubs_per_runtime_job': 300,
 'n_groups': [[40, 2, 7, 15, 10], [35, 3, 6, 20, 9], [30, 4, 5, 25, 8]]}
Ergebnisse abrufen und Prozessfidelity berechnen
Rufe das einzelne zusammengeführte Ergebnis ab, das die Orbit Function zurückgibt. Orbit erfasst die Runtime-Batch-ID, die IDs der untergeordneten Runtime-Jobs und die PUB-Bereiche in den Ergebnis-Metadaten; die PUB-Reihenfolge bleibt über die untergeordneten Jobs hinweg erhalten. Für jedes PUB ist die dem erwarteten Bitstring zugewiesene Wahrscheinlichkeit. extract_counts liest die an den Aufrufer zurückgegebenen Counts; für dynamic/orbit sind dies die MEM-angepassten Counts, wenn die Mitigation erfolgreich ist. extract_raw_counts gewinnt außerdem die entsprechenden unmitigierten Counts zurück, die in den Orbit-Metadaten erfasst sind. Der Code gruppiert die 20 Werte von für jedes (N, label)-Paar und wendet den oben eingeführten Schätzer an.
Das geplottete process_fidelity-Dictionary verwendet daher rohe Counts für unitary/raw und dynamic/raw, aber MEM-angepasste Counts für dynamic/orbit. Das parallele raw_process_fidelity-Dictionary behält für jede Strategie eine unmitigierte Berechnung bei und ist nützlich, um den Effekt von MEM vom Rest der Orbit-Pipeline zu trennen. MEM korrigiert das zurückgegebene Ausgabehistogramm; es kann ein Mid-Circuit-Messergebnis, das bereits durch Echtzeit-Feedforward verwendet wurde, nicht rückwirkend ändern.
def extract_counts(pub_result) -> dict[str, int]:
    """Extract the first nonempty classical-register counts mapping."""
    data = getattr(pub_result, "data", None)
    if data is None:
        raise TypeError("pub_result.data is missing")

    for name in dir(data):
        if name.startswith("_"):
            continue
        register = getattr(data, name)
        get_counts = getattr(register, "get_counts", None)
        if callable(get_counts):
            counts = get_counts()
            if counts:
                return counts

    raise TypeError(
        "No classical register with get_counts() found in pub_result.data"
    )

def extract_raw_counts(pub_result) -> dict[str, int]:
    """Extract unmitigated counts from Orbit metadata when available."""
    orbit_metadata = pub_result.metadata.get("quantum_elements_orbit", {})
    mem_report = orbit_metadata.get("measurementErrorMitigation", {})
    return mem_report.get("rawCounts") or extract_counts(pub_result)

def probability_for_bitstring(
    counts: dict[str, int], bitstring: str, n_qubits: int
) -> float:
    """Return observed probability of an expected bitstring."""
    total = sum(counts.values())
    if total <= 0:
        return 0.0
    normalized = Counter()
    for measured, count in counts.items():
        key = measured.replace(" ", "")[-n_qubits:].zfill(n_qubits)
        normalized[key] += count
    return float(normalized.get(bitstring, 0) / total)

try:
    job_result = job.result()
except Exception as exc:
    job_logs = getattr(job, "logs", lambda: "")()
    if job_logs:
        print(f"Logs for Function job {job.job_id}:\n{job_logs}")
    raise RuntimeError(
        f"Batched Orbit Function job {job.job_id} failed: "
        f"{type(exc).__name__}: {exc}"
    ) from exc

if len(job_result) != len(pub_records):
    raise RuntimeError(
        f"Function job {job.job_id} returned {len(job_result)} PUB results; "
        f"expected {len(pub_records)}"
    )

batch_report = job_result.metadata.get("quantum_elements_orbit", {}).get(
    "batch", {}
)
batch_partitions = batch_report.get("partitions", [])
partition_by_pub = {}
for partition in batch_partitions:
    start = int(partition["pubStart"])
    stop = start + int(partition["pubCount"])
    for pub_index in range(start, stop):
        partition_by_pub[pub_index] = partition

if len(partition_by_pub) != len(pub_records):
    raise RuntimeError(
        "Orbit Batch metadata does not cover every returned PUB."
    )

grouped_success = defaultdict(list)
grouped_raw_success = defaultdict(list)
pub_summaries = []

for pub_index, (record, pub_result) in enumerate(
    zip(pub_records, job_result, strict=True)
):
    partition = partition_by_pub[pub_index]
    label = record["label"]
    n_qubits = record["n_qubits"]
    counts = extract_counts(pub_result)
    raw_counts = extract_raw_counts(pub_result)
    success = probability_for_bitstring(
        counts, record["target_bitstring"], n_qubits
    )
    raw_success = probability_for_bitstring(
        raw_counts, record["target_bitstring"], n_qubits
    )
    key = (n_qubits, label)
    grouped_success[key].append(success)
    grouped_raw_success[key].append(raw_success)

    orbit_report = pub_result.metadata.get("quantum_elements_orbit", {})
    mem_report = orbit_report.get("measurementErrorMitigation", {})
    pub_summaries.append(
        {
            **record,
            "function_job_id": job.job_id,
            "runtime_batch_id": batch_report.get("id"),
            "runtime_job_id": partition.get("jobId"),
            "runtime_batch_partition": partition.get("index"),
            "success_probability": success,
            "raw_success_probability": raw_success,
            "orbit_mode": orbit_report.get("mode"),
            "transpilation_mode": orbit_report.get("transpilationMode"),
            "physical_layout": orbit_report.get("physicalLayout"),
            "dd_status": orbit_report.get("status", "not_applied"),
            "num_sequences_added": orbit_report.get("numSequencesAdded", 0),
            "num_gaps_filled": orbit_report.get("numGapsFilled", 0),
            "dynamic_dd_seq": orbit_report.get("dynamicDdSeq"),
            "mem_status": mem_report.get("status", "not_requested"),
            "warnings": orbit_report.get("warnings", [])
            + mem_report.get("warnings", []),
        }
    )

process_fidelity = defaultdict(dict)
raw_process_fidelity = defaultdict(dict)
mean_success_probability = defaultdict(dict)
raw_mean_success_probability = defaultdict(dict)

for (n_qubits, label), probabilities in sorted(grouped_success.items()):
    n_key = str(n_qubits)
    process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    mean_success_probability[n_key][label] = float(np.mean(probabilities))

for (n_qubits, label), probabilities in sorted(grouped_raw_success.items()):
    n_key = str(n_qubits)
    raw_process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    raw_mean_success_probability[n_key][label] = float(np.mean(probabilities))

process_fidelity = dict(process_fidelity)
raw_process_fidelity = dict(raw_process_fidelity)
mean_success_probability = dict(mean_success_probability)
raw_mean_success_probability = dict(raw_mean_success_probability)

{
    "function_job_id": job.job_id,
    "runtime_batch_id": batch_report.get("id"),
    "runtime_job_ids": batch_report.get("jobIds", []),
    "runtime_batch_partitions": batch_partitions,
    "n_groups": N_GROUPS,
    "process_fidelity": process_fidelity,
    "mean_success_probability": mean_success_probability,
}
{'function_job_id': '4b953302-afc3-4889-9ecf-e63d78b4e252',
 'runtime_batch_id': '096da6a9-cbea-4940-bd6f-3bdebfad436e',
 'runtime_job_ids': ['dabhtfh6e67c73a1dspg',
  'dabhtkp6e67c73a1dt0g',
  'dabhtple36ac739ff7ag'],
 'runtime_batch_partitions': [{'index': 0,
   'pubStart': 0,
   'pubCount': 300,
   'jobId': 'dabhtfh6e67c73a1dspg'},
  {'index': 1,
   'pubStart': 300,
   'pubCount': 300,
   'jobId': 'dabhtkp6e67c73a1dt0g'},
  {'index': 2,
   'pubStart': 600,
   'pubCount': 300,
   'jobId': 'dabhtple36ac739ff7ag'}],
 'n_groups': [[40, 2, 7, 15, 10], [35, 3, 6, 20, 9], [30, 4, 5, 25, 8]],
 'process_fidelity': {'2': {'dynamic/orbit': 0.96795267841156,
   'dynamic/raw': 0.982106196462969,
   'unitary/raw': 0.9813114213091467},
  '3': {'dynamic/orbit': 0.9260299657995851,
   'dynamic/raw': 0.9561294394338111,
   'unitary/raw': 0.9500873287318629},
  '4': {'dynamic/orbit': 0.8830473125154273,
   'dynamic/raw': 0.8338948172317725,
   'unitary/raw': 0.8723284938083211},
  '5': {'dynamic/orbit': 0.8345263398914793,
   'dynamic/raw': 0.7202370952637628,
   'unitary/raw': 0.7886522480980407},
  '6': {'dynamic/orbit': 0.7555427381229081,
   'dynamic/raw': 0.5132161092086612,
   'unitary/raw': 0.7212899564100468},
  '7': {'dynamic/orbit': 0.7050351887334156,
   'dynamic/raw': 0.3785120988393675,
   'unitary/raw': 0.6045265978953258},
  '8': {'dynamic/orbit': 0.6646106162043616,
   'dynamic/raw': 0.16869967802023164,
   'unitary/raw': 0.5043677114922691},
  '9': {'dynamic/orbit': 0.5230999959600392,
   'dynamic/raw': 0.03629305030182246,
   'unitary/raw': 0.4292104907804543},
  '10': {'dynamic/orbit': 0.5578720776016518,
   'dynamic/raw': 0.041261905412736485,
   'unitary/raw': 0.3509234542669733},
  '15': {'dynamic/orbit': 0.2580377878661623,
   'dynamic/raw': 3.083881578947369e-05,
   'unitary/raw': 0.09345722346055228},
  '20': {'dynamic/orbit': 0.05567530378670723,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.00010793585526315788},
  '25': {'dynamic/orbit': 0.003482218097213064,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 7.268778589499868e-06,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}},
 'mean_success_probability': {'2': {'dynamic/orbit': 0.96796875,
   'dynamic/raw': 0.98212890625,
   'unitary/raw': 0.98134765625},
  '3': {'dynamic/orbit': 0.92607421875,
   'dynamic/raw': 0.95615234375,
   'unitary/raw': 0.950146484375},
  '4': {'dynamic/orbit': 0.88310546875,
   'dynamic/raw': 0.833935546875,
   'unitary/raw': 0.872705078125},
  '5': {'dynamic/orbit': 0.8345703125,
   'dynamic/raw': 0.7203125,
   'unitary/raw': 0.78896484375},
  '6': {'dynamic/orbit': 0.7556640625,
   'dynamic/raw': 0.51337890625,
   'unitary/raw': 0.721826171875},
  '7': {'dynamic/orbit': 0.70517578125,
   'dynamic/raw': 0.3787109375,
   'unitary/raw': 0.605419921875},
  '8': {'dynamic/orbit': 0.66484375,
   'dynamic/raw': 0.16884765625,
   'unitary/raw': 0.50576171875},
  '9': {'dynamic/orbit': 0.5232421875,
   'dynamic/raw': 0.0365234375,
   'unitary/raw': 0.43203125},
  '10': {'dynamic/orbit': 0.5580078125,
   'dynamic/raw': 0.04150390625,
   'unitary/raw': 0.353466796875},
  '15': {'dynamic/orbit': 0.258349609375,
   'dynamic/raw': 0.0001953125,
   'unitary/raw': 0.09453125},
  '20': {'dynamic/orbit': 0.057568359375,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.000341796875},
  '25': {'dynamic/orbit': 0.006396484375,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 0.000146484375,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}}}
Orbit-DD-Metadaten überprüfen
Die folgende Zusammenfassung überprüft die dynamic/orbit-PUB-Metadaten, anstatt anzunehmen, dass das angeforderte DD eingefügt wurde. Prüfe den Status, die gemeldete dynamische DD-Sequenz, Warnungen sowie die Anzahl der aufgefüllten Lücken und hinzugefügten Sequenzen. Eine erfolgreiche Einfügung sollte für mindestens einige PUBs Werte ungleich null ergeben, aber die genauen Werte hängen vom geplanten Circuit, den Timing-Beschränkungen des Backends und der Circuit-Größe ab. Diese Metadaten beschreiben die von Orbit angewendete Sequenz; sie sollten nicht als das FC-DD-Protokoll des Papers bezeichnet werden, es sei denn, der Bericht stellt diese Äquivalenz ausdrücklich fest.
dd_summary = defaultdict(lambda: Counter())
sequence_totals = defaultdict(int)
warning_examples = []

for summary in pub_summaries:
    if summary["label"] != "dynamic/orbit":
        continue
    n_key = str(summary["n_qubits"])
    dd_summary[n_key][summary["dd_status"]] += 1
    sequence_totals[n_key] += int(summary.get("num_sequences_added") or 0)
    if summary.get("warnings") and len(warning_examples) < 5:
        warning_examples.append(
            {
                "n_qubits": summary["n_qubits"],
                "target_decimal": summary["target_decimal"],
                "warnings": summary["warnings"],
            }
        )

{
    "dynamic_orbit_dd_status_counts": {
        key: dict(value) for key, value in dd_summary.items()
    },
    "dynamic_orbit_sequences_added": dict(sequence_totals),
    "warning_examples": warning_examples,
}
{'dynamic_orbit_dd_status_counts': {'40': {'dd_inserted': 20},
  '2': {'dd_inserted': 20},
  '7': {'dd_inserted': 20},
  '15': {'dd_inserted': 20},
  '10': {'dd_inserted': 20},
  '35': {'dd_inserted': 20},
  '3': {'dd_inserted': 20},
  '6': {'dd_inserted': 20},
  '20': {'dd_inserted': 20},
  '9': {'dd_inserted': 20},
  '30': {'dd_inserted': 20},
  '4': {'dd_inserted': 20},
  '5': {'dd_inserted': 20},
  '25': {'dd_inserted': 20},
  '8': {'dd_inserted': 20}},
 'dynamic_orbit_sequences_added': {'40': 31200,
  '2': 40,
  '7': 840,
  '15': 4200,
  '10': 1800,
  '35': 23800,
  '3': 120,
  '6': 600,
  '20': 7600,
  '9': 1440,
  '30': 17400,
  '4': 240,
  '5': 400,
  '25': 12000,
  '8': 1120},
 'warning_examples': [{'n_qubits': 40,
   'target_decimal': 853235401719,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 954673909846,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 524641045908,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 185651043478,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 587114273567,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']}]}
Prozessfidelity-Kurven plotten
Der Plot zeigt die gesampelte QFT-Prozessfidelity-Punktschätzung gegenüber der Qubit-Anzahl für die drei Strategien. dynamic/raw und dynamic/orbit teilen sich bei jeder Größe ein physisches Layout; unitary/raw verwendet das Layout und Routing des Transpilers.
Im Gegensatz zu Abbildung 2a zeigt dieser Plot weder eine Kurve für unitär-mit-DD noch Unsicherheitsbänder, und seine Rohkurven sind nicht readout-mitigiert. Er ist am besten als ein Skalierungsvergleich im Stil von Abbildung 2a für diesen Orbit-Workflow zu verstehen, nicht als direkte Reproduktion der veröffentlichten Kurven.
from datetime import datetime
from zoneinfo import ZoneInfo

finished_local = datetime.now(ZoneInfo("America/Los_Angeles"))
labels = ["dynamic/orbit", "dynamic/raw", "unitary/raw"]
colors = {
    "dynamic/orbit": "#26735b",
    "dynamic/raw": "#9b1c31",
    "unitary/raw": "#6e6e6e",
}
pretty_labels = {
    "dynamic/orbit": "Dynamic QFT with Orbit",
    "dynamic/raw": "Dynamic QFT",
    "unitary/raw": "Unitary QFT",
}

series = []
for label in labels:
    values = [process_fidelity[str(n)][label] for n in N_VALUES]
    log_values = [value if value > 0.0 else float("nan") for value in values]
    series.append((label, values, log_values))

nonzero_values = [
    value
    for _, _, log_values in series
    for value in log_values
    if value > 0.0
]
if not nonzero_values:
    raise RuntimeError(
        "No nonzero process-fidelity values found for log inset"
    )
log_floor = min(nonzero_values) / 2

fig, ax = plt.subplots(figsize=(9.8, 5.6))
for label, values, _ in series:
    ax.plot(
        N_VALUES,
        values,
        marker="o",
        linewidth=2.0,
        markersize=5,
        color=colors[label],
        label=pretty_labels[label],
    )

ax.set_xlabel("N qubits")
ax.set_ylabel("Process fidelity")
finished_time_for_title = finished_local
ax.set_title(
    f"Dynamic QFT Orbit results on {IBM_BACKEND_NAME}\n"
    f"Job finished {finished_time_for_title:%Y-%m-%d %H:%M %Z}"
)
ax.set_xticks(N_VALUES)
ax.set_ylim(bottom=0)
ax.grid(axis="both", alpha=0.25)
ax.legend(loc="upper right")

inset = ax.inset_axes([0.53, 0.31, 0.44, 0.43])
for label, _, log_values in series:
    inset.plot(
        N_VALUES,
        log_values,
        marker="o",
        linewidth=2.0,
        markersize=5,
        color=colors[label],
    )
inset.set_yscale("log")
inset.set_ylim(bottom=log_floor)
inset.set_xlim(min(N_VALUES), max(N_VALUES))
inset.set_title("Log scale; zeros omitted", fontsize=9)
inset.grid(axis="both", alpha=0.25)
inset.tick_params(axis="both", labelsize=8)
inset.patch.set_alpha(0.96)

fig.tight_layout()
plt.show()
Referenzen
Nächste Schritte
-
Sieh dir den Orbit-Guide und die API-Referenz-Dokumentation an.
-
Probiere ein anderes Backend, ein alternatives Layout aus oder experimentiere mit einer alternativen Orbit-gestützten Dynamical-Decoupling-Sequenz, indem du die Option
dd_strategyänderst. Bedenke, dass du aufgrund der experimentellen Natur dynamischer Circuits auf mögliche Job-Fehlermodi achten musst (siehe [3] und [4]). Wenn du negative Stretch-Werte feststellst [3], probiere eine kleinere DD-Sequenz (mit weniger Pulsen) aus. Wenn du [4] feststellst, erhöheNUM_BATCH_PARTITIONS, verringereModer reduziere die größten Werte inN_VALUES, die alle im Setup-Abschnitt oben definiert sind.