Multi-Produkt-Formeln zur Reduzierung des Trotter-Fehlers
Geschätzte Nutzung: Vier Minuten auf einem Heron-r2-Prozessor (HINWEIS: Dies ist nur eine Schätzung. Deine tatsächliche Laufzeit kann abweichen.)
Lernziele
-
Wie Multi-Produkt-Formeln (MPFs) den Trotter-Fehler bei der Hamiltonschen Simulation reduzieren, indem sie Erwartungswerte aus mehreren flachen Circuits kombinieren
-
Wann MPFs gegenüber Standard-Produktformeln von Vorteil sind und wann sie nicht das richtige Werkzeug sind
-
Wie man statische und dynamische MPF-Koeffizienten mit dem Paket
qiskit_addon_mpfberechnet -
Wie man einen MPF-Workflow end-to-end auf IBM Quantum®-Hardware ausführt, einschließlich Transpilierung, Fehlerminderung und Nachbearbeitung
Voraussetzungen
-
Kompilierungsmethoden für Hamiltonsche Simulations-Circuits — führt Trotter-(Produktformel)-Circuits in Qiskit ein.
-
Produktformeln in Qiskit, insbesondere die Synthese-Klassen
SuzukiTrotterundLieTrotter.
Hintergrund
Was sind Multi-Produkt-Formeln?
Bei der Simulation von Quantensystemen auf einem Quantencomputer besteht eine zentrale Aufgabe darin, den Zeitentwicklungsoperator für einen Hamiltonian zu approximieren. Der Standardansatz verwendet Produktformeln (PFs), auch bekannt als Trotter-Suzuki-Zerlegungen. Diese zerlegen in Terme, deren einzelne Unitaries effizient zu implementieren sind, und approximieren dann die vollständige Zeitentwicklung als geordnetes Produkt dieser einfacheren Unitaries.
Die Produktformel erster Ordnung (Lie-Trotter) lautet:
was einen quadratischen Fehler verursacht: . Symmetrische Formeln höherer Ordnung , wobei die Ordnung der symmetrischen Produktformel angibt (siehe Ref. [1]), konvergieren schneller, nämlich wie , allerdings auf Kosten tieferer Circuits pro Schritt.
Um den Fehler bei einer festen Ordnung zu reduzieren, teilt man die gesamte Zeitentwicklungsdauer üblicherweise in kleinere Trotter-Schritte auf. Jeder Schritt approximiert durch eine Produktformel, und die Schritte werden aneinandergereiht:
Für eine symmetrische Formel der Ordnung skaliert der verbleibende Trotter-Fehler dann als . Eine Erhöhung von unterdrückt den Trotter-Fehler also schnell — vertieft aber auch linear den Circuit, was auf verrauschter Hardware mehr akkumuliertes Gate-Rauschen bedeutet. Genau diese Spannung zwischen Trotter-Fehler (begünstigt größeres ) und Hardware-Rauschen (begünstigt kleineres ) sollen Multi-Produkt-Formeln auflösen. Beachte, dass es bei MPFs darum geht, Ergebnisse aus unterschiedlichen Wahlen von bei fester Ordnung zu kombinieren — sie ändern nicht die Ordnung der zugrunde liegenden Produktformel.
Multi-Produkt-Formeln (MPFs) [1] bilden eine gewichtete Linearkombination von Erwartungswerten, die aus mehreren flacheren Trotter-Circuits mit jeweils unterschiedlicher Anzahl an Trotter-Schritten (einer Menge von Schrittzahlen) gewonnen werden:
wobei der Erwartungswert einer Observable zur Zeit ist, geschätzt aus einem Trotter-Circuit mit Schritten, und die Koeffizienten so gewählt werden, dass sich die führenden Trotter-Fehlerterme in der Kombination aufheben. Wir werden auf diesen Ausdruck in Schritt 4 zurückkommen, wo wir ihn explizit auswerten, um unsere Trotter-Ergebnisse zu kombinieren. Der entscheidende praktische Punkt ist, dass der tiefste Circuit in der MPF nur Schritte benötigt, was deutlich kleiner ist als das einzelne , das erforderlich wäre, um denselben effektiven Trotter-Fehler direkt zu erreichen. Die flacheren Circuits machen den MPF-Ansatz besser geeignet für verrauschte Hardware.
Wie werden die Koeffizienten bestimmt?
Es gibt zwei Familien von MPF-Koeffizienten:
Statische Koeffizienten sind unabhängig vom Hamiltonian, dem Anfangszustand und der Zeitentwicklungsdauer. Sie werden durch Lösen eines linearen Gleichungssystems ermittelt, das die Auslöschung der führenden Trotter-Fehlerterme erzwingt. Für eine Menge von Trotter-Schritten , die mit einer symmetrischen Produktformel der Ordnung verwendet werden, führt die Entwicklung des Trotter-Fehlers in inversen Potenzen von zu Nebenbedingungsgleichungen der Form:
wobei die ganzzahligen Exponenten die Ordnungen der aufeinanderfolgenden Trotter-Fehlerterme für die gewählte Produktformel sind. Für eine symmetrische PF der Ordnung skaliert der führende Fehler in als , mit nachfolgenden Korrekturen bei — die Exponenten sind also . Bei nicht-symmetrischen PFs tragen sowohl ungerade als auch gerade Potenzen bei, und es gilt . Die vollständige Herleitung findest du in Ref. [1]. Die erste Gleichung im obigen System stellt Verzerrungsfreiheit sicher (die MPF reproduziert den exakten Erwartungswert im Grenzfall ), und die verbleibenden Gleichungen heben nacheinander die ersten Trotter-Fehlerterme auf. Wenn die resultierende -Norm zu groß ist (was das Sampling-Rauschen verstärkt), kannst du stattdessen eine Näherungsoptimierung lösen, die begrenzt, während minimiert wird.
Dynamische Koeffizienten [2], [3] hängen zusätzlich vom Hamiltonian, dem Anfangszustand und der Zeitentwicklungsdauer ab. Sie minimieren den Frobenius-Norm-Abstand zwischen dem tatsächlich zeitentwickelten Zustand und der MPF-Approximation:
wobei die Gram-Matrix der Überlappungen zwischen Trotter-entwickelten Zuständen für unterschiedliche Schrittzahlen ist, und die Überlappung mit dem (näherungsweise) exakten Zustand misst. In diesem Tutorial werden diese Größen effizient mithilfe von Tensor-Netzwerk-Methoden berechnet, insbesondere den TeNPy-basierten Backends in qiskit_addon_mpf.
Wann MPFs verwendet werden sollten
MPFs bieten den größten Nutzen, wenn:
-
Die Circuit-Tiefe der Engpass ist. Wenn Hardware-Rauschen die ausführbare Tiefe begrenzt, verwende MPFs, um mit flacheren Circuits eine höhere effektive Trotter-Genauigkeit zu erreichen.
-
Du genaue Erwartungswerte benötigst, keine vollständige Zustandspräparation. MPFs arbeiten auf der Ebene von Erwartungswerten — sie kombinieren klassische Zahlen, keine Quantenzustände. Sie sind daher ideal für die Observable-Schätzung bei Verwendung der Estimator-Primitive.
-
Du eine moderate Anzahl an Trotter-Schrittzahlen kombinierst. Üblicherweise reicht die Kombination von – unterschiedlichen Schrittzahlen aus, um mehrere führende Trotter-Fehlerterme aufzuheben und dabei handhabbar zu halten.
Wann MPFs möglicherweise nicht helfen
-
Sehr kurze Zeitentwicklungsdauern. Wenn klein genug ist, dass eine einzelne Trotter-Formel niedriger Ordnung bereits genau ist, ist der Aufwand für die Ausführung mehrerer Circuits unnötig.
-
Aufgaben der Zustandspräparation. MPFs erzeugen einen korrigierten Erwartungswert, keinen korrigierten Quantenzustand. Wenn du den tatsächlich zeitentwickelten Zustand benötigst (zum Beispiel als Eingabe für eine andere Quanten-Subroutine), sind MPFs nicht anwendbar.
-
Trotter-Schrittzahlen, die den Konvergenzbereich verletzen. Die Herleitung der statischen Koeffizienten entwickelt jedes einzelne als Reihe in ; diese Entwicklung konvergiert nur dann gut, wenn gilt. Wird für das gegebene zu klein gewählt, liegt der flachste Circuit weit außerhalb des Störungsbereichs, die Fehlerterme höherer Ordnung, die von der MPF nicht aufgehoben werden, werden groß, und die Auslöschung kann große Koeffizienten erfordern. Die -Norm ist die praktische Diagnose: Wenn ist, könnte der Sampling-Mehraufwand die Reduktion des Trotter-Fehlers überwiegen. Details findest du im Leitfaden zur Wahl der Trotter-Schritte.
Was dieses Tutorial abdeckt
Dieses Tutorial führt in zwei Etappen durch einen End-to-End-MPF-Workflow. Zunächst zeigt ein Simulator-Beispiel im kleinen Maßstab (10-Qubit-Heisenberg-Kette), wie das Problem aufgesetzt wird, wie statische und dynamische MPF-Koeffizienten berechnet werden und wie die resultierenden Erwartungswerte mit der exakten Diagonalisierung verglichen werden. Anschließend zeigt ein Hardware-Beispiel im großen Maßstab (50-Qubit-XXZ-Kette), wie transpiliert, auf IBM-Quantum-Hardware mit Fehlerminderung ausgeführt und die Ergebnisse mithilfe der MPF-Koeffizienten nachbearbeitet werden. Durchgehend verwenden wir das Paket qiskit_addon_mpf zusammen mit Standard-Qiskit-Tools.
Voraussetzungen
Stelle vor Beginn dieses Tutorials sicher, dass Folgendes installiert ist:
-
Qiskit SDK v2.0 oder höher, mit Unterstützung für Visualisierung
-
Qiskit Runtime v0.22 oder höher (
pip install qiskit-ibm-runtime) -
Qiskit-Aer-Simulator (
pip install qiskit-aer) -
MPF-Qiskit-Addon mit dem TeNPy-Backend (
pip install "qiskit-addon-mpf[tenpy]") -
Qiskit-Addon-Utilities (
pip install qiskit-addon-utils) -
SciPy (
pip install scipy)
Setup
Im Folgenden sammeln wir alle im gesamten Tutorial verwendeten Paket-Importe in einer einzigen Zelle. Außerdem definieren wir einen CollectAndCollapse-Transpiler-Pass, der benachbarte rxx- und ryy-Rotationen zu einem einzigen XXPlusYYGate verschmilzt. Dieser Pass wird sowohl während des Circuit-Aufbaus in Schritt 1 angewendet (um die Gate-Anzahl niedrig zu halten) als auch indirekt, wenn wir in Schritt 4 die geschichtete Struktur für die dynamische MPF extrahieren (TeNPy erwartet Zwei-Qubit-Gates, keine Paare unverschmolzener Rotationen).
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_mpf": "qiskit-addon-mpf", "qiskit_addon_utils": "qiskit-addon-utils", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy", "tenpy": "physics-tenpy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
import matplotlib.pyplot as plt
from functools import partial
from copy import deepcopy

from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp, Statevector
from qiskit.synthesis import SuzukiTrotter
from qiskit.transpiler import CouplingMap, PassManager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.circuit.library import XXPlusYYGate
from qiskit.transpiler.passes.optimization.collect_and_collapse import (
    CollectAndCollapse,
    collect_using_filter_function,
    collapse_to_operation,
)

from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import EstimatorV2 as Estimator, QiskitRuntimeService

from qiskit_addon_utils.problem_generators import (
    generate_xyz_hamiltonian,
    generate_time_evolution_circuit,
)
from qiskit_addon_utils.slicing import slice_by_depth
from qiskit_addon_mpf.static import setup_static_lse
from qiskit_addon_mpf.dynamic import setup_dynamic_lse
from qiskit_addon_mpf.costs import (
    setup_exact_problem,
    setup_sum_of_squares_problem,
    setup_frobenius_problem,
)
from qiskit_addon_mpf.backends.tenpy_layers import (
    LayerModel,
    LayerwiseEvolver,
)
from qiskit_addon_mpf.backends.tenpy_tebd import MPOState, MPS_neel_state

from scipy.linalg import expm

# Suppress TeNPy's `unit_cell_width` future-API warning. The default
# (`unit_cell_width=len(sites)`) is correct for Chain lattices, which is what
# `CouplingMap.from_line(...)` produces here, so the warning is informational.
warnings.filterwarnings(
    "ignore",
    message=r".*unit_cell_width.*",
    category=UserWarning,
)

# --- Helper: collect XX + YY rotations into a single gate ---
def filter_function(node):
    return node.op.name in {"rxx", "ryy"}

collect_function = partial(
    collect_using_filter_function,
    filter_function=filter_function,
    split_blocks=True,
    min_block_size=1,
)

def collapse_to_xx_plus_yy(block):
    param = 0.0
    for node in block.data:
        param += node.operation.params[0]
    return XXPlusYYGate(param)

collapse_function = partial(
    collapse_to_operation,
    collapse_function=collapse_to_xx_plus_yy,
)

pm = PassManager()
pm.append(CollectAndCollapse(collect_function, collapse_function))
Simulator-Beispiel im kleinen Maßstab
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Wir beginnen mit einem 10-Qubit-Heisenberg-Modell auf einer Linie, wobei der Néel-Zustand als Anfangszustand verwendet wird. Der Hamiltonian lautet:
wobei die Kopplungsstärke zwischen nächsten Nachbarn ist. Wir messen den ZZ-Korrelator an einem Qubit-Paar in der Mitte der Kette und verwenden Trotter-Schritte mit einer Produktformel zweiter Ordnung.
L = 10

# Generate coupling map and Hamiltonian
coupling_map = CouplingMap.from_line(L, bidirectional=False)

hamiltonian = generate_xyz_hamiltonian(
    coupling_map,
    coupling_constants=(1.0, 1.0, 1.0),
    ext_magnetic_field=(0.0, 0.0, 0.0),
)
print(hamiltonian)
SparsePauliOp(['IIIIIIIXXI', 'IIIIIIIYYI', 'IIIIIIIZZI', 'IIIIIXXIII', 'IIIIIYYIII', 'IIIIIZZIII', 'IIIXXIIIII', 'IIIYYIIIII', 'IIIZZIIIII', 'IXXIIIIIII', 'IYYIIIIIII', 'IZZIIIIIII', 'IIIIIIIIXX', 'IIIIIIIIYY', 'IIIIIIIIZZ', 'IIIIIIXXII', 'IIIIIIYYII', 'IIIIIIZZII', 'IIIIXXIIII', 'IIIIYYIIII', 'IIIIZZIIII', 'IIXXIIIIII', 'IIYYIIIIII', 'IIZZIIIIII', 'XXIIIIIIII', 'YYIIIIIIII', 'ZZIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
# Observable: ZZ on the middle pair of qubits
observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)
print(observable)
SparsePauliOp(['IIIIZZIIII'],
              coeffs=[1.+0.j])
# MPF parameters
mpf_trotter_steps = [1, 2, 4]
order = 2
symmetric = False

trotter_times = np.arange(0.5, 1.55, 0.1)
exact_evolution_times = np.arange(trotter_times[0], 1.55, 0.05)
Trotter-Circuits erstellen
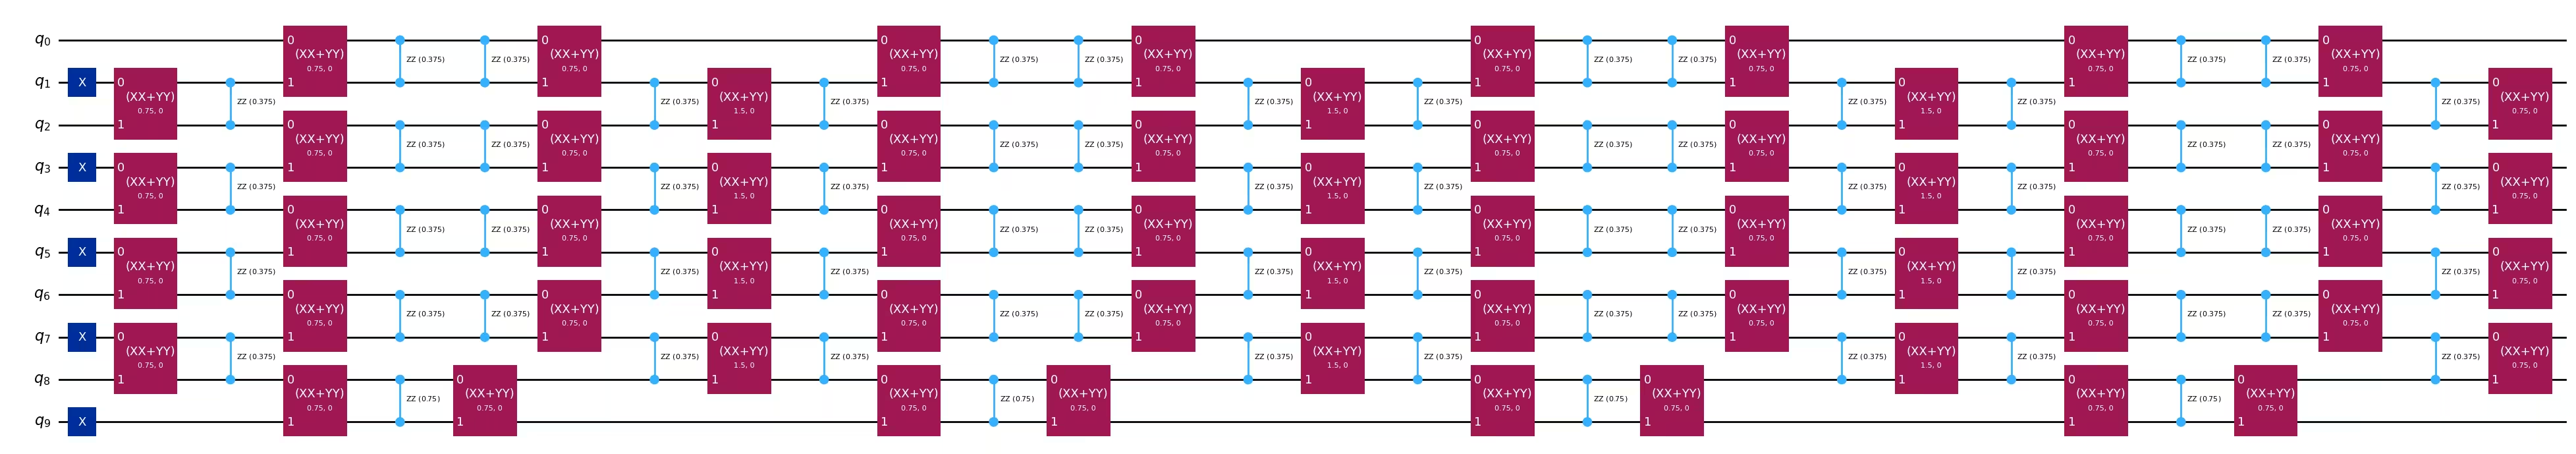
Wir erstellen die Circuits, die die approximierten Trotter-Zeitentwicklungen für jeden Zeitpunkt und jede Trotter-Schrittzahl implementieren. Der im Setup-Abschnitt definierte CollectAndCollapse-Pass sammelt XX- und YY-Rotationen zu einzelnen XX+YY-Gates, um eine spätere effizientere Tensor-Netzwerk-Simulation vorzubereiten.
# Initial Neel state preparation
initial_state_circ = QuantumCircuit(L)
initial_state_circ.x([i for i in range(L) if i % 2 != 0])

all_circs = []
for total_time in trotter_times:
    mpf_trotter_circs = [
        generate_time_evolution_circuit(
            hamiltonian,
            time=total_time,
            synthesis=SuzukiTrotter(reps=num_steps, order=order),
        )
        for num_steps in mpf_trotter_steps
    ]

    mpf_trotter_circs = pm.run(
        mpf_trotter_circs
    )  # Collect XX and YY into XX + YY

    mpf_circuits = [
        initial_state_circ.compose(circuit) for circuit in mpf_trotter_circs
    ]
    all_circs.append(mpf_circuits)
mpf_circuits[-1].draw("mpl", fold=-1)
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren
Für das Beispiel im kleinen Maßstab zielen wir auf den Aer-Simulator ab. Zwei Transformationen finden statt, bevor die Circuits ausführungsbereit sind:
-
Gate-Sammlung auf Ebene der Hamiltonschen Simulation. In der Setup-Zelle haben wir einen
CollectAndCollapse-Pass erstellt, der benachbarterxx- undryy-Rotationen zu einem einzigenXXPlusYYGateverschmilzt. Diesen Pass haben wir bereits angewendet, als wir die Trotter-Circuits in Schritt 1 erstellt haben (der Aufrufpm.run(...)). Dies reduziert nicht nur die Anzahl der Zwei-Qubit-Gates, sondern erzeugt auch eine Struktur, die sich besser für die Tensor-Netzwerk-Simulation eignet, mit der später die dynamischen Koeffizienten berechnet werden. -
Absenken auf die ISA des Simulators. Im Folgenden führen wir den voreingestellten Qiskit-Pass-Manager mit
optimization_level=3aus, um jeden Trotter-Circuit auf die Befehlssatzarchitektur (ISA) des Simulators abzusenken.
aer_sim = AerSimulator()
pm_sim = generate_preset_pass_manager(backend=aer_sim, optimization_level=3)

isa_circs_all_times = [
    pm_sim.run([deepcopy(c) for c in mpf_circuits])
    for mpf_circuits in all_circs
]
Schritt 3: Ausführung mit Qiskit-Primitiven
Für das Beispiel im kleinen Maßstab führen wir die ISA-abgesenkten Trotter-Circuits durch die von Aer unterstützte EstimatorV2-Primitive aus. Dadurch erhalten wir für jedes -Paar einen rauschfreien Referenzwert — dies sind die Werte , die die MPF in Schritt 4 kombinieren wird. Wir variieren die Zeitentwicklungsdauern, sodass wir später die vollständige Zeitreihenkurve jeder einzelnen Produktformel und der MPF darstellen können.
estimator = Estimator(mode=aer_sim)

mpf_expvals_all_times, mpf_stds_all_times = [], []
for isa_circuits in isa_circs_all_times:
    result = estimator.run(
        [(circuit, observable) for circuit in isa_circuits], precision=0.005
    ).result()
    mpf_expvals_all_times.append([res.data.evs for res in result])
    mpf_stds_all_times.append([res.data.stds for res in result])
Schritt 4: Nachverarbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
In Schritt 4 wird die MPF tatsächlich konstruiert. Auch wenn die Koeffizienten hier berechnet werden (und diese Berechnung bei der dynamischen Variante rechenintensiv sein kann), sind sie konzeptionell ein klassisches Rezept, um die Quantenmessungen aus Schritt 3 zu einem einzigen korrigierten Erwartungswert zu kombinieren — deshalb behandeln wir den gesamten Koeffizienten- und Kombinationsworkflow als Nachbearbeitung.
Um zu beurteilen, wie gut die MPF der tatsächlichen Dynamik folgt, berechnen wir zunächst die exakten zeitentwickelten Erwartungswerte, indem wir den Hamiltonian direkt exponentieren. Dies ist nur handhabbar, weil ist; im untenstehenden Hardware-Beispiel im großen Maßstab müssen wir stattdessen auf Tensor-Netzwerk-Schätzungen zurückgreifen.
exact_expvals = []
for t in exact_evolution_times:
    exp_H = expm(-1j * t * hamiltonian.to_matrix())
    initial_state = Statevector(initial_state_circ).data
    time_evolved_state = exp_H @ initial_state

    exact_obs = (
        time_evolved_state.conj()
        @ observable.to_matrix()
        @ time_evolved_state
    ).real
    exact_expvals.append(exact_obs)
Statische MPF-Koeffizienten
Statische MPFs verwenden Koeffizienten , die unabhängig von der Zeitentwicklungsdauer, dem Hamiltonian und dem Anfangszustand sind. Wir stellen das im Hintergrund beschriebene lineare Gleichungssystem auf und lösen es nach den Koeffizienten. Die Matrix wird durch die Trotter-Schrittzahlen , die Ordnung der Produktformel und die Symmetrie der Formel (die die Exponenten bestimmt) festgelegt.
Für unser Beispiel im kleinen Maßstab verwenden wir mit einer nicht-symmetrischen Suzuki-Trotter-Formel der Ordnung (also und , was ergibt). Das System lautet dann:
Die erste Zeile erzwingt Verzerrungsfreiheit (); die zweite und dritte Zeile heben jeweils den führenden - und den nächsten -Trotter-Fehlerterm auf.
Das LGS aufstellen
Wir verwenden setup_static_lse aus qiskit_addon_mpf.static, um die oben beschriebene Matrix und den Vektor auf der rechten Seite zusammenzustellen. Die Matrix hängt nicht nur von ab, sondern auch von unserer Wahl der Produktformel — insbesondere von ihrer Ordnung und davon, ob sie symmetrisch ist. Das Flag symmetric steuert das Exponentenmuster (symmetrische Formeln erzeugen nur Trotter-Fehlerterme mit geraden Potenzen; siehe Ref. [1]). Beachte, dass es, wie in Ref. [2] gezeigt, nicht zwingend erforderlich ist, symmetric=True zu setzen, selbst wenn die zugrunde liegende PF symmetrisch ist — das nicht-symmetrische LGS bleibt gültig (es erzwingt zusätzliche, nicht benötigte Nebenbedingungen).
Für unser Beispiel haben wir order = 2 und symmetric = False bereits in Schritt 1 festgelegt.
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
Überprüfe die konstruierte Matrix und den Vektor , um zu bestätigen, dass sie mit dem oben angegebenen System übereinstimmen.
lse.A
array([[1.      , 1.      , 1.      ],
       [1.      , 0.25    , 0.0625  ],
       [1.      , 0.125   , 0.015625]])
lse.b
array([1., 0., 0.])
Mit dem LGS in der Hand lösen wir nach den statischen Koeffizienten mittels lse.solve() (dies ist die direkte Lösung ).
mpf_coeffs = lse.solve()
print(
    f"The static coefficients associated with the ansatze are: {mpf_coeffs}"
)
The static coefficients associated with the ansatze are: [ 0.04761905 -0.57142857 1.52380952]
mit einem exakten Modell optimieren
Alternativ zur Berechnung von kannst du setup_exact_model verwenden, um eine cvxpy.Problem-Instanz zu konstruieren, die das LGS als Nebenbedingungen verwendet und deren optimale Lösung liefert.
model_exact, coeffs_exact = setup_exact_problem(lse)
model_exact.solve()
print(coeffs_exact.value)
[ 0.04761905 -0.57142857 1.52380952]
print(
    "L1 norm of the exact coefficients:",
    np.linalg.norm(coeffs_exact.value, ord=1),
)
L1 norm of the exact coefficients: 2.1428571428556378
mit einem Näherungsmodell optimieren
Es kann vorkommen, dass die -Norm für den gewählten Satz von -Werten als zu hoch eingestuft wird. Wenn das der Fall ist und du keinen anderen Satz von -Werten wählen kannst, kannst du eine Näherungslösung verwenden, die die -Norm auf einen gewählten Schwellenwert begrenzt, während minimiert wird. Sieh dir dazu den Leitfaden How to use the approximate model an.
model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=1.5
)
model_approx.solve()
print(coeffs_approx.value)
print(
    "L1 norm of the approximate coefficients:",
    np.linalg.norm(coeffs_approx.value, ord=1),
)
[-1.10294118e-03 -2.48897059e-01  1.25000000e+00]
L1 norm of the approximate coefficients: 1.5
Dynamische MPF-Koeffizienten
Die statische MPF hebt Trotter-Fehlerterme auf eine vom Hamiltonian und Zustand unabhängige Weise auf und erzeugt daher nicht notwendigerweise den kleinstmöglichen Approximationsfehler für einen gegebenen Hamiltonian und Anfangszustand. Die dynamische MPF (Refs. [2], [3]) findet stattdessen zeitabhängige Koeffizienten , die den Frobenius-Norm-Abstand zu jedem Zeitpunkt minimieren. Wie im Hintergrund gezeigt, erfordert dies die Überlappungsmatrix zwischen Trotter-entwickelten Zuständen und die Überlappung mit dem exakten Zustand — beide schätzen wir mithilfe von Tensor-Netzwerk-(TeNPy-)Backends in qiskit_addon_mpf.
Um das dynamische LGS aufzustellen, benötigen wir drei Zutaten:
-
Eine Approximate-Evolver-Factory, die das Addon für jedes ausführt, um als MPS/MPO zu erzeugen. Wir bauen sie aus der geschichteten Struktur des Trotter-Circuits der Ordnung auf (eine Schicht pro
slice_by_depth), eingebettet alsLayerwiseEvolvermit TeNPy-Abschneideparametern. -
Eine Exact-Evolver-Factory, die eine hochgenaue Referenz erzeugt. Wir verwenden einen Suzuki-Trotter-Circuit vierter Ordnung mit kleinem Zeitschritt (
dt=0.1,order=4) als Näherung für die exakte Zeitentwicklung. -
Eine Identity-Factory und ein Anfangszustands-MPS, die die TeNPy-Simulation initialisieren.
Die Zelle unten konstruiert die Approximate-Evolver-Factory.
# Create approximate time-evolution circuits
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)  # collect XX and YY

# Find layers in the circuit
layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)

# Create tensor network models
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

# Create the time-evolution object
approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Die Optionen von LayerwiseEvolver, die die Details der Tensor-Netzwerk-Simulation bestimmen, müssen sorgfältig gewählt werden, um ein schlecht definiertes Optimierungsproblem zu vermeiden.
Wir approximieren den exakten zeitentwickelten Zustand mit einer Suzuki-Trotter-Formel vierter Ordnung unter Verwendung eines kleinen Zeitschritts dt=0.1. Die TeNPy-Trunkierungsparameter können die Genauigkeit beeinflussen, daher ist es wichtig, einen Bereich von Werten zu untersuchen.
single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Abschließend definieren wir eine identity_factory, die den anfänglichen MPO-Zustand liefert, und bereiten den Néel-Anfangszustand als MPS vor, der zum Gitter des geschichteten Trotter-Modells passt.
def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)
Mit den Factories an Ort und Stelle berechnen wir nun die dynamischen Koeffizienten zu jedem Zeitpunkt der Zeitentwicklung. Für jedes baut setup_dynamic_lse die relevanten Überlappungsmatrizen über TeNPy auf, und setup_frobenius_problem liefert ein cvxpy.Problem, das die Frobenius-Norm-Kosten minimiert. Der Solver liefert auf diesen Zeitpunkt zugeschnittene Koeffizienten ; wir sammeln sie in mpf_dynamic_coeffs_list. Schlägt der Solver für ein gegebenes fehl, greifen wir auf Nullkoeffizienten zurück, damit die Schleife fortgesetzt wird.
mpf_dynamic_coeffs_list = []
for t in trotter_times:
    print(f"Computing dynamic coefficients for time={t}")
    lse = setup_dynamic_lse(
        mpf_trotter_steps,
        t,
        identity_factory,
        exact_factory,
        approx_factory,
        mps_initial_state,
    )
    problem, coeffs = setup_frobenius_problem(lse)
    try:
        problem.solve()
        mpf_dynamic_coeffs_list.append(coeffs.value)
    except Exception as error:
        mpf_dynamic_coeffs_list.append(np.zeros(len(mpf_trotter_steps)))
        print(error, "Calculation Failed for time", t)
    print("")
Computing dynamic coefficients for time=0.5

Computing dynamic coefficients for time=0.6

Computing dynamic coefficients for time=0.7

Computing dynamic coefficients for time=0.7999999999999999

Computing dynamic coefficients for time=0.8999999999999999

Computing dynamic coefficients for time=0.9999999999999999

Computing dynamic coefficients for time=1.0999999999999999

Computing dynamic coefficients for time=1.1999999999999997

Computing dynamic coefficients for time=1.2999999999999998

Computing dynamic coefficients for time=1.4

Computing dynamic coefficients for time=1.4999999999999998
Trotter-Erwartungswerte mit den MPF-Koeffizienten kombinieren
Nun werten wir für jeden Satz von Koeffizienten aus (statisch-exakt, statisch-approximativ und dynamisch), propagieren die Standardfehler pro Circuit und stellen die resultierende Zeitreihe der exakten Diagonalisierungskurve gegenüber.
sym = {1: "^", 2: "s", 4: "p"}
# Get expectation values at all times for each Trotter step
for k, step in enumerate(mpf_trotter_steps):
    trotter_curve, trotter_curve_error = [], []
    for trotter_expvals, trotter_stds in zip(
        mpf_expvals_all_times, mpf_stds_all_times
    ):
        trotter_curve.append(trotter_expvals[k])
        trotter_curve_error.append(trotter_stds[k])

    plt.errorbar(
        trotter_times,
        trotter_curve,
        yerr=trotter_curve_error,
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

# Get expectation values at all times for the static MPF with exact coeffs
exact_mpf_curve, exact_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_exact.value, trotter_stds)
            ]
        )
    )
    exact_mpf_curve_error.append(mpf_std)
    exact_mpf_curve.append(trotter_expvals @ coeffs_exact.value)

plt.errorbar(
    trotter_times,
    exact_mpf_curve,
    yerr=exact_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Exact",
    color="purple",
)

# Get expectation values at all times for the static MPF with approximate coeffs
approx_mpf_curve, approx_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_approx.value, trotter_stds)
            ]
        )
    )
    approx_mpf_curve_error.append(mpf_std)
    approx_mpf_curve.append(trotter_expvals @ coeffs_approx.value)

plt.errorbar(
    trotter_times,
    approx_mpf_curve,
    yerr=approx_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Approx",
    color="orange",
)

# Get expectation values at all times for the dynamic MPF
dynamic_mpf_curve, dynamic_mpf_curve_error = [], []
for trotter_expvals, trotter_stds, dynamic_coeffs in zip(
    mpf_expvals_all_times, mpf_stds_all_times, mpf_dynamic_coeffs_list
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(dynamic_coeffs, trotter_stds)
            ]
        )
    )
    dynamic_mpf_curve_error.append(mpf_std)
    dynamic_mpf_curve.append(trotter_expvals @ dynamic_coeffs)

plt.errorbar(
    trotter_times,
    dynamic_mpf_curve,
    yerr=dynamic_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Dynamic MPF",
    color="pink",
)

# Exact expectation values
plt.plot(
    exact_evolution_times,
    exact_expvals,
    color="red",
    linestyle="--",
    label="Exact time-evolution",
)

plt.title(f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ vs time")
plt.xlabel("Time")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Der obige Plot veranschaulicht das Zusammenspiel zwischen Trotter-Fehler und Sampling-Fehler.
-
Trotter-Fehler. Die einzelnen Produktformeln (graue Marker) weichen mit wachsender Zeit immer stärker von der exakten Kurve ab. Der Circuit mit hat die größte Abweichung und ist der flachste, befindet sich aber auch bereits in dem Bereich, in dem gilt, sodass der führende -Fehlerterm groß ist. Die MPF-Kombinationen (farbige Marker) heben mehrere dieser führenden Trotter-Fehlerterme auf und folgen der exakten Kurve daher viel enger als jeder einzelne -Circuit. Die verbleibende Lücke spiegelt die Trotter-Terme höherer Ordnung wider, die die MPF nicht aufhebt: Eine statische MPF der Ordnung mit eliminiert nur die ersten beiden Fehlerordnungen, und bei großem dominiert schließlich der nicht aufgehobene Rest — die MPF garantiert also nicht, dass sehr flache Circuits zu beliebigen Zeiten genau bleiben.
-
Sampling-Fehler. Die breiteren Fehlerbalken bei den MPF-Kurven sind eine direkte Folge der Linearkombination: Die Propagation unabhängiger Standardfehler pro Circuit ergibt eine Gesamtvarianz . Je größer also ist (und in der Praxis , das wir kontrollieren), desto mehr Shots sind erforderlich, um eine gegebene Zielunsicherheit zu erreichen. Dies ist der Kompromiss hinter der Näherungslöser-Option im Hintergrund: Wir begrenzen , um diesen Mehraufwand handhabbar zu halten. Entscheidend ist, dass der Sampling-Fehler, anders als der Trotter-Fehler, mit schrumpft und daher immer durch mehr Shots reduziert werden kann.
Im untenstehenden Hardware-Beispiel im großen Maßstab kommt Hardware-Rauschen als zusätzliche Fehlerquelle bei jedem hinzu, das ebenso durch die MPF-Koeffizienten verstärkt wird. Wir werden in diesem Abschnitt sehen, wie Fehlerminderung mit MPFs zusammenwirkt.
Hardware-Beispiel im großen Maßstab
In diesem Abschnitt skalieren wir das Problem über das hinaus, was sich exakt simulieren lässt. Wir reproduzieren einige der in Ref. [3] gezeigten Ergebnisse anhand einer 50-Qubit-XXZ-Kette zur Zeit . Wir folgen demselben vierschrittigen Workflow wie beim Beispiel im kleinen Maßstab, richten uns nun aber an echte Quantenhardware mit Fehlerminderung. Wie in der Vorlage ist jeder Schritt im Code inline markiert, und ein einzelner Schritt kann mehrere Zellen umfassen, wenn sich ein Blick auf seine Zwischenergebnisse lohnt. Die Zuordnung entspricht dem Beispiel im kleinen Maßstab: einen Hamiltonian definieren, Trotter-Parameter wählen, MPF-Koeffizienten (statisch und dynamisch) berechnen und Circuits erstellen. Die wichtigsten Unterschiede sind:
-
Ein XXZ-Hamiltonian auf 50 Plätzen mit zufälligen Kopplungen, gezogen aus (Ref. [3]).
-
Eine symmetrische Trotter-Formel zweiter Ordnung mit (also ,
symmetric=True). -
Eine einzelne feste Zeitentwicklungsdauer . Mit ergibt dies , wodurch die flachen Bestandteile innerhalb des Trotter-Konvergenzbereichs bleiben, in dem das Modell des führenden Fehlers, auf dem die MPF beruht, gültig ist.
-
Ein zusätzlicher Vergleichslauf mit einem einzelnen Circuit bei Trotter-Schritten, der als Baseline dient. Wir haben gewählt, weil seine Zwei-Qubit-Tiefe auf der Hardware größer ist als die des tiefsten MPF-Bestandteils () zuzüglich des Mehraufwands für die Ausführung mehrerer MPF-Circuits — tief genug, um rauschbegrenzt zu sein, also genau der Bereich, in dem die MPF-Kombination die Baseline mit einem einzelnen Circuit übertreffen sollte. Es handelt sich um einen Vergleich „einzelner tiefer Circuit" gegen die MPF-Kombination, nicht um einen Circuit, der auf den effektiven Trotter-Fehler der MPF abzielt (was deutlich mehr Schritte erfordern würde).
Beachte, dass wir hier zwar noch in Schritt 1 sind (Zuordnung und Circuit-Aufbau), in dieser Zelle aber bereits die dynamischen Koeffizienten zusammen mit den statischen vorberechnen. Dynamische Koeffizienten hängen von und ab, nicht aber von den Quantenmessungen, sodass sie jederzeit vor Schritt 4 berechnet werden können. Wir tun dies bereits jetzt, um das gesamte MPF-spezifische Setup an einem Ort zu bündeln.
# -------------------------Step 1-------------------------
L = 50
coupling_map = CouplingMap.from_line(L, bidirectional=False)

# XXZ Hamiltonian with random couplings (Ref. [3])
np.random.seed(0)
even_edges = list(coupling_map.get_edges())[::2]
odd_edges = list(coupling_map.get_edges())[1::2]

Js = np.random.uniform(0.5, 1.5, size=L)
hamiltonian = SparsePauliOp(Pauli("I" * L))
for i, edge in enumerate(even_edges + odd_edges):
    hamiltonian += SparsePauliOp.from_sparse_list(
        [
            ("XX", (edge), 2 * Js[i]),
            ("YY", (edge), 2 * Js[i]),
            ("ZZ", (edge), 4 * Js[i]),
        ],
        num_qubits=L,
    )

observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)

total_time = 3
mpf_trotter_steps = [3, 4, 6]
order = 2
symmetric = True

# Static coefficients
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
mpf_coeffs = lse.solve()
print(f"Static coefficients: {mpf_coeffs}")
print(f"L1 norm: {np.linalg.norm(mpf_coeffs, ord=1)}")

model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=2.0
)
model_approx.solve()
print(f"Approximate coefficients: {coeffs_approx.value}")
print(f"L1 norm (approx): {np.linalg.norm(coeffs_approx.value, ord=1)}")

# -------------------------Dynamic coefficients-------------------------
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)

layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 4,
    },
)

single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 3,
    },
)

def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)

print(f"Computing dynamic coefficients for time={total_time}")
lse_dyn = setup_dynamic_lse(
    mpf_trotter_steps,
    total_time,
    identity_factory,
    exact_factory,
    approx_factory,
    mps_initial_state,
)
problem, coeffs_dyn = setup_frobenius_problem(lse_dyn)
try:
    problem.solve()
    mpf_dynamic_coeffs = coeffs_dyn.value
except Exception as error:
    mpf_dynamic_coeffs = np.zeros(len(mpf_trotter_steps))
    print(error, "Calculation Failed")

# -------------------------Step 1 (cont): Build circuits-------------------------
mpf_circuits = []
for k in mpf_trotter_steps:
    circuit = QuantumCircuit(L)
    circuit.x([i for i in range(L) if i % 2])
    trotter_circ = generate_time_evolution_circuit(
        hamiltonian,
        synthesis=SuzukiTrotter(reps=k, order=order),
        time=total_time,
    )
    circuit.compose(trotter_circ, qubits=range(L), inplace=True)
    mpf_circuits.append(circuit)

# Baseline "single deep circuit" comparison run with k=10 Trotter steps.
# Its two-qubit depth is deeper than the deepest MPF constituent (k_max=6) plus
# the overhead of running multiple circuits, pushing it into the noise-limited
# regime where MPF is expected to outperform. It does NOT target the MPF's effective
# Trotter error (which would require many more steps).
comp_circuit = QuantumCircuit(L)
comp_circuit.x([i for i in range(L) if i % 2])
trotter_circ = generate_time_evolution_circuit(
    hamiltonian,
    synthesis=SuzukiTrotter(reps=10, order=order),
    time=total_time,
)
comp_circuit.compose(trotter_circ, qubits=range(L), inplace=True)
mpf_circuits.append(comp_circuit)
Static coefficients: [ 0.42857143 -1.82857143  2.4       ]
L1 norm: 4.65714285714286
Approximate coefficients: [-0.4942491   0.40206845  1.09218065]
L1 norm (approx): 1.9884981979026675
Computing dynamic coefficients for time=3
Wir optimieren nun die Circuits für das gewählte Backend. Wir verwenden den voreingestellten Qiskit-Pass-Manager mit optimization_level=3, der automatisch eine gute Menge physischer Qubits auswählt und jeden Circuit auf die Gerätetopologie routet.
# -------------------------Step 2-------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(operational=True, simulator=False, min_num_qubits=L)
backend = service.backend("ibm_fez")
print(backend)

transpiler = generate_preset_pass_manager(
    optimization_level=3, backend=backend
)
transpiled_circuits = [transpiler.run(circ) for circ in mpf_circuits]

isa_observables = [
    observable.apply_layout(circ.layout) for circ in transpiled_circuits
]
<IBMBackend('ibm_fez')>
Das Ausführen tieferer Circuits auf echter Hardware erfordert aggressive Fehlerminderung. Wir aktivieren dynamische Entkopplung, Gate- und Messungs-Twirling, Fehlerminderung beim Auslesen sowie Zero-Noise-Extrapolation (ZNE). Beachte, dass die hier verwendeten ZNE-Rauschfaktoren (1, 1.2, 1.4) kleiner sind als in einem Szenario mit flachen Circuits, da die tieferen MPF-Bestandteile bereits nahe an der Rauschschwelle liegen und große Rauschverstärkungen sie über den Punkt hinaustreiben würden, an dem die ZNE-Extrapolation noch zuverlässig ist.
Wir reichen alle vier Circuits (drei MPF-Bestandteile bei plus die -Baseline) in einem einzigen Estimator-Job ein.
# -------------------------Step 3-------------------------
estimator = Estimator(mode=backend)
estimator.options.default_shots = 30000

# Error suppression/mitigation
estimator.options.dynamical_decoupling.enable = True
estimator.options.twirling.enable_gates = True
estimator.options.twirling.enable_measure = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.twirling.strategy = "active-accum"
estimator.options.resilience.measure_mitigation = True
estimator.options.experimental.execution_path = "gen3-turbo"

estimator.options.resilience.zne_mitigation = True
estimator.options.resilience.zne.noise_factors = (1, 1.2, 1.4)
estimator.options.resilience.zne.extrapolator = "linear"

estimator.options.environment.job_tags = ["TUT_MPF"]

job_50 = estimator.run(
    [
        (circ, observable)
        for circ, observable in zip(transpiled_circuits, isa_observables)
    ]
)
Wir extrahieren die Erwartungswerte und Standardabweichungen pro Circuit aus dem Job-Ergebnis und kombinieren sie dann mit jedem Satz von MPF-Koeffizienten genau wie im Beispiel im kleinen Maßstab: , mit propagierter Varianz .
# -------------------------Step 4-------------------------
result = job_50.result()
evs = [res.data.evs for res in result]
std = [res.data.stds for res in result]

print(evs)
print(std)
[array(-0.07916195), array(-0.04479681), array(-0.2560756), array(-0.06045848)]
[array(0.04605538), array(0.10056336), array(0.14426151), array(0.04059092)]
exact_mpf_std = np.sqrt(
    sum([(coeff**2) * (std**2) for coeff, std in zip(mpf_coeffs, std[:3])])
)
print(
    "Exact static MPF expectation value: ",
    evs[:3] @ mpf_coeffs,
    "+-",
    exact_mpf_std,
)
approx_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(coeffs_approx.value, std[:3])
        ]
    )
)
print(
    "Approximate static MPF expectation value: ",
    evs[:3] @ coeffs_approx.value,
    "+-",
    approx_mpf_std,
)
dynamic_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(mpf_dynamic_coeffs, std[:3])
        ]
    )
)
print(
    "Dynamic MPF expectation value: ",
    evs[:3] @ mpf_dynamic_coeffs,
    "+-",
    dynamic_mpf_std,
)
Exact static MPF expectation value:  -0.5665938395816946 +- 0.3925273058119915
Approximate static MPF expectation value:  -0.25856647611537903 +- 0.164249927266166
Dynamic MPF expectation value:  -0.12667812062949296 +- 0.06059471006973169
sym = {3: "^", 4: "s", 6: "p"}
for k, step in enumerate(mpf_trotter_steps):
    plt.errorbar(
        k,
        evs[k],
        yerr=std[k],
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

plt.errorbar(
    3,
    evs[-1],
    yerr=std[-1],
    alpha=0.5,
    markersize=8,
    marker="x",
    color="blue",
    label="10 Trotter steps",
)

plt.errorbar(
    4,
    evs[:3] @ mpf_coeffs,
    yerr=exact_mpf_std,
    markersize=4,
    marker="o",
    color="purple",
    label="Static MPF",
)

plt.errorbar(
    5,
    evs[:3] @ coeffs_approx.value,
    yerr=approx_mpf_std,
    markersize=4,
    marker="o",
    color="orange",
    label="Approximate static MPF",
)

plt.errorbar(
    6,
    evs[:3] @ mpf_dynamic_coeffs,
    yerr=dynamic_mpf_std,
    markersize=4,
    marker="o",
    color="pink",
    label="Dynamic MPF",
)

exact_obs = -0.24384471447172074  # Calculated via Tensor Network calculation
plt.axhline(
    y=exact_obs, linestyle="--", color="red", label="Exact time-evolution"
)

plt.title(
    f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ at time {total_time} for the different methods"
)
plt.xlabel("Method")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Ein paar Beobachtungen zu den obigen Hardware-Ergebnissen:
-
Tiefer zu gehen ist auf Hardware nicht kostenlos. Die Baselines mit einzelnen Circuits erzählen die Geschichte direkt: Der Circuit mit ist im Wesentlichen exakt ( gegenüber der Referenz ), doch die tiefere Baseline mit ist schlechter (, um daneben), nicht besser. Sobald der Trotter-Fehler bereits klein ist, vertieft das Hinzufügen weiterer Schritte vor allem den Circuit und akkumuliert mehr Gate-Rauschen und Dekohärenz. Genau für diesen Bereich sind MPFs konzipiert: die Genauigkeit eines tiefen Circuits nur mit flachen Bestandteilen zu erreichen.
-
Eine MPF mit kleiner Norm schlägt den tiefen Einzel-Circuit. Die statische Näherungs-MPF (begrenzt auf ) liegt bei , innerhalb von der Referenz und damit deutlich näher als die -Baseline. Die dynamische MPF () übertrifft diese Baseline ebenfalls deutlich. Beide kombinieren nur die flachen Circuits und liefern dennoch ein Ergebnis, das der tiefe Einzel-Circuit nicht erreichen konnte.
-
Die Koeffizientennorm ist wichtiger als mathematische Optimalität. Die exakte statische MPF hat und ist von allen Schätzern der schlechteste (, mehr als daneben): Die große Koeffizientennorm verstärkt das verbleibende Gate-Rauschen, die Dekohärenz und den ZNE-Fehler bei jedem um ungefähr denselben Faktor und überwiegt damit die Aufhebung des Trotter-Fehlers, die sie eigentlich erkauft. Wird die Norm begrenzt (der statische Näherungslöser, ), verschwindet dieses Übergewicht, und man erhält die beste Schätzung — auch wenn ihre Koeffizienten den führenden Trotter-Fehler nicht mehr exakt aufheben.
-
Einzelne flache Circuits können trotzdem konkurrenzfähig sein. Der einzelne -Bestandteil () ist hier für sich genommen im Wesentlichen exakt — in diesem Lauf liegt er sogar geringfügig näher als die statische Näherungs-MPF. Der Haken ist, dass man im Voraus nicht weiß, welches einzelne im Sweet Spot von „konvergiert, aber noch nicht rauschbegrenzt“ liegt, und dass ausgerechnet die scheinbar sichere Wahl, einfach tiefer zu gehen (), um Trotter-Konvergenz zu garantieren, diejenige ist, die scheitert. Die MPF liefert eine prinzipiengeleitete Kombination flacher Circuits, bei der man die richtige Tiefe nicht erraten muss.
Der praktische Schluss daraus ist: Auf Hardware sollten MPFs mit starker Fehlerminderung für jedes einzelne kombiniert werden, die -Norm der Koeffizienten sollte moderat gehalten werden (den Näherungslöser oder die dynamische MPF verwenden), und die Trotter-Schritte sollten so gewählt werden, dass gilt — hier ergibt bei einen Wert von , wodurch die Bestandteile im konvergenten Regime bleiben, in dem das Modell des führenden Fehlers, auf das sich die statische MPF stützt, gültig ist. Mit diesen Entscheidungen erreichen die MPFs mit kleiner Norm hier das Niveau eines konvergierten Einzel-Circuits, während die naive Baseline „einfach tiefer gehen“ das nicht schafft, wodurch das in Referenz [3] gezeigte günstige Verhältnis von Tiefe und Genauigkeit wiederhergestellt wird. Beachte außerdem, dass einzelne Läufe verrauscht sind — bei einer anderen Einreichung desselben Jobs (oder einem anderen Backend) kann sich die genaue Reihenfolge verschieben; die robusten Trends sind, dass MPFs mit kleinem gut abschneiden, die exakte statische MPF mit großem durch Hardware-Rauschen verstärkt wird und der übermäßig tiefe Einzel-Circuit rauschbegrenzt ist.
Nächste Schritte
Falls du diese Arbeit interessant fandest, könnte dich auch folgendes Material interessieren:
- Wie man die Trotter-Schritte für eine MPF wählt — praktische Anleitung zur Auswahl von -Werten, um Instabilitäten zu vermeiden
- Wie man das Näherungsmodell verwendet — Abstimmung der -Norm-Einschränkung und der Solver-Optionen für die statische Näherungs-MPF
qiskit-addon-mpf-API-Referenz — vollständige Dokumentation für die static-, dynamic- und backend-Module
Referenzen
[1] Vazquez, A. C., Egger, D. J., Ochsner, D., & Woerner, S. Well-conditioned multi-product formulas for hardware-friendly Hamiltonian simulation. Quantum, 7, 1067 (2023)
[2] Zhuk, S., Robertson, N. F., & Bravyi, S. Trotter error bounds and dynamic multi-product formulas for Hamiltonian simulation. Physical Review Research, 6(3), 033309 (2024)
[3] Robertson, N. F., et al. Tensor network enhanced dynamic multiproduct formulas. arXiv:2407.17405 (2024)