Spin- und Ladungsdynamik im Fermi-Hubbard-Modell
Geschätzte Nutzung: 5 Minuten auf einem Heron-r3-Prozessor. (HINWEIS: Dies ist nur eine Schätzung. Deine Laufzeit kann abweichen.)
Hintergrund
Das Fermi-Hubbard-Modell beschreibt Elektronen, die auf einem Gitter hüpfen, mit einer Energiestrafe für Doppelbesetzung. Auf einer eindimensionalen Kette mit Plätzen und offenen Rändern ist der Hamiltonoperator wie folgt definiert:
wobei ein Fermion mit Spin auf Platz erzeugt und sie zählt. Die drei Terme sind die Hüpfamplitude auf der Bindung zwischen den Plätzen und , die Wechselwirkung am Platz und das chemische Potenzial . Das Tutorial misst Energie in Einheiten von und Zeit in Einheiten von .
Die Echtzeitdynamik dieses Modells ist klassisch schwer zu berechnen. Die exakte Diagonalisierung endet bei etwa Plätzen, und nach einem Quench wächst die Verschränkungsentropie eines Tensornetzwerk-Lösers linear mit der Zeit, sodass die für eine feste Genauigkeit nötige Bonddimension exponentiell wächst.
In einer Dimension sind die elementaren Anregungen Spinonen, die Spin, aber keine Ladung tragen, und Holonen, die Ladung, aber keinen Spin tragen. Beide breiten sich mit unterschiedlichen Geschwindigkeiten aus, sodass sich eine lokalisierte Störung in eine schnelle und eine langsame Front aufspaltet. Dieser Effekt heißt Spin-Ladungs-Trennung, und dieses Tutorial misst ihn [1].
Dieses Tutorial verwendet die Qiskit Function Dynamics Simulator, die den Hamiltonoperator, einen Anfangszustand, einen Trotter-Plan und eine Liste von Observablen entgegennimmt und Erwartungswerte zurückgibt. Sie übernimmt die Jordan-Wigner-Abbildung, die Trotterisierung, das Qubit-Layout und die Fehlerunterdrückung intern, daher gibt es in diesem Tutorial keine Circuits zu erstellen oder zu transpilieren.
Voraussetzungen
Bevor du mit diesem Tutorial beginnst, stelle sicher, dass die folgenden Pakete installiert sind:
-
Qiskit SDK v2.3.0 oder höher (
pip install qiskit) -
Qiskit Runtime v0.50.0 oder höher (
pip install qiskit-ibm-runtime) -
Qiskit Functions Catalog v0.21.0 oder höher (
pip install qiskit-ibm-catalog) -
NumPy v2.5.1 oder höher (
pip install numpy) -
Matplotlib v3.10.3 oder höher (
pip install matplotlib) -
Q-CTRL Visualizer v11.0.0 oder höher (
pip install qctrl-visualizer)
Einrichtung
Authentifiziere dich zunächst mit deinem IBM Quantum API-Schlüssel. Wähle dann die Qiskit Function wie folgt aus. (Dieser Code setzt voraus, dass du dein Konto bereits in deiner lokalen Umgebung gespeichert hast.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qctrlvisualizer": "qctrlvisualizer", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from qiskit_ibm_runtime import QiskitRuntimeService
import qctrlvisualizer as qv

plt.style.use(qv.get_qctrl_style())
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Access Function
sim_qf = catalog.load("q-ctrl/dynamics-simulator")
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Den Hamiltonoperator definieren
Die Function nimmt das Modell als Dictionary mit drei Schlüsseln entgegen. Jeder akzeptiert entweder einen einzelnen Float, der gleichmäßig entlang der Kette gilt, oder eine Liste, die den Wert Platz für Platz angibt. Listen haben Einträge für hopping_amplitude, weil eine offene Kette eine Bindung weniger als Plätze hat, und Einträge für on_site_interaction und chemical_potential.
Dieses Tutorial verwendet eine gleichmäßige Kette mit 31 Plätzen und einer abstoßenden Wechselwirkung . Ein gleichmäßiges chemisches Potenzial trägt bei fester Teilchenzahl nur eine globale Phase bei, daher setzt dieses Beispiel es auf null. Das chemische Potenzial spielt nur dann eine Rolle, wenn es von Platz zu Platz variiert, zum Beispiel um Unordnung oder eine einzelne Störstelle hinzuzufügen.
site_count = 31
hopping_amplitude = 1.0
on_site_interaction = 8.0
chemical_potential = 0.0

model = {
    "hopping_amplitude": [hopping_amplitude] * (site_count - 1),
    "on_site_interaction": [on_site_interaction] * site_count,
    "chemical_potential": [chemical_potential] * site_count,
}

print(
    f"{site_count} sites, {2 * site_count} qubits, U/t_h = {on_site_interaction:.0f}"
)
31 sites, 62 qubits, U/t_h = 8
Den Trotter-Plan festlegen
Das Dictionary simulation enthält den Zeitschritt () und die Anzahl der Trotter-Schritte, und die gesamte Entwicklungszeit ist ihr Produkt. Größere Schritte erreichen bei fester Circuit-Tiefe spätere Zeiten, verursachen aber mehr Trotter-Fehler, der mit wächst, weil die Terme des Hamiltonoperators weniger kommutieren. Die veröffentlichte Hardwarestudie verwendete für [2], und dieses Tutorial verwendet denselben Wert. Die Circuit-Tiefe wächst linear mit der Schrittzahl und hängt überhaupt nicht von ab.
time_step = 0.15
step_count = 30

simulation = {"time_step": time_step, "step_count": step_count}

print(
    f"Total evolution time: t = {time_step * step_count:.2f} (units of 1/t_h)"
)
Total evolution time: t = 4.50 (units of 1/t_h)
Den Anfangszustand vorbereiten
Jeder Platz enthält zwei Spinorbitale, daher verwendet eine Kette mit Plätzen Qubits. Der Anfangszustand ist eine Fock-Besetzungszeichenkette mit einem Zeichen pro Platz:
Die Zeichenkette wird beginnend mit dem niederwertigsten Platz gelesen, daher ist das ganz rechte Zeichen Platz 0, und der physikalische Platzindex von Zeichen , von links gezählt, ist . Die Zeichenkette udud bedeutet daher, dass Platz 0 d ist, Platz 1 u, Platz 2 d und Platz 3 u.
Bereite als Nächstes einen halb gefüllten Néel-Zustand vor, der u und d abwechselt, wobei der mittlere Platz durch eine Leerstelle ersetzt wird. Die Leerstelle ist die Störung, deren Ausbreitung verfolgt wird.
vacancy_site = site_count // 2

# Build in increasing site order, then reverse: the leftmost character of the
# string is the highest site index.
site_occupations = [
    "u" if site % 2 == 0 else "d" for site in range(site_count)
]
site_occupations[vacancy_site] = "e"
initial_state = "".join(reversed(site_occupations))

print(f"Vacancy at site {vacancy_site}")
print(initial_state)
Vacancy at site 15
udududududududueudududududududu
Die Observablen erstellen
Jede Observable ist ein Dictionary, das eine gewichtete Summe von Produkten von Besetzungsoperatoren darstellt:
Jeder Eintrag von operators ist ein Term , geschrieben als Liste von [name, site]-Paaren, die miteinander multipliziert werden, und der entsprechende Eintrag von coefficients ist sein Gewicht. Die beiden Namen sind "Nup" für und "Ndn" für . Eine einzelne Ein-Punkt-Observable wird wie folgt geschrieben:
{"operators": [[["Nup", 3]]], "coefficients": [1.0]}
Die nächste Zelle gibt die kleinste vollständige Menge an Eingaben aus, die die Function akzeptiert, was beim Lesen des folgenden Codes als Referenz für die Struktur nützlich ist.
minimal_inputs = {
    "model": {
        "hopping_amplitude": 1.0,
        "on_site_interaction": [2.0, 2.5],
        "chemical_potential": 0.5,
    },
    "simulation": {"step_count": 5, "time_step": 0.1},
    "observables": [{"operators": [[["Nup", 0]]], "coefficients": [1.0]}],
    "initial_state": "ud",
    "shots": 4096,
}

for key, value in minimal_inputs.items():
    print(f"{key}: {value}")
model: {'hopping_amplitude': 1.0, 'on_site_interaction': [2.0, 2.5], 'chemical_potential': 0.5}
simulation: {'step_count': 5, 'time_step': 0.1}
observables: [{'operators': [[['Nup', 0]]], 'coefficients': [1.0]}]
initial_state: ud
shots: 4096
Es werden drei Gruppen von Observablen benötigt. Die Ladungsdichte und der lokale Spin sind beide Zwei-Term-Summen über dieselben Operatoren und unterscheiden sich nur in ihren Koeffizienten. Der Spinkorrelator zwischen Platz und dem Leerstellenplatz erweitert sich zu vier Zwei-Punkt-Termen mit Koeffizienten .
Besetzungsoperatoren kommutieren, daher ist die Reihenfolge der Faktoren innerhalb eines Terms unerheblich, aber die Reihenfolge der Liste observables legt die Reihenfolge der zurückgegebenen Werte fest. Der Code merkt sich beim Aufbau der Liste einen Index für jede Gruppe. Der Korrelator überspringt den Leerstellenplatz, an dem das Produkt einen Faktor wiederholen würde.
observables = []
charge_indices = []
spin_indices = []
correlator_indices = []

# Charge density: n_i = n_{i,up} + n_{i,down}
for site in range(site_count):
    charge_indices.append(len(observables))
    observables.append(
        {
            "operators": [[["Nup", site]], [["Ndn", site]]],
            "coefficients": [1.0, 1.0],
        }
    )

# Local spin: S^z_i = (n_{i,up} - n_{i,down}) / 2
for site in range(site_count):
    spin_indices.append(len(observables))
    observables.append(
        {
            "operators": [[["Nup", site]], [["Ndn", site]]],
            "coefficients": [0.5, -0.5],
        }
    )

# Spin correlator: S^z_i S^z_{i_*}, expanded into four two-point terms.
correlator_sites = [
    site for site in range(site_count) if site != vacancy_site
]
for site in correlator_sites:
    correlator_indices.append(len(observables))
    observables.append(
        {
            "operators": [
                [["Nup", site], ["Nup", vacancy_site]],
                [["Nup", site], ["Ndn", vacancy_site]],
                [["Ndn", site], ["Nup", vacancy_site]],
                [["Ndn", site], ["Ndn", vacancy_site]],
            ],
            "coefficients": [0.25, -0.25, -0.25, 0.25],
        }
    )

print(f"{len(observables)} observables")
print("Example correlator:", observables[correlator_indices[0]])
92 observables
Example correlator: {'operators': [[['Nup', 0], ['Nup', 15]], [['Nup', 0], ['Ndn', 15]], [['Ndn', 0], ['Nup', 15]], [['Ndn', 0], ['Ndn', 15]]], 'coefficients': [0.25, -0.25, -0.25, 0.25]}
Schritt 2: Das Problem für die Ausführung auf Quantenhardware optimieren
Dieses Tutorial hat keinen Transpilationsschritt. Die Function führt intern die folgenden Schritte aus [2], und du kannst sie nicht vom Notebook aus konfigurieren:
-
Bildet die fermionischen Moden auf Qubits ab, mit einer Anordnung, die die Pauli-Gewichte auf einem Heavy-Hex-Gitter niedrig hält
-
Verwendet ein fermionisches SWAP-Netzwerk, sodass jeder Hüpfterm zu einer Zwei-Qubit-Rotation wird
-
Bettet die Kette entlang eines Pfades ein, der schwache Qubits vermeidet
-
Wendet während der Kompilierung dynamische Entkopplung und Pauli-Twirling an
Du wählst das Backend und die Shot-Anzahl. Die Function nimmt einen Backend-Namen als String entgegen, daher wählt dieses Tutorial das am wenigsten ausgelastete Gerät, das groß genug für die Kette ist, und übergibt dessen Namen.
Das kleinste Signal, das du auflösen musst, bestimmt die Shot-Anzahl. Der Ladungs-Tracer erreicht Amplituden nahe , aber der verbundene Spin-Tracer erreicht nur etwa , ungefähr viermal weniger. Die veröffentlichte Studie verwendete aus diesem Grund 20.000 Shots pro Circuit [2].
service = QiskitRuntimeService()
backend = service.backend("ibm_boston")
backend_name = backend.name
shot_count = 20_000

print(f"{backend_name}, {shot_count} shots per circuit")
ibm_boston, 20000 shots per circuit
Schritt 3: Mit Qiskit-Primitives ausführen
Sende als Nächstes die Simulation ab. run gibt sofort ein Job-Handle zurück, statt zu blockieren.
job = sim_qf.run(
    model=model,
    simulation=simulation,
    observables=observables,
    initial_state=initial_state,
    shots=shot_count,
    backend_name=backend_name,
)
print(job.job_id, job.status())
6261b073-be19-48a1-be60-2f369b25613c QUEUED
Verwende job.status(), um den Fortschritt zu verfolgen, und job.result(), um zu blockieren, bis der Job abgeschlossen ist. Das Ergebnis ist ein Mapping, dessen Eintrag observable_expectation_values zuerst nach Observable, in der Reihenfolge, in der sie übergeben wurden, und dann nach Zeit indiziert ist. Es gibt step_count + 1 Zeitpunkte, weil der Wert bei enthalten ist.
result = job.result()

print("Result keys:", sorted(result.keys()))
Result keys: ['observable_expectation_values', 'observables', 'provider_job_ids', 'warnings']
Schritt 4: Nachverarbeiten und das Ergebnis im gewünschten klassischen Format zurückgeben
Die Korrelatoren rekonstruieren
Teile das flache Array mithilfe der zuvor festgehaltenen Indizes wieder in die drei Gruppen auf und bilde dann die beiden Tracer-Korrelatoren. Der Ladungs-Tracer ist die Änderung der Dichte pro Platz relativ zu :
Der Spin-Tracer ist der verbundene Korrelator zwischen jedem Platz und dem Leerstellenplatz :
Beide werden aus Operatoren der Fock-Basis aufgebaut, daher stammen sie aus denselben gemessenen Bitstrings, und der zweite kostet keine zusätzliche Hardwareausführung.
Beim Aufbau der Observablen hat der Code die Position jedes Ladungsoperators (charge_indices), Spinoperators (spin_indices) und Spinkorrelationsoperators (correlator_indices) in der Liste festgehalten. Da der Simulator die Erwartungswerte in derselben Reihenfolge zurückgibt, kannst du diese Positionen verwenden, um die zugehörigen Ergebnisse zu extrahieren. Für die Spinkorrelationen nutzt der Code zusätzlich correlator_sites, um jedes Ergebnis an der richtigen Gitterposition abzulegen, und lässt die Leerstelle als NaN.
expectation_values = np.asarray(
    result["observable_expectation_values"], dtype=float
)
times = np.arange(expectation_values.shape[1]) * time_step

charge_density = expectation_values[charge_indices]
local_spin = expectation_values[spin_indices]
spin_correlator = np.full_like(charge_density, np.nan)
spin_correlator[correlator_sites] = expectation_values[correlator_indices]

# Charge tracer: change in per-site density relative to t = 0.
charge_tracer = charge_density - charge_density[:, [0]]

# Spin tracer: connected correlator with the vacancy site.
spin_tracer = 4.0 * (spin_correlator - local_spin * local_spin[vacancy_site])
spin_tracer[vacancy_site] = np.nan

print(
    f"{expectation_values.shape[0]} observables, "
    f"{expectation_values.shape[1]} time points up to t = {times[-1]:.2f}"
)
print(
    f"Peak amplitudes: charge {np.nanmax(np.abs(charge_tracer)):.3f}, "
    f"spin {np.nanmax(np.abs(spin_tracer)):.3f}"
)
92 observables, 31 time points up to t = 4.50
Peak amplitudes: charge 0.978, spin 0.168
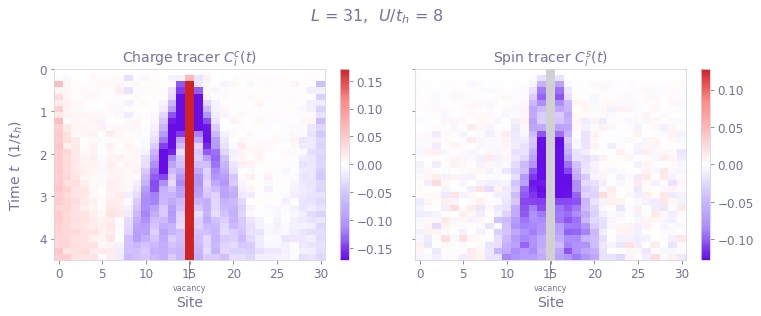
Die Wellenfronten visualisieren
Wenn du jeden Korrelator als Heatmap über Raum und Zeit darstellst, ist der Lichtkegel direkt sichtbar. Die Zeit verläuft nach unten, und die horizontale Achse ist die Position entlang der Kette.
def plot_tracer(axis, tracer, title):
    """Draw one tracer correlator as a space-time heatmap, time flowing down."""
    # Scale from the off-centre sites. The vacancy site carries an order-one
    # change in charge density and is left to clip rather than set the scale.
    off_center = np.ones(site_count, dtype=bool)
    off_center[vacancy_site] = False
    limit = np.nanpercentile(np.abs(tracer[off_center]), 98)

    colormap = qv.QCTRL_DIVERGENT_COLORMAP.reversed().copy()
    colormap.set_bad("0.82")  # the spin tracer has no value at the vacancy

    image = axis.imshow(
        tracer.T,
        aspect="auto",
        origin="upper",
        cmap=colormap,
        vmin=-limit,
        vmax=limit,
        extent=(-0.5, site_count - 0.5, times[-1], times[0]),
        interpolation="nearest",
    )

    axis.annotate(
        "vacancy",
        xy=(vacancy_site, times[-1]),
        xytext=(vacancy_site, times[-1] + 0.55),
        ha="center",
        va="top",
        fontsize=8,
        annotation_clip=False,
        arrowprops=dict(arrowstyle="-", lw=0.8, color="0.4"),
    )

    axis.set_title(title)
    axis.set_xlabel("Site")
    return image

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)

charge_image = plot_tracer(
    axes[0], charge_tracer, r"Charge tracer $C^{c}_{i}(t)$"
)
spin_image = plot_tracer(axes[1], spin_tracer, r"Spin tracer $C^{s}_{i}(t)$")

axes[0].set_ylabel(r"Time $t$  $(1/t_h)$")
fig.colorbar(charge_image, ax=axes[0], fraction=0.046)
fig.colorbar(spin_image, ax=axes[1], fraction=0.046)
fig.suptitle(f"$L$ = {site_count},  $U/t_h$ = {on_site_interaction:.0f}")
fig.tight_layout()
plt.show()
Die Wellenfrontgeschwindigkeiten extrahieren
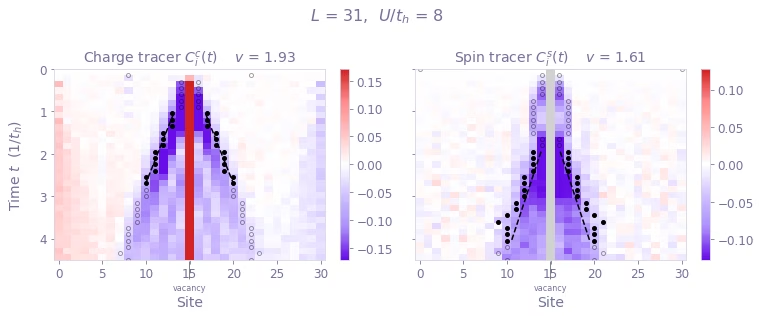
Wandle die Heatmaps in Zahlen um, indem du dem Detektionsprotokoll der veröffentlichten Studie [2] folgst. Symmetrisiere das räumliche Profil zu jedem Zeitschritt um die Leerstelle, wodurch der antisymmetrische Anteil des Hardwarerauschens herausgemittelt wird, normiere auf die größte Amplitude außerhalb des Zentrums und halte den äußersten Platz oberhalb eines Schwellenwerts fest. Die Detektionen werden anschließend in Abschnitte aufeinanderfolgender Zeitschritte zerlegt, und nur der längste Abschnitt wird gefittet, wodurch der frühe Einschwingvorgang aus dem Ergebnis herausbleibt.
def front_distance(profile, center, threshold):
    """Distance from `center` to the outermost site above a relative threshold."""
    values = np.nan_to_num(np.asarray(profile, dtype=float))
    length = values.size

    symmetrized = values.copy()
    for site in range(length):
        mirror = 2 * center - site
        if 0 <= mirror < length:
            symmetrized[site] = 0.5 * (values[site] + values[mirror])

    amplitude = np.abs(symmetrized)
    off_center = np.ones(length, dtype=bool)
    off_center[center] = False

    peak = amplitude[off_center].max()
    if peak <= 0.0:
        return np.nan
    above = np.flatnonzero((amplitude / peak > threshold) & off_center)
    return float(np.abs(above - center).max()) if above.size else np.nan

def longest_run(mask):
    """Indices of the longest run of consecutive True values."""
    best, current = [], []
    for index, keep in enumerate(mask):
        current = current + [index] if keep else []
        if len(current) > len(best):
            best = current
    return np.array(best, dtype=int)

def front_velocity(tracer, center, threshold=0.3, quantile=0.75, min_block=5):
    """Fit front position against time, using only the longest contiguous run."""
    distances = np.array(
        [
            front_distance(tracer[:, k], center, threshold)
            for k in range(tracer.shape[1])
        ]
    )
    edge = max(center, tracer.shape[0] - 1 - center)
    usable = (
        np.isfinite(distances) & (distances >= 2) & (distances <= edge - 2)
    )

    block = longest_run(usable)
    if block.size < min_block:
        return np.nan, distances, np.array([], dtype=int), np.nan

    candidates = [
        stats.theilslopes(distances[block[:k]], times[block[:k]]).slope
        for k in range(min_block, block.size + 1)
    ]
    cutoff = np.quantile(candidates, quantile)
    keep = max(i for i, value in enumerate(candidates) if value >= cutoff)

    fit_block = block[: keep + min_block]
    slope, intercept = np.polyfit(times[fit_block], distances[fit_block], 1)
    return float(slope), distances, fit_block, float(intercept)
Die gefittete Geschwindigkeit hängt vom Detektionsschwellenwert und vom Trimmquantil ab, und diese Empfindlichkeit überwiegt das Shot-Rauschen. Durchlaufe beide Parameter und gib den Median mit der vollen Einhüllenden an, wie es die veröffentlichte Analyse tut.
thresholds = [0.15, 0.225, 0.30, 0.375, 0.45]
quantiles = [0.60, 0.675, 0.75, 0.825, 0.90]

def velocity_envelope(tracer, center):
    """Median, minimum, and maximum velocity over the parameter scan."""
    values = [
        front_velocity(tracer, center, threshold=p, quantile=q)[0]
        for p in thresholds
        for q in quantiles
    ]
    values = np.array([v for v in values if np.isfinite(v)])
    if values.size == 0:
        return np.nan, np.nan, np.nan
    return float(np.median(values)), float(values.min()), float(values.max())

charge_velocity, charge_low, charge_high = velocity_envelope(
    charge_tracer, vacancy_site
)
spin_velocity, spin_low, spin_high = velocity_envelope(
    spin_tracer, vacancy_site
)

_, charge_front, charge_block, charge_intercept = front_velocity(
    charge_tracer, vacancy_site
)
_, spin_front, spin_block, spin_intercept = front_velocity(
    spin_tracer, vacancy_site
)

print(f"v_c = {charge_velocity:.2f}  [{charge_low:.2f}, {charge_high:.2f}]")
print(f"v_s = {spin_velocity:.2f}  [{spin_low:.2f}, {spin_high:.2f}]")
print(f"v_s / v_c = {spin_velocity / charge_velocity:.2f}")
v_c = 1.93  [1.81, 2.18]
v_s = 1.61  [1.23, 2.12]
v_s / v_c = 0.83
PUBLISHED = {"charge": 1.78, "spin": 1.46}

edge = max(vacancy_site, site_count - 1 - vacancy_site)
fig, axis = plt.subplots(figsize=(7, 4.6))

axis.axhspan(0, 2, color="0.92", zorder=0)
axis.axhspan(edge - 2, edge + 2, color="0.92", zorder=0)

series = [
    (
        "charge",
        "$v_c$",
        charge_front,
        charge_block,
        charge_velocity,
        charge_intercept,
        charge_low,
        charge_high,
        "C0",
        "o",
    ),
    (
        "spin",
        "$v_s$",
        spin_front,
        spin_block,
        spin_velocity,
        spin_intercept,
        spin_low,
        spin_high,
        "C1",
        "s",
    ),
]

for name, sym, front, block, v, b, lo, hi, color, marker in series:
    excluded = np.setdiff1d(np.arange(front.size), block)
    axis.plot(
        times[excluded],
        front[excluded],
        marker,
        color=color,
        markersize=5,
        markerfacecolor="none",
        alpha=0.45,
        zorder=2,
    )
    axis.plot(
        times[block],
        front[block],
        marker,
        color=color,
        markersize=5,
        label=f"{name}, {sym} = {v:.2f} [{lo:.2f}, {hi:.2f}]",
        zorder=3,
    )

    span = times[block]
    anchor = v * span[0] + b
    axis.plot(
        span,
        v * (span - span[0]) + anchor,
        "-",
        color=color,
        lw=1.6,
        zorder=4,
    )
    axis.fill_between(
        span,
        lo * (span - span[0]) + anchor,
        hi * (span - span[0]) + anchor,
        color=color,
        alpha=0.15,
        zorder=1,
    )
    axis.plot(
        span,
        PUBLISHED[name] * (span - span[0]) + anchor,
        "--",
        color=color,
        lw=1.2,
        alpha=0.8,
        zorder=4,
    )

axis.plot([], [], "--", color="0.4", lw=1.2, label="published [2]")
axis.plot(
    [],
    [],
    "o",
    color="0.5",
    markerfacecolor="none",
    label="excluded from fit",
)

axis.set_xlabel(r"Time $t$  $(1/t_h)$")
axis.set_ylabel("Front distance from vacancy (sites)")
axis.set_xlim(0, times[-1])
axis.set_ylim(
    0, min(edge + 1, np.nanmax(np.r_[charge_front, spin_front]) + 3)
)
axis.legend(loc="upper left", frameon=False, fontsize=9)
axis.set_title(
    f"L = {site_count}, $U/t_h$ = {on_site_interaction:.0f}, front propagation",
    fontsize=11,
)

fig.tight_layout()
plt.show()

Wenn du die Detektionen zurück auf die Heatmaps zeichnest, siehst du, ob der Algorithmus der Vorderkante gefolgt ist. Gefüllte Markierungen sind die Detektionen, die in den Fit eingegangen sind. Offene Markierungen wurden durch die Maskierungsregeln entfernt, entweder weil sie zu nah an der Leerstelle oder zu nah am Kettenende liegen oder weil sie so spät auftraten, dass die Front verbreitert und ihre Position nicht mehr scharf ist. Die gestrichelte Linie ist der Fit über die verwendeten Zeiten, und ihre Steigung ist die Geschwindigkeit im Titel jedes Diagramms.
Die Spalte der Leerstelle ist unterhalb der Achse markiert. Die Ladung wird dort begrenzt, weil ihr Wert in der Größenordnung eins liegt, und der Spin hat dort keinen Wert, weshalb er grau gezeichnet ist.
Der Ladungskegel öffnet sich weiter als der Spinkegel. Beide Störungen gehen im selben Moment vom selben Defekt aus und breiten sich mit unterschiedlichen Geschwindigkeiten nach außen aus.
def plot_tracer_front(axis, tracer, front, block, velocity, intercept, title):
    """Overlay the detected wavefront and the fitted cone on a tracer heatmap."""
    image = plot_tracer(axis, tracer, title)

    excluded = np.setdiff1d(np.arange(front.size), block)
    for index, filled in ((block, True), (excluded, False)):
        good = index[np.isfinite(front[index])]
        if good.size == 0:
            continue
        for sign in (-1, 1):
            axis.plot(
                vacancy_site + sign * front[good],
                times[good],
                "o",
                markersize=4,
                color="k",
                markerfacecolor="k" if filled else "none",
                markeredgewidth=0.9,
                alpha=1.0 if filled else 0.4,
            )

    span = times[block]
    for sign in (-1, 1):
        axis.plot(
            vacancy_site + sign * (velocity * span + intercept),
            span,
            "--",
            color="k",
            lw=1.5,
        )

    axis.set_title(f"{title}    $v$ = {velocity:.2f}")
    return image

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True)

charge_image = plot_tracer_front(
    axes[0],
    charge_tracer,
    charge_front,
    charge_block,
    charge_velocity,
    charge_intercept,
    r"Charge tracer $C^{c}_{i}(t)$",
)
spin_image = plot_tracer_front(
    axes[1],
    spin_tracer,
    spin_front,
    spin_block,
    spin_velocity,
    spin_intercept,
    r"Spin tracer $C^{s}_{i}(t)$",
)

axes[0].set_ylabel(r"Time $t$  $(1/t_h)$")
fig.colorbar(charge_image, ax=axes[0], fraction=0.046)
fig.colorbar(spin_image, ax=axes[1], fraction=0.046)
fig.suptitle(f"$L$ = {site_count},  $U/t_h$ = {on_site_interaction:.0f}")
fig.tight_layout()
plt.show()
Die Ladungsfront läuft der Spinfront davon. Ein Loch in einem eindimensionalen Mott-Hintergrund bewegt sich nicht wie ein Elektron. Stattdessen fraktionalisiert es in ein Holon, das die Ladung trägt, und ein Spinon, das die Spinstörung trägt, und bei ist das Spinon das langsamere der beiden.
Die Reihenfolge hängt von der Wechselwirkung ab. Bei ist das Modell ein System freier Fermionen mit und , der Spin ist also schneller. Die Abstoßung unterdrückt den Spintransport, während der Ladungstransport nahezu unberührt bleibt, und bei betragen die veröffentlichten Hardwarewerte und [2]. Wenn du den Lauf mit mehreren Werten von wiederholst und aufträgst, erhältst du eine Karte des Übergangs.
Beachte diese Einschränkungen bei den Zahlen. Die schwellenwertbasierte Detektion ist leicht nach unten verzerrt, daher ist eine Ladungsgeschwindigkeit, die einige Prozent unter dem veröffentlichten Wert liegt, zu erwarten. Die Einhüllende des Spins ist breit, weil der verbundene Korrelator näher am Rauschboden liegt, weshalb der Median des Scans statt eines einzelnen Fits angegeben wird.
Referenzen
[1] Essler, F. H. L., Frahm, H., Gohmann, F., Klumper, A., & Korepin, V. E. (2005). The One-Dimensional Hubbard Model. Cambridge University Press.
[2] Hartnett, G. S., Najafi, K. S., Khindanov, A., Liao, H., Schutzman, M., Hush, M. R., Biercuk, M. J., & Baum, Y. (2026). Fast, accurate, high-resolution simulation of large-scale Fermi-Hubbard models on a digital quantum processor. arXiv:2605.04025.