Fehlererkennung mit geringem Overhead durch Spacetime-Codes
Geschätzte Nutzungsdauer: 4 Minuten auf einem Heron-Prozessor (ibm_kingston oder vergleichbar) (HINWEIS: Dies ist nur eine Schätzung. Deine tatsächliche Laufzeit kann abweichen.)
Lernziele
-
Wie Spacetime-Pauli-Checks logische Fehler in Clifford-Circuits erkennen und wie die Postselektion anhand ihrer Syndrome die Fidelity einer gesampelten Verteilung steigert.
-
Wie du das Paket
qiskit-pauliceverwendest, um mitget_check_qubits,NoiseModelundadd_pauli_checksautomatisch hardware-effiziente Checks zu finden und einzufügen. -
Wie du die Fidelity eines Stabilizer-Zustands schätzt, indem du seine Stabilisatoren sampelst und anhand von Check-Syndromen postselektierst.
-
Wie du den vollständigen Fehlererkennungs-Workflow auf IBM Quantum®-Hardware ausführst und verrauschte mit postselektierten Fidelities vergleichst.
Voraussetzungen
-
Hardware-Grundlagen für Quantencomputing im Nutzmaßstab.
-
Den Clifford- und Stabilizer-Formalismus, einschließlich der Frage, wie eine Stabilisatorgruppe einen reinen Stabilizer-Zustand beschreibt.
Hintergrund
Low-overhead error detection with spacetime codes [1] von Simon Martiel und Ali Javadi-Abhari stellt eine Methode zur Erkennung logischer Fehler in Clifford-dominierten Circuits vor, die zwischen vollständiger Fehlerkorrektur und leichtgewichtigerer Fehlerminderung angesiedelt ist. Die Idee baut auf Coherent Pauli Checks (CPC) aus Single-shot error mitigation by coherent Pauli checks [2] von van den Berg und anderen auf. Bei beiden Ansätzen wird ein Clifford-„Payload"-Circuit mit Ancilla-Qubits verschränkt, um bestimmte Invarianten zu prüfen. Das Messen der Ancillas erzeugt ein Syndrom, das angibt, ob während der Ausführung ein Fehler erkannt wurde. Werden nur die Samples ohne erkannten Fehler behalten, verbessert das die Fidelity der gesampelten Verteilung – auf Kosten einer reduzierten Postselektionsrate.
Der entscheidende Unterschied zwischen Coherent Pauli Checks und Spacetime-Checks liegt in den Operatoren, die sie messen. Coherent Pauli Checks messen zeitlich lokalisierte Operatoren mit hohem Gewicht. Bei Qubit-Topologien mit eingeschränkter Konnektivität, wie zum Beispiel Heavy Hex, benötigen diese Checks viele SWAP-Gates und machen den Circuit oft zu tief, um in der Praxis ausgeführt zu werden. Die Implementierung der Checks als Spacetime-Codes verteilt stattdessen jeden Check über den Payload-Circuit hinweg in Raum und Zeit. Das ergibt eine hardware-effiziente Kodierung, die bei der Erkennung logischer Fehler wirksam bleibt und dabei den Qubit- und Tiefen-Overhead gering hält.
Was das Paket qiskit-paulice bewirkt
Das Paket qiskit-paulice automatisiert den Aufbau dieser Checks, sodass du sie nicht von Hand erstellen musst. Seine Hauptaufgabe besteht darin, gültige Spacetime-Pauli-Checks an den Stellen im Circuit zu finden und einzufügen, die die Fehlererkennung maximieren und gleichzeitig den Qubit-Overhead minimieren. Ein Check ist gültig, wenn seine Operatoren die logische Wirkung des Payload-Circuits unverändert lassen, leichtgewichtig, wenn er wenige verschränkende Gates verwendet, und effektiv, wenn er einen großen Teil der Fehler erkennt, gemessen am Rauschen, das der Check selbst einführt. Das Paket bewertet Kandidaten-Checks anhand eines Rauschmodells und übernimmt die besten davon in den Circuit. Dieses Tutorial verwendet drei API-Methoden:
-
get_check_qubitsuntersucht die Kopplungskarte eines Backends und gibt Ziel- und Ancilla-Qubit-Paare zurück. Ein Check auftarget_qubits[i]verwendetancilla_qubits[i]. -
NoiseModel.from_backenderstellt aus den Benchmark-Daten eines Backends ein grobes Rauschmodell. Das Modell bewertet Kandidaten-Checks, sodass kein exaktes, gelerntes Rauschmodell erforderlich ist. Ein gelerntes Pauli-Lindblad-Modell findest du unterNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checksfindet und fügt Checks in einen Circuit ein. Die Funktion gibt eine Sequenz vonCheckedCircuit-Objekten mit einer zunehmenden Anzahl an Checks zurück, und jedes Objekt stellt eineget_postselection_methodbereit, die einen gemessenen Bitstring auf einen Syndromvektor abbildet. Das Argumentcostwählt die Funktion aus, die einen Check bewertet (gamma, der Sampling-Overhead des postselektierten inversen Rauschkanals, oderLER, die logische Fehlerrate). Das Argumentmethodwählt die Suchstrategie aus (windowed,geneticoderwindowed_genetic). Dieses Tutorial verwendetcost="gamma"undmethod="windowed", was zusammen eine deterministische, reproduzierbare Check-Auswahl ergibt.
Fidelity aus Stabilizer-Sampling schätzen
Um zu messen, wie gut die Fehlererkennung funktioniert, kannst du die Fidelity des Stabilizer-Zustands , den der Circuit im Idealfall präpariert, gegenüber dem verrauschten Zustand , den die Hardware tatsächlich ausgibt, schätzen. Der Projektor auf einen reinen Stabilizer-Zustand entspricht dem gleichverteilten Mittelwert über die Elemente seiner Stabilisatorgruppe :
Setzt man dies in die Fidelity ein, ergibt sich die Fidelity von als der durchschnittliche Erwartungswert jedes Stabilisators bezüglich :
Bei größeren Problemen ist es nicht praktikabel, alle Stabilisatoren aufzuzählen, daher kannst du die Fidelity anhand einer Zufallsstichprobe schätzen. Das gleichverteilte zufällige Ziehen von Stabilisatoren aus liefert eine erwartungstreue Schätzung:
Da ein Clifford-Circuit einen stabilisierenden Zustand präpariert, kannst du seine Fidelity direkt anhand von gesampelten Erwartungswerten seiner Stabilisatoren schätzen. Dieses Tutorial führt zunächst auf einem Simulator mit einem kleinen Circuit durch den Workflow, und führt anschließend denselben Workflow auf Hardware mit einem größeren, tieferen Circuit aus. Sobald ein Circuit mehr Nicht-Clifford-Operationen enthält, sinkt die Anzahl gültiger Checks rasch, sodass die Methode am besten für Clifford-dominierte Circuits funktioniert.
Anforderungen
Bevor du mit diesem Tutorial beginnst, stelle sicher, dass Folgendes installiert ist:
-
Qiskit SDK v2.0 oder höher, mit Unterstützung für Visualisierung
-
Qiskit Runtime v0.40 oder höher (
pip install qiskit-ibm-runtime) -
Qiskit Aer v0.17 oder höher (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
Setup
Importiere die benötigten Bibliotheken und definiere die Hilfsfunktionen, die nicht als Importe verfügbar sind. Die Funktion random_clifford_circuit erstellt eine zufällige Clifford-Payload im Brickwork-Muster, find_check_layout durchsucht die Kopplungskarte (Coupling Map) eines Backends nach einem Qubit-Pfad mit niedriger Fehlerrate und vielen verfügbaren Ancillas, learned_noise_model wandelt die Ausgabe von NoiseLearner in ein qiskit-paulice-Rauschmodell um, append_basis_rotation rotiert einen Circuit so, dass ein Stabilisator in der Rechenbasis gemessen wird, expectation berechnet einen Stabilisator-Erwartungswert aus gesampelten Zählwerten (Counts), und cum_mean_sem verfolgt die laufende Fidelity-Schätzung.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
Kleinskaliges Simulatorbeispiel
Dieser Abschnitt führt durch den vollständigen Workflow auf einem verrauschten Simulator. Er verwendet Backend-Benchmark-Daten, um ein Qubit-Layout und ein Rauschmodell auszuwählen, findet Checks automatisch und nutzt Postselektion auf der gesampelten Verteilung, um die Verbesserung der Fidelity zu zeigen.
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Der Payload-Circuit ist ein flacher, eindimensionaler zufälliger Clifford-Circuit im Brickwork-Muster. Da der Circuit ein Clifford-Circuit ist, präpariert er einen stabilisierenden Zustand, dessen Fidelity du direkt aus gesampelten Stabilisator-Erwartungswerten schätzen kannst. Beginne mit einem flachen Circuit, damit sich die Checks im nächsten Schritt leicht visualisieren lassen.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

Schritt 2: Für die Ausführung auf Quantenhardware optimieren
Das Abbilden des Circuits auf Hardware legt das physische Qubit-Layout, das Rauschmodell, das Kandidaten-Checks bewertet, sowie die Checks selbst fest.
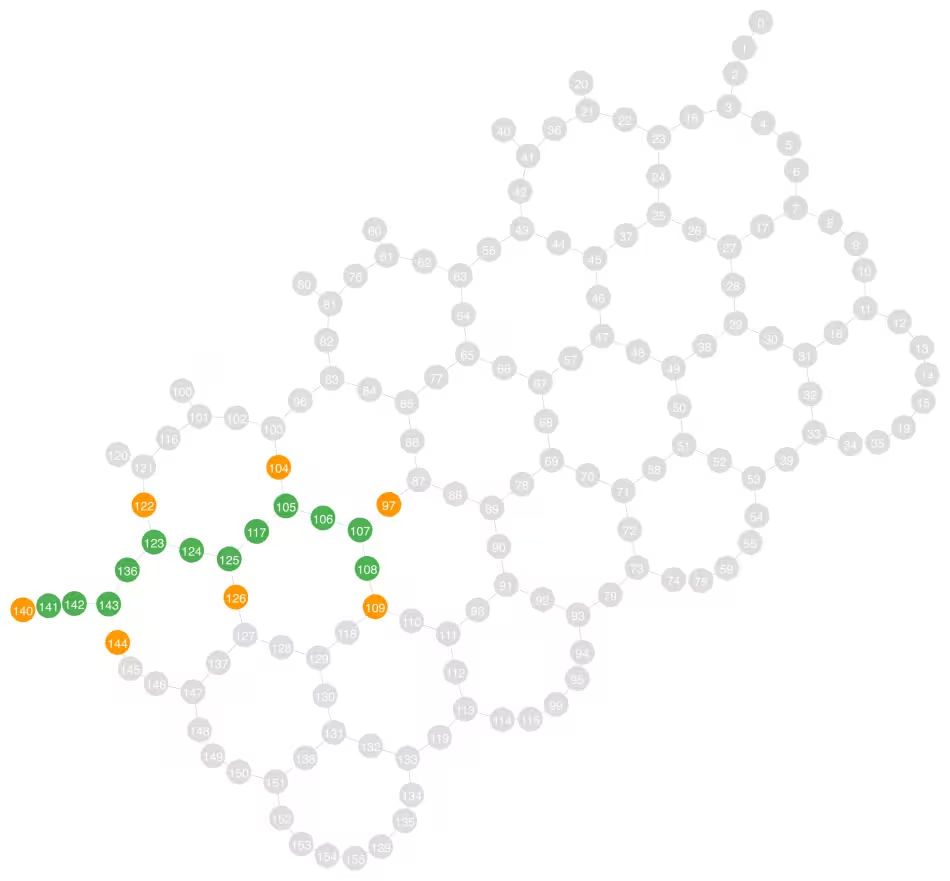
Wähle zunächst ein Backend aus und durchsuche dessen Kopplungskarte (Coupling Map) mithilfe der im Abschnitt Setup definierten Hilfsfunktion find_check_layout nach einem eindimensionalen Qubit-Layout. Die Hilfsfunktion erstellt zufällige selbstvermeidende Pfade (Self-Avoiding Walks), die die Gates und Auslesevorgänge mit der höchsten Fehlerrate meiden, und behält den Pfad, der die meisten Target- und Ancilla-Paare bietet. Da die Suche die Konnektivitäts- und Fehlerdaten direkt vom Backend liest, läuft derselbe Code auf jeder beliebigen IBM-Quantum-QPU. Die Funktion get_check_qubits gibt anschließend die Target- und Ancilla-Paare zurück, wobei ein Check auf target_qubits[i] ancilla_qubits[i] verwendet.
Im folgenden Kopplungsgraphen sind die grünen Qubits Payload-Qubits und die orangen Qubits die Ancillas, die die Checks implementieren. Qubits mit einer benachbarten Ancilla werden als Target-Qubits für Checks verwendet.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
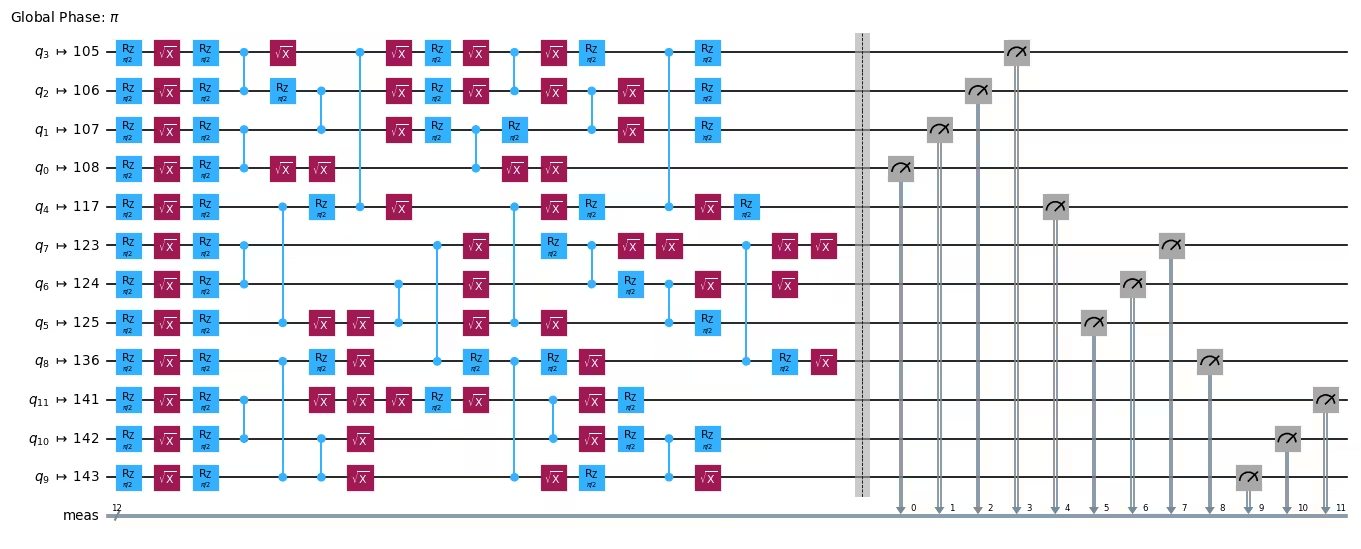
Nachdem Backend und Layout ausgewählt sind, transpiliere die Payload in einen Circuit der Instruction Set Architecture (ISA). Dabei ist es nur nötig, das Layout festzulegen und die Gates in den nativen Gate-Satz des Backends zu übersetzen.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
Modelliere als Nächstes, wie sich das Gate- und Auslese-Rauschen auf dem Backend auf die Ausführung auswirkt. Das Rauschmodell bestimmt, an welcher Stelle im Circuit ein Check die meisten Fehler abfängt. Ein genaueres Modell verbessert die Erkennung, es ist jedoch meist nicht nötig, eines durch Sampling der QPU zu erlernen. Das folgende Modell leitet aus den Benchmark-Daten von qiskit-ibm-runtime einen einheitlichen depolarisierenden Kanal für Gate- und Auslese-Rauschen ab.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
Füge dem Circuit nun Checks hinzu. Die Funktion add_pauli_checks nimmt die Clifford-Payload, die Liste der Target-Qubits und das Rauschmodell entgegen. Das Argument ancilla_qubits teilt der Funktion mit, welche physische Ancilla mit welchem Target gepaart werden soll. Checks werden in der Reihenfolge hinzugefügt, in der die Target-Qubits erscheinen, sodass das endgültige Layout des Circuits mit Checks layout + ancilla_qubits ist. Um einen Ausgabe-Circuit mit weniger (i) Checks auszuführen, lautet das endgültige Layout layout + ancilla_qubits[:i].
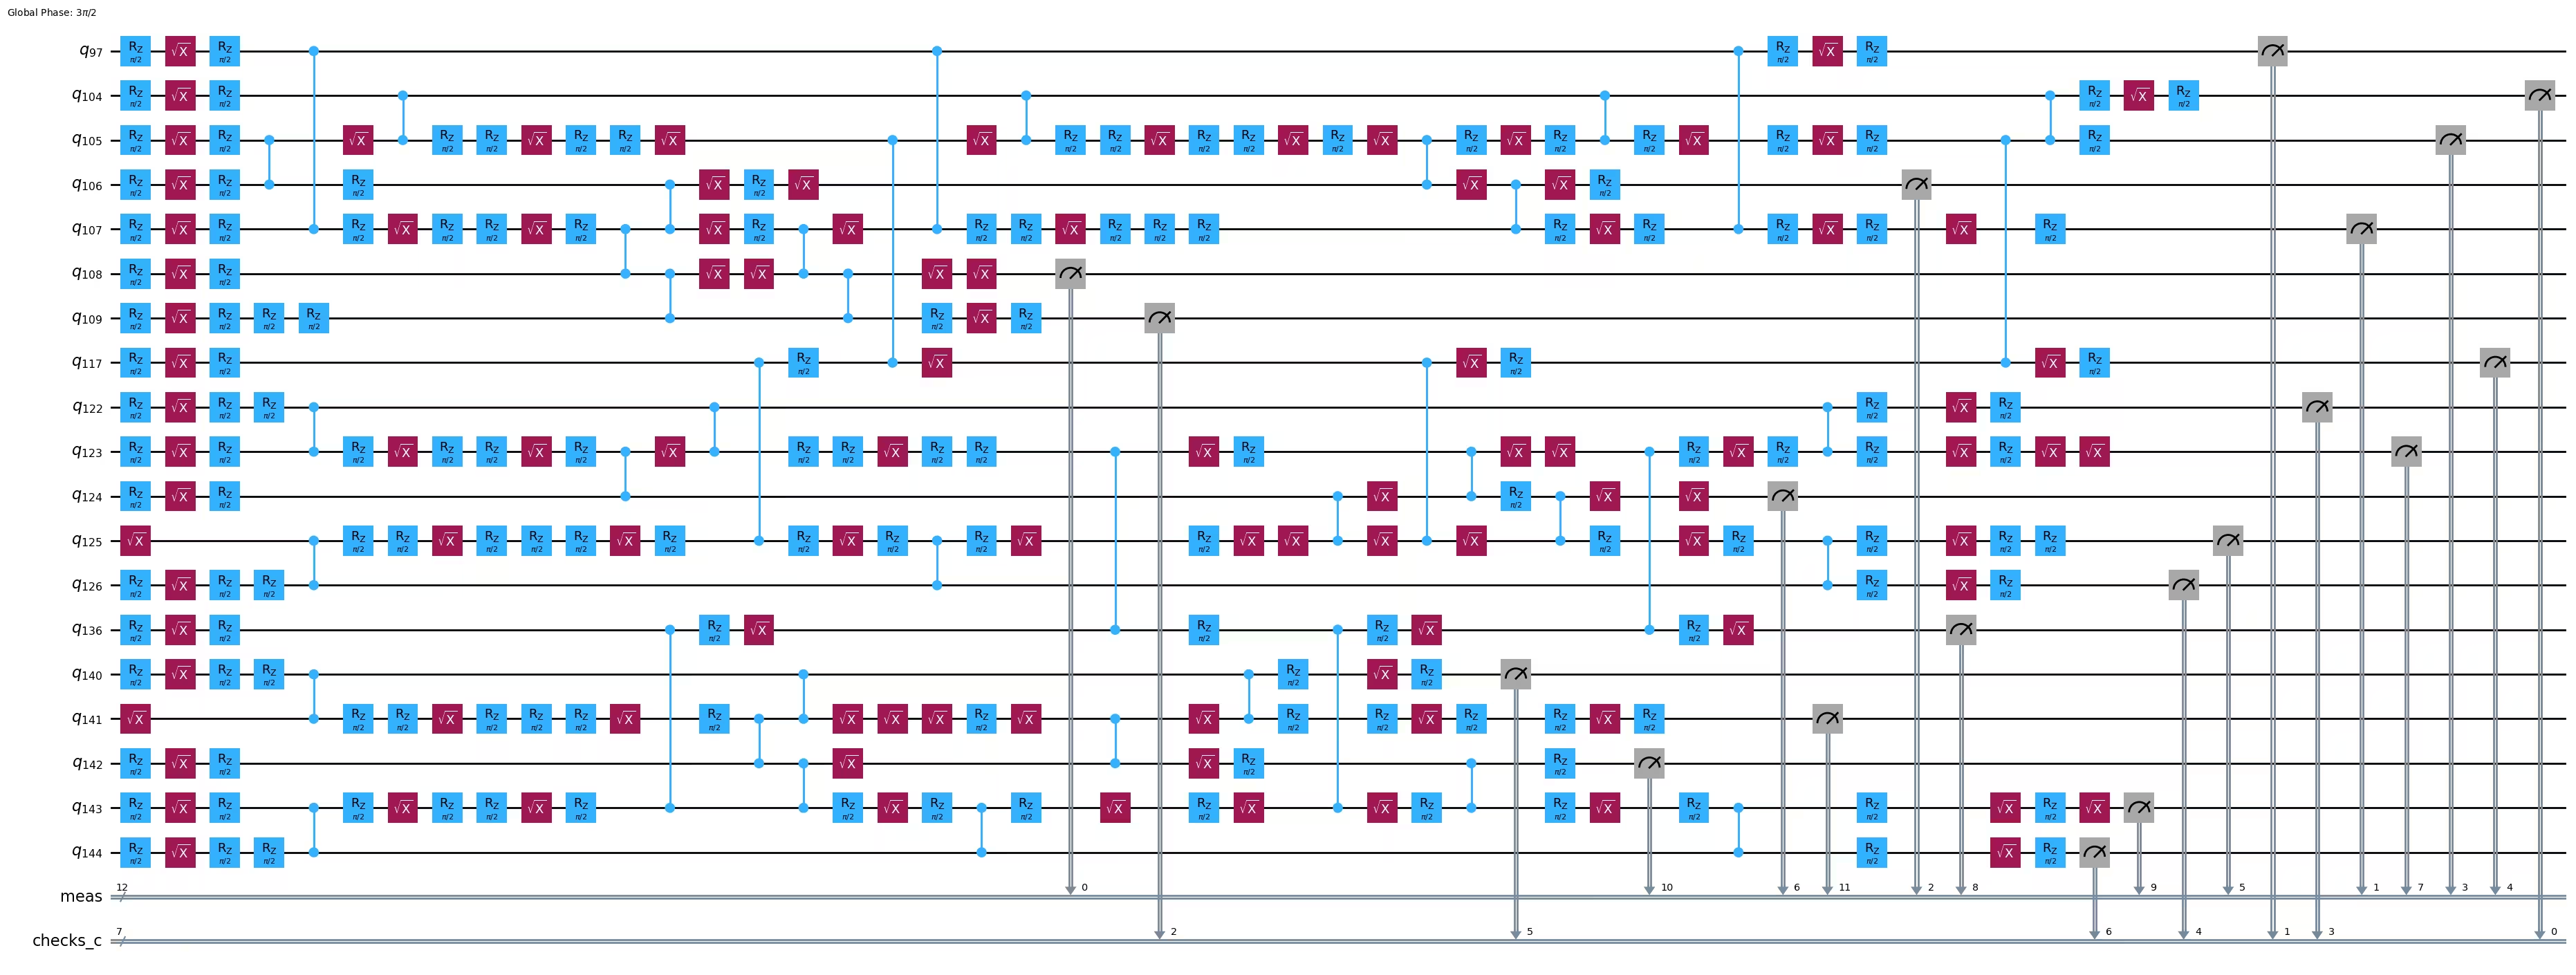
Die Ausgabe von add_pauli_checks ist eine Sequenz von Circuits mit einer steigenden Anzahl von Checks, von keinem Check bis zu einem Check auf jedem Target-Qubit. Die Visualisierung bestätigt, dass die Checks die angegebenen Target- und Ancilla-Paare verwenden. Details zum Finden guter Checks findest du in den Abschnitten II bis IV der ergänzenden Informationen in Referenz [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
Schritt 3: Ausführung mit Qiskit-Primitiven
Um den Effekt von Gate-Rauschen sichtbar zu machen, erhöhe die Tiefe der Payload und sample eine Teilmenge ihrer Stabilisatoren. Im Allgemeinen kommutiert jeder Stabilisator qubitweise nicht mit den anderen, sodass ein einzelner Satz von Checks nicht für zwei unterschiedliche Stabilisatoren gültig ist. Anstatt Stabilisatoren zu kommutierenden Mengen zu gruppieren, finde für jeden Stabilisator unabhängig einen guten Satz von Checks. Das gleichverteilte zufällige Sampling von Stabilisatoren liefert eine erwartungstreue Fidelity-Schätzung.
Erstelle den tieferen Circuit und ziehe eine Zufallsstichprobe seiner Stabilisatoren.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
Rotiere für jeden gesampelten Stabilisator den Circuit so, dass der Stabilisator in der Rechenbasis gemessen wird, transpiliere ihn auf das Backend und finde einen guten Satz von Checks. Die Target- und Ancilla-Paare werden für jeden Stabilisator gemeinsam durchmischt, sodass jedes Target seine Ancilla behält. Beachte, dass Checks in der Reihenfolge, in der die Target-Qubits angegeben werden, sequenziell festgelegt werden und ein bereits festgelegter Check nicht mehr geändert wird, wenn weitere Checks hinzugefügt werden.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
Sample die ungeschützte Payload und die Circuits mit Checks in Qiskit Aer. Der Simulator verwendet dasselbe depolarisierende Modell, mit dem die Checks bewertet wurden, sodass das Rauschen, auf das die Checks abzielen, dem Rauschen entspricht, das der Simulator anwendet.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
Schritt 4: Nachbearbeiten und Ergebnis im gewünschten klassischen Format zurückgeben
Jeder Check verwendet verschränkende Gates zwischen einer Ancilla und einem Target. Die Ancilla startet in , sodass ihre Eingabe stabilisiert. Das Vorwärts-Propagieren von durch den Circuit mit Checks ergibt einen Pauli-Operator auf der Ausgabe, dessen Nicht-Identitäts-Terme den Support (Träger) des Checks definieren. Ein Check besteht, wenn die Bits in seinem Support gerade Parität haben. Eine Stichprobe wird nur behalten, wenn jeder Check besteht.
Die get_postselection_method jedes CheckedCircuit gibt eine Funktion zurück, die einen gemessenen Bitstring auf einen Syndromvektor abbildet. Behalte die Stichproben, deren Syndrom für jeden Check null ist, und verwirf den Rest. Die folgende Grafik zeigt, dass das Hinzufügen weiterer Checks die Postselektionsrate senkt. Eine niedrigere Postselektionsrate benötigt mehr Shots, um eine Zielgenauigkeit zu erreichen, sodass es einen Kompromiss zwischen Erkennungsfähigkeit und Sampling-Kosten gibt. Die Rate scheint zu konvergieren, was darauf hindeutet, dass zusätzliche Checks weniger Erkennungsfähigkeit beitragen.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

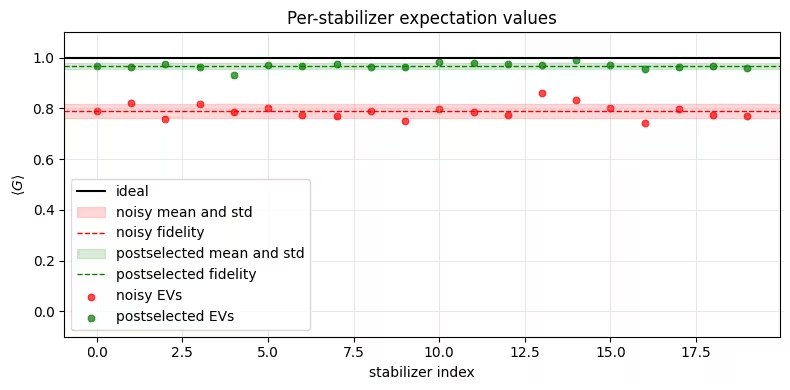
Vergleiche nun die Fidelity des ungeschützten (verrauschten) Zustands mit dem postselektierten Zustand. Das Postselektieren nur der Stichproben ohne erkannten Fehler erhöht den Erwartungswert jedes Stabilisators und damit die geschätzte Fidelity. Die postselektierten Werte verwenden weniger Stichproben als die Rohwerte, dennoch sind die Erwartungswerte genauer und die gesampelte Varianz geringer. Beachte außerdem, dass die mittlere Postselektionsrate nahe an der verrauschten Fidelity liegt. Das ist zu erwarten, wenn die Checks nahezu alle fehlerhaften Stichproben erkennen: Der Anteil der Stichproben, die jeden Check bestehen, nähert sich dem Anteil fehlerfreier Stichproben an, was der Fidelity des verrauschten Zustands entspricht.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

Der Gamma-Score gibt an, wie viel des modellierten Rauschkanals von den Checks unentdeckt bleibt. Das Auftragen des Gamma-Scores gegen die Anzahl der festgelegten Checks zeigt, wie sich die Erkennungsfähigkeit mit jedem hinzugefügten Check verbessert. Ein Wert von 1.0 bedeutet, dass die Checks das gesamte modellierte Rauschen erfassen. Die Kurven fallen gegen 1.0, je mehr Checks festgelegt werden, was zeigt, dass jeder zusätzliche Check einen Teil des verbleibenden unentdeckten Fehlers erfasst.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

Großskaliges Hardwarebeispiel
Derselbe Workflow läuft auf Hardware mit einer größeren, tieferen Payload. Dieser Abschnitt verwendet dasselbe Backend wie das Simulatorbeispiel, erstellt jedoch ein neues 20-Qubit-Layout mit eigenen Target- und Ancilla-Paaren sowie einem eigenen Pass Manager und übermittelt die Circuits dann in einem einzigen Job an die QPU. Bei dieser Größe löst der Großteil der Shots mindestens einen Check aus, sodass die Postselektionsrate niedrig ist und jeder Circuit ein großes Shot-Budget benötigt, damit genügend Stichproben übrig bleiben. Das Beispiel konzentriert sein Budget daher auf wenige gesampelte Stabilisatoren; dies ist weiterhin eine erwartungstreue Fidelity-Schätzung, jedoch gröber als der Durchschnitt über viele Stabilisatoren im Simulatorbeispiel.
Eine Sache ändert sich gegenüber dem Simulatorbeispiel: Anstatt einen einheitlichen depolarisierenden Kanal aus Kalibrierungsdaten abzuleiten, lernt dieser Abschnitt das Rauschmodell mit NoiseLearner und erstellt aus dem Ergebnis mit NoiseModel.from_pauli_lindblad_maps das qiskit-paulice-Modell. Ein erlerntes Pauli-Lindblad-Modell erfasst die räumliche Struktur des Rauschens auf diesem spezifischen Layout, statt anzunehmen, dass jede Kante gleich verrauscht ist, sodass die Platzierung der Checks anhand von Rauschen bewertet wird, das der tatsächlichen QPU ähnlicher ist. Das Lernen des Rauschens erfordert Sampling der QPU und sollte in jedem gesamten QPU-Sampling-Budget berücksichtigt werden.
Die folgenden Parameter legen die Anzahl der Qubits, die Tiefe, die Anzahl der Stabilisatoren und die Anzahl der Shots fest. Skaliere hw_num_shots mit dem Kehrwert der Postselektionsrate: Bei einer Rate von 3 % verbleiben bei 40.000 Shots etwa 1.200 postselektierte Stichproben pro Circuit. Erhöhe hw_num_stabilizers für eine präzisere Fidelity-Schätzung auf Kosten von mehr Circuits pro Job, von denen jeder dasselbe Shot-Budget benötigt.
Schritte 1–4 (zu einem einzigen Codeblock zusammengefasst)
Die folgende Zelle führt dieselben vier Schritte wie das Simulatorbeispiel aus. Sie erstellt die größere Payload und sampelt einige Stabilisatoren (Schritt 1); wählt ein Layout, lernt darauf das Rauschmodell und findet für jeden Stabilisator den vollständig mit Checks versehenen Circuit (Schritt 2); übermittelt einen Sampler-Job, der sowohl die ungeschützten als auch die Circuits mit Checks enthält (Schritt 3); und postselektiert die Zählwerte (Counts) mit Checks, um die verrauschten und postselektierten Fidelity-Schätzungen pro Stabilisator und im Durchschnitt zu vergleichen (Schritt 4). Bei dieser Größe ist es, anders als im Simulatorbeispiel, nicht praktikabel, die vollständige Stabilisatorgruppe aufzuzählen, daher sampelt die Zelle eine zufällige Teilmenge von Stabilisatoren, um eine Schätzung der Fidelity zu berechnen.
Beachte, dass Schritt 2 hier mehr leistet als im Simulatorbeispiel: Das Lernen des Rauschmodells übermittelt vor dem Sampler-Job einen eigenen NoiseLearner-Job, sodass die Zelle insgesamt zwei Jobs ausführt. Sie tragen die Tags TUT_ASPC_LEARN und TUT_ASPC, damit du sie später wiederfinden kannst. Weitere Informationen zum Taggen von Jobs findest du unter Nach Job-Tags organisieren und suchen.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

Bei Circuits dieser Größe enthalten die meisten Stichproben mindestens einen erkannten Fehler, sodass die Postselektionsrate klein ist und die Postselektion die meisten Shots verwirft. Die Stichproben, die jeden Check bestehen, liefern einen deutlich besseren Erwartungswert als der ungeschützte Circuit, und die Werte pro Stabilisator heben sich klar von der verrauschten Basislinie ab. Um die Fidelity-Schätzung zu verfeinern, sample mehr Stabilisatoren mit demselben Shot-Budget pro Circuit. Um die Postselektionsrate zu erhöhen, verringere die Circuit-Tiefe oder lege weniger Checks fest; um zu größeren Payloads vorzudringen, skaliere das Shot-Budget mit dem Kehrwert der Postselektionsrate.
Nächste Schritte
Wenn du diese Arbeit interessant fandest, könnte dich das folgende Material interessieren:
-
Das Tutorial zu Wiederholungscodes für eine Einführung in die Quantenfehlerkorrektur.
-
Die
qiskit-paulice-Dokumentation für die vollständige API zum Finden von Checks, sowie das GitHub-Repository des Pakets für den Quellcode. -
Das Paper Low-overhead error detection with spacetime codes für die Theorie hinter den Checks.
Referenzen
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.