Rauschen und Fehler
Diese Lektion führt in Quantenrauschen und -fehler ein, einschließlich vieler ihrer Ursachen, und zieht Analogien zu klassischen Fehlern. Das Verständnis der Fehlertypen, die auftreten können, sowie die Fähigkeit, Rauschen mithilfe von Quantenkanälen zu modellieren, sind entscheidend für das Verständnis künftiger Lektionen. Tatsächlich erfordern die meisten Methoden der Fehlerbehandlung, dass wir etwas über die Art des Rauschens oder der Fehler wissen, die wir verringern oder korrigieren möchten.
Dieses Video gibt einen Überblick über Rauschen und Fehler und hebt einige Berechnungsergebnisse hervor. Der nachfolgende Text bietet mehr Details und untersucht einige Fehlertypen mithilfe von Qiskit.
Ursachen
Klassisches Rauschen und Fehler
Um Quantenfehler und -rauschen zu verstehen, beginnen wir mit dem klassischen Analogon. In klassischen Computern treten Fehler aus verschiedenen Gründen auf, darunter mehrere Mechanismen für unerwünschte Ladungsansammlung, Single-Event-Upsets und langsame Materialalterung. Einige dieser Mechanismen (nicht alle) haben Analogien im Quantencomputing und werden hilfreich sein, um Quantenfehler und -rauschen zu verstehen. Wir betrachten kurz einige davon und gehen dann zu den quantenmechanischen Analogien über.
Thermisches Rauschen:
Wenn sich die Komponenten eines Computers erwärmen, verändert die thermische Bewegung der Atome und Ladungsträger den spezifischen Widerstand des Materials (in der Regel erhöht sie ihn). Das bedeutet, dass der Widerstand in der Schaltung variieren kann. Obwohl selten, kann dies zu einem unerwünschten logischen Übergang in einem Transistor führen. Auch wenn geringfügige Schwankungen unvermeidlich sind, ist eine angemessene Kühlung der Komponenten entscheidend, um diese Effekte zu vermeiden.
Thermische Schäden und Alterung:
Wiederholtes Erhitzen und Abkühlen von Materialien kann eine sehr langsame Migration leitfähiger Elemente (Metalle) verursachen. Im besten Fall verändert dies den Widerstand oder die Kapazität (oder beides) von Schaltungselementen und führt zu ungenauem Timing beim Betrieb der Schaltung. Im schlimmsten Fall führt es zu einem Kurzschluss oder einem dauerhaften Fehler. Auch hier ist eine angemessene Temperaturkontrolle entscheidend, um diese Art der Alterung zu verhindern.
Strahlungsinduzierte Effekte (Single-Event Upsets, SEUs):
Manchmal können hochenergetische Teilchen Atome im Inneren eines Prozessors ionisieren und zu einer unerwünschten Ladung führen. Geschieht dies am falschen Ort und zur falschen Zeit, kann dies zu logischen Fehlern führen. Die Quelle dieser hochenergetischen Teilchen (einschließlich elektromagnetischer Strahlung und Neutronen) sind typischerweise hochenergetische Wechselwirkungen in der oberen Atmosphäre. Diese Störungen treten daher häufiger in Umgebungen in großer Höhe auf, einschließlich des Weltraums. Dem wird mit fehlerkorrigierenden Codes und strahlungsresistentem Design begegnet.
Elektromagnetische Störungen:
Fehler können auch durch externe elektromagnetische (EM) Felder verursacht werden, die von schaltenden Stromleitungen, Funksendern oder anderen Systemkomponenten ausgehen. Dies unterscheidet sich von der hochenergetischen Strahlung des vorherigen Phänomens. Hier induzieren zeitabhängige Streufelder Strom und Spannung in Computerkomponenten (im Gegensatz zur Ionisierung eines bestimmten Atoms in einem einzelnen Ereignis). Da die Zeitabhängigkeit der Felder ein entscheidender Faktor für die induzierten Spannungen ist, ist diese Art der Störung besonders bei Hochfrequenzsystemen von Bedeutung. Diesen Fehlern kann unter anderem durch Abschirmung und Erdung entgegengewirkt werden.
Übersprechen zwischen Verbindungsleitungen:
Kapazitive oder induktive Kopplung zwischen benachbarten Leitern, insbesondere in integrierten Schaltungen im Nanomaßstab, kann zu unerwünschten Signalen führen. Dies hängt mit elektromagnetischen Störungen zusammen, unterscheidet sich jedoch dadurch, dass die Quelle des störenden Feldes eine andere Komponente innerhalb der Computerschaltung ist. Stell dir zwei sehr nahe beieinanderliegende Drähte vor. Wenn Draht A einen plötzlichen Übergang (Spannungsänderung) erfährt, kann dies Ströme im benachbarten Draht B induzieren. Die genaue Richtung und Stärke hängen vom Layout der Schaltung ab; es könnte sich um einen kohärenten Nettoladungsfluss oder um etwas handeln, das eher Wirbelströmen der Ladung ähnelt. In manchen Fällen kann dies jedoch zu unerwünschten logischen Übergängen führen. Diese Übersprecheffekte können durch optimalen Layout-Abstand, Abschirmung und kontrollierte Signalanstiegszeiten gemindert werden.
Dies ist keine vollständige Liste, reicht aber aus, damit wir beginnen können, Parallelen zum Quantencomputing zu erkennen. Beachte, dass bei allen oben genannten Arten unerwünschter Wechselwirkungen die Manifestation des Rauschens als logischer Fehler nur die Form annehmen kann, dass aus einer 0 eine 1 wird oder aus einer 1 eine 0. Dies ist alles, was im Zustandsraum klassischer Bits erlaubt ist.
Quantenrauschen und -fehler
Im Quantencomputing werden Rauschen und Fehler oft im gleichen Atemzug diskutiert, aber es ist wichtig, den Unterschied zu erkennen. Quantenrauschen bezeichnet die zugrunde liegende physikalische Störung, die Qubits und Quantensysteme beeinträchtigt. Es umfasst alle Formen unerwünschter Wechselwirkungen oder Fluktuationen aus der Umgebung, unvollkommener Steuerungen oder Hardwaredefekte, die dazu führen, dass der Quantenzustand vom Ideal abweicht. Quantenfehler sind die spezifischen Abweichungen oder Mängel in der Quanteninformation, die aus dem Quantenrauschen resultieren. Quantenfehler sind die messbaren oder operativen Manifestationen des Rauschens, und zu den Fehlern zählen Bit-Flips, Phasen-Flips, Amplitudendämpfung und mehr. Sowohl Rauschen als auch Fehler können kontinuierlich auftreten. Zum Beispiel könnte das in einem Quanten-Gate verwendete Feld um 0,1 %, 0,15 % oder einen beliebigen anderen Bruchteil abweichen. Dies könnte zu einer falschen Phase auf einem Qubit führen, ebenfalls um einen beliebigen kontinuierlichen Betrag. Du wirst jedoch sehen, dass es in der Praxis, insbesondere bei der Fehlerkorrektur, üblich ist, Fehler so zu behandeln, als wären sie diskret: Die akkumulierten Effekte werden zu einem diskreten Bit-Flip oder einer einzelnen Phasenrotation zusammengefasst. Dies ist nützlich, um Fehler zu korrigieren und zu charakterisieren, bedeutet aber nicht, dass sich die Auswirkung von Rauschen auf ein Qubit ausschließlich auf eine diskrete Menge von Fehlern beschränkt.
Es gibt viele Arten von Rauschen, die Quantencomputer beeinträchtigen. Manche können zu mehreren Fehlertypen führen, während andere mit spezifischen Fehlermanifestationen einhergehen. Eine vollständige Liste würde den Rahmen dieser Lektion sprengen; hier ist eine teilweise Liste, die für den Rest dieses Kurses relevant ist, manche davon mit Parallelen zum Rauschen im klassischen Computing.
Thermal:
Die beiden Rechenbasiszustände und eines Qubits sind durch einen sehr geringen Energiebetrag getrennt. Der genaue Wert hängt natürlich von der Quantenhardware ab. Für Festkörper-Qubits (Fixed-Frequency-Transmons), wie sie von IBM Quantum® verwendet werden, liegt die Energielücke zwischen diesen Zuständen in der Größenordnung von J, also einigen Mikroelektronenvolt. Diese Energieskala lässt sich über mit der Frequenz oder mit einer charakteristischen Temperatur in Beziehung setzen. Da die Temperatur mit der mittleren kinetischen Energie der Teilchen in einer Probe zusammenhängt, können wir mithilfe der Boltzmann-Konstante eine Schätzung der Temperatur vornehmen, bei der durchschnittliche Teilchen genug Energie hätten, um einen Übergang zu verursachen:
Um die Wahrscheinlichkeit zu verringern, dass thermische Wechselwirkungen Übergänge von einem Rechenbasiszustand eines Qubits zu einem anderen verursachen, muss die Temperatur der Qubits deutlich unter 100 mK gehalten werden, idealerweise näher an 15-25 mK. Jeder signifikante Anstieg der Temperatur über diese Schwellenwerte hinaus würde zu einer völlig zufälligen Zustandsbesetzung und einem vollständigen Verlust der Quanteninformation führen.
Dies ist analog zu den thermischen Fehlern, die in klassischen Computern auftreten können, da beide thermischen Ursprungs sind — aber die Temperaturskala ist offensichtlich anders, ebenso wie der Mechanismus des Informationsverlusts.
Übersprechen und Störungen:
Übersprechen im Quantencomputing bezeichnet jede unerwünschte Kopplung oder Störung zwischen Qubits oder Steuerleitungen, sodass eine für ein Qubit vorgesehene Operation oder ein Signal ungewollt andere beeinflusst. Es äußert sich als Fehler oder Korrelationen zwischen Qubits, die idealerweise unabhängig sein sollten.
In supraleitenden Qubit-Architekturen, wie sie von IBM® verwendet werden, kann Übersprechen durch Mikrowellen-Steuersignale entstehen, die in benachbarte Qubits einstreuen, durch unbeabsichtigte Kopplung zwischen Ausleseresonatoren oder durch Fluss-Übersprechen zwischen Qubit-Schleifen.
Viele der Ansätze zur Minimierung von Übersprechen sind bereits im Design eines Quantencomputers verankert, etwa der Abstand zwischen Qubits und die Sicherstellung, dass benachbarte Qubits unterschiedliche Betriebsfrequenzen haben. Es gibt auch Software-Ansätze zur Minderung von Übersprechfehlern, die in späteren Lektionen besprochen werden.
Unvollkommene Gate-Operationen:
Operationen an Qubits werden mit Hardware ausgeführt, die eine endliche Präzision besitzt und Rauschen oder anderen Quellen von Ungenauigkeit unterliegen kann. Insbesondere werden Mikrowellenpulse bestimmter Dauer und mit bestimmter Ausrichtung verwendet, um Rotations-Gates zu implementieren. Nehmen wir zum Beispiel an, ein Mikrowellenpuls soll um 0,30 Radiant um die -Achse rotieren. Die Ausrichtung besitzt eine endliche Präzision, was zu einer gewissen Ungenauigkeit in der Rotationsachse führt. Außerdem gibt es immer einen grundlegenden Kompromiss zwischen der Pulsfrequenz und ihrer Dauer. Ein sehr langer Puls kann im Wesentlichen ein sinusförmiges Verhalten mit praktisch einer einzigen Frequenz aufweisen. Um ein kurzes Paket zu bilden, benötigt man eine Überlagerung vieler Frequenzen. Dies ist derselbe Kompromiss, der der Energie-Zeit-Unschärferelation zugrunde liegt, obwohl die Gate-Präzision diese fundamentalen Grenzen noch nicht erreicht; es gibt noch Raum für Verbesserungen.
Quanteninhärentes Rauschen:
Diese letzte Art von Rauschen unterscheidet sich deutlich von den anderen; sie beruht nicht auf Fehlern, sondern auf der Natur der Quantenmechanik. Angenommen, ein Qubit im Quantenzustand wird gemessen und kollabiert in einen Eigenzustand ( oder ). In einem Fixed-Frequency-Transmon-System ist das Qubit dispersiv an einen Mikrowellenresonator gekoppelt, dessen Resonanzfrequenz leicht vom Zustand des Qubits abhängt. Ein Mikrowellen-Abfragepuls wird durch den Resonator gesendet, und das ausgehende Signal erhält eine zustandsabhängige Phasenverschiebung und Amplitudenänderung. Dieses Signal wird anschließend mit klassischer Elektronik verstärkt und gemessen.
Auf Quantenebene wird das Messsignal von einem kohärenten Mikrowellenfeld mit einer endlichen durchschnittlichen Photonenzahl getragen. Aufgrund der Quantennatur elektromagnetischer Felder weisen die Feldquadraturen intrinsische Fluktuationen auf. Diese Fluktuationen sind unabhängig von technischen Unvollkommenheiten und treten selbst bei einem idealen kohärenten Zustand auf. Eine Erhöhung der durchschnittlichen Photonenzahl erhöht das Messsignal, aber das grundlegende Rauschniveau bleibt endlich, sodass sich die Unterscheidbarkeit zwischen den Ergebnissen nur wie verbessert.
Selbst wenn das Qubit perfekt präpariert ist und die Messkette ideal ist, ist das Auslesesignal für einen gegebenen Qubit-Zustand daher kein einzelner fester Wert, sondern eine Verteilung, die begrenzt, wie gut sich die Ergebnisse unterscheiden lassen. Diese Überlappung stellt eine fundamentale Quelle der Unsicherheit im Messprozess selbst dar. In der Praxis dominiert zwar häufig technisches Rauschen von Verstärkern und anderen Komponenten, aber dieses intrinsische Quantenrauschen setzt eine untere Grenze für die Fidelity des Auslesens.
Unsicherheit ist kein Fehler:
Diese Rauschquellen unterscheiden sich alle von der fundamentalen Unsicherheit, die mit Messungen von Quantenzuständen verbunden ist. Nehmen wir zum Vergleich an, wir haben ein Qubit in einem Quantenzustand:
Dieser Zustand hat eine Wahrscheinlichkeit von 64 %, im Zustand gemessen zu werden, und eine Wahrscheinlichkeit von 36 %, im Zustand gemessen zu werden. Eine einzelne Messung liefert jedoch nur oder — eine einzelne Messung wird uns also selten viel über den Zustand vor der Messung verraten. Um detaillierte Informationen über den Zustand zu erhalten, sind viele Messungen erforderlich. Bei zehn Messungen könnten wir erwarten, dass sechs oder sieben ergeben. Es wäre aber nicht schockierend, wenn die ersten zehn Messungen zufällig alle ergäben (ähnlich wie beim Werfen einer fairen Münze zehnmal hintereinander „Kopf“ zu erhalten: unüblich, aber durchaus plausibel). Würden wir die Messung 1000 Mal wiederholen und immer erhalten, wäre das tatsächlich schockierend.
Es besteht daher eine Unsicherheit in unserem Wissen über den Quantenzustand, die auf jeder endlichen Anzahl von Messungen beruht. Während wir die Messungen wiederholen, verbessert sich unser Wissen über den Quantenzustand vor der Messung, ist aber nie perfekt. Man könnte umgangssprachlich sagen, dass jedem Ergebnis einer Quantenmessung immer ein zugrunde liegender „Fehler“ innewohnt. Dies ist jedoch eine andere Verwendung des Begriffs „Fehler“ und wird besser als statistische Unsicherheit beschrieben. Der Prozess, das Wissen über einen Quantenzustand durch viele Messungen zu erweitern, wird Quantenzustandstomographie genannt. Die Quantenzustandstomographie beschränkt sich jedoch nicht auf Messungen entlang Z; sie bezieht sich im Allgemeinen auf Messungen entlang orthogonaler Achsen (wie X, Y und Z) zur Bestimmung von Amplituden und relativer Phase. Mehr zu diesem Prozess findest du in diesem Abschnitt in John Watrous' Kurs General Formulation of Quantum Information, oder für eine praktische Umsetzung siehe diese Lektion zur Teleportation des Kurses Utility-Scale Quantum Computing.
Fehler und ihre Akkumulation beobachten
In diesem Abschnitt verwenden wir echte Quantencomputer, um Quantenfehler und ihre Akkumulation unter verschiedenen Bedingungen zu beobachten. In der Praxis sind typischerweise viele Quellen von Quantenfehlern gleichzeitig vorhanden. Um verschiedene Fehlertypen einigermaßen isoliert zu beobachten, benötigen wir Circuits, die für diese Isolation konzipiert sind. Circuits, die in Anwendungen des Quantencomputings verwendet werden, sehen wesentlich komplizierter aus.
Beginnen wir mit Energierelaxationsfehlern.
Energierelaxationsfehler ()
Erinnere dich an unsere Diskussion über thermisches Rauschen: Bei jeder Temperatur ungleich null besteht eine gewisse Wahrscheinlichkeit, dass ein Quantensystem einen Übergang zwischen Energieeigenzuständen durchläuft. Die Relaxation () dominiert, da sie durch spontane Emission angetrieben wird (unabhängig von der Temperatur), während niedrige Temperatur den konkurrierenden Anregungsprozess unterdrückt. Je länger ein Qubit untätig verharrt, desto mehr Zeit hat es, einen solchen Übergang zu durchlaufen. Die Wahrscheinlichkeit, dass ein im Zustand präpariertes Qubit nach einer Zeit im Zustand verbleibt, ist gegeben durch
Hierbei handelt es sich bei der Zeit um eine experimentell bestimmte charakteristische Zeit, die für jedes Qubit unterschiedlich ist und sich sogar mit der Zeit leicht ändern kann. IBM®-Quantencomputer werden regelmäßig benchmarkt, sodass die -Zeiten, die du für Qubits auf IBM-Quantencomputern aufgelistet findest, genau und aktuell sein sollten. Ein großer Wert von bedeutet, dass das Qubit (im Durchschnitt) länger im präparierten Zustand verbleibt. Typische -Werte unterscheiden sich je nach Architektur; die Qubits in IBM-Quantencomputern haben oft -Zeiten in der Größenordnung von 200-300 , und du kannst die aktuellsten Werte auf der Seite Compute resources einsehen.
Die charakteristische Zeit misst etwas anderes: den Verlust von Phaseninformation. Wir kommen später darauf zurück.
Um Energierelaxationsfehler zu beobachten, präparieren wir Qubits im Zustand und lassen sie dann absichtlich für lange Zeiträume untätig. Das ist der künstliche Teil. In echten Quanten-Workflows kann es vorkommen, dass einige Qubits für längere Zeiträume untätig bleiben, während auf anderen Qubits Prozesse ausgeführt werden; daher sind einige Instanzen solcher Leerlaufzeiten nicht künstlich.
Beginnen wir damit, einige Pakete zu importieren und das am wenigsten ausgelastete Backend auszuwählen.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
Nun wählen wir ein Qubit aus, mit dem wir arbeiten, in diesem Fall Qubit null. Wir können die Eigenschaften dieses Qubits, einschließlich und , direkt importieren.
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
Es ist wichtig, in Einheiten von Mikrosekunden zu kennen, aber du hast vielleicht kein intuitives Gefühl dafür, was das bedeutet. Schließlich sind Gate-Operationen auf Quantencomputern sehr schnell. Die eigentliche Frage lautet: Wie viel können wir in dieser Zeit auf einem Quantencomputer erreichen? Zu diesem Zweck ist es hilfreich, mit anderen im Quantencomputing verwendeten Zeitskalen in Beziehung zu setzen — insbesondere mit den folgenden:
-
Sampling-Zeit - der kleinste Taktschritt, über den Steuerungsprozesse auf dem Quantencomputer implementiert werden können.
-
Single-Qubit-Gate-Zeiten - die Zeit, die benötigt wird, um eine Gate-Operation an einem einzelnen Qubit auszuführen. Dies ist kein einzelner Wert, sondern ein Bereich möglicher Werte, abhängig vom Gate-Typ.
-
Two-Qubit-Gate-Zeiten - die Zeit, die benötigt wird, um eine Gate-Operation an zwei benachbarten Qubits auszuführen. Auch dies kann einen Wertebereich annehmen, ist aber typischerweise etwa eine Größenordnung länger als bei einem Single-Qubit-Gate.
Überprüfen wir für unser Backend und zeigen wir einige plausible Bereiche für Gate-Zeiten an.
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
Diese Gate-Zeiten variieren von Backend zu Backend. Wir werden eine Two-Qubit-Gate-Zeit von 68 ns, entnommen von ibm_boston, fest codieren.
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
Denk daran, dass hier keine anderen Fehlerquellen oder deren Unterdrückung oder Minderung berücksichtigt wurden. -Fehler sind nicht die einzigen Fehler, die in einem Quantensystem wirken, also mach dir wegen dieser Zahlen nicht zu viele Sorgen. Das bedeutet lediglich, dass wir ohne jegliche Unterdrückung plausibel in der Größenordnung von Tausenden von Two-Qubit-Gates implementieren könnten, bevor -Fehler zu dominieren beginnen. Andere Fehler dominieren typischerweise bei viel geringeren Tiefen, und umgekehrt könnte es sich lohnen, -Fehler auch bei viel kürzeren Zeiten zu unterdrücken als jenen, die nötig sind, um das Signal vollständig auszulöschen.
Wir beginnen mit einem Simulator mit einem Rauschmodell und vergleichen die Ergebnisse anschließend mit echter Hardware.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
Definieren wir einen Zeitschritt für unsere Messungen, der der oberen Schätzung für eine Two-Qubit-Gate-Zeit entspricht. Dann bauen wir 50 Circuits in Schritten dieser Zeitschrittgröße auf. Auf diese Weise sehen wir, was auf einer Zeitskala geschieht, die der Implementierung von 80 Two-Qubit-Gates ähnelt. Präzision ist hier nicht entscheidend, daher verwenden wir nur eine Handvoll Shots.
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
Wir bauen ein Rauschmodell für unseren Simulator, das explizit thermische Relaxationsfehler einschließt.
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
Nun bauen wir unsere Circuits und Observablen auf. Diese sind außergewöhnlich einfach. Die Circuits bestehen lediglich darin, das Qubit im Zustand zu präparieren und Delays für zunehmende Zeiträume zu implementieren, unter Verwendung der oben definierten charakteristischen Gate-Zeiten und . Die Observablen sind einfach , da wir wissen wollen, ob das Qubit im Zustand geblieben oder zu zerfallen ist. Obwohl Transpilation für Simulatoren nicht immer notwendig ist, transpilieren wir unsere Circuits hier trotzdem für die spätere Verwendung auf einem echten Backend.
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
Wir führen unseren Job mit einem Simulator aus.
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
Abschließend plotten wir die Ausgaben.
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
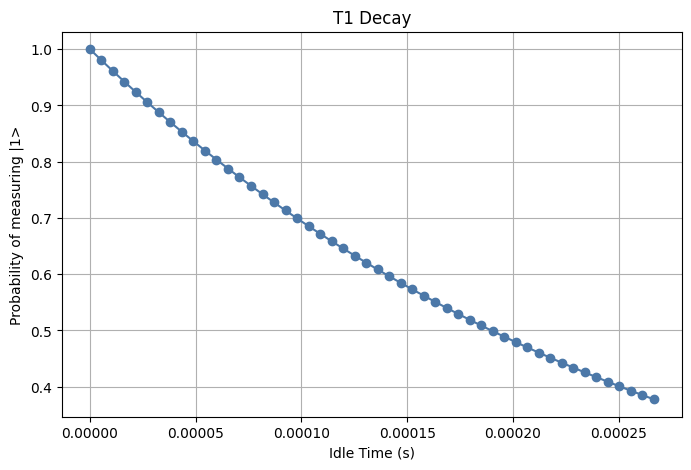
Der exponentielle Zerfall ist deutlich sichtbar, und in dieser Zeit zerfällt er auf knapp unter eine 40%ige Wahrscheinlichkeit, sich im Zustand zu befinden. Beachte, dass dies exakt mit dem Modell übereinstimmt: wobei wir das Maximum von in derselben Größenordnung wie gewählt haben; erinnere dich, dass wir sagten, könnte etwa 60 Gates entsprechen (oder dieser Größenordnung), und hier entspricht 60 Gates. Somit
Lassen wir nun dieselben Circuits auf einem echten Quantencomputer laufen. Um dieselbe Delay-Dauer mit weniger Jobs abzudecken, erhöhen wir die Delay-Einheit und verringern die Anzahl der Punkte.
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
Nun plotten wir die Ergebnisse.
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
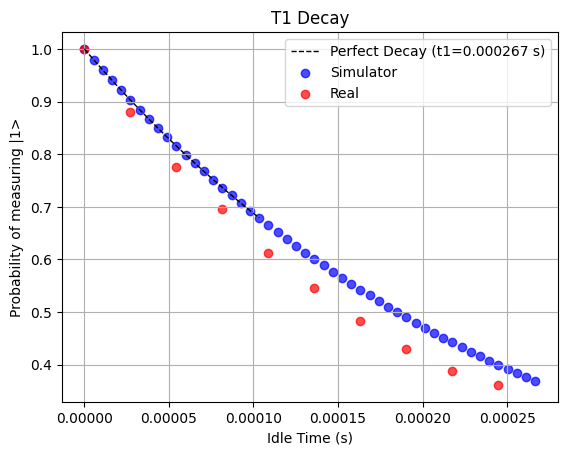
Wie wir sehen können, stimmt der Zerfall des Zustands im Zeitverlauf mit der Theorie (und der Definition von ) überein. Außerdem trifft der Simulator in diesem Fall das Verhalten des echten Quantencomputers recht gut. Hier sind einige Dinge, die du über den Zerfall dieses Zustands im Hinterkopf behalten solltest:
- Wir haben die Messung künstlich um eine unrealistische Zeitspanne verzögert. Diese Verzögerungen entsprechen der Zeitskala extrem tiefer Circuits, die aus Tausenden von Two-Qubit-Gates bestehen könnten. Dies diente nur dazu, zu zeigen, dass die Effekte thermischen Rauschens existieren. In echten Circuits, die auf reale Probleme angewendet werden, würden Operationen an anderen Qubits durchgeführt, während einige wenige lange genug untätig bleiben könnten, damit Energierelaxationsfehler eine Rolle spielen — aber andere Fehler würden dominieren, bevor ein vollständiges erreicht wird.
- Es wurden keine Fehlerminderungs- oder Unterdrückungstechniken angewendet. Wir können diese Zerfallskurve mit Techniken verändern, die wir in diesem Kurs lernen werden.
- Wir haben hier nur 100 Shots verwendet, was ungewöhnlich niedrig ist, da wir nur zeigen wollten, dass der Effekt existiert. In Anwendungen wirst du wahrscheinlich mehr als 1.000 Shots verwenden.
Diese erste Visualisierung von Fehlern erforderte fast keine Gates außer Delays (und das einzelne X-Gate, das zur Präparation von verwendet wurde). Schauen wir uns nun ein weiteres Beispiel an, das sich auf Gate-Fehler konzentriert.
Gate-Fehler und Akkumulation
Wenn wir ein Quantengate anwenden, sagen wir ein -Gate, dreht dieses Gate theoretisch einen Quantenzustand um den Winkel Radiant um die -Achse auf der Bloch-Kugel und bildet auf ab, und zwar über
Ein reales Gate ist jedoch unvollkommen. Es könnte falsch ausgerichtet sein (was Drehungen verursacht, die nicht exakt um die X-Achse erfolgen), oder es könnte eine etwas größere oder kleinere Drehung als beabsichtigt verursachen. Lass uns einen Gate-Fehler als reine Über- oder Unterrotation um einen kleinen Winkel modellieren.
Wenn ein unvollkommenes Gate viele Male angewendet wird, können sich kleine Fehler aufsummieren. Manchmal führen diese mehrfachen Fehler sogar dazu, dass sich der Zustand jedes Mal in dieselbe Richtung verschiebt (ein Phänomen, das als „kohärente Akkumulation“ bezeichnet wird, auf das wir weiter unten zurückkommen werden). Sehen wir uns an, was passiert, wenn wir ein reales X-Gate viele Male auf ein Qubit anwenden.
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
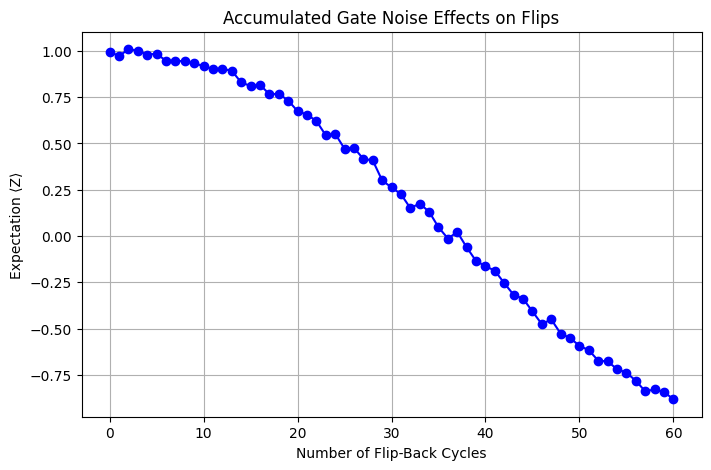
Der Erwartungswert beginnt wie erwartet bei etwa 1,0 und fällt ab, aber er fällt nicht einfach auf null! Er wird negativ. Wäre dies thermisches Rauschen oder zufällige Wechselwirkungen, würde es nicht dazu führen, dass mit höherer Wahrscheinlichkeit gemessen wird als . Dieser Fehler ist eindeutig anders. Und das ergibt im Kontext unserer Diskussion über Über-/Unterdrehung Sinn. Wenn jedes Rotationspaar, das sich eigentlich aufheben sollte, tatsächlich um einen kleinen Winkel dreht, würden viele solcher Wiederholungen den Zustand langsam von in Richtung drehen lassen.
Die hier gezeigte Fehlerakkumulation wird in einem realen Workflow wahrscheinlich nicht so sauber ablaufen. Zum einen haben wir die Fehlerminderung explizit ausgeschaltet und dieselbe sich wiederholende Gate-Sequenz ausgeführt, damit sich Fehler kohärent aufsummieren können. Dies geschieht ausschließlich, um zu zeigen, dass diese Fehler existieren. Wenn wir Techniken zur Rauschbehandlung verwenden (zum Beispiel Pauli-Twirling), können wir beeinflussen, wie sich Fehler aufsummieren, was häufig zu einem geringeren Gesamtfehler führt.
Wir können genau überprüfen, wie gut unser Modell dieses Fehlers zu den experimentellen Daten passt, indem wir explizit ein Rauschmodell erstellen und einen Simulator verwenden. Im folgenden Modell bauen wir explizit einen Fehler ein, der 0,025 Radiant entspricht. Das ist keine magische Zahl; man kann den Fehler einfach so lange anpassen, bis er das Experiment einigermaßen genau beschreibt.
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
Jetzt können wir die realen und simulierten Kurven zusammen darstellen.
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
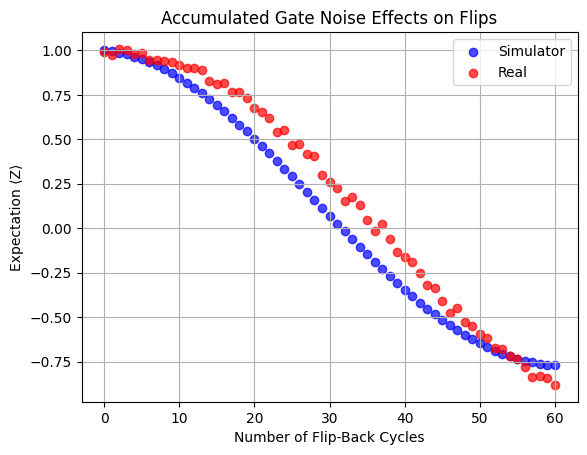
Der Fehler im realen Circuit wurde vom Über-/Unterrotations-Fehlermodell recht gut beschrieben. Unterschiedliche Arten von Rauschen und Fehlern akkumulieren sich eindeutig unterschiedlich und führen zu drastisch unterschiedlichen Auswirkungen auf die Genauigkeit (Fidelity) unserer Quanten-Circuits. Daher wird es sehr wichtig, die auftretenden Fehler formaler zu klassifizieren und zu charakterisieren, als wir es bisher getan haben.
Quantenfehler charakterisieren
Wir haben bereits einige der Quellen von Quantenrauschen beschrieben, und wir könnten Fehler nach den Rauschkategorien klassifizieren, die sie verursachen. Es könnte jedoch verschiedene Kategorien von Quantenfehlern geben, die für die Fehlerkorrektur und -minderung nützlich sind. Zum Beispiel müssen wir wissen, an welchem Punkt Fehler auftreten und wie sich Fehler akkumulieren, wenn wir sie korrigieren oder mindern wollen. Bei der Festlegung, wo (in welchen Prozessen) Fehler auftreten, ist eine wichtige gängige Kategorie die Zustandspräparations- und Messfehler (kurz: SPAM-Fehler). Hier bedeutet der Begriff „Zustandspräparation“ nicht alles, was mit einem Zustand getan wird, um ihn für die Messung vorzubereiten. Vielmehr bezieht er sich auf die Initialisierung der Qubits, die „Präparation“ der Qubits für die Ausführung eines Algorithmus, und daher schließt diese SPAM-Kategorie Dinge wie Gate-Fehler während der Algorithmusausführung aus.
Eine weitere wichtige Unterscheidung ist, ob die Fehler kohärent oder inkohärent sind. Kurz zusammengefasst (wir besprechen sie weiter unten ausführlicher): Kohärente Fehler werden typischerweise durch unitäre Operationen modelliert und erhalten die Reinheit des Zustands. Inkohärente Fehler werden durch nicht-unitäre Quantenkanäle modelliert und verringern im Allgemeinen die Reinheit des Zustands. Es ist einfach, sich inkohärente Fehler als thermische Wechselwirkungen vorzustellen, die zum Verlust von Quanteninformation führen, aber tatsächlich könnten sie durch jede beliebige zufällige Kopplung an die Umgebung verursacht werden. Als Beispiel für einen kohärenten Fehler nehmen wir an, es gäbe eine Unvollkommenheit in der Pulsausrichtung bei der Implementierung eines RY-Gates, sodass ein -Gate tatsächlich bewirkt. Eine solche Unvollkommenheit würde stets eine fehlerhafte Drehung um X in dieselbe Richtung verursachen. Dies wäre ein kohärenter Fehler.
Beachte, dass SPAM-Fehler eine Mischung aus kohärenten Fehlern, wie systematischen Steuerungsfehlern, und inkohärenten Fehlern, wie Photonenverlust und thermischen Effekten, umfassen. Da dies mehrere Schritte und Fehlerquellen betrifft, werden SPAM-Fehler am besten als eine Kombination aus sowohl kohärenten als auch inkohärenten Fehlern beschrieben.
SPAM-Fehler
Wie der Name schon sagt, entstehen SPAM-Fehler in zwei unterschiedlichen Phasen eines Quantenexperiments: bei der anfänglichen Präparation und beim Auslesen/der Messung. Zustandspräparationsfehler treten auf, wenn die Hardware die Qubits nicht zuverlässig in den gewünschten Startzustand ( bei IBM-Quantencomputern) initialisieren kann. Zu den Ursachen gehören:
- thermische Anregung (reale Qubits werden nicht perfekt gekühlt und können gelegentlich in statt in starten)
- Restphotonen oder Rauschen in Resonatoren bei supraleitenden Qubits
- Kalibrierungsdrift, die beeinflusst, wie genau Qubits zurückgesetzt werden
Messfehler treten während des Ausleseprozesses auf, wenn das Messgerät den Qubit-Zustand falsch erkennt. Zu den Quellen gehören:
-
Rauschen des Ausleseverstärkers, das zu Verwechslungen zwischen und führt
-
Qubit-Relaxation während des Auslesens (zum Beispiel zerfällt ein Qubit in kurz vor oder während der Messung nach )
-
Übersprechen zwischen Ausleseleitungen: Das Auslesen eines Qubits beeinflusst leicht die Messwerte benachbarter Qubits
-
Unvollkommene Diskriminierungsschwellen in den resonatorbasierten Messsystemen von IBM
SPAM-Fehler sind hauptsächlich inkohärent. Präparationsfehler wirken wie zufällige Mischungen aus angeregten Zuständen und Grundzuständen. Messfehler verhalten sich wie klassische Verwechslung: Mit Wahrscheinlichkeit wird als gemeldet oder umgekehrt. Dies unterscheidet sich von kohärenten unitären Fehlern (wie fehlkalibrierten Gates, die systematische Phasenverschiebungen verursachen). SPAM-Fehler ähneln stattdessen zufälligem klassischem Rauschen, obwohl seltene kohärente Verzerrungen beim Auslesen auftreten können.
SPAM-Fehler können beim randomisierten Benchmarking oder bei Circuits mit geringer Tiefe problematisch sein, bei denen die Zustandspräparation und Messung einen großen Anteil des Gesamtfehlers ausmachen. Bei sehr tiefen Circuits, insbesondere solchen mit vielen Zwei-Qubit-Gates, sind sie weniger problematisch.
Mathematisch lassen sich SPAM-Fehler so beschreiben, dass sie eine verrauschte Verteilung erzeugen, die über eine Matrix mit der idealen Verteilung in Beziehung steht:
Hier ist die Wahrscheinlichkeit, den Bitstring zu messen, und ist die Wahrscheinlichkeit, den Zustand zu erhalten, obwohl der Zustand eigentlich in Zustand präpariert worden sein sollte. Stell dir den Kontext von aus dem Sampler entnommenen Bitstrings vor. Deine gemessene Zustandsverteilung wird aus vielen genauen Messungen bestehen, aber auch aus einigen Messungen, bei denen die Anweisungen zur Zustandspräparation nicht mit dem beobachteten Zustand übereinstimmen. Das bedeutet, dass die Wahrscheinlichkeiten leicht abweichen werden.
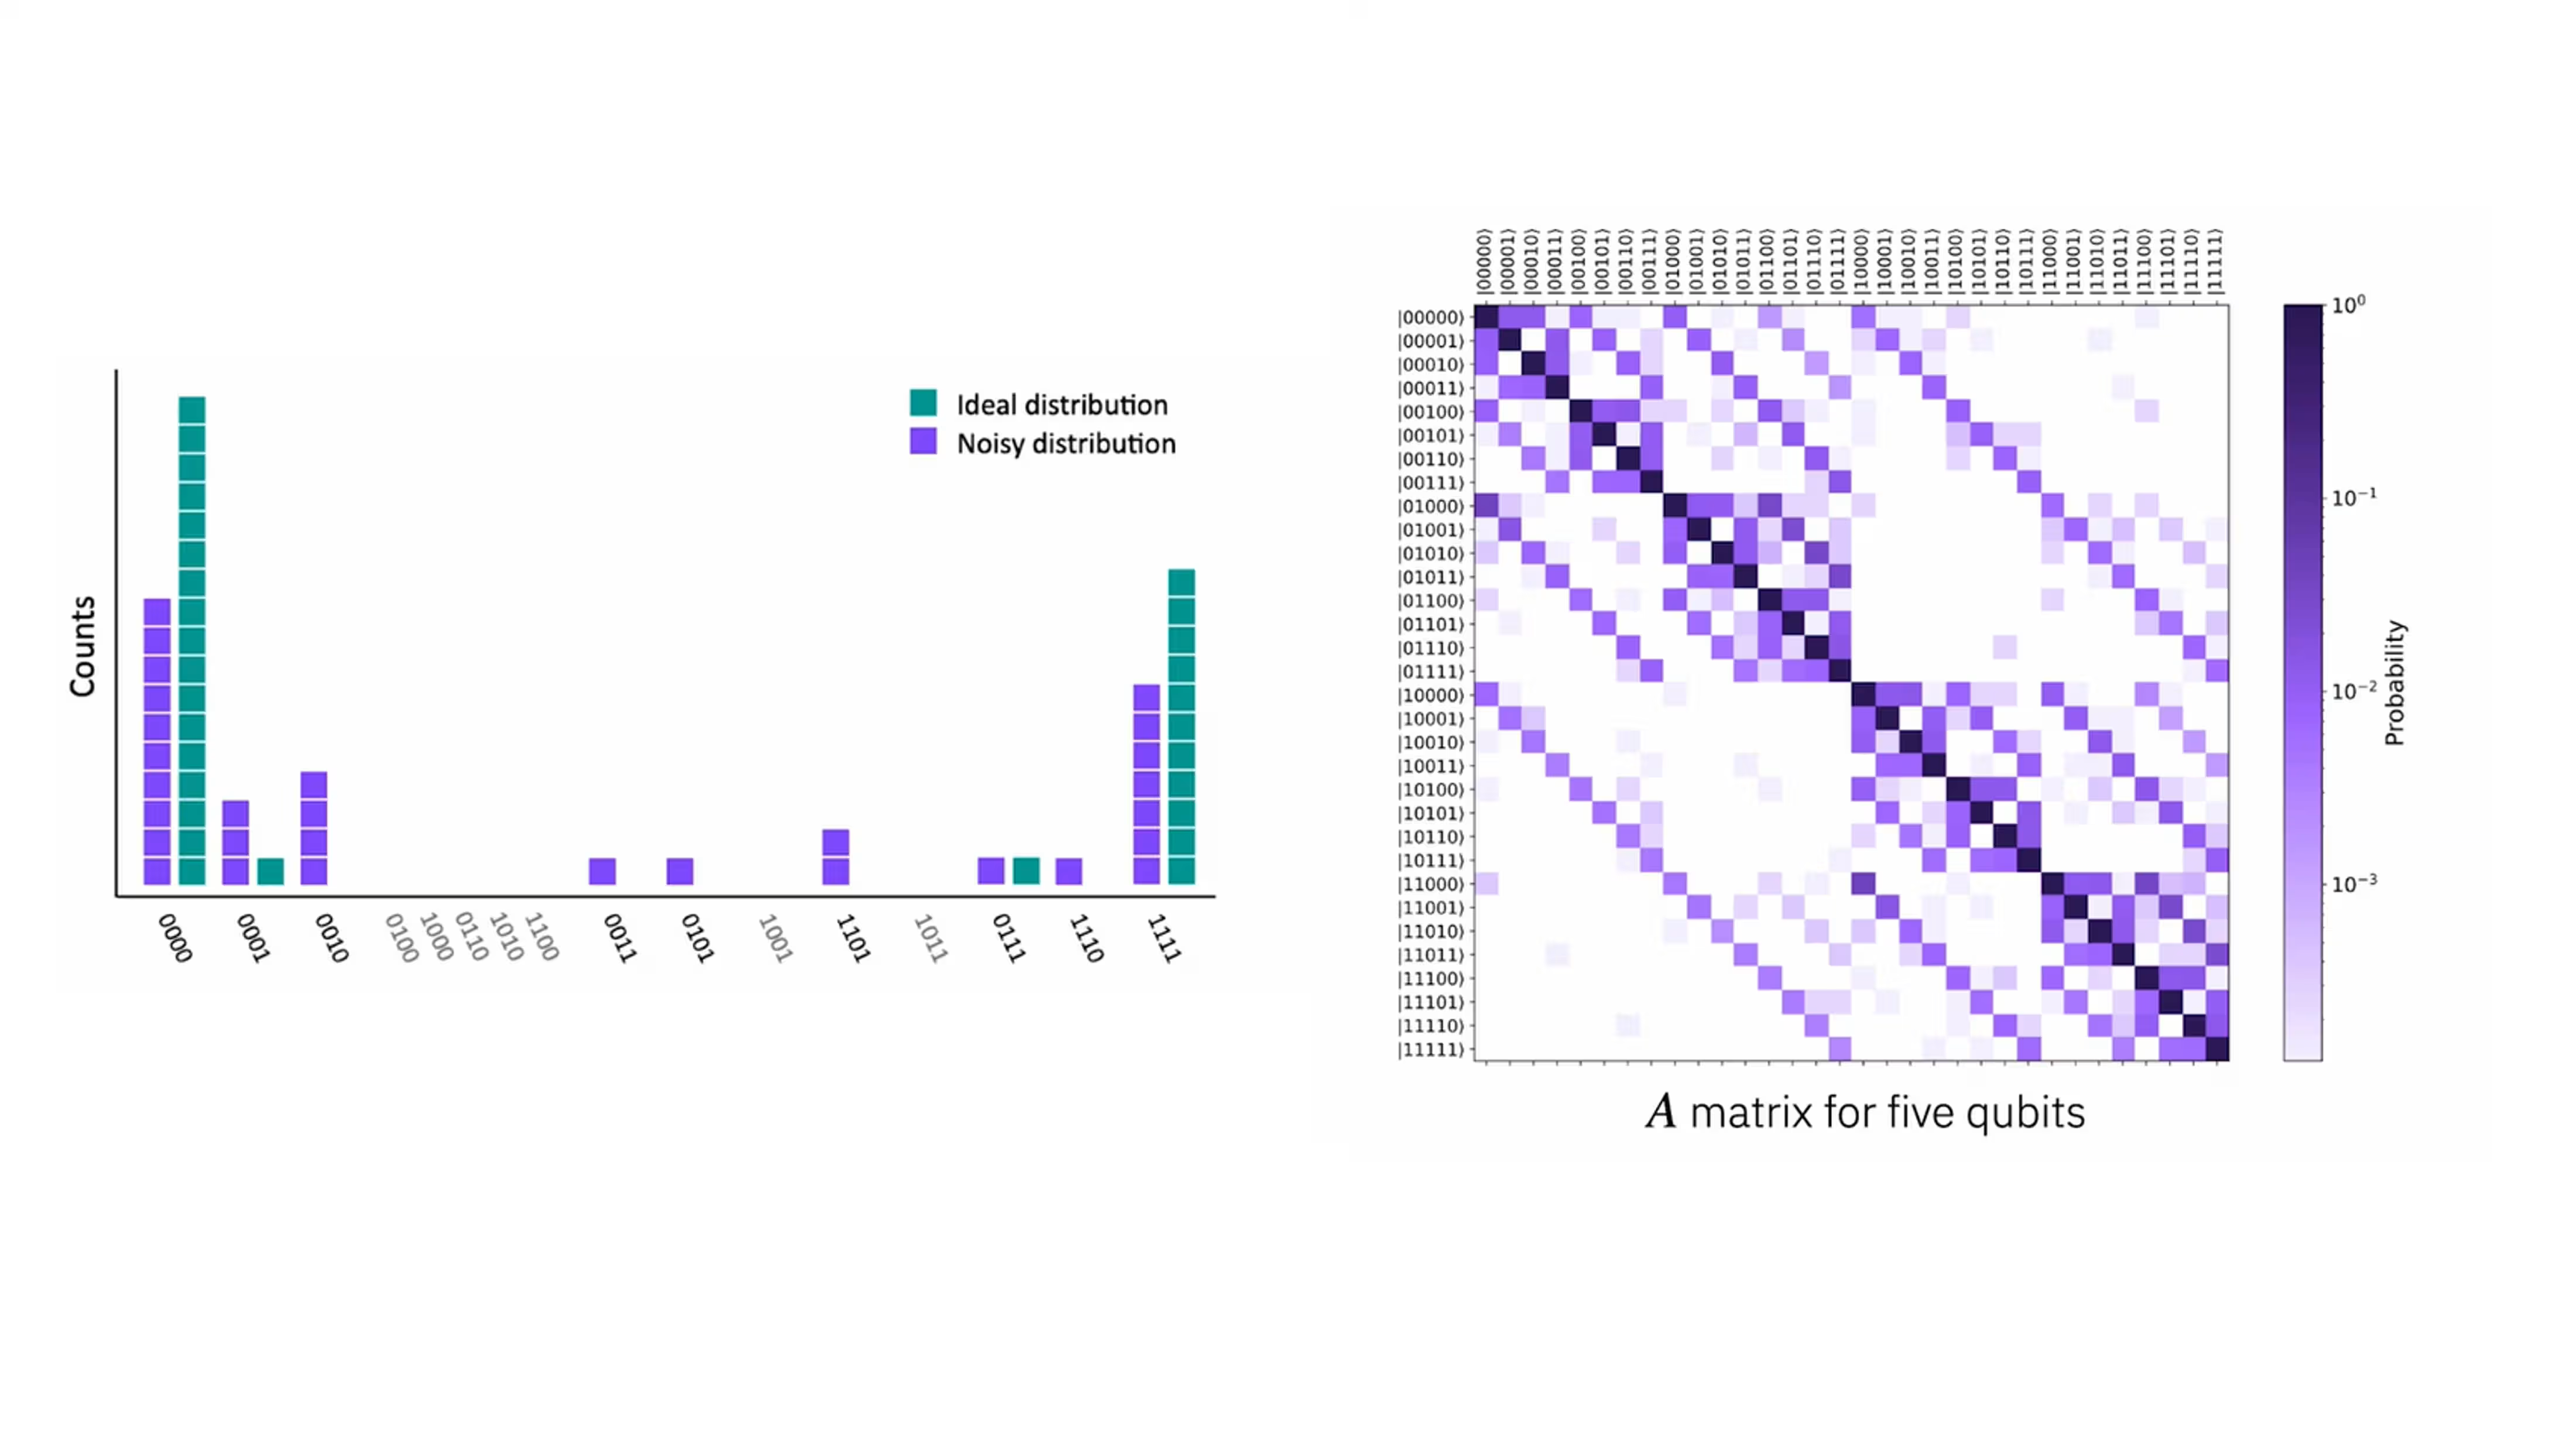
In der obigen Abbildung zeigt Teil (a) die ideale Verteilung eines GHZ-Zustands in Blaugrün und die tatsächlichen Messungen in Violett. In Teil (b) sehen wir ein Beispiel für eine -Matrix. Beachte, dass die Matrix nicht perfekt symmetrisch entlang der Diagonale ist, da nicht jedes Qubit gleich wahrscheinlich fälschlicherweise eine 0 oder fälschlicherweise eine 1 zurückgeben muss. In der Praxis ist es oft schwierig, Präparations- und Auslesefehler zu trennen, sodass sie häufig in einer einzigen Behandlung zusammengefasst werden (daher die verbreitete Verwendung von SPAM).
Eine Möglichkeit, diese SPAM-Fehler zu korrigieren, besteht darin, einfache Circuits mit bekannten idealen Messergebnissen zu verwenden und diese mit den gemessenen Ergebnissen bei Vorliegen von SPAM-Fehlern zu vergleichen. Dies kann genutzt werden, um die idealen Ergebnisse komplexerer Circuits per Reverse Engineering zu bestimmen. Für allgemeine Zustände mit hoher Entropie könnte dies das Erstellen einer Matrix mit Wahrscheinlichkeiten erfordern, aber in weniger extremen Fällen können diese Fehler gemindert werden.
Kohärente Fehler versus inkohärente Fehler
Kohärente Fehler sind systematische, deterministische und unitäre Fehldrehungen des Quantenzustands. Sie entstehen durch unvollkommene Quantenoperationen, die auf vorhersehbare Weise abweichen. Beispiele hierfür sind kleine Fehler bei der Drehung durch Ein-Qubit-Rotations-Gates, einschließlich solcher, die durch Kalibrierungsdrift verursacht werden und die konsistent über- oder unterrotieren. Mathematisch könnten wir schreiben, dass ein reales Rotations-Gate, etwa , durch das ideale Rotations-Gate plus einen zusätzlichen Fehler gegeben ist:
für eine kleine Unter- oder Überrotation . Weitere Beispiele sind ein Zwei-Qubit-Gate, das eine kleine unerwünschte Phasenverschiebung hinzufügt, und Steuerpulse, die systematisch von der idealen Form abweichen.
Ein wesentliches Merkmal kohärenter Fehler ist, dass sie deterministisch sind und selbst durch unitäre Gates modelliert werden können. Dementsprechend erhalten sie die Reinheit des Quantenzustands: Die Quanteninformation geht nicht verloren, sie wurde lediglich unvollkommen verarbeitet. Ein weiterer wichtiger Punkt ist, dass wiederholte kohärente Fehler konstruktiv interferieren und manchmal quadratisch mit der Anzahl der Gates wachsen.
Diese Fehler sind manchmal vorhersehbar und können daher bis zu einem gewissen Grad wegkalibriert werden. Die verbleibenden kohärenten Fehler können sich jedoch schnell akkumulieren und lästige Abweichungen von den idealen Zuständen verursachen. Das bedeutet, dass es manchmal vorteilhaft ist, kohärente Fehler absichtlich zu „randomisieren“. Dieses Verfahren und sein Nutzen werden in der Lektion zur Fehlerminderung behandelt.
Warum sie problematisch sind
Kohärente Fehler können sich auf gefährliche Weise „aufstauen“ und große Abweichungen vom korrekten Zustand verursachen, wenn sie nicht randomisiert oder korrigiert werden.
Inkohärente Fehler sind stochastisch, zufällig und oft nicht-unitär. Sie entstehen durch Wechselwirkungen mit der Umgebung oder unkontrollierte Rauschquellen. Wir haben bereits einige Beispiele gesehen: Energierelaxation / -Zerfall ist inkohärent. Das Gleiche gilt für stochastisches Gatterrauschen, thermisches Rauschen und Messfehler.
Das entscheidende Merkmal inkohärenter Fehler ist, dass sie bei jeder Ausführung einer Operation nicht dieselben sind. Sie sind nicht-unitär und können daher nicht wie kohärente Fehler durch ein einfaches unitäres Quantengatter modelliert werden. Da sie inkohärent sind, akkumulieren sie sich typischerweise linear wie zufälliges Rauschen, nicht wie eine konsistente Überdrehung.
Inkohärente Fehler führen dazu, dass Qubits Information irreversibel verlieren (Verlust von Reinheit und Phaseninformation).
Was ist also schlimmer? Wie bei den meisten Dingen im Quantencomputing kommt es darauf an. Die wichtigste Erkenntnis ist, dass sich kohärente Fehler schneller und nichtlinear akkumulieren (was schlecht ist). Sie können jedoch teilweise wegkalibriert werden, und die Phaseninformation ist immer noch in deinem System vorhanden, wenn du herausfindest, wie man sie richtig extrahiert. Inkohärente Fehler akkumulieren sich linear, was aus zwei Gründen gut ist: Es geht langsamer vonstatten als die kohärente Akkumulation, und es ist recht einfach zu erkennen, wie sich die Auswirkungen inkohärenter Fehler für Prozesse wie die Nullrausch-Extrapolation (Zero-Noise Extrapolation, ZNE) skalieren, die in der Lektion zur Fehlerminderung behandelt wird. Wenn jedoch inkohärente Fehler auftreten, geht Quanteninformation tatsächlich verloren, statt nur verschleiert zu werden.
Dichtematrizen und Quantenkanäle
In den folgenden Abschnitten werden wir tiefer auf einige Arten von kohärenten und inkohärenten Fehlern eingehen und sehen, wie sie mathematisch mithilfe von Quantenkanälen modelliert werden können. Zunächst ist eine kurze Auffrischung zu Dichtematrizen und Quantenkanälen angebracht. Eine vollständige, rigorose Behandlung dieser Themen findest du in John Watrous' Kurs General formulation of quantum information auf IBM Quantum Learning. Die Behandlung hier wird beispielorientiert und weniger formal sein.
Quantenkanäle sind die allgemeinste Art zu beschreiben, wie sich ein Quantensystem entwickelt, wechselwirkt und Rauschen unterliegt. Wenn du an reine Zustände und unitäre Entwicklung gewöhnt bist, sind Quantenkanäle der natürliche nächste Schritt.
In der Standard-Quantenmechanik wird ein „reiner“ Zustand als geschrieben. „Rein“ bezieht sich hier auf die Reinheit der Information oder das Wissen über die Präparation des Zustands; es bedeutet nicht einen Eigenzustand eines bestimmten Systems. Als Qubit-Beispiel ist ein reiner Zustand, weil wir über perfektes Wissen der relativen Amplituden und der Phase verfügen. Die zeitliche Entwicklung eines solchen reinen Zustands wird durch einen unitären Operator bestimmt:
gemäß der Schr"odinger-Gleichung, in der , wobei der Hamilton-Operator des Systems und das reduzierte Plancksche Wirkungsquantum ist, das oft „gleich eins gesetzt“ oder strenger genommen in den Hamilton-Operator absorbiert wird, sodass alle Energien in Einheiten von angegeben werden.
Unitäre Entwicklung ist reversibel, deterministisch und isoliert. Das reicht jedoch nicht aus, um reale Quantensysteme zu beschreiben. In realen Quantensystemen:
- Wir führen Messungen durch, wodurch der Quantenzustand in einen Eigenzustand des Systems kollabiert. Dies ist ausdrücklich nicht-unitär.
- Das System wechselwirkt mit einer Umgebung. Das bedeutet, dass das System nicht wirklich isoliert ist, und da die Umgebung nicht bis ins Unendliche verfolgt werden kann, entspricht dies einem Informationsverlust.
- Praktisch gesprochen: Rauschen korrumpiert den Zustand. Und mehr.
Unitäre Entwicklung allein kann diese Prozesse nicht beschreiben; daher benötigen wir eine allgemeinere Darstellung von Quantenzuständen und -prozessen. Ein gemischter Zustand beschreibt eine klassische Verteilung von Quantenzuständen. Das heißt, wir wissen bereits, dass der Quantenzustand: mit einer Wahrscheinlichkeit von 50 % im Zustand gemessen (in klassische Information kollabiert) wird und mit einer Wahrscheinlichkeit von 50 % in gemessen wird. Die Behauptung ist jedoch, dass der anfängliche Quantenzustand mit 100%iger Wahrscheinlichkeit exakt ist. Jetzt wollen wir zusätzlich zur quantenmechanischen Wahrscheinlichkeit eine klassische Wahrscheinlichkeit hinzufügen, zum Beispiel:
Der anfängliche Quantenzustand wird mit einer klassischen Wahrscheinlichkeit von 25 % in präpariert und mit einer klassischen Wahrscheinlichkeit von 75 % in präpariert (beachte die unterschiedlichen relativen Phasen).
Manchmal kann dies an expliziten klassischen Wahrscheinlichkeiten bei der Präparation liegen; ein andermal kann es an der Verschränkung mit Teilen der Umgebung liegen, die wir ignorieren. So oder so besteht eindeutig der Bedarf an einem Werkzeug, um diese klassische Verteilung quantenmechanischer Zustände zu beschreiben. Reine Zustände allein können diese Möglichkeiten nicht darstellen. Daher führen wir die Dichtematrix ein.
Ein gemischter Zustand wird durch einen Dichteoperator beschrieben:
Hier ist ein Quantenzustand (nicht notwendigerweise ein Eigenzustand eines bestimmten Operators) und ist die klassische Wahrscheinlichkeit, dass das System im Zustand präpariert ist. Dies ist eine gute Vorschrift, wie man eine Dichtematrix aus einer bekannten klassischen Verteilung von Quantenzuständen aufbaut. Andererseits möchten wir vielleicht wissen, gegeben sowohl eine klassische Verteilung von Quantenzuständen als auch eine quantenmechanische Wahrscheinlichkeit verschiedener Messergebnisse, wie groß die Wahrscheinlichkeit ist, dass eine Messung einen bestimmten Zustand ergibt (wie oder oder andere Zustände, wenn mehr Qubits beteiligt sind). Genau hier ist die Dichtematrix besonders nützlich. Wir können sie auch in einer Basis schreiben als:
Hier sind die Diagonalelemente Wahrscheinlichkeiten:
-
= Wahrscheinlichkeit, dass sich das Qubit in befindet
-
= Wahrscheinlichkeit, dass sich das Qubit in befindet
Sie sind reell, nicht-negativ und summieren sich zu 1.
Außerdiagonale Elemente sind Kohärenzen: Phasenbeziehungen oder Interferenzfähigkeit, und sie entsprechen im Allgemeinen dem Ausmaß an quantenmechanischer Information im Zustand. Dies ist eine informelle Aussage, aber sehen wir uns an, was sie in der Praxis bedeutet.
Beispiel
Betrachte den reinen Zustand . (a) Was weißt du über die Messwahrscheinlichkeiten und die Phaseninformation, ohne irgendeine Rechnung durchzuführen? (b) Erstelle die Dichtematrix und überprüfe deine Intuition.
Solution:
(a) Da es sich um einen reinen Zustand handelt, gibt es nur eine mögliche Phase zwischen und : +1. Dies ist perfekte Phaseninformation, daher erwarten wir, dass die außerdiagonalen Elemente unserer Dichtematrix groß sind. Du hast vielleicht eine genauere Intuition über die Außerdiagonalelemente, aber das reicht vorerst aus. Außerdem sind die Amplituden der beiden Basiszustände gleich, daher erwarten wir eine Wahrscheinlichkeit von 50 %, entweder oder zu messen. Wir erwarten also, dass die Diagonaleinträge 1/2 betragen. (b) Unter Verwendung der obigen Definition:
gilt nur für den Zustand . Wir können also schreiben
Die Diagonaleinträge sind wie erwartet jeweils , und die außerdiagonalen Elemente sind groß (sie summieren sich zu eins).
Sehen wir uns nun an, was passiert, wenn wir keine gute Phaseninformation haben.
Beispiel
Betrachte einen ähnlichen Fall, aber jetzt mit einer klassischen Wahrscheinlichkeit von 50 %, sich im Zustand zu befinden, und einer klassischen Wahrscheinlichkeit von 50 %, sich im Zustand zu befinden. Dieselben zwei Fragen: (a) Was weißt du über die Messwahrscheinlichkeiten und die Phaseninformation, ohne irgendeine Rechnung durchzuführen? (b) Erstelle die Dichtematrix und überprüfe deine Intuition.
Solution:
(a) Wie zuvor sind die Amplituden der beiden Basiszustände gleich, daher erwarten wir eine Wahrscheinlichkeit von 50 %, entweder oder zu messen. Wir erwarten also, dass die Diagonaleinträge 1/2 betragen. Diesmal gibt es jedoch zwei entgegengesetzte Möglichkeiten für die Phase zwischen und : +1 und -1, und jede ist gleich wahrscheinlich. Man könnte erwarten, dass man bei zwei gleich wahrscheinlichen entgegengesetzten Phasen wenig bis keine Phaseninformation hat. Man könnte erwarten, dass die außerdiagonalen Einträge klein sind. (b) Wieder unter Verwendung der obigen Definition
gilt nur für die beiden Zustände und . Wir können also schreiben
Die außerdiagonalen Einträge sind klein, tatsächlich null, wie erwartet. Die Diagonalelemente betragen weiterhin jeweils 50 %, was Sinn ergibt, da jeder der Zustände in der Mischung und gleich gewichtet hatte.
Dieses Konstrukt wird interessanter, je mehr Qubits beteiligt sind. Erkunde dies in den folgenden Fragen.
Überprüfe dein Verständnis
Schreibe die Dichtematrix für den reinen Bell-Zustand .
Antwort
gilt nur für den Zustand . Wir können also schreiben
Schreibe die Dichtematrix für eine klassische Wahrscheinlichkeit von 25 % für und eine klassische Wahrscheinlichkeit von 75 % für .
Antwort
gilt nur für die beiden Zustände und . Wir können also schreiben
Ändere deine Arbeit aus der vorherigen Frage ab, um die Dichtematrix für eine klassische Wahrscheinlichkeit von 50 % für und eine klassische Wahrscheinlichkeit von 50 % für zu schreiben. Sage voraus, welche Phaseninformation erhalten bleiben sollte.
Antwort
gilt nur für die beiden Zustände und . Wir können also schreiben
Die Diagonalterme summieren sich, wie es sein muss, zu 1. Die außerdiagonalen Terme heben sich hier nicht auf, wie es in einem vorherigen Ein-Qubit-Beispiel der Fall war. Warum das so ist, lässt sich mathematisch nachvollziehen, aber eine Kurzerklärung ist, dass jetzt mehr Zustände in unserem Hilbertraum vorhanden sind. Obwohl der erste Bell-Zustand eine positive relative Phase und der zweite eine negative hatte, lagen diese Phasen zwischen unterschiedlichen Basiszuständen. Der erste Bell-Zustand hatte eine Phase zwischen und , während der zweite eine relative Phase zwischen und hatte.
Quantenkanäle
Ein Quantenkanal ist die allgemeinste physikalisch erlaubte Transformation eines Quantenzustands. Er überführt eine anfängliche Dichtematrix in eine andere Dichtematrix:
Hier bedeutet ein Quantenkanal , der auf eine Dichtematrix wirkt, nicht zu verwechseln mit den Bell-Zuständen oder .
Quantenkanäle sind extrem allgemein. Sie können Folgendes umfassen:
-
Unitäre Entwicklung
-
Probabilistische Mischungen von Unitären
-
Measurements
-
Decoherence
-
Amplitudendämpfung (Energieverlust)
-
Dephasierung (Verlust von Phaseninformation)
-
Wechselwirkung mit einer Umgebung Und viele andere Dinge.
Eine Möglichkeit, über Quantenkanäle nachzudenken, besteht darin, dass sie für Dichtematrizen das sind, was Unitäre für reine Zustände sind. Doch die Allgemeinheit der Dichtematrizen erlaubt es den entsprechenden Quantenkanälen, viel allgemeiner und damit mächtiger zu sein.
Die einzigen Einschränkungen für einen Quantenkanal sind, dass er sein muss:
- Linear Mischungen von Zuständen sollten sich konsistent entwickeln:
- Vollständig positiv Er sollte keine negativen Wahrscheinlichkeiten erzeugen, selbst wenn dein System mit etwas anderem verschränkt ist.
- Spurerhaltend Wahrscheinlichkeiten müssen sich zu 1 addieren. Diese werden manchmal im Akronym CPTP zusammengefasst: Completely Positive Trace-Preserving maps (vollständig positive spurerhaltende Abbildungen).
Es gibt verschiedene Darstellungen von Quantenkanälen, darunter die Stinespring-, Kraus- und Choi-Darstellung. Diese werden ausführlich in dieser Lektion über Quantenkanäle im Kurs General formulation of quantum information behandelt, und dort wird auch gezeigt, dass sie äquivalent sind. Wir werden hier nicht näher auf diese verschiedenen Darstellungen eingehen. Es genügt zu sagen, dass sie vergleichbar damit sind, Vektoren mithilfe von drei verschiedenen Koordinatensystemen zu beschreiben. Jede könnte unterschiedliche Aspekte betonen und auf unterschiedliche Weise Intuition aufbauen; aber sie alle liefern dir die richtige Antwort. Kraus-Darstellungen sind für unsere Zwecke praktisch. Sie bieten eine bequeme formelhafte Möglichkeit, die Wirkung eines Kanals durch Matrixmultiplikation und -addition auszudrücken. Insbesondere ist eine Kraus-Darstellung eine Spezifikation eines Kanals in folgender Form.
Hier sind Matrizen, die alle die gleichen Dimensionen haben: Ihre Spalten entsprechen den klassischen Zuständen des Eingangssystems , und ihre Zeilen entsprechen den klassischen Zuständen des Ausgangssystems, sei es oder ein anderes System . Damit ein gültiger Kanal ist, müssen diese Matrizen die folgende Bedingung erfüllen.
Diese Matrizen werden Kraus-Matrizen genannt. Diese Formulierung ist nicht nur auf Rauschkanäle anwendbar, sondern auf allgemeine Quantenprozesse und -kanäle, einschließlich Messung. Sehen wir uns ein Beispiel an, wie diese verwendet werden können, um Kanäle im Kontext von Rauschen und Fehlern aufzubauen.
Vollständig dephasierender Kanal
Betrachte einen Kanal, der alle Phaseninformation zerstört, und nenne ihn den vollständig dephasierenden Kanal. Das bedeutet, der Kanal soll jede Dichtematrix der Form
nehmen und auf
abbilden.
Wenn wir annehmen, dass die Dichtematrix bereits in der Rechenbasis geschrieben wurde, können wir als ausdrücken. Dies legt eine Reihe von Kraus-Matrizen nahe, die diese Kanalwirkung erzielen können: . Wenden wir diese Strategie auf ein Beispiel mit einem einzelnen Qubit an und sehen wir, ob sie wie gefordert funktioniert:
Setze und .
Da eine Zahl ist, können wir den Vektor einfach daran vorbeischieben. Dies gilt auch für den zweiten Term. Wir erhalten:
Beachte, dass diese Matrizen die erforderliche Bedingung erfüllen:
Es ist erwähnenswert, dass diese Wahl der Kraus-Matrizen nicht eindeutig ist.
Rauschen als Kanäle charakterisieren
In diesem Abschnitt verwenden wir das Modell der Bloch-Kugel und die Mathematik von Quantenkanälen, um verschiedene Arten von Rauschen und Fehlern besser zu verstehen.
Inkohärente Fehler
Kehren wir zu inkohärenten Fehlern zurück und untersuchen speziell Energierelaxationsfehler. Erinnere dich daran, dass der Zustand der Grundzustand eines Qubits ist und der Zustand eine etwas höhere Energie hat. Manchmal zerfallen Quantenzustände einfach spontan von einem höheren Energieniveau in ein niedrigeres. Der Prozess der spontanen Emission ist ein reichhaltiges Thema und kann ohne eine quantenfeldtheoretische Behandlung nicht wirklich verstanden werden. Doch die Intuition dahinter ist uns allen sehr vertraut: zufällige Störungen können dazu führen, dass ein Stein einen Hügel hinunterrollt; sie werden jedoch nicht dazu führen, dass ein Stein einen Hügel hinaufrollt. Wie lange ein Qubit im höheren Energiezustand verbleibt, wird durch eine Zeit charakterisiert. Genauer gesagt ist die Wahrscheinlichkeit, dass ein Qubit, das im Zustand präpariert wurde, nach der Zeit in diesem Zustand verbleibt, . Oder äquivalent dazu ist die Wahrscheinlichkeit eines Energierelaxationsfehlers nach der Zeit
Um dies mit einem Quantenkanal in der Kraus-Darstellung zu beschreiben, benötigen wir Kraus-Matrizen, die Folgendem entsprechen:
- -Zustände unverändert lassen
- -Zustände mit einer gewissen Wahrscheinlichkeit p in ändern.
Definieren wir
Prüfen wir zunächst, ob dies die gewünschten Auswirkungen auf eine Dichtematrix hat. Betrachte ein System, das sich in einem reinen Zustand befindet. Wir haben in einem Beispiel oben gesehen, dass die Dichtematrix für diesen Fall
Wenn wir den Energierelaxationskanal mit Hilfe der Kraus-Matrizen anwenden, erhalten wir die neue, abgebildete Dichtematrix:
Betrachten wir dies und vergleichen es mit unserer Intuition:
Prüfen wir zunächst den Grenzwert für gegen null. Wir erhalten wie erwartet unsere ursprüngliche Dichtematrix zurück:
Mit fortschreitender Zeit würden wir erwarten, dass die Wahrscheinlichkeit, den Zustand zu messen, zunimmt und die Wahrscheinlichkeit, zu messen, abnimmt. Dies ist wiederum genau das, was wir sehen, da
Wir können auch trivial erkennen, dass sich die Wahrscheinlichkeiten für die Messung von und zu 1 summieren, wie es sein muss.
Die genaue Skalierung der Kohärenzterme (Nebendiagonalelemente) würde den Rahmen dieser Betrachtung sprengen. Klar ist jedoch, dass wir zu Beginn perfekte Phaseninformation haben und nach sehr langer Zeit keine Phaseninformation mehr vorhanden sein kann, da das System vollständig in den Zustand relaxiert ist. Daher müssen die Kohärenzterme über sehr lange Zeiträume auf null abklingen. Tatsächlich,
Viele der Einschränkungen für unsere Kraus-Matrizen werden implizit durch diese intuitiven Überlegungen überprüft. Man sollte rigoros prüfen, dass die Einschränkungen für Kanäle (und insbesondere für Kraus-Matrizen) erfüllt sind, aber wir überlassen dies dem Leser als Übung.
Grafisch lässt sich dieser Kanaltyp mithilfe einer Bloch-Kugel darstellen. Ein reiner Zustand liegt auf der Oberfläche einer Bloch-Kugel. Gemischte Zustände verschieben sich ins Innere der Kugel und breiten sich von einem einzelnen Punkt aus. Die Einbeziehung klassischer Wahrscheinlichkeiten zeigt sich in der Verringerung des absoluten Abstands vom Ursprung zu einem der Zustände in der Mischung, während die Ausbreitung von einem einzelnen Punkt zu einer Region das Mischen mehrerer möglicher Zustände anzeigt. Im speziellen Fall eines Energierelaxationskanals würde der gemischte Zustand (die Dichtematrix) nach einer nicht vernachlässigbaren Zeit wie im folgenden Bild aussehen: eine Region im Inneren der Bloch-Kugel, die nach oben zum -Pol hin verschoben ist und sowohl entlang der -Achse als auch entlang der -Ebene geschrumpft ist, wobei die Schrumpfung entlang der -Ebene geringer ausfällt als entlang der -Achse.

Beachte, dass die Region keine „Kappe“ der Bloch-Kugel ist, wie es in einer perspektivischen Darstellung manchmal erscheint. Wie im Video deutlich zu erkennen ist, handelt es sich um ein abgeplattetes Rotationsellipsoid, das geschrumpft und zum Zustand hin verschoben ist. Rauschkanäle (und Kanäle im Allgemeinen) sind natürlich auf Systeme beliebiger Größe anwendbar. Doch ihre visuelle Darstellung (wie mit einer Bloch-Kugel) wird mit zunehmender Anzahl wechselseitig orthogonaler Zustände im Hilbertraum schwieriger.
Überprüfe dein Verständnis
Überprüfe, dass die im obigen Energierelaxationskanal verwendeten Kraus-Matrizen die Identitätsbedingung erfüllen:
Antwort
Wir werden zwei weitere Arten inkohärenter Rauschkanäle vorstellen, überlassen aber den Großteil der Interpretation und Überprüfung als Übungen. Als Nächstes folgt der Dephasierungskanal, der einen Verlust der Phaseninformation bei gleichzeitiger Erhaltung der Amplituden beschreibt. Obwohl an der gesamten Messwahrscheinlichkeit weiterhin sowohl klassische als auch quantenmechanische Wahrscheinlichkeiten beteiligt sein können, wird der Verlust der Phaseninformation oft als Verlust von Quanteninformation beschrieben, oder als ein Vorgang, bei dem das System klassischer wird.
Ganz ähnlich wie die Energierelaxation mit einer charakteristischen Zeit beschrieben wurde, werden Dephasierungsfehler durch einen zweiten Zeitparameter beschrieben. Die Wahrscheinlichkeit eines Dephasierungsfehlers nach der Zeit ist gegeben durch
Ein Satz von Kraus-Matrizen für den Dephasierungskanal auf einem einzelnen Qubit lautet in Bezug auf diese Wahrscheinlichkeit wie folgt:
Das Ergebnis dieses Dephasierungskanals wird in der Abbildung unten mithilfe einer Bloch-Kugel visualisiert.

Beachte, dass die Amplituden nicht verändert werden, sodass Zustände, die genau auf einem Pol liegen ( oder ), unbeeinflusst bleiben und weiterhin auf die Kugeloberfläche im schattierten Bereich abgebildet werden. Phaseninformation geht jedoch verloren, was einer Schrumpfung des schattierten Bereichs entlang der -Ebene entspricht. Eine Möglichkeit, dies zu verstehen: Jeder mögliche Quantenzustand kann weiterhin eine wohldefinierte Phase besitzen, doch da eine klassische Wahrscheinlichkeit besteht, mehrere Zustände mit unterschiedlichen wohldefinierten Phasen vorzufinden, verringert sich die Gesamtwahrscheinlichkeit für jede einzelne wohldefinierte Phase.
Überprüfe dein Verständnis
Überprüfe, dass die oben definierten Kraus-Matrizen für den Dephasierungskanal die Identitätsbedingung erfüllen:
Antwort
Beginne mit einem reinen Einzel-Qubit-Zustand deiner Wahl, mit einer wohldefinierten Phase zwischen und . Schreibe ihn als Dichtematrix. Wende den Dephasierungskanal mit den oben vorgeschlagenen Kraus-Operatoren an. Interpretiere die resultierende, abgebildete Dichtematrix.
Antwort
Wählen wir den Zustand . Die entsprechende Dichtematrix ist
Nun wenden wir den Dephasierungskanal mit den Kraus-Operatoren auf diese Dichtematrix an.
Zunächst stellen wir fest, dass die Summe der Diagonalelemente tatsächlich gleich eins ist, wie es sein muss. Zweitens ist zu beachten, dass die Nebendiagonalelemente anfangs groß waren, mit einer Summe von 24/25, was auf starke Kohärenz hindeutet. Beachte, dass diese Nebendiagonalelemente mit zunehmender Wahrscheinlichkeit eines Dephasierungsfehlers abnehmen. Dies entspricht ebenfalls unserer Erwartung. Eine Feinheit: Beachte, was passiert, wenn . Die Kohärenz wird wieder stark! Das erscheint zunächst kontraintuitiv, denn eine hohe Wahrscheinlichkeit eines Dephasierungsfehlers sollte doch unsere Phase durcheinanderbringen, oder? Der Haken ist: Wenn wir uns zu 100 % sicher sind, dass ein Phasenfehler auftritt, dann haben wir wieder starke Informationen über die Phase – die Phase hat sich einfach umgekehrt. Mit dieser Erkenntnis würden wir erwarten, dass die schlechteste Phaseninformation einer 50:50-Chance für das Auftreten eines Phasenfehlers entspricht, und genau das finden wir auch.
Unser letztes Beispiel für einen Rauschkanal, der inkohärente Fehler beschreibt, ist der Pauli-Rauschkanal. Dieser Kanal beschreibt das Auftreten von drei Fehlertypen mit unabhängigen Wahrscheinlichkeiten:
- Bit-Flip-Fehler (X-Fehler) mit Wahrscheinlichkeit
- Phasen-Flip-Fehler (Z-Fehler) mit Wahrscheinlichkeit
- Kombinierter X- und Z-Fehler (Y-Fehler) mit Wahrscheinlichkeit Hierbei gilt für alle . Daraus folgt, dass die Wahrscheinlichkeit, dass kein Fehler auftritt, ist.
Die Kraus-Operatoren für diesen Kanal sind:
Im Fall des Pauli-Rauschkanals ist es lehrreich, den Kanal selbst auszuschreiben:
Aus dieser Form erkennen wir, dass der Pauli-Rauschkanal einen oder mehrere Fehler entsprechend der Wirkung der Pauli-Matrizen implementiert, jeweils mit Wahrscheinlichkeit .
Verschiedene Kombinationen von Flip-Wahrscheinlichkeiten führen zu unterschiedlichen Visualisierungen. Hier visualisieren wir den Spezialfall , auch als Depolarisierungskanal bezeichnet.

Modellierung kohärenter Fehler
Quantenkanäle können sowohl kohärente als auch inkohärente Fehler darstellen, werden in der Praxis jedoch hauptsächlich für inkohärente Fehler verwendet, da kohärente Fehler besser als unitäre Fehlkalibrierungen modelliert oder zur einfacheren Analyse in stochastische Kanäle umgewandelt werden. In diesem Abschnitt stellen wir Ansätze vor, die besser auf kohärente Fehler anwendbar sind.
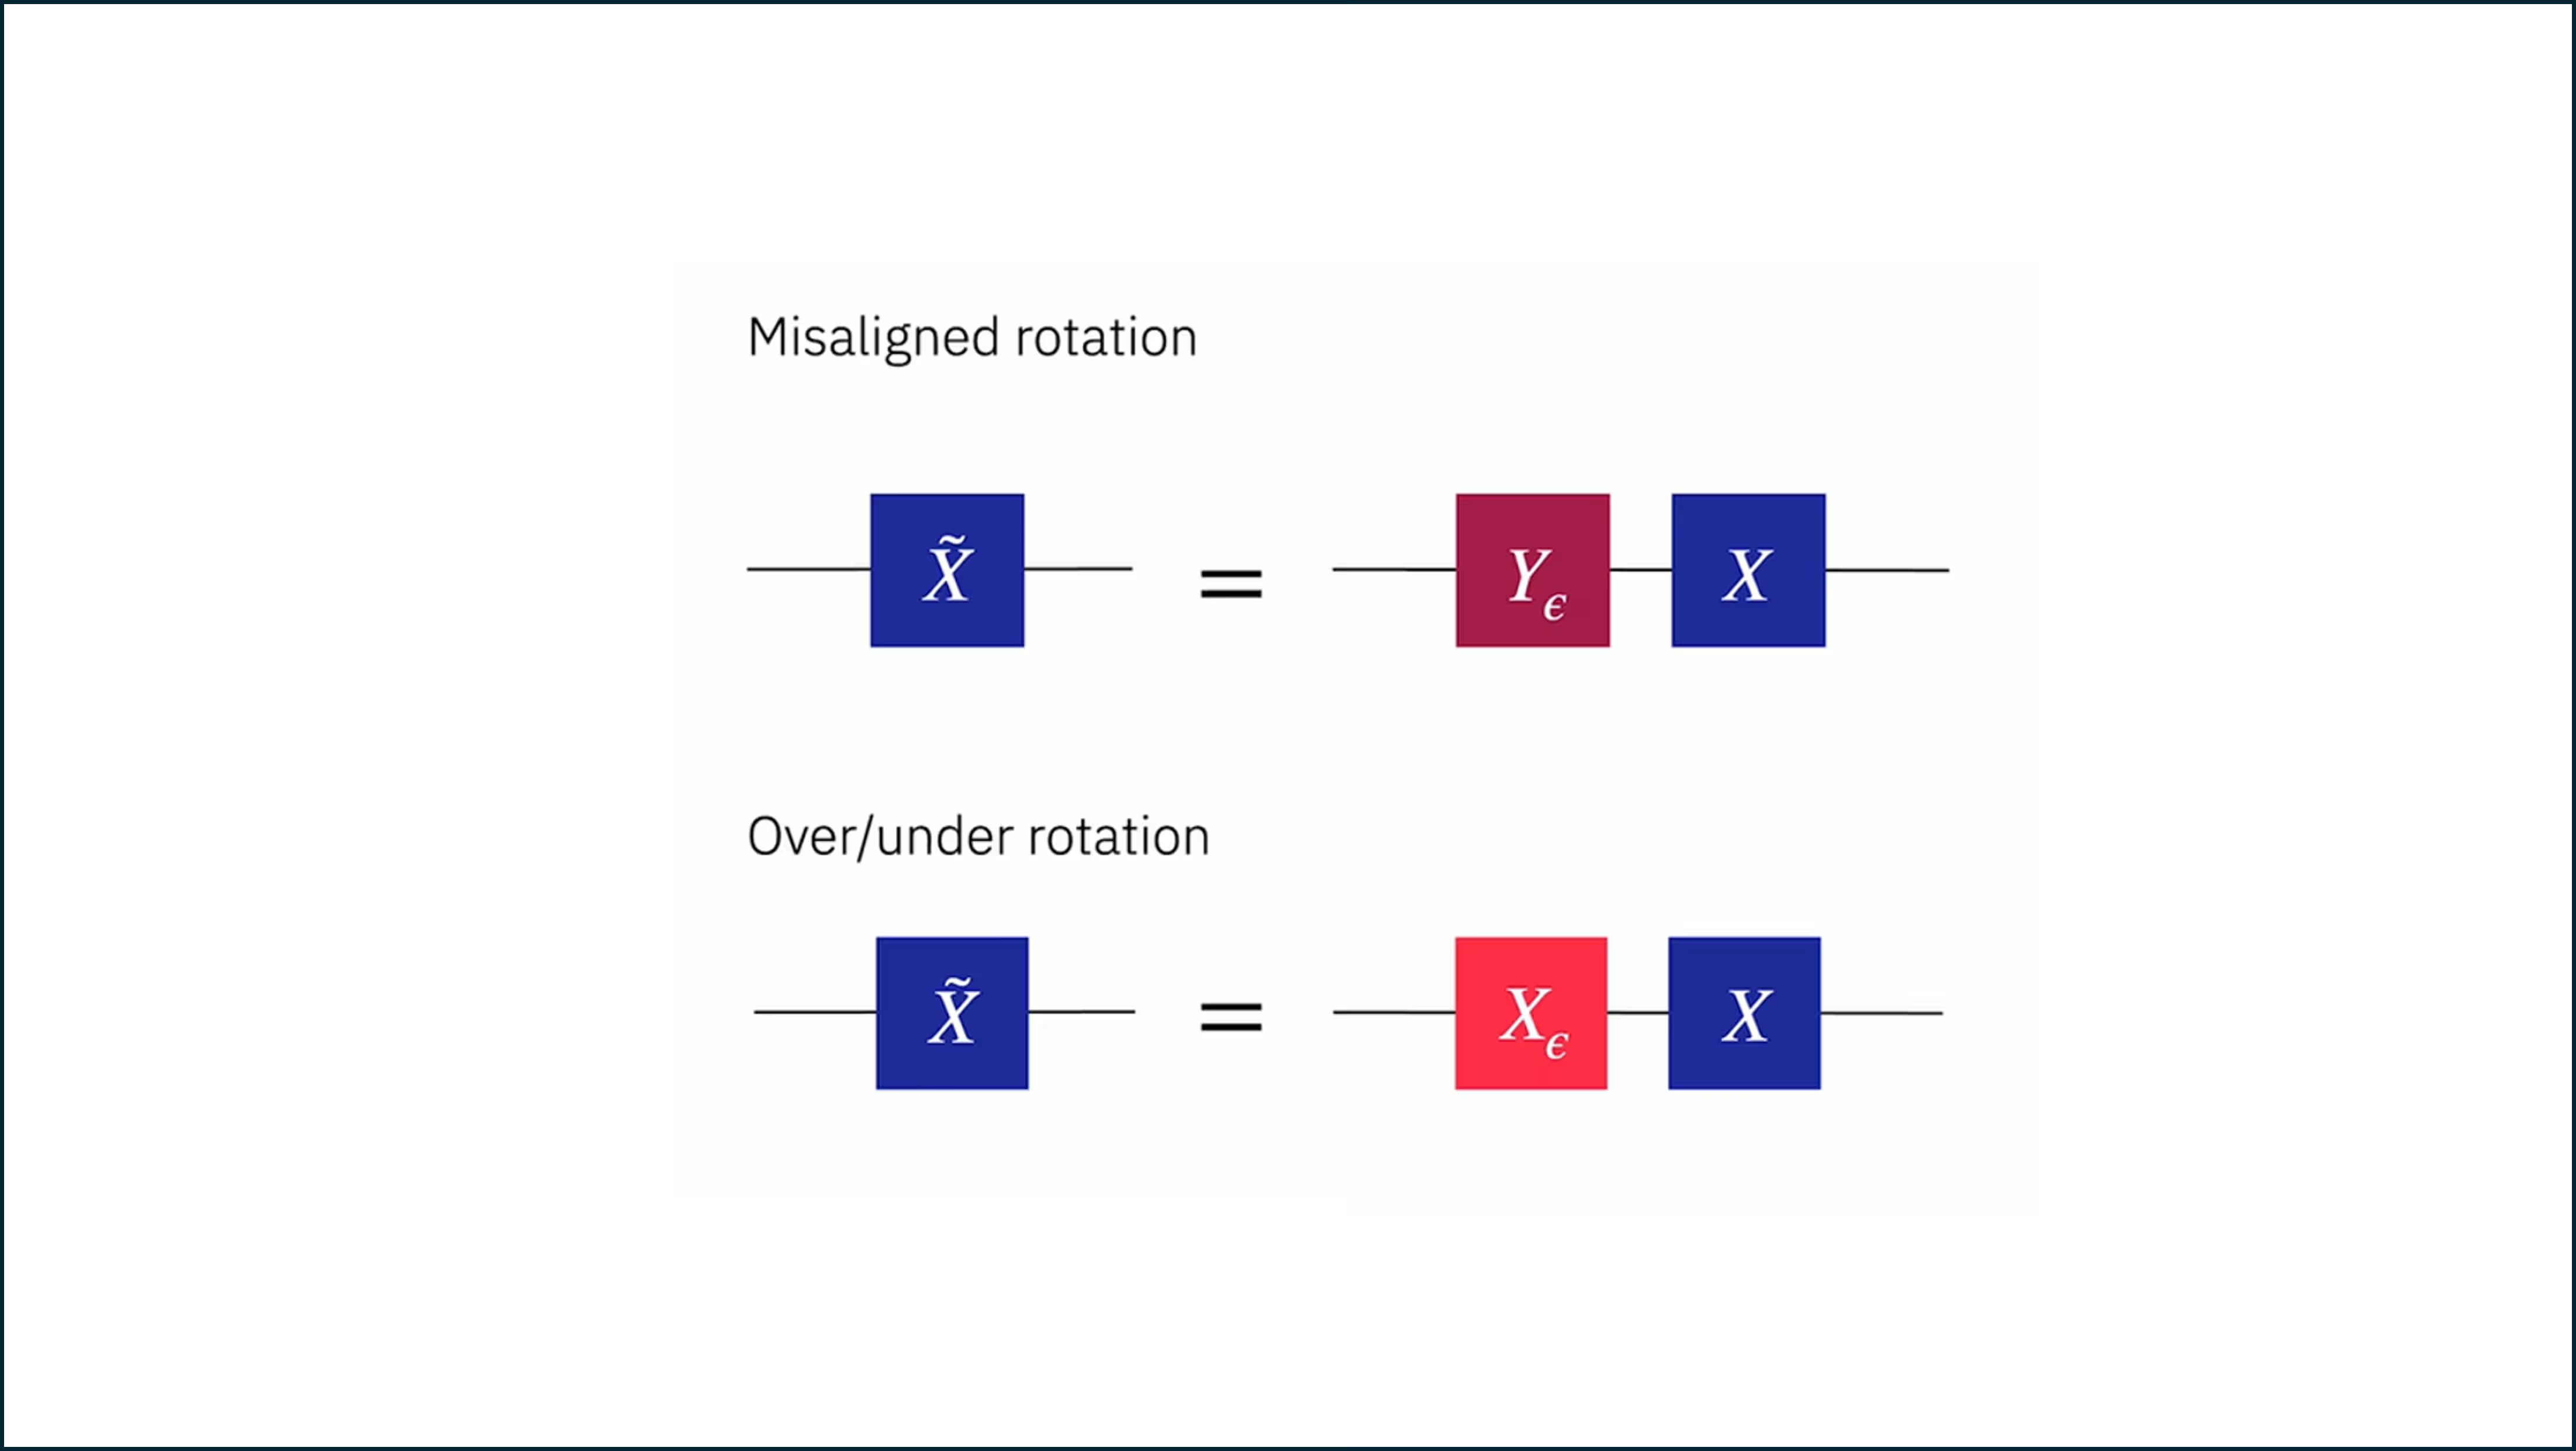
Kohärente Fehler können durch unerwünschte unitäre Gates modelliert werden. Einige einfache Beispiele sind fehlausgerichtete Rotationen oder Unter-/Überrotation. Im Bild unten zeigen wir eine fehlausgerichtete Rotation als zusätzliche -Rotation um einen kleinen Betrag zusätzlich zur gewünschten Rotation um die -Achse. Eine Überrotation wird durch die gewünschte -Rotation sowie eine zusätzliche Rotation um dieselbe Achse beschrieben.
Zwei-Qubit-Fehler und schattierte Lichtkegel
Ein Einzel-Qubit-Gate rotiert ein isoliertes Qubit. Ein Zwei-Qubit-Gate implementiert eine Logik, die auf zwei Qubits basiert, kann jedoch keine direkte Messung eines der beiden Qubits vornehmen; es muss daher eine Wechselwirkung zwischen den Qubits aktivieren. Diese Wechselwirkung ist der Grund, warum wir Verschränkung aufbauen können, und sie ist auch die Quelle eines Großteils des Rauschens, des Übersprechens und der Kalibrierungsschwierigkeiten. Diese Wechselwirkung zwischen Qubits ermöglicht es auch Fehlern, sich auszubreiten. Wenn ein Qubit einen Fehler aufweist und als Kontroll-Qubit für ein anderes Ziel-Qubit dient, kann der Fehler auf das Ziel-Qubit übertragen werden. In dieser Lektion untersuchen wir, was Zwei-Qubit-Gates für Fehlerraten und deren Ausbreitung innerhalb eines Circuits bedeuten.
Echoed-Cross-Resonance-Gates
Unterschiedliche Hardwarearchitekturen und Gate-Familien realisieren diese Wechselwirkung auf unterschiedliche Weise. IBM-Quantencomputer implementieren abstrakte Zwei-Qubit-Gates wie CZ- oder CX-Gates mithilfe hardware-nativer Echoed-Cross-Resonance-(ECR)-Gates. ECR-Gates erzeugen eine effektive -Wechselwirkung mittels eines Mikrowellen-Drives. Verwandte Gates wie CNOT werden aus aufgebaut, indem Einzel-Qubit-Rotationen hinzugefügt werden.
Unterschiedliche Qubits haben unterschiedliche Resonanzfrequenzen (Frequenzen, auf die sie stark reagieren). Ein Standardvorgang könnte diese Resonanzfrequenz nutzen, um einen Übergang in einem Qubit zu induzieren. Was passiert aber, wenn man Qubit C mit der Resonanzfrequenz eines benachbarten Qubits T ansteuert? Benachbarte Qubits sind durch eine feste kapazitive oder resonator-vermittelte Wechselwirkung verbunden. Aufgrund dieser Kopplung „sickert“ ein Drive auf Qubit C in den Hamilton-Operator von Qubit T durch. Stärke und Richtung dieses effektiven Drives hängen vom Zustand von Qubit C ab ( oder ). Hierbei ist Qubit C die Kontrolle und Qubit T das Ziel.
Das Ergebnis ist eine effektive Rotation des Ziel-Qubits, die vom Zustand des Kontroll-Qubits abhängt. Mathematisch:
Diese ZX-Wechselwirkung ist genau das, was man zum Aufbau eines CNOT benötigt. Die weiteren Terme könnten jedoch einige Fehler enthalten und enthalten mit ziemlicher Sicherheit eine kapazitive Kopplung zwischen den Qubits C und T, die einem ZZ-Term entspricht.
Wir können uns diese zusätzlichen Terme wie folgt vorstellen:
-
IX = Ziel wird unbeabsichtigt angesteuert
-
ZI = Kontroll-Qubit erhält eine unerwünschte Z-Rotation
-
IZ = Ziel-Qubit erhält eine unerwünschte Z-Rotation
-
ZZ = statische zustandsabhängige Phasenverschiebung
-
andere = kleine XY-, XX-, Wechselwirkungen höherer Ordnung
Ein ECR-Gate ist einfach eine kontrollierte Rotation plus ein sorgfältig gewählter Echo-Puls auf dem Kontroll-Qubit. Das Echo kehrt das Vorzeichen vieler unerwünschter Terme um, während die ZX-Wechselwirkung erhalten bleibt. Dieser Vorgang hebt IX- und ZI-Fehler recht gut auf, manchmal auch einige Terme höherer Ordnung. Das Echo kann die statische ZZ-Kopplung jedoch nicht aufheben, da sie mit dem Echo-Puls kommutiert. Es gibt weitere Wechselwirkungen, die sich bei diesem Vorgang nicht aufheben: einige Restnichtlinearitäten und Spectator-Qubit-Effekte, Leckage und Kontamination durch Fernwirkungen des Drives, sowie ein paar andere — aber der ZZ-Term ist besonders wichtig.
Dieser Vorgang erfordert häufig Drive-Zeiten, die um eine Größenordnung länger sind als bei Einzel-Qubit-Gates. Die Kombination aus längeren Drive-Zeiten, anhaltenden ZZ-Termen im Hamiltonian und Unvollkommenheiten der Kopplung macht Zwei-Qubit-Gates zur dominanten Fehlerquelle bei Gates. Beachte außerdem, dass, wenn in einem Circuit Wechselwirkungen zwischen nicht benachbarten Qubits benötigt werden, die dafür nötigen SWAP-Gates natürlich ebenfalls Zwei-Qubit-Gates sind. Deshalb lautet die gängige tiefebezogene Metrik: Zwei-Qubit, transpilierte Tiefe. Uns interessieren vor allem Zwei-Qubit-Gates, weil sie den Gate-Fehler dominieren, und wir müssen die transpilierten Circuits betrachten, da die Transpilierung oft viele zusätzliche Zwei-Qubit-Gates in Form von SWAP-Gates einführt.
Überprüfe dein Verständnis
Erkläre, warum uns vor allem die transpilierte Zwei-Qubit-Tiefe interessiert. Berücksichtige dabei die Hardwareeinschränkungen sowie die Tatsache, dass die Einzel-Qubit-Gate-Tiefe deutlich größer sein könnte.
Antwort
Zwei-Qubit-Gates haben deutlich höhere Fehlerraten als Einzel-Qubit-Gates. Einzel-Qubit-Gates sind nicht perfekt, sodass es Fälle geben kann, in denen es auch nützlich ist, die Einzel-Qubit-Tiefe zu berücksichtigen. Doch die Zwei-Qubit-Gate-Tiefe dominiert in der Regel das Fehlerverhalten eines Circuits. Wir müssen den transpilierten Circuit betrachten. Moderne Quantencomputer verfügen nicht über eine All-to-all-Konnektivität der Qubits. IBM-Quantencomputer verwenden entweder ein quadratisches Gitter oder ein „Heavy-Hex“-Gitter, was bedeutet, dass Qubits 2, 3 oder 4 nächste Nachbarn haben, mit denen sie direkt über ein einzelnes Zwei-Qubit-Gate gekoppelt werden können. Jede Verschränkung mit anderen, nicht benachbarten Qubits erfordert es, Information mithilfe von Zwei-Qubit-SWAP-Gates auf dem Quantencomputer zu verschieben. Daher erhöht die Transpilierung in der Regel die Zwei-Qubit-Gate-Tiefe. Bei stark verschränkenden Circuits kann dieser Anstieg sehr groß sein.
Schattierte Lichtkegel
Nehmen wir an, ein einzelnes Qubit sei von allen anderen gut isoliert. Ein Fehler auf diesem Qubit verursacht keine Fehler auf anderen Qubits. Wenn jedoch ein Qubit mit einem anderen wechselwirkt, können sich Fehler ausbreiten. Die Art und Weise, wie sich Fehler ausbreiten, hängt davon ab, wie die Qubits wechselwirken. Betrachte den folgenden Circuit. Nimm an, dass alle im Circuit-Diagramm benachbarten Qubits auch auf dem Quantenchip benachbart sind (das heißt, Information muss nicht zu anderen Qubits verschoben werden, um die beschriebenen Wechselwirkungen zu ermöglichen).
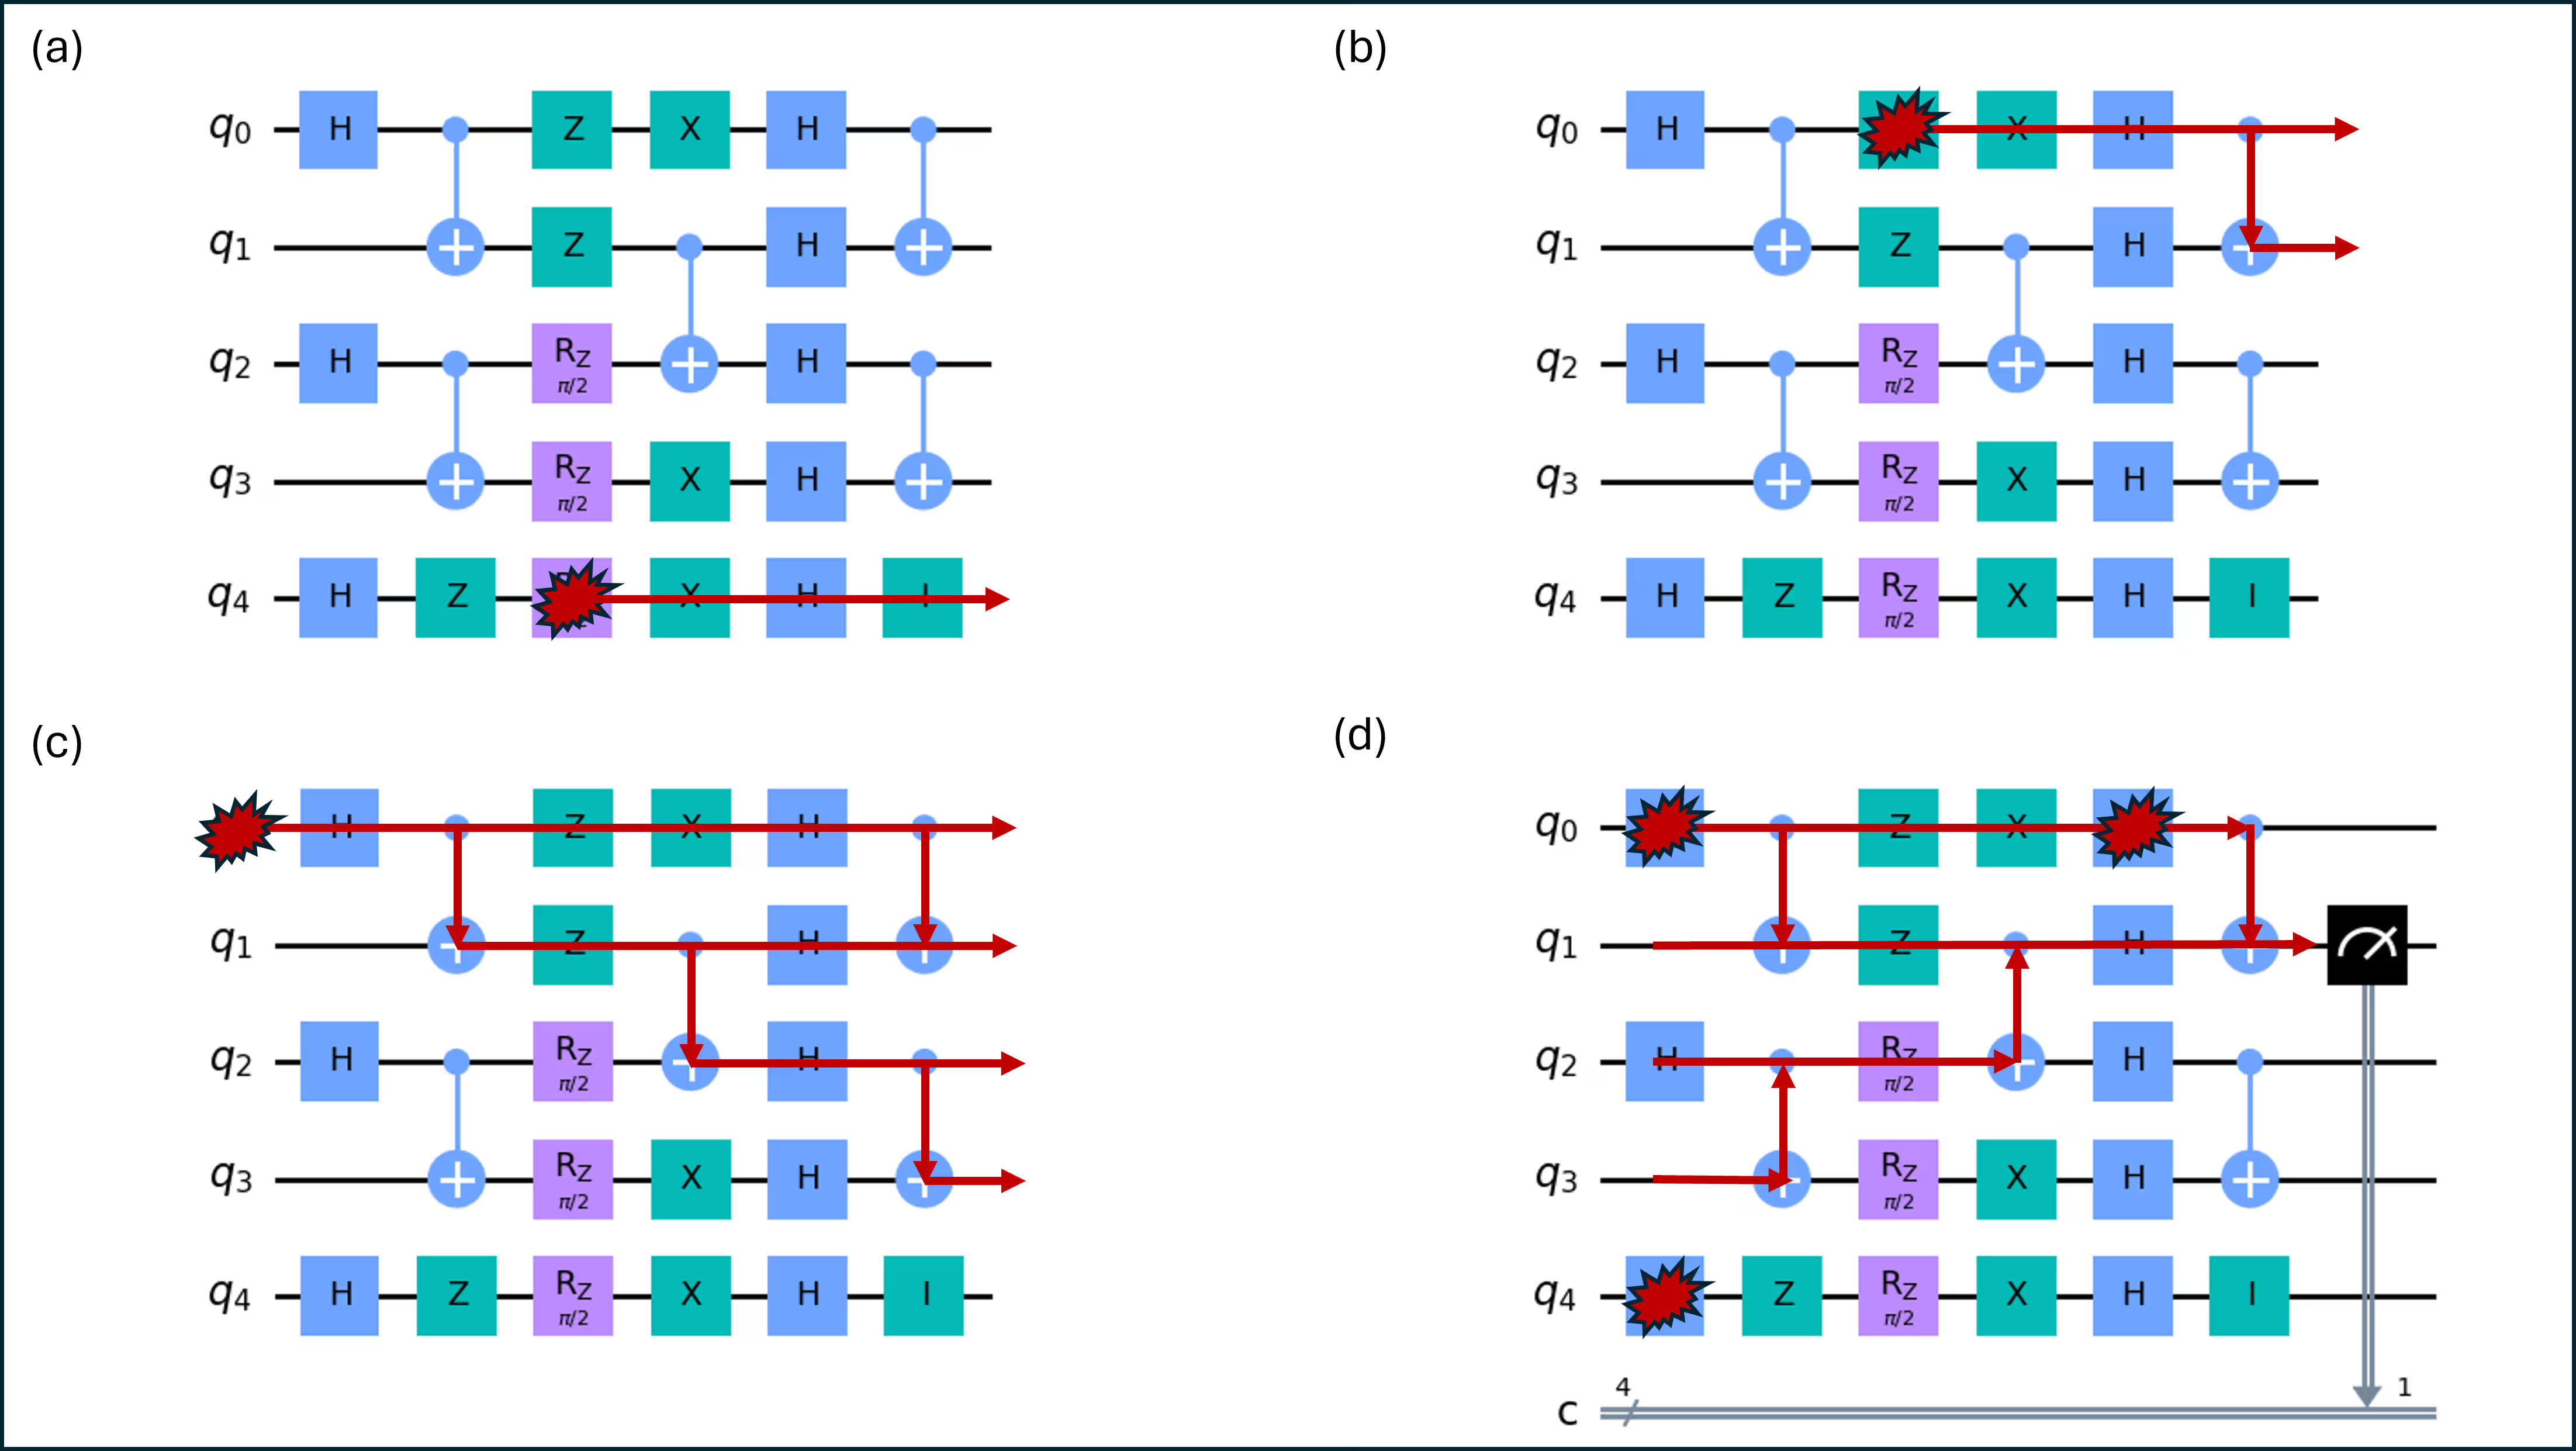
Auch wenn du vielleicht noch nicht so darüber nachgedacht hast: Dies ist eine Art Raumzeitdiagramm. Die vertikale Achse in einem Quanten-Circuit repräsentiert verschiedene, im Raum angeordnete Qubits. Die horizontale Achse repräsentiert die Zeit, über die eine Abfolge von Gates angewendet wird. Wenn wir uns der Sprache der Relativitätstheorie bedienen, repräsentiert ein Lichtkegel den Bereich der Raumzeit, der von einem Punkt aus über kausale Wechselwirkungen erreichbar ist.
In der obigen Abbildung wurde der Fehlertyp nicht spezifiziert. Es stellt sich heraus, dass der Fehlertyp den Lichtkegel beeinflusst, da manche Fehler die Logik eines Zwei-Qubit-Gates beeinflussen und andere nicht. Darauf kommen wir gleich zurück. Betrachte vorerst die gelben Linien als Pfade der potenziellen Ausbreitung eines bestimmten Fehlertyps. Beobachte zum Beispiel in Teil (a) der Abbildung, dass sich ein Einzel-Qubit-Fehler am RZ-Gate von Qubit 4 nur zeitlich vorwärts auf diesem einen Qubit ausbreiten kann. Er kann sich nicht auf andere Qubits ausbreiten, da Qubit 4 mit keinem anderen Qubit verschränkt ist. Dies ist ein guter Zeitpunkt, um festzustellen, dass Qubit 4 in diesem Circuit ziemlich nutzlos ist, und tatsächlich ist der gesamte Circuit nur zu pädagogischen Zwecken aufgebaut.
Ein Fehler am Z-Gate von Qubit 0 (nicht notwendigerweise ein Z-Fehler, sondern einfach irgendein Fehler an dieser Stelle) könnte sich jedoch auf ein anderes Qubit ausbreiten: Qubit 1, über das abschließende CNOT, das Qubit 0 als Kontrolle und Qubit 1 als Ziel verwendet. Dies ist in Teil (b) dargestellt. Wie zu erwarten, hat ein Fehler, der früher im Circuit auftritt, oft die Möglichkeit, sich über mehr Qubits auszubreiten. Teil (c) zeigt, dass sich ein Fehler bei der anfänglichen Zustandspräparation von Qubit 0 auf alle Qubits außer Qubit 4 ausbreiten kann, das isoliert ist.
Dieser Aufbau zeigt, wie sich ein Fehler zeitlich vorwärts ausbreiten kann, um Messungen zu beeinflussen. Man kann aber auch die umgekehrte Frage untersuchen: Welche Teile meines Circuits könnten für eine bestimmte Einzel-Qubit-Messung einen Fehler beigetragen haben? In diesem Fall würde man einfach bei der Messung oder einem anderen interessierenden Punkt beginnen und zeitlich rückwärts durch den Circuit arbeiten, wobei man allen verschränkenden Circuits folgt, wie in Teil (d) gezeigt. Ebenfalls dargestellt sind einige zufällig gewählte Punkte, an denen Fehler auftreten könnten.
In der obigen Abbildung breiten sich Fehler zwischen Qubits über ECR-Gates aus, doch eine ähnliche Betrachtung ließe sich auch auf andere Zwei-Qubit-Gates anwenden. Diese Gates haben eine Kontrolle und ein Ziel. Es ist klar, dass ein Fehler an der Kontrolle die Logik des Gates beeinflussen und somit zu einem Fehler am Ziel führen kann. Aber wie sieht es mit der anderen Richtung aus? Kann sich ein Fehler am Ziel auf das Kontroll-Qubit ausbreiten? Erinnere dich daran, dass die Kopplung zwischen Kontrolle und Ziel bei ECR-Gates nicht rein vom idealen ZX-Typ ist; sie weist auch eine unerwünschte ZZ-Kopplung auf.
Wenn ein Fehler am Ziel mit der ZZ-Kopplung kommutiert, kann er sich nicht auf das Kontroll-Qubit ausbreiten. Das lässt sich anhand der zugrunde liegenden physikalischen Mechanismen erkennen. Ein schneller Weg, dies zu sehen: Wenn ein Fehler mit kommutiert, kann ihre Reihenfolge vertauscht werden, ohne das Ergebnis zu beeinflussen. Wenn jedoch , das unmittelbar vor der -Kopplung auftritt, dasselbe bewirkt wie ein Auftreten nach der -Kopplung, kann es die Kontrolle nicht beeinflussen, da der Fehler im letzteren Fall zeitlich rückwärts wandern müsste. Wenn ein Fehler nicht mit der ZZ-Kopplung kommutiert, könnte er sich tatsächlich vom Ziel zurück zur Kontrolle ausbreiten. Somit könnten sich bei einem ECR-Gate Z-Fehler nicht vom Ziel zur Kontrolle ausbreiten, X- oder Y-Fehler hingegen schon.
Überprüfe dein Verständnis
Betrachte in Teil (d) der obigen Abbildung die vertikalen Linien zwischen den Qubits 0 und 1. Ist es korrekt, dass sich manche Fehler über diese Linien ausbreiten könnten? Auch hier kann es vom Fehlertyp abhängen, was wir bisher noch nicht besprochen haben. Die Frage ist, ob irgendein Fehler existiert, der sich so ausbreiten könnte, wie es durch diese vertikalen Linien dargestellt ist. Erkläre.
Antwort
Ja, das ist korrekt. Beim Zeichnen des Lichtkegels rückwärts von der Messung aus könnte es sich so anfühlen, als würde man behaupten, dass sich etwas vom Ziel zur Kontrolle bewegt. Die Bedeutung des Diagramms ist jedoch tatsächlich, dass sich ein Fehler von der Kontrolle (Qubit 0) zum Ziel (Qubit 1) hätte bewegen können, um einen Fehler am interessierenden Punkt zu verursachen. Wenn deine Intuition ist, dass es vom Fehlertyp abhängt, liegst du absolut richtig. Dies wird im nächsten Abschnitt teilweise behandelt.
Verfolge, ausgehend von einer fehlerfreien Version der Circuits im obigen Diagramm, die potenzielle Ausbreitung eines Fehlers im ersten Hadamard-Gate, das auf Qubit 2 wirkt. Liste alle Qubits auf, die am Ende des Circuits betroffen sein könnten, wenn der Fehler (a) ein Phasen-Flip und (b) ein Bit-Flip ist. Hinweis: Überlege, wie die Information auf jedem Qubit verwendet wird.
Antwort
(a) Qubit 3 könnte betroffen sein, ebenso natürlich Qubit 2 selbst. Sonst niemand! Falls du die Qubits 0 und 1 aufgelistet hast, beachte, dass Qubit 2 das Ziel des ECR ist, das es mit Qubit 1 verschränkt. An Qubit 1 wird bei diesem Gate keine Veränderung vorgenommen. (b) Die Qubits 0-3 könnten betroffen sein. Der Bit-Flip- bzw. X-Typ-Fehler kommutiert nicht mit der ZZ-Kopplung im ECR-Gate und kann sich daher vom Ziel zur Kontrolle ausbreiten.
Fehlerausbreitung
Im vorherigen Abschnitt haben wir die Fehlerausbreitung besprochen, ohne eine formale Definition dafür zu geben. Im Folgenden gilt:
Für einen Fehler , der vor einem Teil der logischen Nutzlast eines Schaltkreises auftritt, bedeutet Fehlerausbreitung, den äquivalenten Operator zu finden, der dasselbe fehlerhafte Ergebnis reproduziert, wenn er nach statt davor angewendet wird.
Die Darstellung der Fehlerausbreitung im vorherigen Abschnitt legte nahe, dass sich Fehler von einem Kontroll-Qubit über ein CNOT-Gate auf ein Ziel-Qubit ausbreiten könnten. Eine Möglichkeit zu prüfen, wann dies zutrifft, besteht darin, einen Fehler an der Kontrolle oder am Ziel vor der Verschränkung zu betrachten und zu prüfen, ob dieser Operator mit dem CNOT-Gate kommutiert. Wenn die beiden Operatoren kommutieren, macht es keinen Unterschied, ob man sie in umgekehrter Reihenfolge anwendet, was bedeutet, dass der Fehler einfach am CNOT „vorbeigeschoben“ werden könnte, ohne andere Qubits zu beeinflussen. Dies ist die gängigste Herangehensweise an die Fehlerausbreitung und führt zu den folgenden Regeln:
Sei Qubit 0 die Kontrolle und Qubit 1 das Ziel. Betrachte X- und Z-Fehler auf dem Kontroll- bzw. Ziel-Qubit (, , bzw. ). Wenn man diese Fehler an einem vorbeischiebt, werden die Fehler zu:
Wir geben das Obige ohne Beweis an. Wenn du jedoch wie der Autor dieser Lektion das Schr"odinger-Bild bevorzugst, kannst du auch beliebige Kontroll- und Zielzustände aufschreiben, den Fehler anwenden, dann das CNOT, und den Endzustand untersuchen. Wenn du diesen Endzustand mit einem fehlerfreien Fall vergleichst, kannst du erkennen, welche nach dem CNOT angewendete Fehlerkombination den fehlerhaften Zustand ergeben würde, und insbesondere kannst du sehen, ob sich die Fehleroperation von einem Qubit auf das andere ausgebreitet hat.
| Kontrolle anfänglich | Ziel anfänglich | Fehler | Endzustand | Fehleräquivalent nach CNOT |
|---|---|---|---|---|
| Keiner | Nicht zutreffend | |||
| X auf Kontrolle | ||||
| Z auf Kontrolle | ||||
| X auf Ziel | ||||
| Z auf Ziel |
Vielleicht überraschend: Ein Z-Fehler am Ziel breitet sich tatsächlich zurück zur Kontrolle aus!
Wie du dir vorstellen kannst, ist es kompliziert, eine solche Ausbreitung von Fehleroperatoren vorwärts durch Circuits zu verfolgen (oder äquivalent dazu die zu messenden Operatoren rückwärts zu propagieren). Qiskit bietet Werkzeuge, die dies erleichtern, die wir in Lektion 6 über moderne Workflows kennenlernen.
Es gibt ein Qiskit-Addon namens Shaded Lightcones. Das Shaded-Lightcones-(SLC)-Addon analysiert die Fehlerausbreitung in Quanten-Circuits, indem es Pauli-Propagation nutzt, um zu ermitteln, welche Teile eines Circuits tatsächlich eine Zielobservable beeinflussen können. Es wurde in erster Linie entwickelt, um Fehlerminderung effizienter zu machen, insbesondere für probabilistische Fehlerauslöschungs-(PEC)-Workflows. Wir werden dieses Werkzeug hier nur kurz erkunden und es in zukünftigen Lektionen im Kontext von Fehlerminderungstechniken umfassender nutzen. Es verwendet Pauli-Operator-Propagation, um die Ausbreitung von Fehlern unterschiedlicher Typen darzustellen und erzeugt dabei einen Lichtkegel für Fehler vom Typ X, Y und Z.
Shaded Lightcones (SLC) gehen noch weiter, indem sie klassische Simulationen nutzen, um die Empfindlichkeit gegenüber Fehlern im gesamten Circuit enger einzugrenzen. Dies tauscht etwas QPU-Zeit gegen CPU-Zeit und reduziert den Sampling-Overhead, der zur Renormierung des Bias benötigt wird. Anstelle eines harten Cutoffs wird jedem potenziellen Fehler im Circuit eine abgestufte „Shade“ zugewiesen, die die Anfälligkeit der Observable gegenüber diesem Fehler nach oben begrenzt. Diese verfeinerte Charakterisierung ermöglicht effizientere, gezieltere Anwendungen von PEC mit reduzierter Varianz und gibt dem Nutzer gleichzeitig die Möglichkeit, den Bias bei der Observable-Schätzung kontrolliert einzustellen. Weitere Details findest du unter Lightcone shading for classically accelerated quantum error mitigation.
Wir werden hier keinen vollständigen Workflow vorstellen. Wir zeigen lediglich schematisch, wie dieser Workflow einen Circuit verarbeitet:

Der Workflow unterteilt den Circuit in „Boxen“, die nützlich sind, um das Rauschverhalten zu erlernen:

Abschließend nutzt er Operatorpropagation und Noise Learning, um eine schattierte Karte der Fehleranfälligkeit im gesamten Circuit zu erstellen:
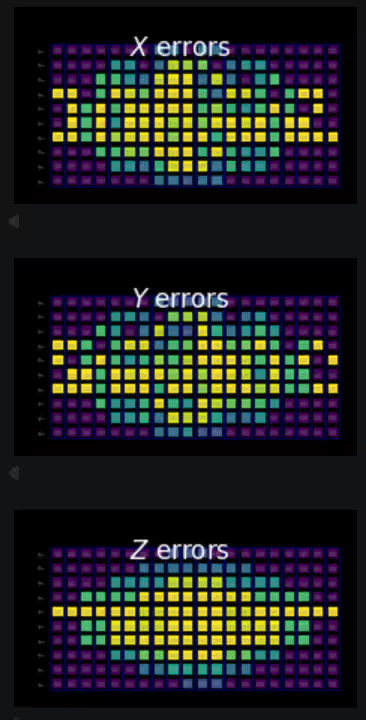
Jede farbige Box in der Ausgabe entspricht einem bestimmten Qubit zu einem bestimmten Zeitpunkt. Die dunkelsten (violetten) Boxen kennzeichnen ein Qubit und eine Schicht, bei denen sich ein Fehler nicht auf die betrachtete(n) Messung(en) auswirken kann. Die hellsten (gelben) Boxen entsprechen einem Qubit und einer Schicht, bei denen ein Fehler einen starken Einfluss auf die betrachtete(n) Messung(en) haben kann.
Beachte die violetten Bereiche auf der rechten Seite jeder Karte. Ein Fehler in derselben Schicht wie die Messung, aber auf einem anderen Qubit, kann die Messung aufgrund der gezeigten Circuit-Konnektivität nicht beeinflussen. Ebenso kann sich ein Fehler eine Schicht zurück in der Zeit (eine Schicht weiter links) im nächsten Schritt nur auf das benachbarte Qubit auswirken, und zwar aufgrund der Struktur der verschränkenden Schicht, und so weiter. Die Kegelform auf der rechten Seite ist daher allgemein üblich, wann immer relativ wenige Qubits an der betrachteten Messung beteiligt sind.
Überprüfe dein Verständnis
Denkst du, es ist besser, eine Shaded-Lightcone-Karte vor oder nach der Transpilation zu erstellen? Warum?
Antwort
Es muss nach der Transpilation erfolgen. Damit diese verschiedenen Karten nützlich sind, müssen wir sicherstellen, dass die benachbarten Qubits in unserem Circuit auch benachbarten Qubits auf unserem Quantenchip entsprechen. Andernfalls würden verschränkende Gates, die im Circuit-Diagramm als auf benachbarte Qubits wirkend dargestellt sind, letztlich SWAP-Gates und eine kompliziertere Circuit-Struktur erfordern.