Fehlerunterdrückung und -formgebung
Fehlerunterdrückung kann sich auf jede Technik beziehen, die bestimmte Arten von Rauschen und Fehlern antizipiert und zu vermeiden versucht. Dies lässt sich am einfachsten anhand konkreter Beispiele erklären, aber man sollte bedenken, dass diese Methoden nicht auf die hier gezeigten Beispiele beschränkt sind und ständig neue Methoden erforscht werden. Manchmal ist es nicht möglich, Fehler zu unterdrücken, aber es ist möglich, zu beeinflussen, wie sie sich akkumulieren. Wenn wir Fehler langsamer akkumulieren lassen können, könnten wir dies als Unterdrückung des Gesamtfehlers beschreiben, aber es ist genauer als Rauschformgebung zu betrachten. In dieser Lektion behandeln wir kanonische Beispiele der Fehlerunterdrückung (dynamische Entkopplung) und der Rauschformgebung (Pauli-Twirling).
Ein Video zu dieser Lektion wird in den nächsten Tagen veröffentlicht und hier eingebettet.
Dynamische Entkopplung
Beginnen wir mit einem sehr einfachen Zustand auf einem einzelnen Qubit und führen ein einfaches Rauschmodell ein. Dies reicht nicht aus, um dynamische Entkopplung vollständig zu erklären, gibt uns aber ein klares Beispiel. Angenommen, wir haben ein Qubit, das mithilfe eines Hadamard-Gates in einem Superpositionszustand präpariert wurde:
Dieser Zustand wird auf der Bloch-Kugel wie unten links dargestellt visualisiert. Im Idealfall ohne Rauschen würde dieses Qubit in diesem Zustand verbleiben, bis die nächste Operation ausgeführt wird. Wir wissen jedoch aus der vorherigen Lektion, dass dies nicht das ist, was wir beobachten. Rauschen führt dazu, dass die Quanteninformation degradiert.
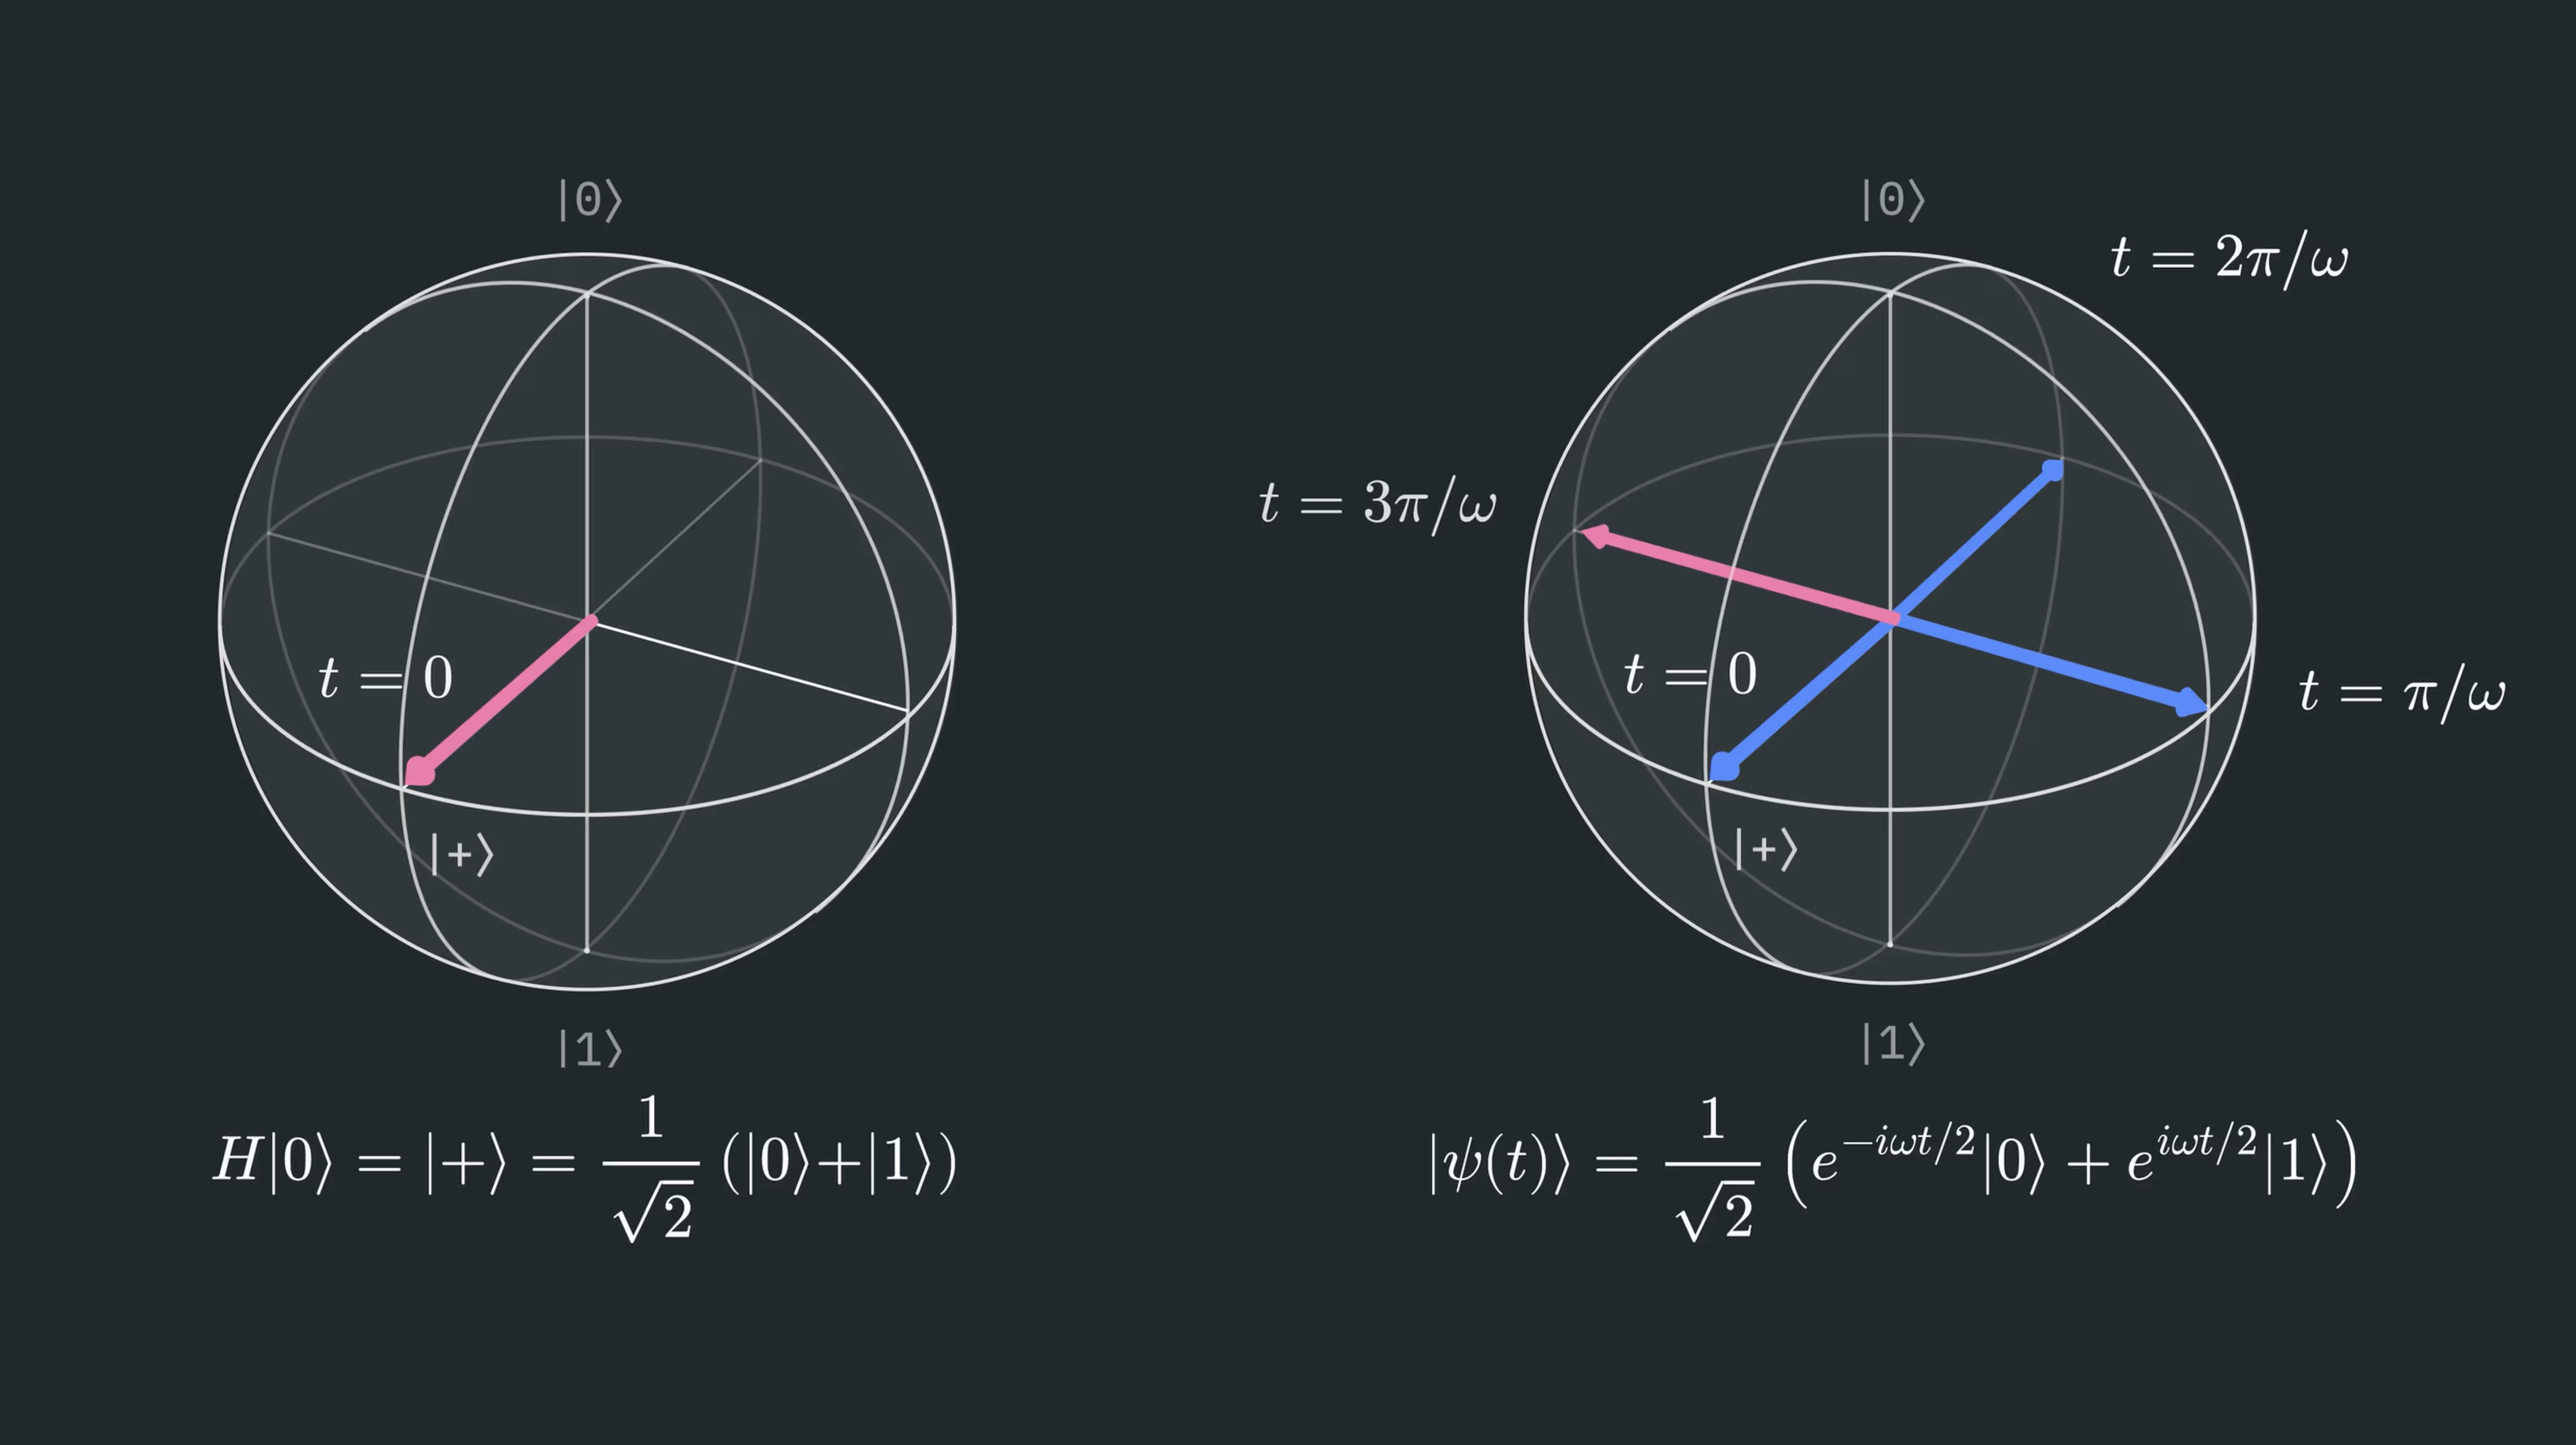
Rauschen oder Kopplung an die Umgebung kann dazu führen, dass sich die relative Phase zwischen den Basiszuständen ändert. Das heißt, die Wahrscheinlichkeiten von und ändern sich nicht, da sich die Absolutwerte ihrer Koeffizienten nicht ändern. Vielmehr ändern sich die Phasen der Amplituden, wodurch sich ihre Real- und Imaginärteile ändern. Um diese Diskussion konkreter zu machen, betrachten wir eine Art von Wechselwirkung, die dies verursachen kann: die Kopplung an ein Magnetfeld, das in Z-Richtung ausgerichtet ist: .
Betrachten wir, was mit dem Zustand passiert, wenn Zeit vergeht:
Hier haben wir die Tatsache genutzt, dass ein Magnetfeld in Z-Richtung eine Präzession um die Z-Achse mit einer Frequenz verursacht, die vom effektiven magnetischen Moment und der Magnetfeldstärke abhängt. Die Details sind weniger wichtig als die Tatsache, dass diese Wechselwirkung eine Entwicklung um die Z-Achse verursacht, was zu entgegengesetzter Phasenakkumulation für die beiden Rechenbasiszustände führt. Wenden wir diesen Operator auf jeden Term in an, erhalten wir Folgendes:
Diese zeitabhängige Phase entspricht der Präzession um die Z-Achse in der Bloch-Kugel-Darstellung. Dies wird in der rechten Hälfte der obigen Abbildung gezeigt.
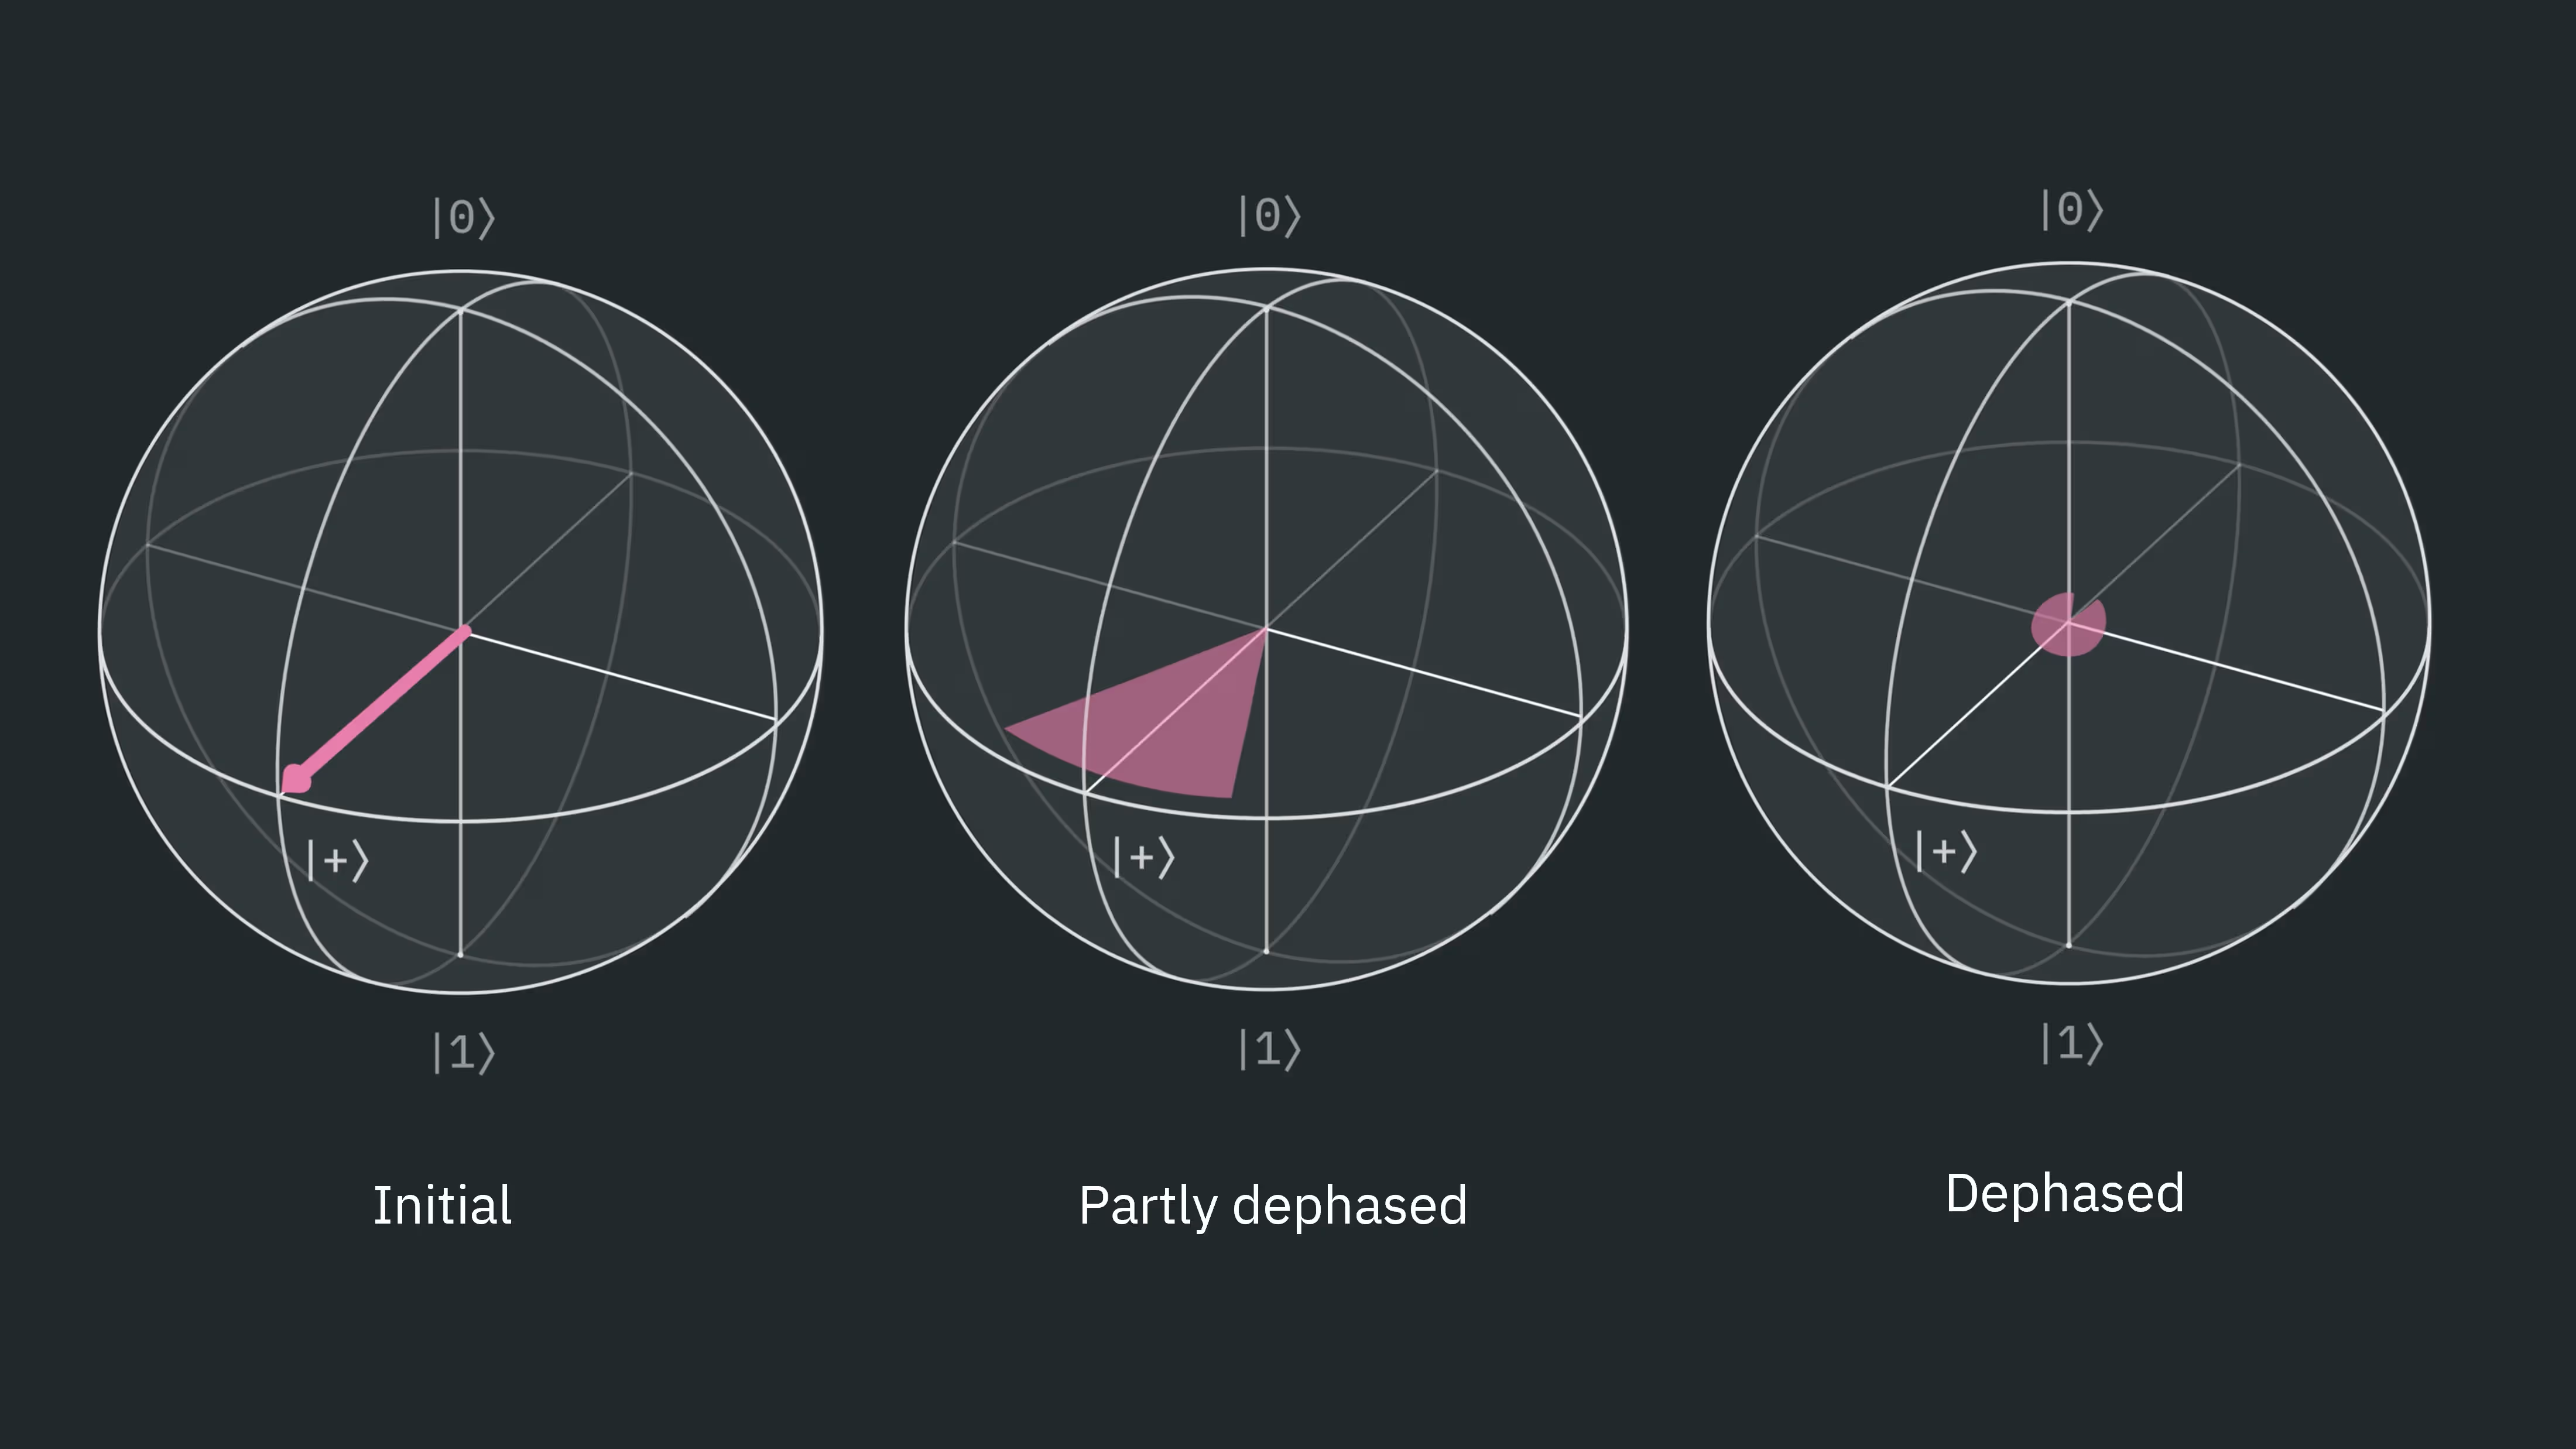
Wenn wir wüssten, dass diese Wechselwirkung auf kontrollierte Weise stattfindet, könnten wir sie vorhersagen. Um diese Art von Rauschen zu modellieren, betrachten wir stattdessen eine Verteilung möglicher Magnetfeldstärken, die jeweils mit einer bestimmten klassischen Wahrscheinlichkeit auftreten (andere Rauschquellen müssten anders modelliert werden). Wir müssen berücksichtigen, was passiert, wenn es eine nicht-null klassische Wahrscheinlichkeit gibt, dass der Zustand überhaupt nicht rotiert wurde, und auch eine gewisse Wahrscheinlichkeit, dass er um einen kleinen Betrag oder sogar um einen großen Betrag rotiert wurde. Diese Verteilung möglicher Rotationen ist der Grund für die Verbreiterung des Zustands in der Bloch-Kugel-Darstellung unten. Wenn mehr solches Dephasierungsrauschen vorliegt, wird die Phase weniger gut definiert sein. Im Grenzfall starker Dephasierung wird das Qubit vollständig dephasiert, was dem Verlust der im Zustand gespeicherten Quantenkohärenz entspricht.
Natürlich haben wir in einem Experiment keine Ahnung, welche zufällige Kopplung auftreten wird. Was können wir dagegen tun?
Angenommen, die Umgebungskopplung bleibt über ein Zeitintervall ungefähr konstant. Betrachten wir, was passieren würde, wenn wir dieser Vorschrift folgen würden:
-
Lasse die Phase für die Zeit ändern
-
Wende ein X-Gate auf das Qubit an
-
Lasse die gleiche Umgebungskopplung für eine weitere Zeit auftreten
-
Wende ein zweites X-Gate an
Nach der anfänglichen Zeitentwicklung hätten wir genau den obigen Zustand. Wenn wir das erste X-Gate anwenden, erhalten wir:
Wenn nun das zweite Intervall von vergeht, findet dieselbe Wechselwirkung statt. Aber nun sind die Amplituden mit den entgegengesetzten Z-Eigenzuständen verknüpft, was bedeutet, dass sich das Vorzeichen der Rotation um die Z-Achse umgekehrt hat. Nachdem das System sich für eine weitere Zeit entwickelt hat, haben wir den Zustand:
Und durch Einsetzen von erhalten wir:
Das Anwenden des letzten X-Gates bewirkt in diesem Fall nichts, ist aber im Allgemeinen notwendig:
Wir haben den ursprünglichen Quantenzustand einschließlich seiner relativen Phase wiederhergestellt. Dieser Prozess ist ein besonders einfaches Beispiel für dynamische Entkopplung.
Allgemeiner gesagt beinhaltet dynamische Entkopplung (DD) das Einfügen einiger Einzel-Qubit-Gates, um die Auswirkung von Wechselwirkungen mit Systemen außerhalb des Qubits zu reduzieren (es von der Umgebung zu entkoppeln). Die vollständige Refokussierung aller möglichen Phasenverläufe zurück zum ursprünglichen Zustand, wie oben gezeigt, ist etwas idealisiert, aber dennoch ein mögliches Szenario. Besprechen wir, wann DD nützlich ist und welche Einschränkungen bestehen.
Überprüfe dein Verständnis
Im obigen Text haben wir die Auswirkung einer XX-DD-Sequenz auf den Anfangszustand Schritt für Schritt durchgegangen. Überprüfe, ob dieselben Schritte oben auch den Zustand unter denselben Annahmen eines sich langsam ändernden Magnetfelds entlang der z-Richtung in seinen Ausgangszustand zurückversetzen.
Antwort
Nach der anfänglichen Zeitentwicklung hätten wir genau den obigen Zustand. Wenn wir das erste X-Gate anwenden, erhalten wir:
Wenn nun das zweite Intervall von vergeht, findet dieselbe Wechselwirkung statt. Aber nun sind die Amplituden mit den entgegengesetzten Z-Eigenzuständen verknüpft, was bedeutet, dass sich das Vorzeichen der Rotation um die Z-Achse umgekehrt hat. Nachdem das System sich für eine weitere Zeit entwickelt hat, haben wir den Zustand:
Und durch Einsetzen von erhalten wir
Wenn wir das letzte X-Gate anwenden, erhalten wir:
Wann DD verwenden
Die erste und offensichtlichste Einschränkung ist, dass wir in unserer Behandlung einen rein dephasierenden Kanal angenommen haben. Wechselwirkungen in der realen Welt erzeugen typischerweise eine Mischung aus Dephasierung und anderen Fehlermechanismen. In der obigen Behandlung haben wir uns entschieden, speziell X-Gates anzuwenden. Dies wird in der dynamischen Entkopplung als XX-Sequenz bezeichnet. Diese besondere Sequenz eignet sich für rein dephasierende Fehler. Aber es gibt andere Sequenzen, die breiter anwendbar sein könnten, wie XY4 (im untenstehenden Schaltkreisdiagramm gezeigt) und das komplexere XY8.

Eine weitere Einschränkung ist, dass dynamische Entkopplung Einzel-Qubit-Gates hinzufügt, die aufgrund von Gate-Unvollkommenheiten oder sogar Crosstalk zusätzliche Einzel-Qubit-Fehler hinzufügen können. Diese Einzel-Qubit-Fehlerraten sind typischerweise viel niedriger als Mehr-Qubit-Gate-Fehler, sodass dies normalerweise kein größeres Problem darstellt, aber es ist etwas, das man im Hinterkopf behalten sollte, wenn viele Qubits DD im gesamten Schaltkreis mehrfach einsetzen.
DD ist nützlich, wenn die externe Kopplung genug Zeit hat, um den Zustand des Qubits zu beeinflussen. Da Qubits mühsam gut isoliert sind und externe Kopplungen schwach sein sollten, ist diese Art von Rauschen am deutlichsten bemerkbar, wenn ein Qubit über lange Zeiträume untätig bleibt. Bei kurzen Leerlaufzeiten könnte die Wirkung von DD darin bestehen, Einzel-Qubit-Gate-Fehler hinzuzufügen, während nur sehr wenig Rauschen unterdrückt wird; die Fidelität deines Schaltkreises könnte tatsächlich verringert werden.
Wichtige Erkenntnis: Verwende dynamische Entkopplung, wenn Qubits ausreichend lange untätig bleiben, und achte auf die Art der verwendeten DD-Sequenz.
Dynamische Entkopplung mit Qiskit
Untersuchen wir die Verwendung von DD, indem wir den Fall mehrerer Qubits betrachten, die im Zustand präpariert werden und dann für lange Zeit untätig bleiben. In Abwesenheit von Fehlern sollte die Präparation des Mehr-Qubit-Zustands und die anschließende Anwendung eines Hadamard-Gates vor der Messung (wodurch in der X-Basis gemessen wird) immer 0 ergeben. Mit Rauschen wird das Messergebnis nur einen Bruchteil der Zeit 0 sein, anstatt mit 100%iger Wahrscheinlichkeit. Wir berechnen den durchschnittlichen X-Erwartungswert über mehrere Qubits. Das heißt, wir interessieren uns für Folgendes:
wobei mit dem X-Operator an der -ten Position von rechts, und der Zustand des gesamten Systems ist.
Dieser Schaltkreis enthält absichtliche Verzögerungen, was für einen Benchmark etwas konstruiert ist. Es ist jedoch sehr üblich, dass reale Schaltkreise Qubits enthalten, die während eines Teils der Ausführung untätig bleiben. Man kann sich dies als vereinfachtes Modell eines komplexeren Schaltkreises vorstellen, bei dem einige Qubits während eines Teils der Berechnung untätig bleiben. Diese Art von Benchmarking, basierend auf der Entwicklung von -Zuständen, wird oft als Ramsey-Benchmarking bezeichnet.
Wir beginnen mit dem Laden der notwendigen Pakete und der Konfiguration des Dienstes.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Nun definieren wir einige Hilfsfunktionen. Zunächst wollen wir den Punkt bezüglich langer Leerlaufzeiten ansprechen. Was genau bedeutet "lang" in diesem Zusammenhang? Wir könnten die Leerlaufzeit einfach in Mikrosekunden angeben. Es ist jedoch nützlich zu wissen, wie viele Zwei-Qubit-Gates während desselben Intervalls ausgeführt werden könnten. Dies macht die Leerlaufzeiten direkter aussagekräftig für die Schaltkreistiefe, die während desselben Zeitraums hätte ausgeführt werden können. Die erste Hilfsfunktion holt das dem Backend native Zwei-Qubit-Gate und bestimmt die Dauer dieses Gates.
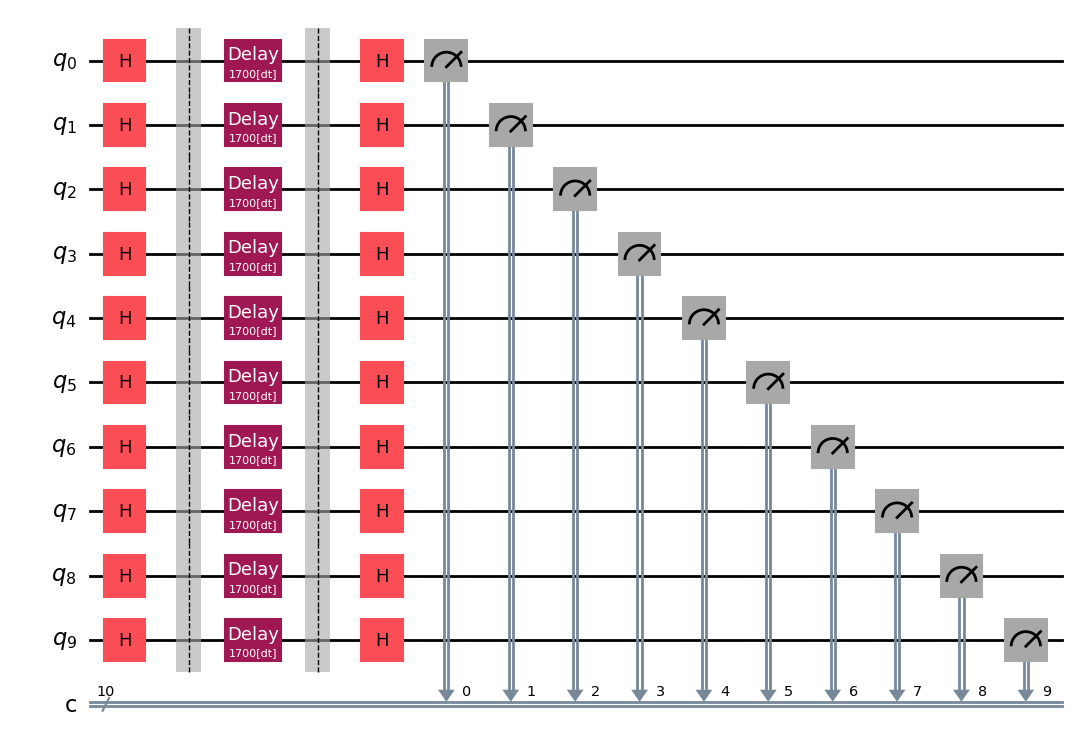
Die zweite Funktion erstellt einfach einen Ramsey-Schaltkreis (einen mit Qubits im Zustand ), implementiert eine Verzögerung, rotiert mit einem H-Gate und misst dann. Erinnere dich daran, dass ein Hadamard-Gate (H) auf abbildet, sodass die Messung von in der Z-Basis nach dem Hadamard-Gate dem entspricht, dass sich das Qubit unmittelbar vor dem Hadamard-Gate in befand.
Unsere letzte Funktion konvertiert die rohen Zählungen der Messergebnisse 0 und 1 in einen Erwartungswert von X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Nun spezifizieren wir die Details unseres Tests, einschließlich der Anzahl der Qubits und der in DD zu verwendenden Gate-Sequenz (in diesem Fall XX). Beachte besonders, dass wir das Optimierungslevel auf null setzen. In der Praxis würdest du oft ein höheres Optimierungslevel wählen; hier verwenden wir Level 0, um sicherzustellen, dass die Auswirkungen der von DD adressierten Fehler sichtbar bleiben. Schließlich bestimmen wir die charakteristische Zeit für Zwei-Qubit-Gates auf diesem Backend und geben einige relevante Zeiten aus.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Nun konstruieren wir unsere Schaltkreise und transpilieren sie für unser gewähltes Backend.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Wir sollten mindestens einen Schaltkreis visualisieren, um sicherzustellen, dass wir unseren Schaltkreis mit den gewünschten Zuständen und Verzögerungen kodiert haben. Es könnte einfacher sein, den nicht transpilierten Schaltkreis qc zu visualisieren, oder du überprüfst den transpilierten qc_isa.
qc.draw("mpl")
Ausführen
Wir sind endlich bereit, auf Hardware auszuführen. Wir verwenden Sampler, um viele Messungen jedes Qubits zu erhalten, und wir werden es zweimal verwenden: einmal mit explizit ausgeschaltetem DD, und einmal mit eingeschaltetem DD unter Verwendung der XX-Gate-Sequenz.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Wir können die Zählungen aus den verschiedenen Schaltkreisen extrahieren.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Nachbearbeitung
Wir haben nun die Zählungen aus der Messung, aber wir wollen diese in den Erwartungswert von X umwandeln und dann diese Erwartungswerte über alle von uns verwendeten Qubits mitteln, um etwas über die Erhaltung der Phaseninformation zu erfahren. Dafür verwenden wir unsere zuvor definierte Funktion counts_to_x_expectations.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Zum Schluss plotten wir unsere Ergebnisse.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
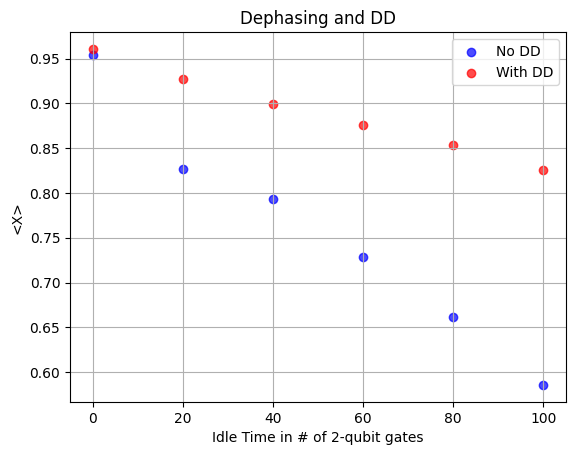
Wie du sehen kannst, liegen die Erwartungswerte ohne explizite Verzögerung tatsächlich nahe bei 1, was wir erwarten würden, wenn die gesamte Phaseninformation erhalten bliebe. Wenn die gesamte Phaseninformation verloren ginge, gäbe es keine Präferenz dafür, dass die letzte Rotation statt erzeugt, und der durchschnittliche Erwartungswert würde sich Null annähern. In den Daten sehen wir, dass der durchschnittliche Erwartungswert von X mit zunehmenden Verzögerungszeiten abnimmt und sich Null annähert. Beachte, dass DD hier sehr effektiv war; die Erwartungswerte mit DD sind typischerweise mehr als 20% besser (näher an 1) als die Werte ohne DD. Beachte aber auch, dass der erste verzögerte Datenpunkt einer Verzögerung entspricht, die ungefähr 100 Zwei-Qubit-Gate-Operationen entspricht. Dies unterstreicht erneut den Punkt, dass DD am nützlichsten ist, wenn Qubits für relativ lange Zeiträume untätig bleiben.
Überprüfe dein Verständnis
Wenn wir DD mit XY4 auf denselben Schaltkreis wie zuvor anwenden, erwartest du dann, dass dies Ergebnisse liefert, die viel besser, viel schlechter oder ungefähr gleich sind wie DD mit XX? Erkläre.
Antwort
Ungefähr gleich, vielleicht etwas schlechter. Der von uns verwendete Schaltkreis hatte Zustände, die in die XY-Ebene rotiert wurden. Dieser Zustand speichert Information hauptsächlich in seiner Phase, was ihn besonders empfindlich gegenüber Dephasierungsfehlern statt T1-Relaxation macht. XY4 könnte bei einer größeren Vielfalt von Fehlern helfen, aber XX ist bereits optimiert, um dem von uns verwendeten Schaltkreis zu helfen. XY4 könnte genauso gut sein, würde aber nichts Wesentliches hinzufügen, oder die Tatsache, dass XY4 mehr Gates enthält, könnte zusätzliche Gate-Fehler zulassen, die die Ergebnisse etwas schlechter machen.
Das letzte Ergebnis verwendete die einfachste DD-Gate-Sequenz XX. Sehen wir uns an, wie man eine komplexere Sequenz, XY4, implementiert. Wir definieren im nächsten Abschnitt einen Sampler.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
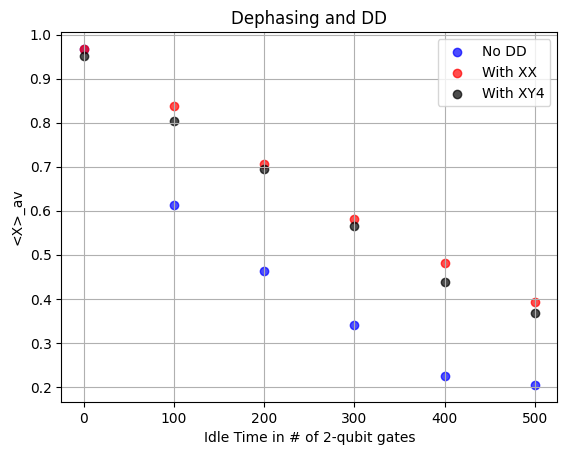
Hier sehen wir, dass sich XY4 nicht nennenswert von XX unterscheidet. Es könnte aufgrund zusätzlicher Gates in der XY4-Sequenz sehr geringfügig schlechter sein, aber wichtiger ist, dass wir bereits erklärt haben, warum XX die gewünschte Wirkung hätte, um die Phase speziell für einen Zustand wie zu erhalten. Es gibt keinen Grund anzunehmen, dass für einen solchen Anfangszustand eine andere Sequenz die Ergebnisse verbessern würde.
Überprüfe dein Verständnis
Überprüfe, dass die XY4-Sequenz den Zustand bis auf eine globale Phase unverändert lässt.
Antwort
Pauli-Twirling
Wir sollten zunächst anmerken, dass Pauli-Twirling oft nicht als Fehlerunterdrückungstechnik verwendet wird, sondern als Fehlerformgebungstechnik: Es lässt Rauschen/Fehler sich anders verhalten, manchmal vorhersehbarer, um andere Methoden zu ermöglichen. Obwohl Pauli-Twirling Fehler nicht verhindert, könnte es ihre kohärente Akkumulation verhindern.
In einem Quantenschaltkreis addieren sich mehrere verschiedene Fehlerquellen. Die Fehler können sich auf unterschiedliche Weise addieren, insbesondere kohärent und inkohärent. Kohärente Akkumulation von Fehlern bedeutet, dass Rauschen oder unvollkommene Implementierungen dazu neigen, Fehler über mehrere Schichten und Gates hinweg in dieselbe Richtung zu treiben. Ein Beispiel wäre kohärente Überrotation bei der Anwendung eines Rotations-Gates.
Betrachte ein ideales Rotations-Gate, wie , das um die X-Achse um genau rotiert. Natürlich ist die Gate-Implementierung nicht perfekt, und die tatsächliche Rotation könnte für eine Implementierung sein, und es könnte sogar der Fall sein, dass immer dasselbe Vorzeichen hat und möglicherweise über viele Anwendungen von hinweg ähnlich in der Größe ist. Somit kann die wiederholte Anwendung von Rotations-Gates zu kohärenter Akkumulation dieser vielen Über- (oder Unter-)Rotationen führen.
Inkohärente Fehlerakkumulation ist genau das Gegenteil: Fehler in zufälligen Richtungen mit zufälligen Vorzeichen, sodass Fehler in verschiedenen Schichten nicht immer additiv interferieren, sondern sich manchmal aufheben oder quadratisch addieren. Inkohärente Fehler akkumulieren offensichtlich langsamer in Bezug auf die Gesamtwirkung auf den Zustand des Qubits. Ein vereinfachtes Diagramm dazu ist in der Abbildung unten gezeigt. Dies ist eine Vereinfachung. Reale Quantenfehler sind nicht auf einen zweidimensionalen kartesischen Raum beschränkt; nicht alle Fehlerbeiträge haben dieselbe Größenordnung, und es gibt weitere Komplexitäten. Aber die Intuition eines solchen Bildes ist nützlich: Kohärente Fehler neigen dazu, schneller zu akkumulieren als inkohärente.
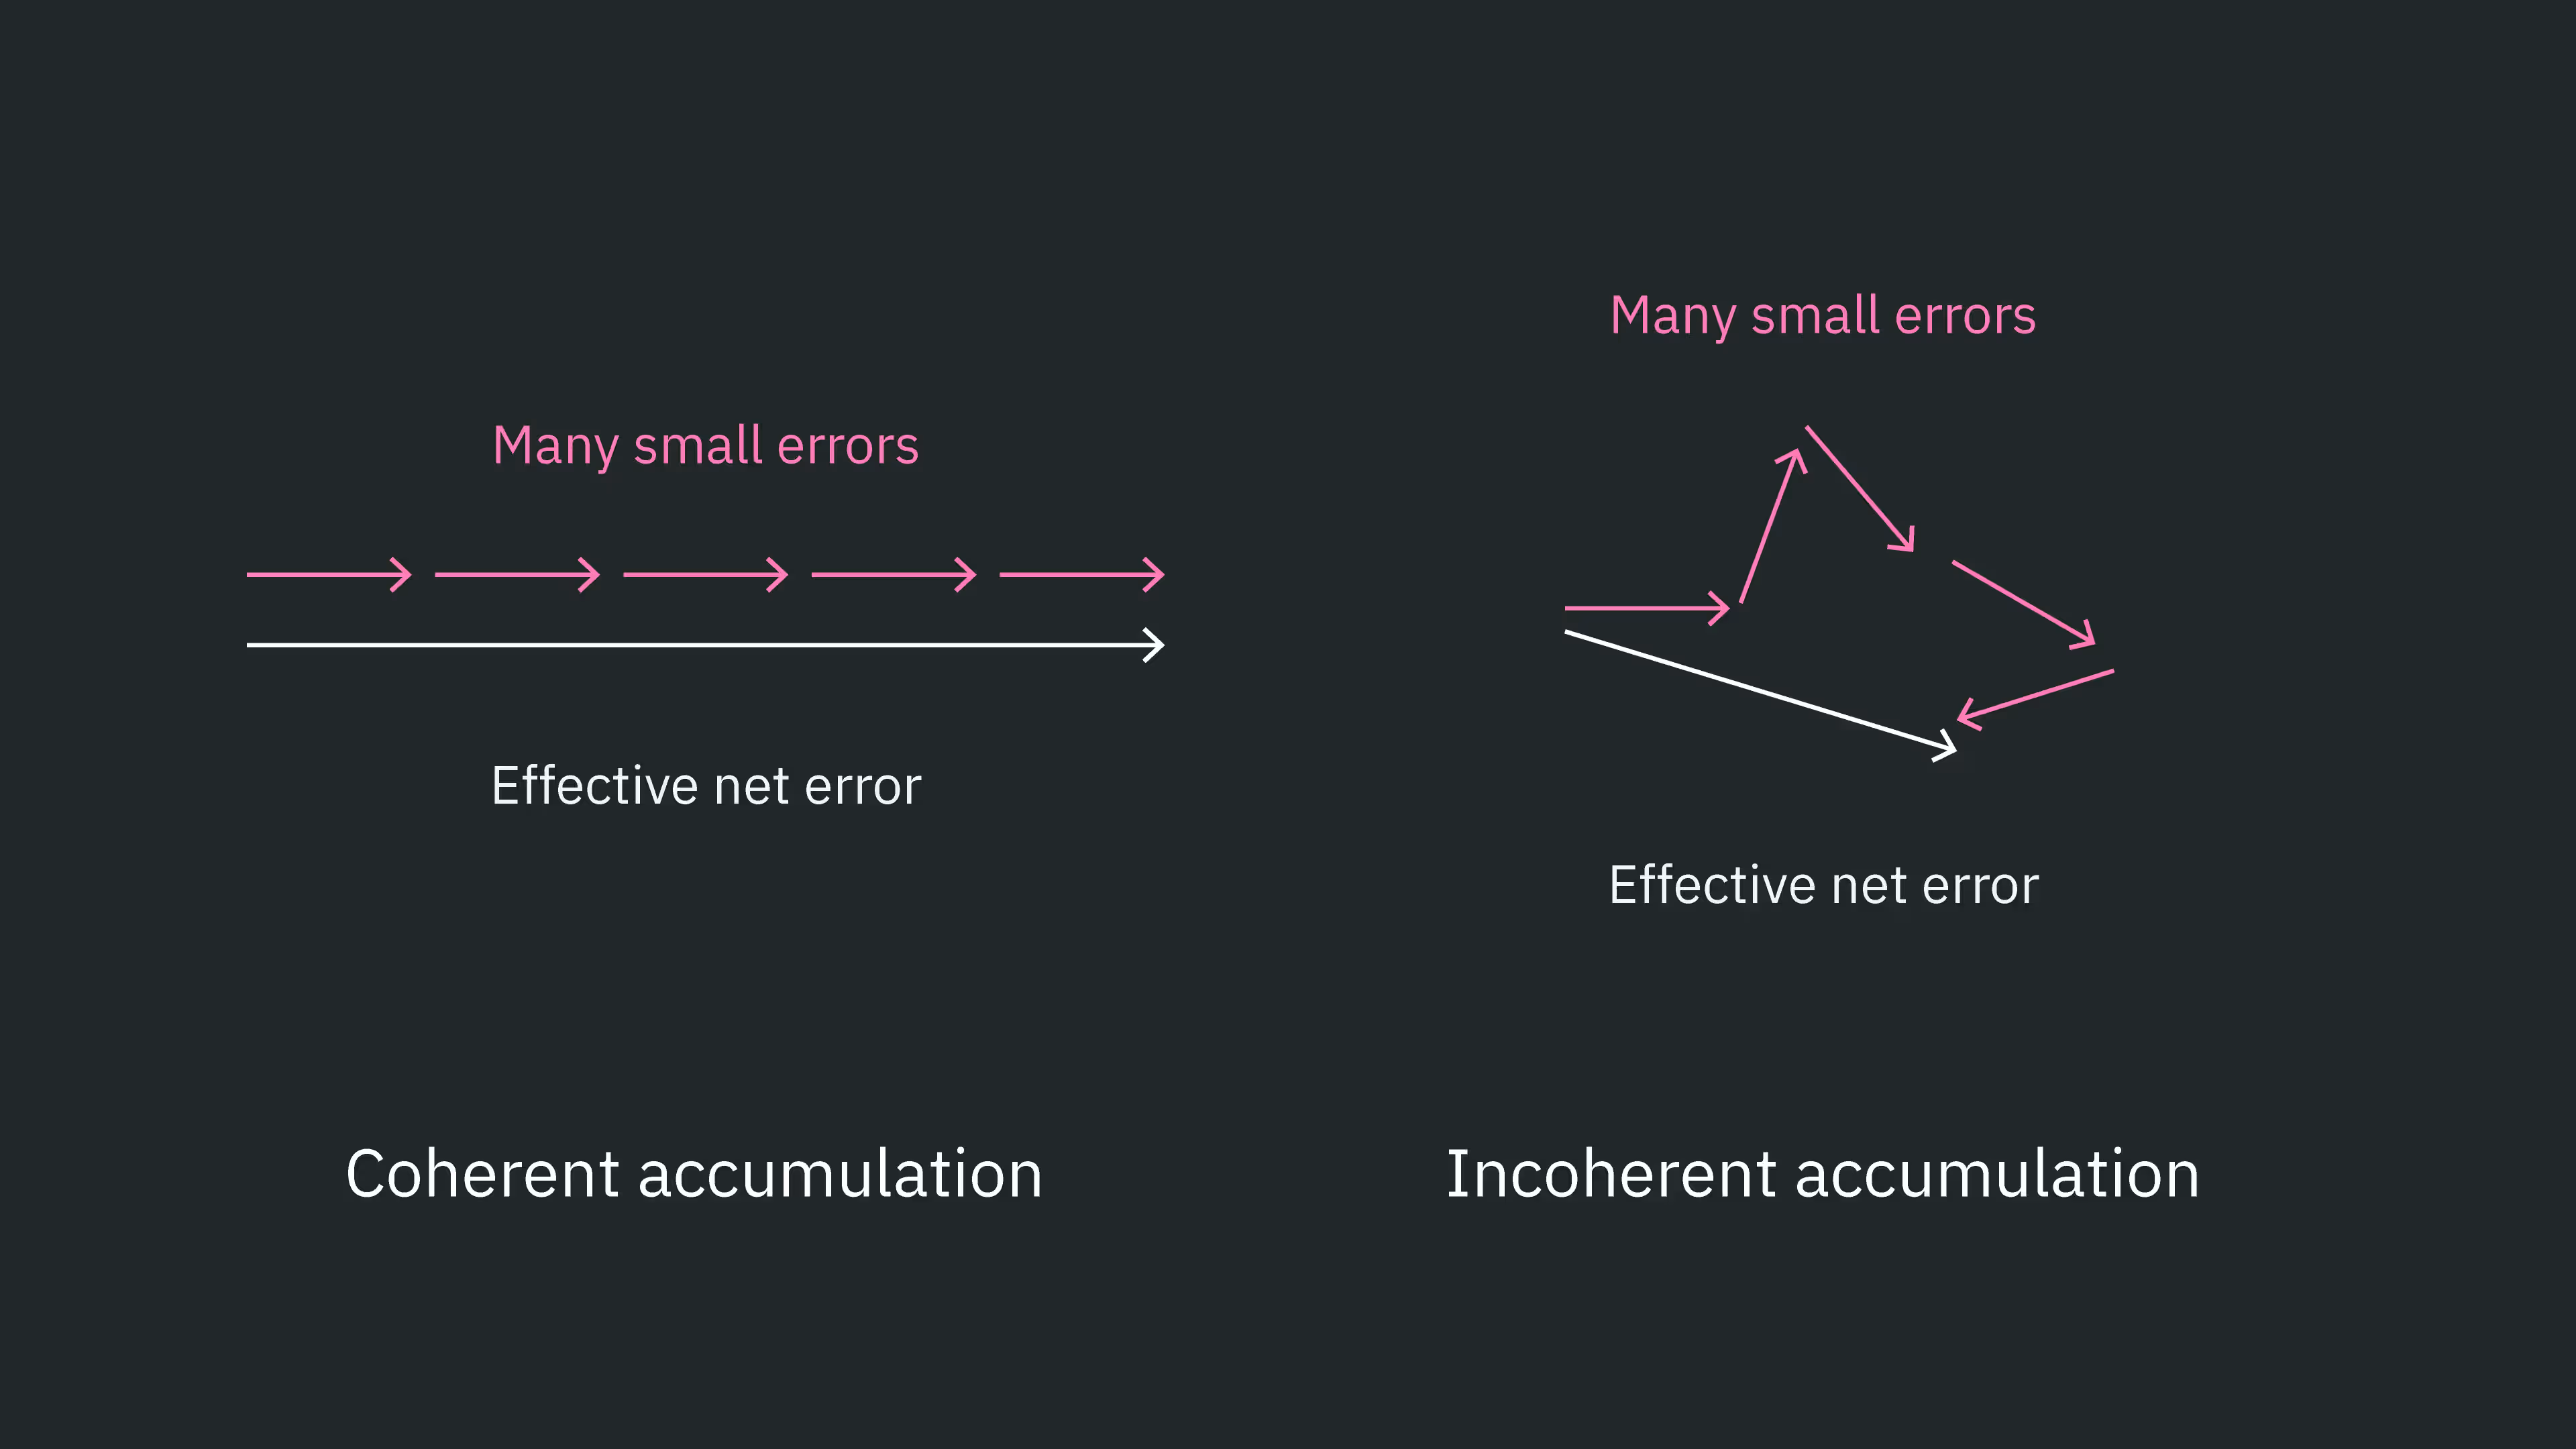
Man kann oft Ergebnisse mit höherer Fidelität erhalten, indem man kohärente Fehlerakkumulation in inkohärente Fehlerakkumulation umwandelt. Eine primäre Möglichkeit, dies zu erreichen, wird Pauli-Twirling genannt.
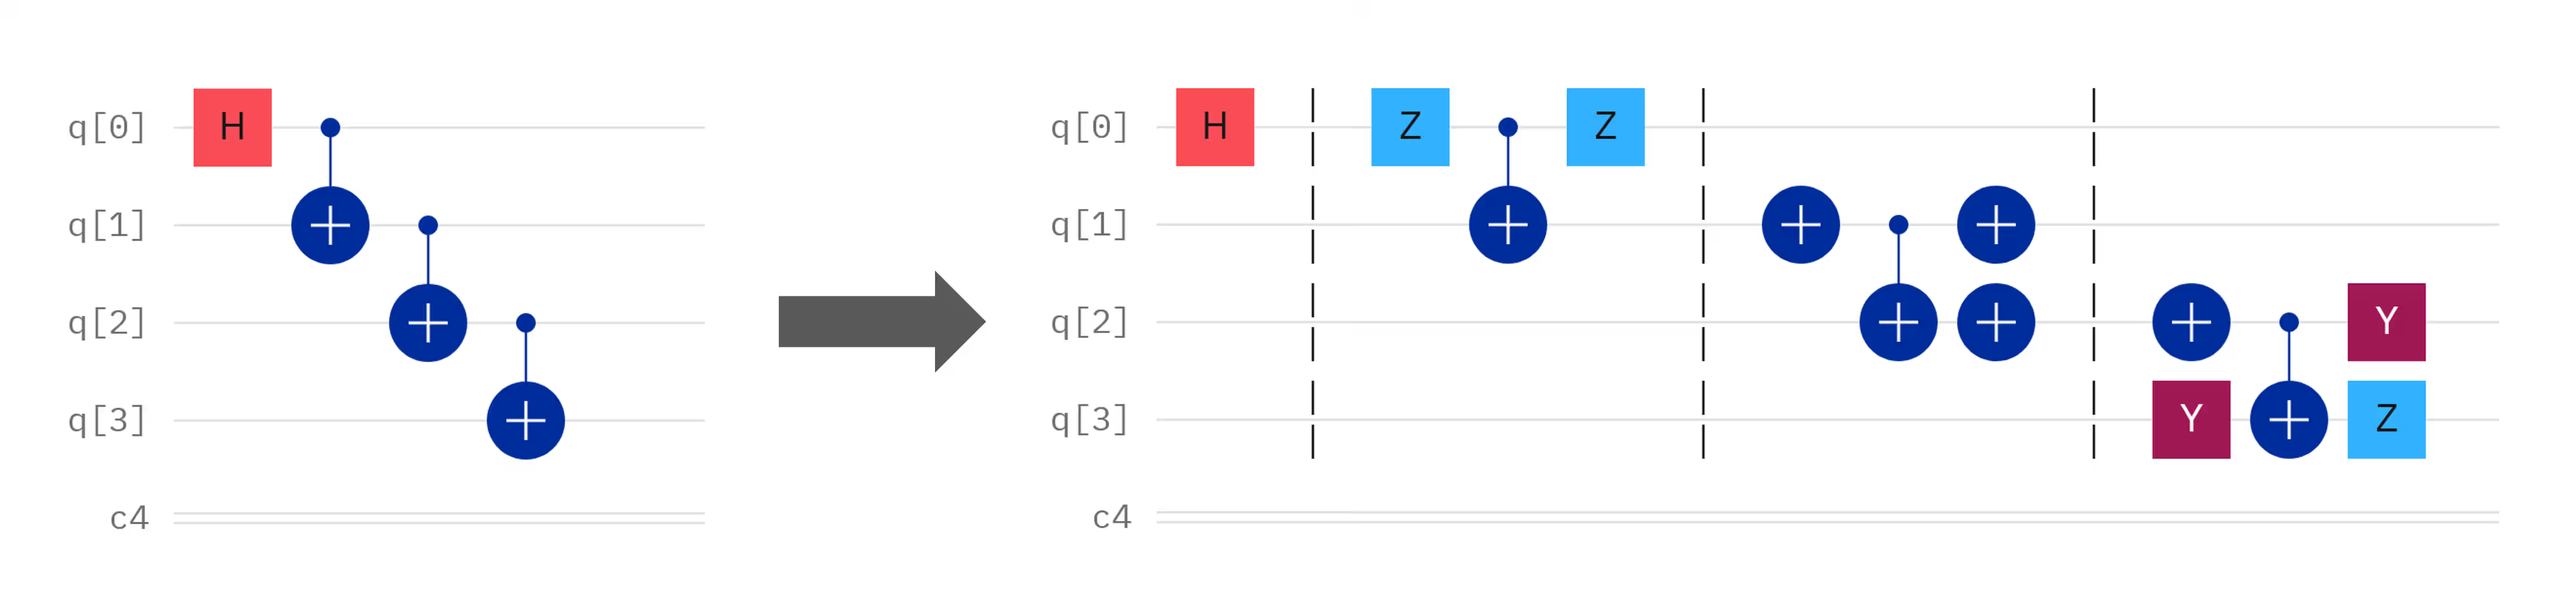
Pauli-Twirling bezieht sich auf das Hinzufügen von Kombinationen von Pauli-Gates vor und nach einer gewünschten Gate-Operation auf eine Weise, dass . Hier sind und keine einzelnen Paulis, sondern Sammlungen von Pauli-Operatoren, die oft auf mehrere Qubits wirken. Manchmal wird gesagt, dass die Wirkung der zusätzlichen Pauli-Gates "äquivalent zur Identität" sei. Aber das ist ungenau und potenziell verwirrend. Die Pauli-Gates sind durch getrennt, und das Ziel ist es, die logische Wirkung aller Gates gleich zu belassen. Manchmal wird als "Payload" bezeichnet, um diese beabsichtigte Operation von den zur Unterdrückung hinzugefügten Gates zu unterscheiden. Einige Beispiele für Pauli-Twirling um ein CNOT-Gate herum sind unten gezeigt.

Gehen wir nur ein Beispiel durch, um zu überprüfen, dass Twirling die logische Wirkung der Payload unverändert lässt. Ohne Beschränkung der Allgemeinheit seien die beiden Zwei-Qubit-Zustände mit und :
Wie immer verwenden wir die Qubit-Ordnungskonvention . Das Anwenden eines CX-Gates mit als Ziel ergibt
Betrachten wir nun den dritten gezeigten Schaltkreis, der X-Gates für Pauli-Twirling verwendet. Wir könnten einfach die Matrizen miteinander multiplizieren und überprüfen, ob sie eine CNOT-Matrix ergeben. Alternativ können wir die Operation auf einen beliebigen Quantenzustand durch den Schaltkreis verfolgen, wie wir es unten tun. Die Zustände an verschiedenen Punkten im Schaltkreis wurden mit a-d bezeichnet.

Dies ist genau , das wir zuvor ohne Twirling erhalten haben. Tatsächlich lässt diese getwirlte Gate-Sequenz die logische Wirkung der Payload unverändert. Wenn jedoch verschiedene gültige Twirling-Sequenzen von Schicht zu Schicht zufällig ausgewählt werden, kann kohärente Fehlerakkumulation in effektiv stochastische (inkohärente) Fehlerakkumulation umgewandelt werden. Um es klar zu sagen: Man wählt nicht ein einzelnes Twirling-Muster und verwendet es im gesamten Schaltkreis. Stattdessen werden für verschiedene Schichten unterschiedliche gültige Twirling-Sequenzen ausgewählt. Ein Beispiel mit vielen verschränkenden Schichten könnte so aussehen.
Überprüfe dein Verständnis
Überprüfe, dass das Pauli-Twirling im vierten Panel der obigen Abbildung ebenfalls die logische Wirkung des CNOT unverändert lässt.
Antwort
Wir folgen dem obigen Beispiel und zeigen, dass die Wirkung auf einen beliebigen Zwei-Qubit-Zustand äquivalent zu einer CNOT-Operation ist. Wir werden uns auf die beschrifteten Punkte in diesem Diagramm beziehen.

Dies ist äquivalent zur Wirkung eines CNOT mit Qubit 0 als Kontrolle und Qubit 1 als Ziel.
Kannst du eine Pauli-Twirling-Sequenz für das CNOT-Gate finden, die oben nicht gezeigt wird?
Antwort
Ja, es gibt viele andere. Ein Beispiel ist vor dem CNOT und ein und nach dem CNOT.
Wann Pauli-Twirling verwenden
Wie hier dargestellt, wird Pauli-Twirling nur auf Mehr-Qubit-Gates angewendet. Die Anwendung eines ähnlichen Protokolls auf Einzel-Qubit-Gates würde eine andere Logik erfordern und ist in der Praxis im Allgemeinen nicht nützlich. Pauli-Twirling selbst verwendet mehrere Einzel-Qubit-Gates (die Pauli-Gates). Die zusätzlichen Pauli-Gates würden wahrscheinlich mehr Fehler einführen, als durch die Randomisierung jeglicher kohärenter Fehlerakkumulation gewonnen würde. Fehlerraten im Zusammenhang mit Zwei-Qubit-Gates sind viel größer als die im Zusammenhang mit Einzel-Qubit-Gates. Außerdem sind manche Einzel-Qubit-Gates nicht-Clifford, die nicht vollständig getwirlt werden können. Deshalb enthält Qiskit Pauli-Twirling-Optionen, die automatisch um Zwei-Qubit-Gates twirlen, nicht aber um Einzel-Qubit-Gates.
Dies war in der obigen Abbildung implizit: Pauli-Twirling wurde um die CX-Gates herum implementiert, aber nicht um das Hadamard-Gate.
Sehen wir uns zwei Beispiele für Pauli-Twirling in Aktion an.
Pauli-Twirling zur Unterdrückung kohärenter Akkumulation
Um zu beobachten, wie Pauli-Twirling kohärente Fehlerakkumulation in langsamere inkohärente Akkumulation umwandeln kann, wollen wir einen Schaltkreis und eine Observable, die als Stresstest für kohärente Fehler dienen. Der alleinige Zweck ist es, kohärent akkumulierende Zwei-Qubit-Fehler sichtbar zu machen und dann zu zeigen, wie Pauli-Twirling diese kohärente Ansammlung in stochastischen Zerfall umwandelt.
CNOT- (oder CZ-)Gates sind eine häufige Quelle kohärenter Fehler. Das einfachste Experiment, das wir in diesem Fall durchführen können, ist die Initialisierung eines Zustands (sagen wir ), das Anwenden von Schichten gepaarter CNOT-Gates (unter Ausnutzung der Tatsache, dass zwei CNOTs eine Identität ergeben) und die Überprüfung, wie sich Fehler mit zunehmender Anzahl von Schichten akkumulieren, sowohl mit als auch ohne Pauli-Twirling.
Die interessierende Observable ist auf einem einzelnen Qubit, die wir als Funktion der Anzahl der Wiederholungen von CNOT-Paaren plotten.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Da wir unsere Basis vor den Messungen rotiert haben, entspricht eine Messung von dem Zustand, der sich unmittelbar vor dem letzten Hadamard-Gate in befand, und ähnlich für und . Daher kann unser Erwartungswert einfach aus den Zählungen von minus den Zählungen von berechnet werden.
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Wir wählen eine angemessene Anzahl von CNOT-Schichten, über die sich der Fehler akkumulieren lassen soll, bauen unsere Schaltkreise und transpilieren sie dann.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Bedenke, dass jede Schicht aus mehr als einem Zwei-Qubit-Gate besteht. Überwache die transpilierte Zwei-Qubit-Tiefe mithilfe der unten stehenden Funktion.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Nun führen wir die Jobs aus.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Zum Schluss visualisieren wir diese Ergebnisse.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
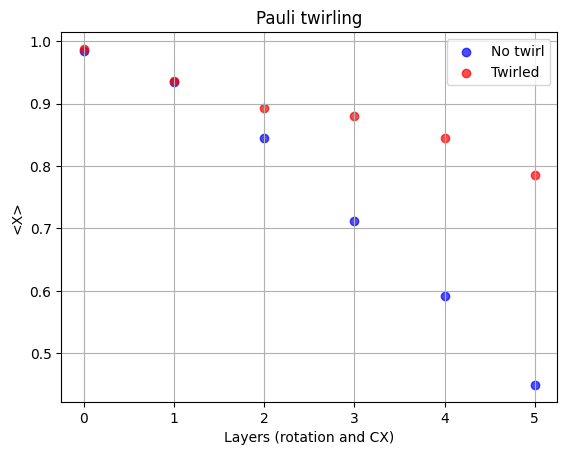
Wir können deutlich sehen, dass der getwirlte Schaltkreis einen Erwartungswert liefert, der näher am idealen liegt. Dieses Beispiel hat seinen Zweck erfüllt, aber gehen wir weiter zu etwas Nützlicherem: Twirling bei der Erzeugung stark verschränkter Zustände.
Pauli-Twirling bei der GHZ-Zustandspräparation
Das vorherige Beispiel zeigte einen überzeugenden Fall für Pauli-Twirling bei der Zerstörung der kohärenten Akkumulation von Fehlern im Zusammenhang mit CNOT-Gates. Die GHZ-Zustandserzeugung verwendet viele CNOT-Gates, um stark verschränkte Zustände zu erzeugen, die für viele Quantencomputing-Anwendungen nützlich sind. Untersuchen wir, wie Pauli-Twirling in diesem Kontext hilft, mit GHZ-Zuständen zunehmender Größe.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
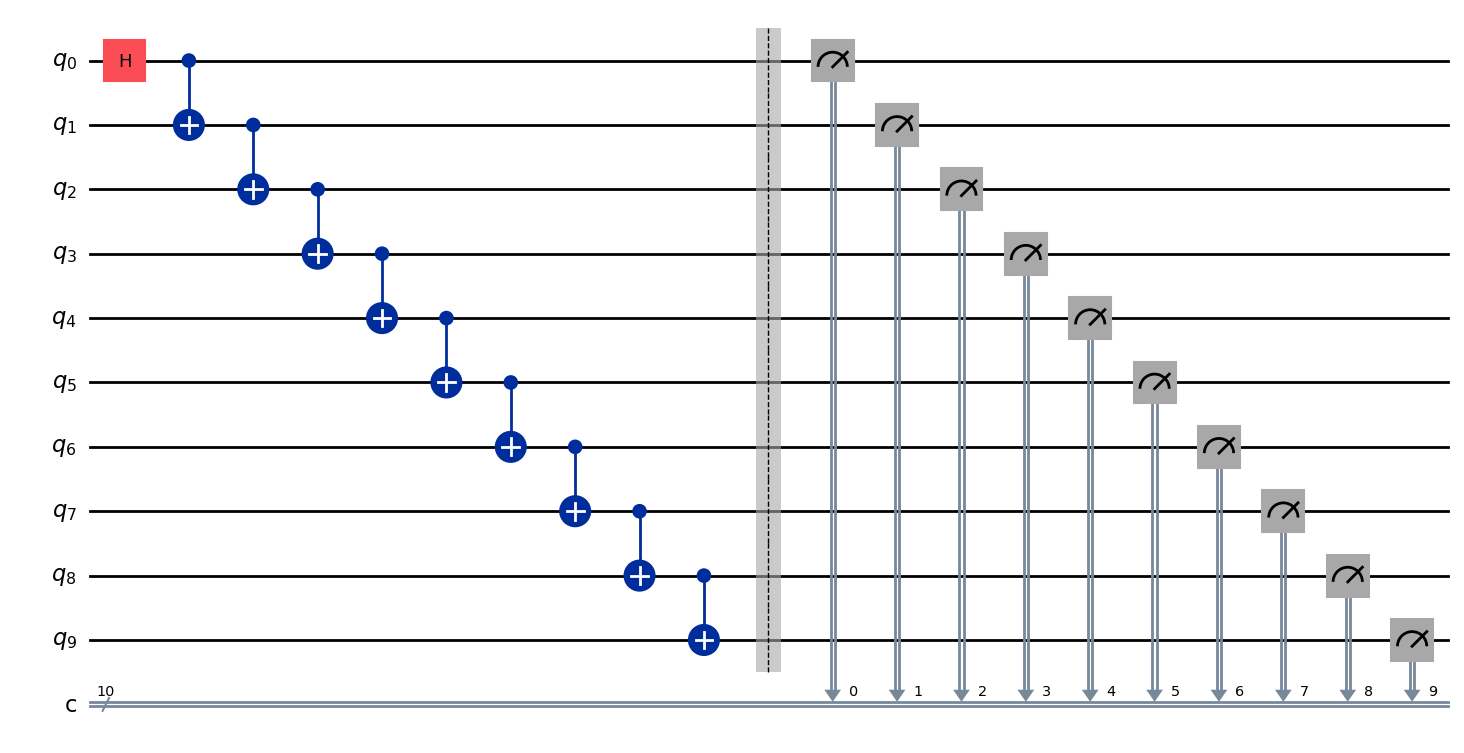
Nun bauen wir unsere Schaltkreise und transpilieren sie. In diesem Fall haben wir keine künstlich wiederholten Gates, die sich auf die Identität reduzieren. Also können wir dem Pass-Manager erlauben, etwas mehr für uns zu optimieren. Wir stellen es auf Level drei.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Wir können sehen, dass der Optimierer unseren abstrakten Schaltkreis auf die Qubits 123, 124, 136, 142 und 143 abgebildet hat.
circuits[0].draw("mpl")
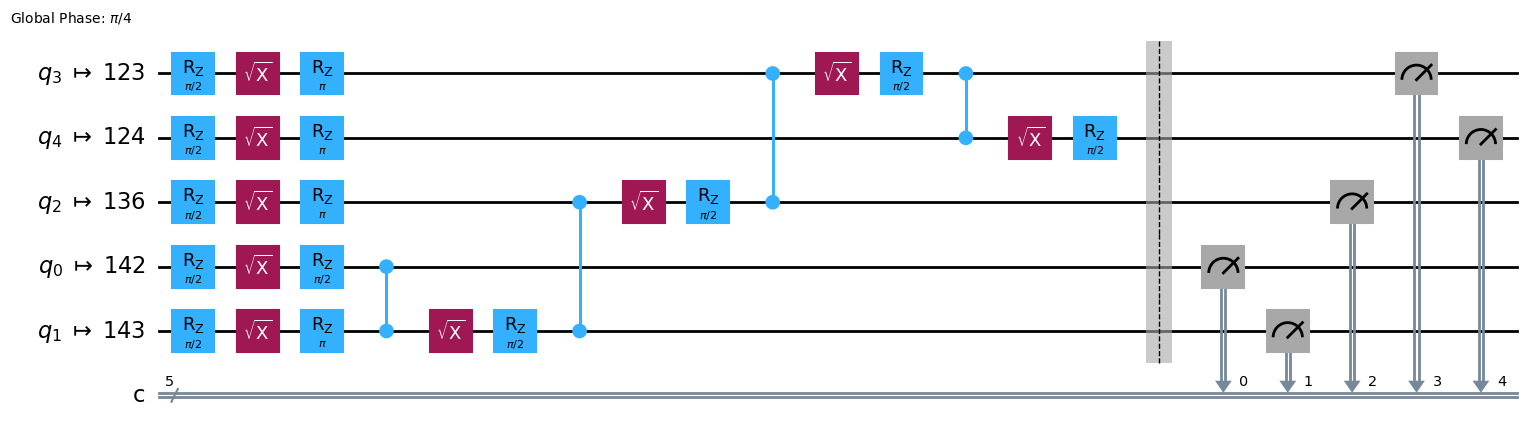
Um zu verstehen warum, schauen wir uns eine Karte des Layouts unseres Backends an (in diesem Bild ibm_fez, aber du kannst äquivalente Analysen auf jedem Backend durchführen).
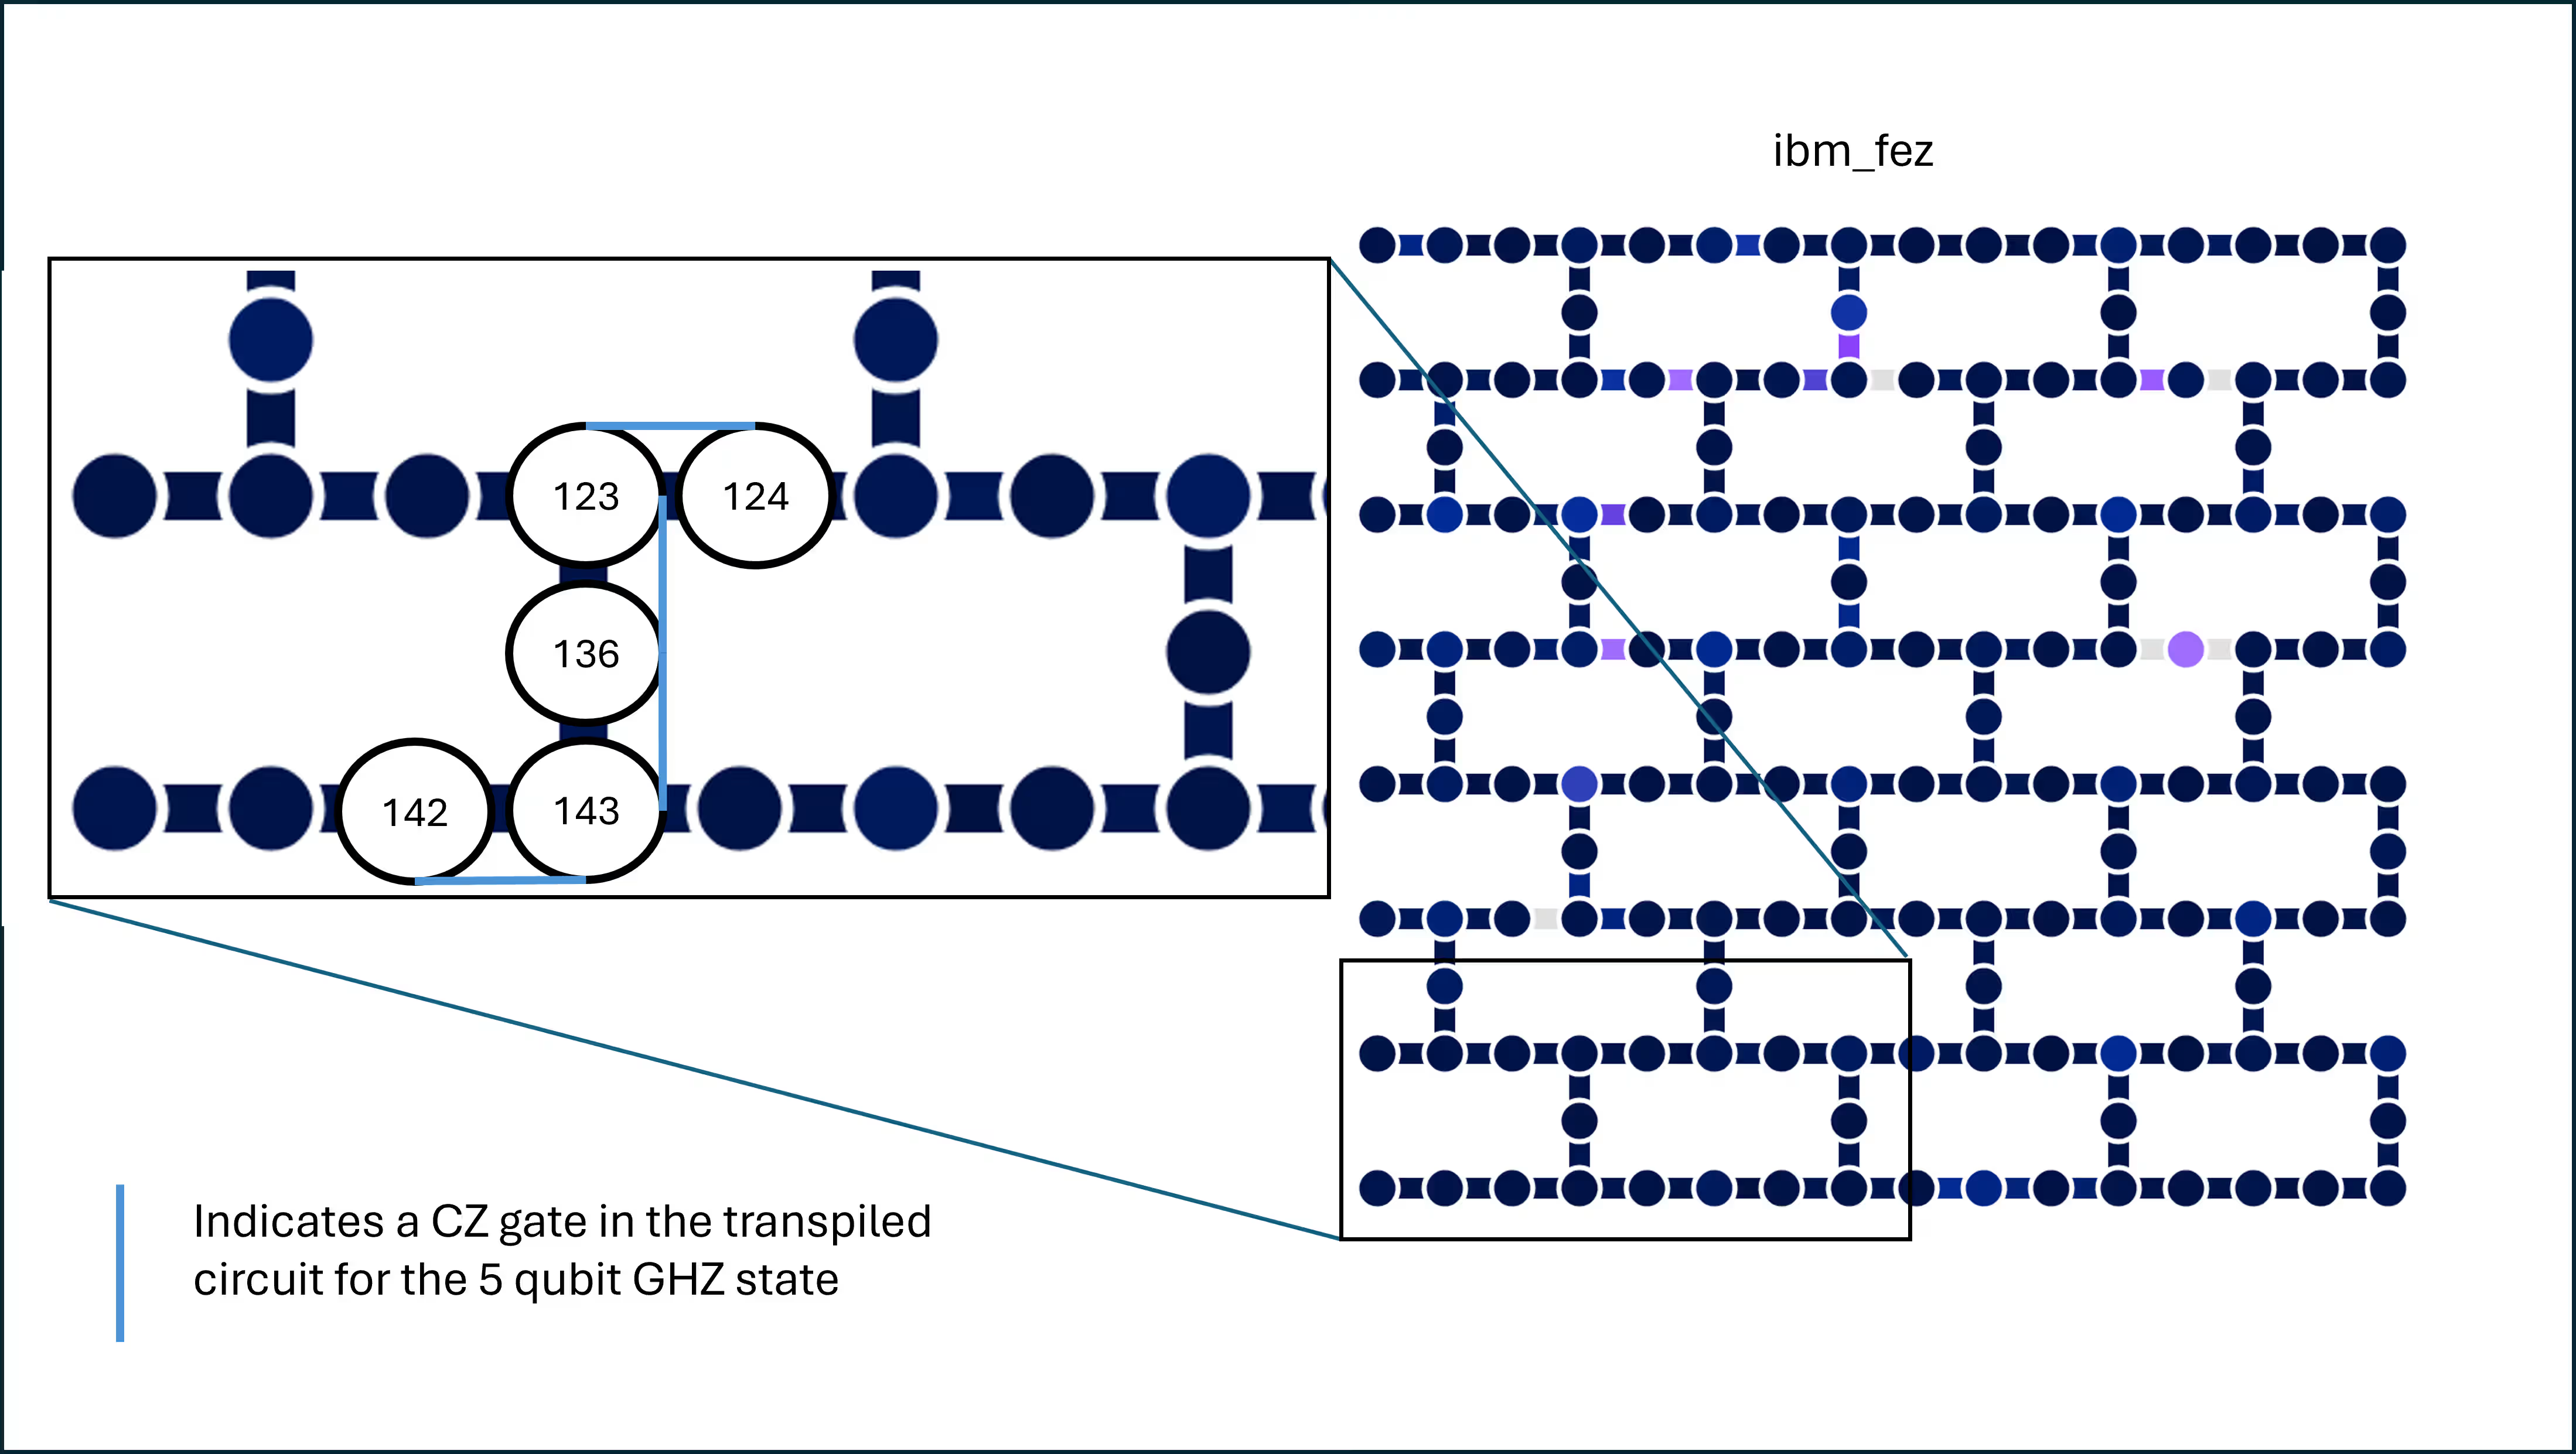
Wir sehen, dass die Qubits in einer Kette ausgewählt wurden, um Swap-Gates und damit die Schaltkreistiefe zu minimieren. Außerdem befindet sich jedes im Schaltkreis implementierte CZ-Gate zwischen benachbarten Qubits. Schließlich haben alle fünf Qubits relativ niedrige Fehlerraten, einschließlich Readout-Zuweisungsfehlerraten. Du kannst diese Fehlerraten für jedes Backend auf der Seite Compute-Ressourcen überprüfen. Ein solches Layout für eine einfache lineare Kette zu finden ist nicht schwierig, aber mit zunehmender Komplexität der Probleme wird die Optimierung des Schaltkreis-Layouts schwieriger und wertvoller.
Nun konfigurieren wir unsere Sampler-Primitive. Wir schalten andere Unterdrückungs-/Minderungswerkzeuge aus, um uns auf Pauli-Twirling zu konzentrieren.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Zum Schluss führen wir unsere Jobs aus. Du kannst optional die Job-ID-Nummern für den späteren Abruf ausgeben.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Wir extrahieren die Zählungen jedes gemessenen Rechenbasiszustands für alle Schaltkreise, sowohl mit als auch ohne Twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Wir wissen, dass die ideale Verteilung eines GHZ-Zustands diejenige ist, bei der die Hälfte der Shots und die andere Hälfte zurückgibt. Baue dies zum Vergleich auf.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Wir verwenden nun die Hellinger-Fidelität als Maß für die Qualität unseres Endzustands.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Zum Schluss plotten wir unsere Ergebnisse.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
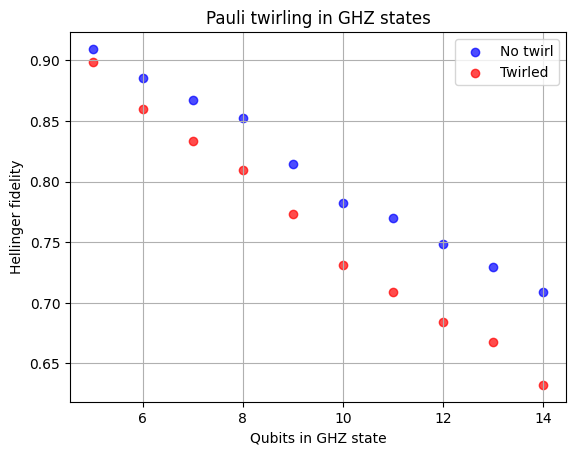
Die Ergebnisse mit Pauli-Twirling sind nicht besser (und sogar etwas schlechter) als ohne Twirling. Was ist passiert?
Zwei Dinge sind passiert. Erstens reduziert Pauli-Twirling nicht die Gesamtmenge des Rauschens — vielmehr formt es kohärente, systematische Fehler in stochastische Fehler vom Pauli-Typ um, sodass das Fehlerwachstum vorhersehbar und modellierbar wird. Es wurde nie eine Fehlerreduktion versprochen, außer in Sonderfällen.
Zweitens können in GHZ-Schaltkreisen bestimmte kohärente Fehler aufgrund der Symmetrie der GHZ-Konstruktion teilweise aufheben oder sich wie harmlose Phasenverschiebungen verhalten; Twirling entfernt diesen zufälligen Schutz und ersetzt ihn durch unkorreliertes stochastisches Pauli-Rauschen, sodass die GHZ-Fidelität unter Twirling etwas schlechter wird.
Diese zweite Behauptung bedarf einer Erklärung. Die Behauptung ist nicht, dass GHZ-Schaltkreise vor allen Arten kohärenter Fehlerakkumulation geschützt sind, sondern nur vor einigen — und dass in diesen Fällen der Schutz durch Twirling zerstört wird. Betrachten wir konkret die kohärente Überrotation im Zusammenhang mit den CX-Gates. Nennen wir das reale CX-Gate mit Überrotation :
wobei ein beliebiges Produkt von Pauli-Operatoren ist, wie , , , usw. Für allgemeine Zustände könnten all diese Überrotationen die Messstatistik (und damit die Maße der Zustandstreue) beeinflussen. Eine Teilmenge davon lässt jedoch viele Standard-GHZ-Observablen unverändert, einschließlich Operatoren wie und . Im Kontext der Vorbereitung eines GHZ-Zustands wären die relevanten Überrotationsfehler dieser Art:
Die Vorbereitung des gesamten -Qubit-GHZ-Zustands würde folgendermaßen aussehen:
Nach der Vorbereitung des GHZ-Zustands ist der Zustand idealerweise:
Dieser Zustand ist ein simultaner Eigenzustand einer großen Menge von Pauli-Operatoren, einschließlich der folgenden:
mit Eigenwert . Infolgedessen wirkt ein Operator der Form auf den GHZ-Zustand als Multiplikation mit dem Phasenfaktor , was Standard-GHZ-Observablen wie Parität, kollektives oder Populationen in der Rechenbasis nicht beeinflusst. Obwohl die Überrotationsfehler kohärent und systematisch sind, sind sie daher für die Messungen, die zur Bewertung der GHZ-Treue verwendet werden, effektiv unsichtbar. In diesem Sinne genießt der GHZ-Circuit einen zufälligen Kohärenzschutz: Bestimmte kohärente CX-Fehler kommutieren mit der Struktur des vorbereiteten Zustands und verschlechtern daher die gemessene Leistung nicht.
Pauli-Twirling verändert diese Situation grundlegend. Twirling erhält den kohärenten Überrotationsfehler nicht als deterministischen -Prozess. Stattdessen wandelt es den kohärenten Fehlerkanal in einen effektiven stochastischen Pauli-Kanal um. Infolgedessen enthält der Fehlerkanal nun Terme wie , , und , die nicht mit den GHZ-Stabilisatoren kommutieren.
Wenn diese stochastischen Pauli-Fehler auftreten, erzeugen sie echte Bit-Flip- und Phase-Flip-Fehler auf einzelnen Qubits oder Qubit-Paaren. Diese Fehler bringen den Zustand aus dem GHZ-Stabilisator-Unterraum heraus, verringern die Interferenz zwischen und und senken direkt die GHZ-Treue und die Multi-Qubit-Paritätssignale. Mit anderen Worten: Pauli-Twirling entfernt die kohärente Struktur des Fehlers, entfernt aber auch die symmetriebasierte Aufhebung, die diese Fehler zuvor harmlos machte. Das Ergebnis ist ein etwas schlechterer GHZ-Zustand — nicht weil Twirling Rauschen hinzufügt, sondern weil es einen größtenteils harmlosen kohärenten Fehler in echt schädliche stochastische Fehler umwandelt.
Dieses Beispiel verdeutlicht eine wichtige Lektion: Pauli-Twirling ist keine universelle Verbesserungsstrategie. Es ist am nützlichsten, wenn sich kohärente Fehler über einen Circuit hinweg auf eine Weise anhäufen, die die erforderliche Treue beeinträchtigt. In hochsymmetrischen Circuits wie der GHZ-Zustandsvorbereitung sind manche kohärenten Fehler natürlich an den Stabilisatoren des Zustands ausgerichtet, und ihre absichtliche Randomisierung kann diesen zufälligen Schutz aufheben.
Methoden kombinieren
Man kann Pauli-Twirling im Prinzip mit dynamischer Entkopplung kombinieren. Wir haben DD in diesem Fall aus zwei Gründen nicht verwendet: Erstens sollte es in diesem Circuit keine extrem langen Leerlaufzeiten geben. Zweitens speichern GHZ-Zustände die meisten ihrer Informationen nicht in der Einzel-Qubit-Phasenkohärenz, insbesondere wenn wir die Treue nur anhand von Bitstring-Zählungen betrachten und nicht anhand der Phase zwischen den gewünschten Bitstrings und .
Würden wir die GHZ-Vorbereitung auf 100+ Qubits erweitern, könnten die Verzögerungen bei der Messung der ersten/frühen Qubits tatsächlich lang genug sein, damit DD nützlich sein könnte. Dies gilt besonders, wenn wir die transpilierte Tiefe des Circuits berücksichtigen.
Pauli-Twirling in der RTZ-Echostruktur
Unser letztes Beispiel für Pauli-Twirling im Kontext der Reduzierung kohärenter Fehlerakkumulation verwendet einen Circuit mit Schichten von X-CZ-X-CZ-Kombinationen. Dies ist eine bekannte Gate-Sequenz, die oft verwendet wird, um kohärente ZZ-Fehlerterme in Zwei-Qubit-Gates aufzuheben, auch ohne Twirling. Aber mit Twirling können wir andere Formen der kohärenten Fehlerakkumulation reduzieren oder randomisieren.
Wir beginnen damit, eine Funktion zu definieren, um RTZ-ähnliche Circuits mit einer variierenden Anzahl von Schichten zu erstellen.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Nun erstellen wir Circuits mit zunehmender Anzahl von Schichten, bis zu einer angemessenen transpilierten Zwei-Qubit-Gesamttiefe.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
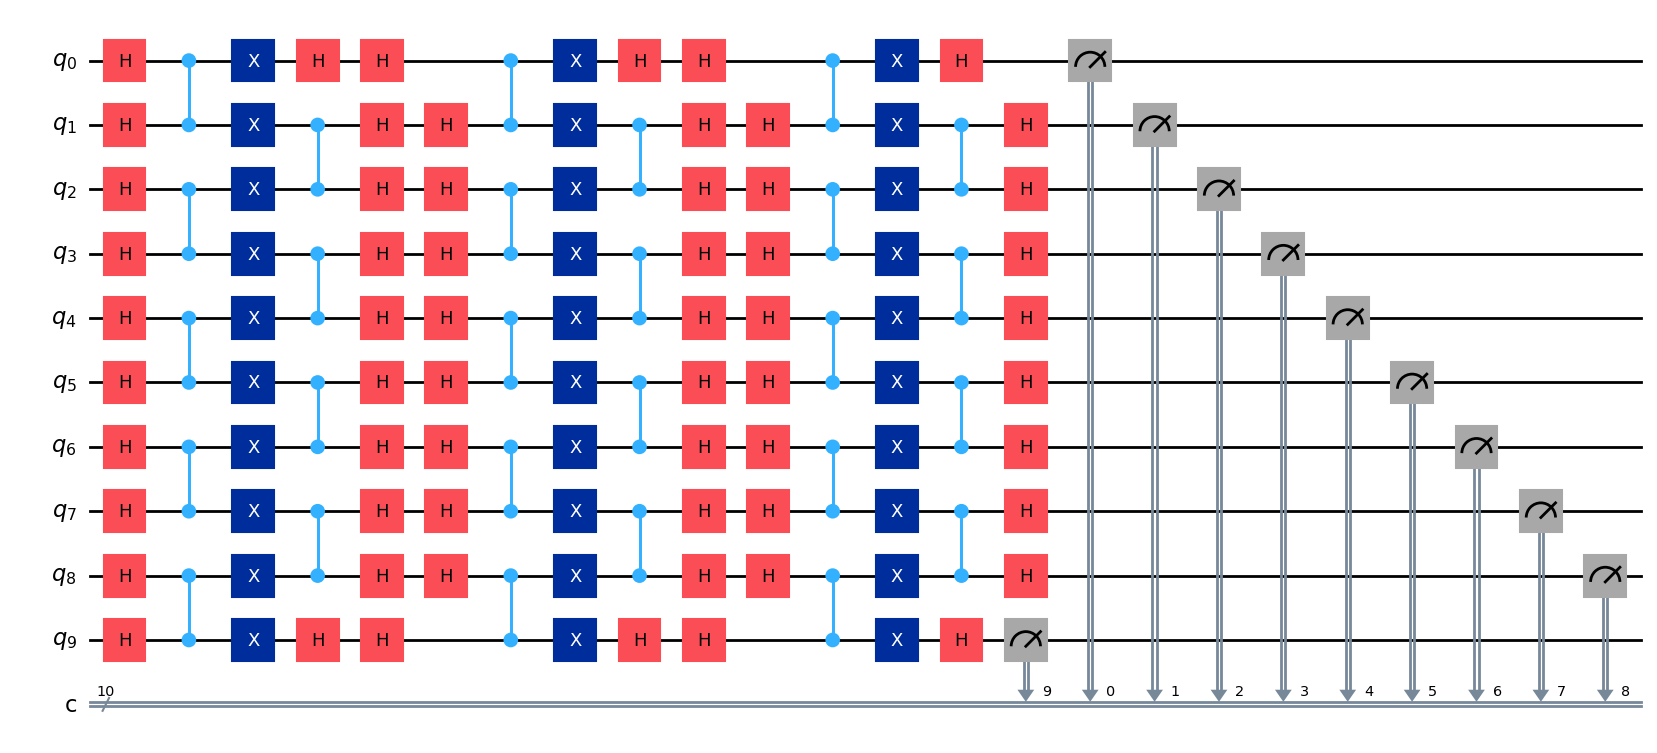
Am oberen Ende sind einige davon ziemlich tief. Verwenden wir den AerSimulator ohne Rauschmodell, um die idealen Zustände am Ende jedes dieser Circuits zu erhalten. Wir können dann unsere Ergebnisse von echten Quantencomputern mithilfe der Hellinger-Treue benchmarken.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Nun definieren wir einen SamplerV2 mit Twirling und einen ohne Twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Nun führen wir unsere Jobs aus.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Wir erhalten die Zählungen aus jedem der Läufe auf einem echten Quantencomputer.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Nun bestimmen wir die Hellinger-Treue, indem wir jeden dieser Läufe mit den rauschfreien AerSimulator-Ergebnissen vergleichen.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Nun visualisieren wir unsere Ergebnisse.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
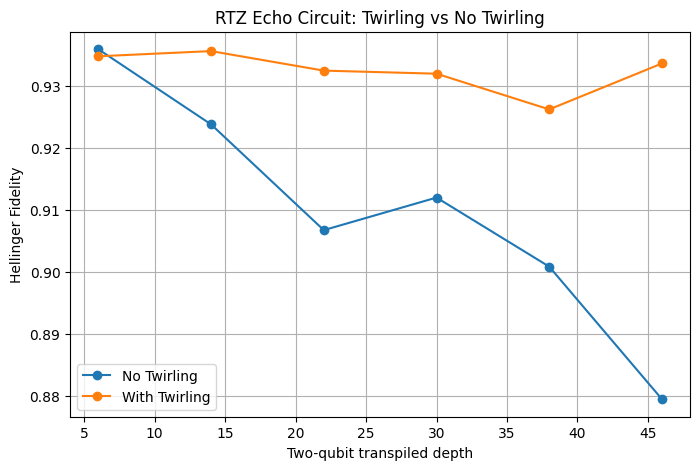
In dieser Lektion haben wir Fälle untersucht, in denen Pauli-Twirling verwendet wird, um die Akkumulation kohärenter Fehler zu begrenzen – ein Kontext, in dem man es als Fehlerunterdrückung bezeichnen könnte. Pauli-Twirling ist jedoch oft nützlicher als Werkzeug zur Umgestaltung des Fehlerverhaltens, indem es kohärente Fehler in eine Form umwandelt, die vorhersehbarer und leichter zu modellieren ist. Der Nutzen davon wird im Kontext von Fehlerminderungstechniken wie der Zero-Noise-Extrapolation (ZNE) deutlicher, die auf einer einigermaßen vorhersehbaren Rauschskalierung beruhen. Dies wird in der nächsten Lektion besprochen.