Moderne Workflows
Dieser Kurs hat eine Vielzahl von Methoden zum Umgang mit Quantenrauschen und Fehlern behandelt. Wir haben bewusst einige Blackbox-Lösungen vermieden, damit wir sehen konnten, wie diese Methoden funktionieren. Jetzt sind wir bereit, diese Methoden in ihrer modernsten Form zu verwenden. Konkret untersuchen wir einige hochoptimierte Werkzeuge zur Fehlerbehandlung, die einen Teil der Komplexität vor uns verbergen. Außerdem untersuchen wir Samplomatic und Addons wie Shaded Lightcones (SLC), die uns sehr feine Kontrolle über bestimmte Minderungsprozesse geben.
In diesem Video gibt Dr. Chris Porter einen Überblick über diese modernen Werkzeuge. Wir planen, dieser Lektion zu einem späteren Zeitpunkt Beispiel-Workflows hinzuzufügen. Diese Lektion enthält jedoch bereits alle Informationen, die du brauchst, um diese Werkzeuge zu verwenden und die Badge-Prüfung zu bestehen.
Überblick
Frühe IBM Quantum Primitives wie Estimator und Sampler boten Fehlerminderung über eine kleine Anzahl voreingestellter Stufen. Spätere Versionen ermöglichten eine direktere Kontrolle über einzelne Techniken, darunter die Wahl der Strategie zur Zero-Noise-Extrapolation, Pauli-Twirling-Konfigurationen und Randomisierungsparameter. Diese Einstellungen blieben jedoch weitgehend global und wurden einheitlich auf einen gesamten Circuit angewendet.
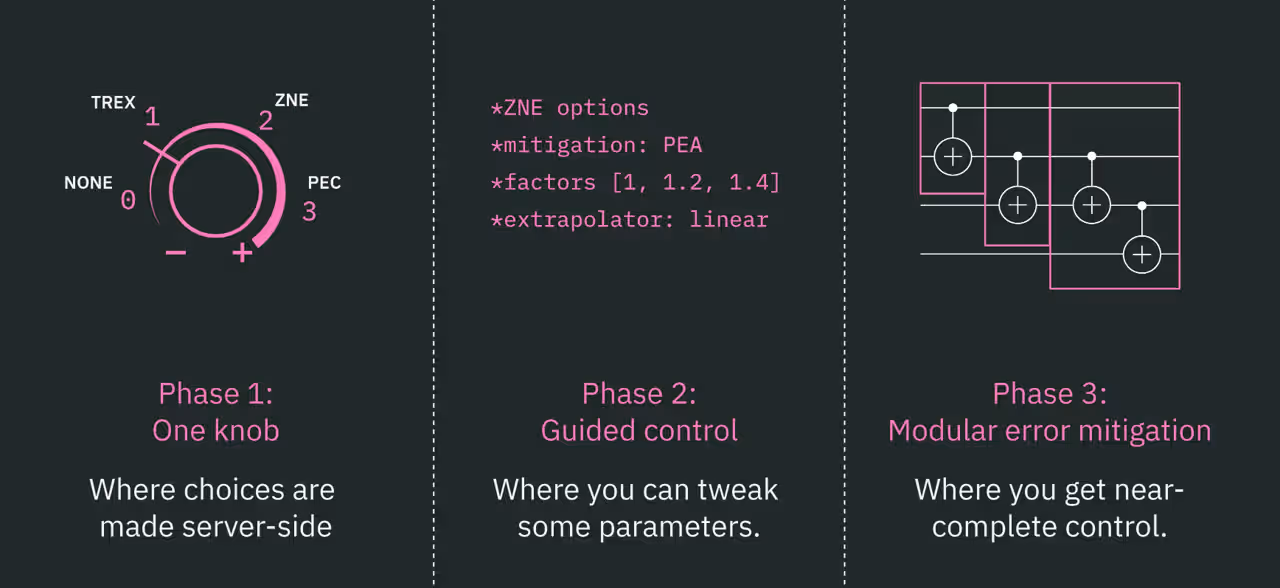
Je anspruchsvoller Quanten-Workloads werden, desto häufiger brauchen Entwickler die Möglichkeit, Ausführungs- und Minderungsstrategien auf bestimmte Bereiche eines Circuits zuzuschneiden. Das folgende Diagramm skizziert mehrere wichtige Werkzeuge, die in dieser Lektion besprochen werden, und zeigt, wo sie in einen typischen Workflow passen.
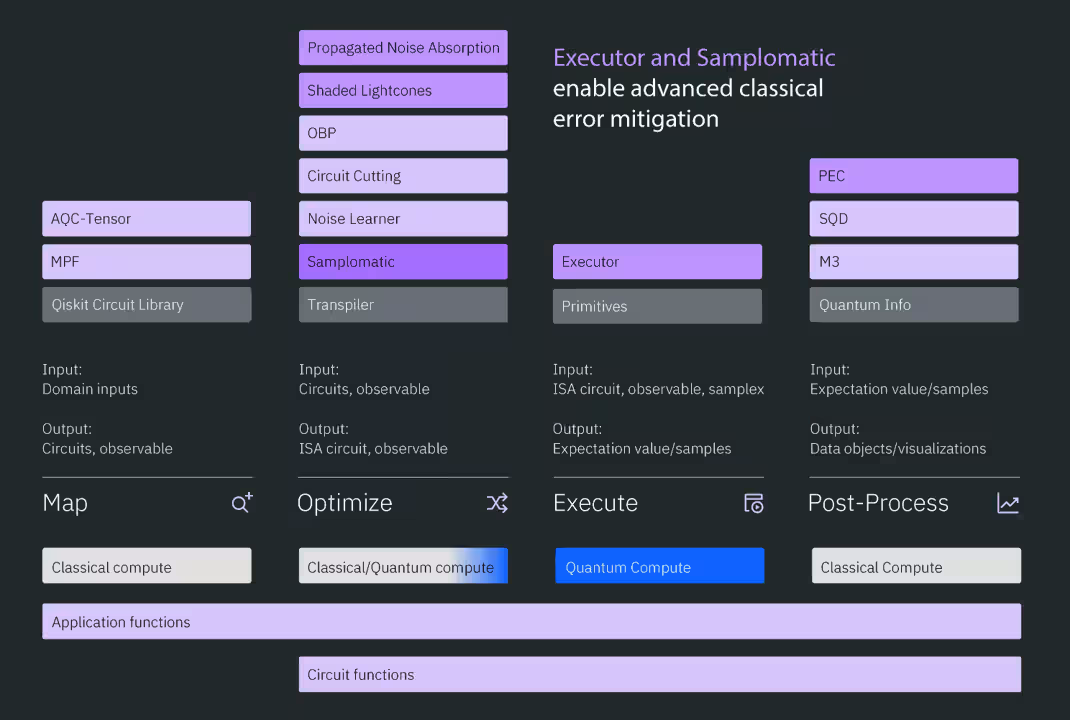
Das Directed-Execution-Modell erfüllt den Bedarf an modularer Kontrolle über die Ausführung und integriert viele dieser Werkzeuge.
Directed-Execution-Modell
Anstatt implizite Ausführungsentscheidungen zu treffen, folgt das Directed-Execution-Modell Anweisungen, die der Nutzer vorgibt. Dieser Ansatz verbessert die Transparenz und macht komplexe Workflows leichter inspizierbar und debuggbar. Zu den wichtigsten Merkmalen dieses Modells gehören:
-
Konfiguration pro Layer durch beschriftete Circuit-Bereiche
-
Identifizierung einzigartiger und wiederholter Layer für effizientes Noise Learning
-
Workflows mit gebündelter (Batch-)Ausführung
-
Strukturierte Nachverarbeitung
-
Enge Integration mit Addons wie Shaded Lightcones
Das Modell basiert auf zwei Schlüsselkomponenten:
-
Samplomatic, das Ausführungsrezepte definiert
-
Executor, der diese Rezepte ausführt und Samples zurückgibt
Die meisten Workflows, die Executor verwenden, lassen sich auch mit Sampler umsetzen, da beide letztlich Samples erzeugen. Der entscheidende Vorteil von Executor ist die Effizienz. Aufgaben wie das Erzeugen von Twirling-Konfigurationen sind in der serverseitigen Near-Time-Umgebung oft deutlich schneller als auf dem Client. Estimator und Sampler werden weiterhin unterstützt und sind für viele Workloads möglicherweise nach wie vor die bequemste Wahl.
Vor der Ausführung musst du jedoch einen Circuit konstruieren und vorbereiten. Qiskit bietet mehrere Addons, die bei der Circuit-Erzeugung, Simulation und Optimierung helfen. Weitere Informationen zu den folgenden Werkzeugen findest du über die Links.
Quanten-Circuits aufbauen
Für manche Anwendungen oder neue Ansätze müssen Nutzer selbst festlegen, wie sie ihr Problem auf einen Quanten-Circuit abbilden. In vielen Bereichen können Qiskit-Addons jedoch wichtige Teile dieses Prozesses automatisieren.
Optimization Mapper
Der Optimization Mapper hilft dabei, klassische Optimierungsprobleme in Formen auszudrücken, die für Quantenalgorithmen geeignet sind. Zu den wichtigsten Funktionen gehören:
-
Zielfunktionen und Nebenbedingungen konstruieren
-
Probleme in QUBO-Formulierungen umwandeln
-
Hamilton- oder Operatordarstellungen erzeugen
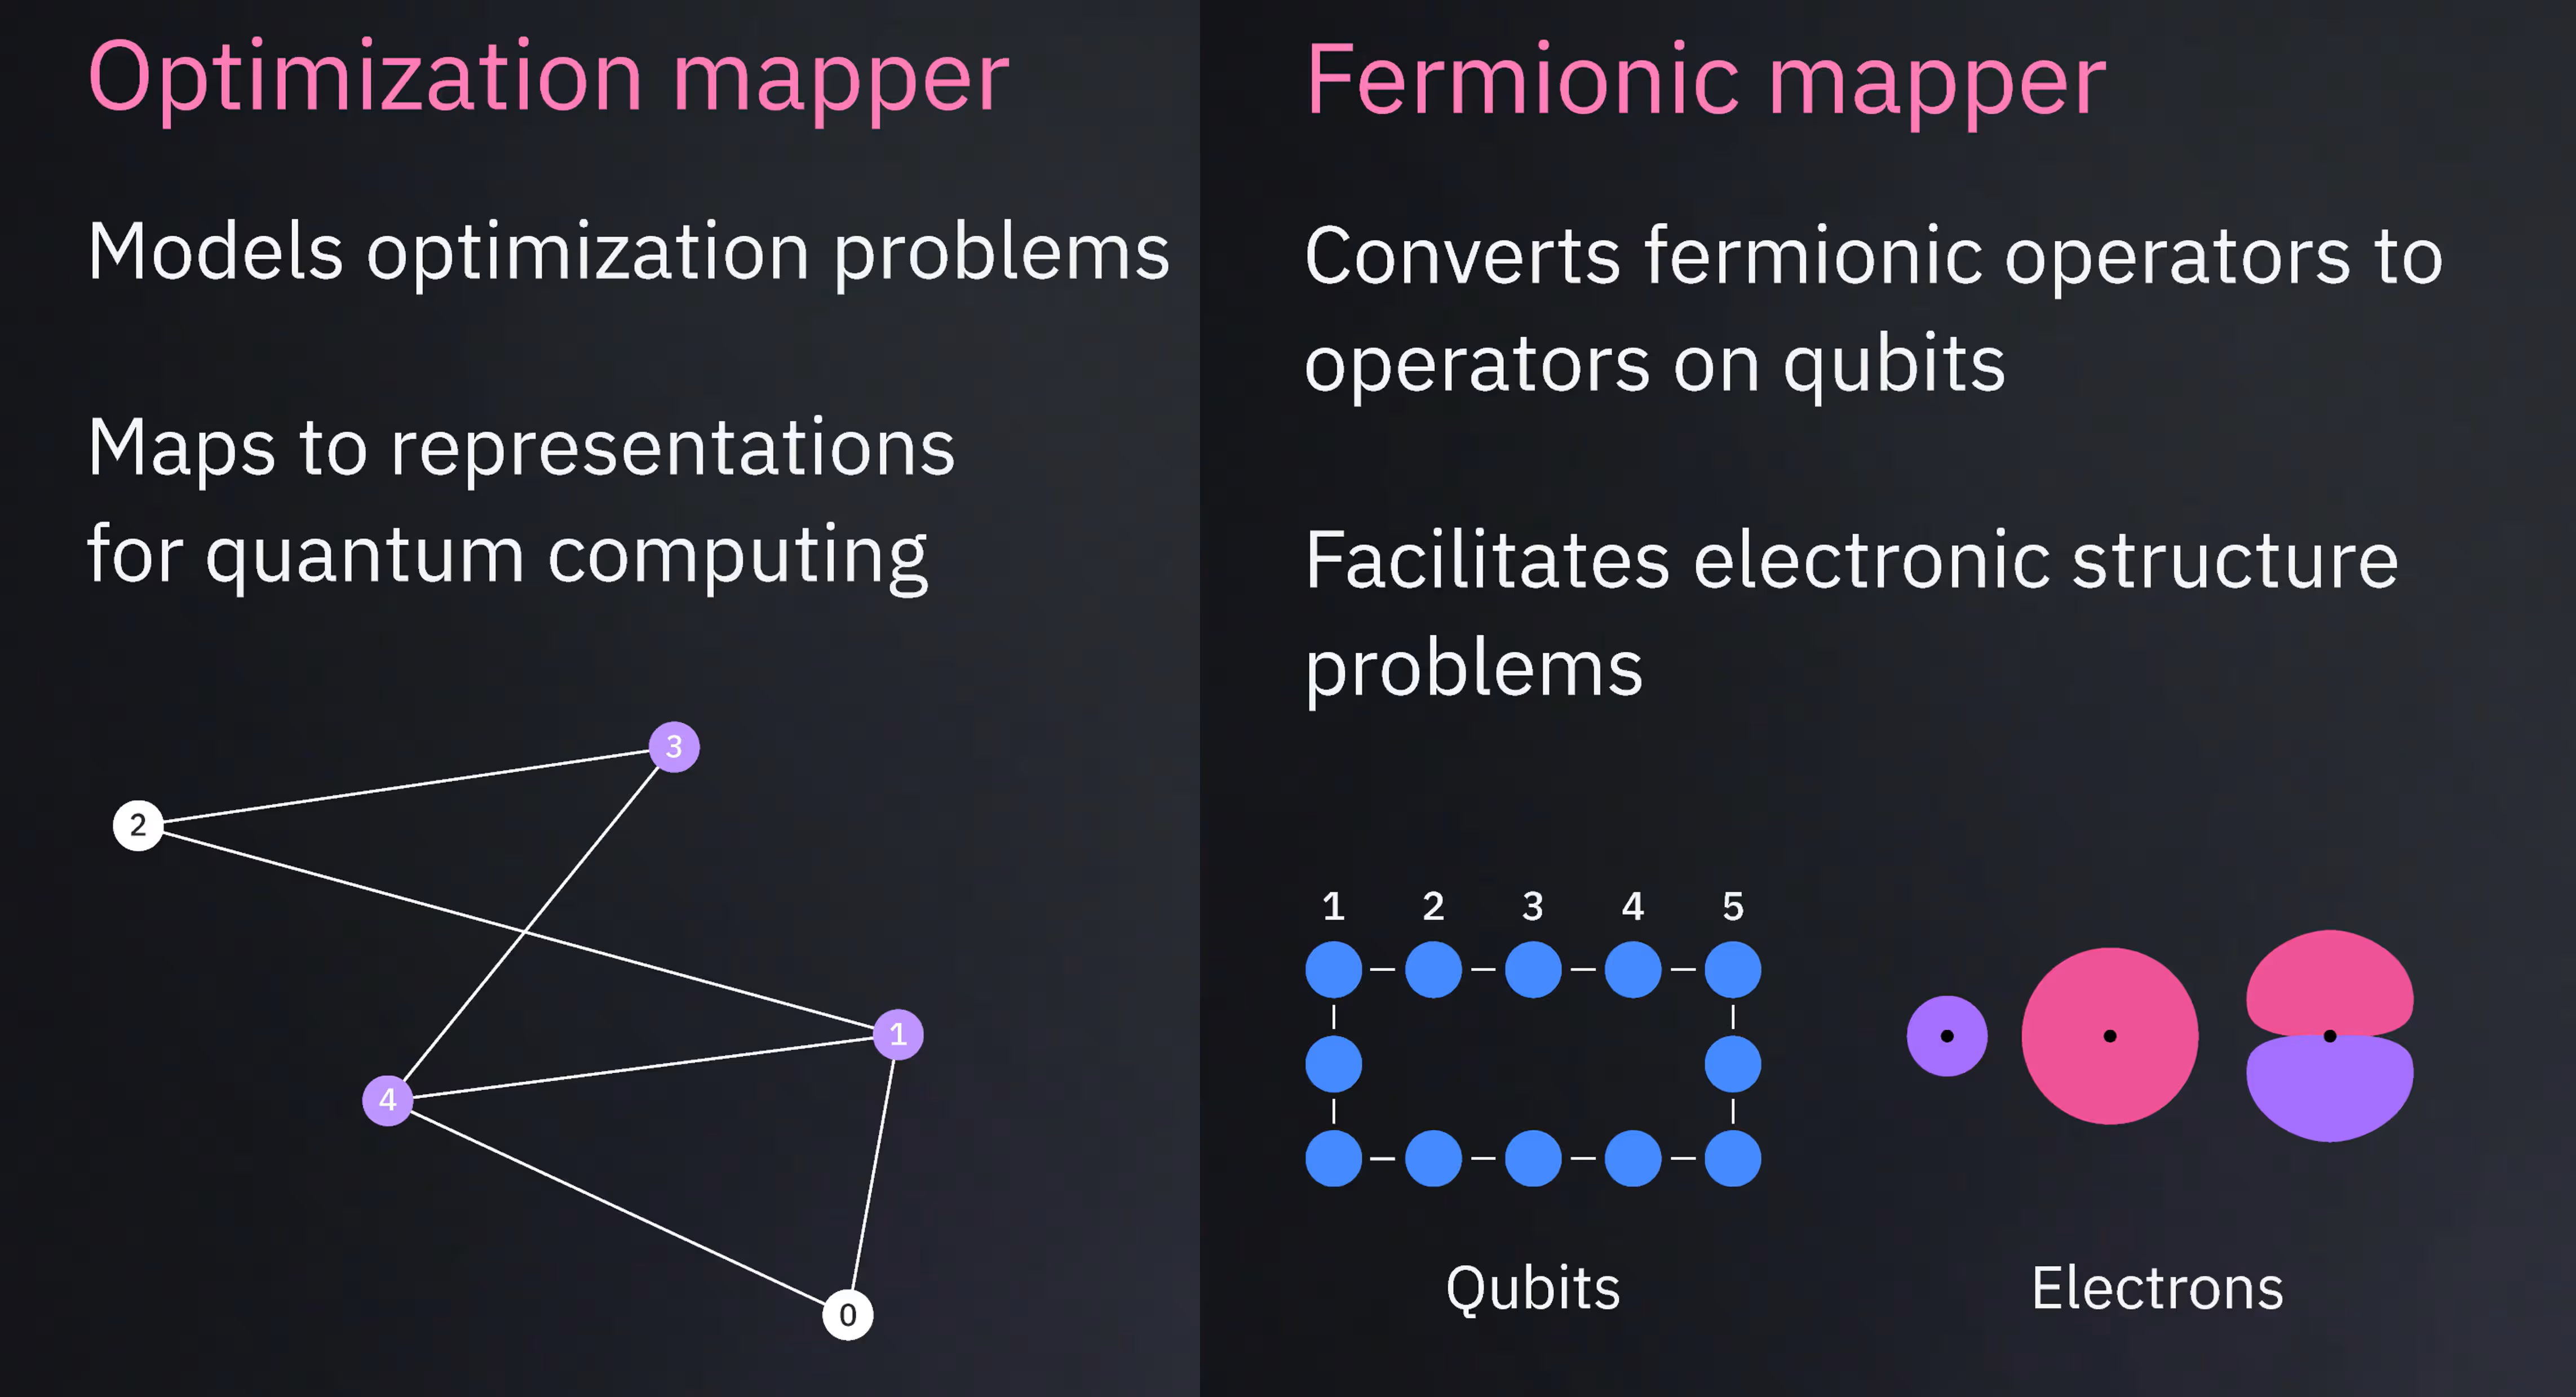
Fermionic Mapper
Der Fermionic Mapper wandelt fermionische Operatoren in Qubit-Operatoren um, die für Quantenhardware geeignet sind. Er unterstützt Abbildungen wie Jordan-Wigner, die Operatoren auf ununterscheidbaren Fermionen in Pauli-Operatoren auf unterscheidbaren Qubits umwandelt und dabei die fermionische Statistik bewahrt. Dieses Addon ist nützlich für Anwendungen in der Quantenchemie und den Materialwissenschaften.
Die beiden vorherigen Addons konzentrieren sich auf die anfängliche Abbildung einer Problemstruktur auf einen Quanten-Circuit. Ebenso wichtig ist es jedoch, die zeitliche Entwicklung eines Prozesses effizient auf einen Quanten-Circuit abzubilden und einen Circuit durch Verringerung seiner Tiefe zu optimieren. Die nächsten Addons widmen sich diesen Aufgaben.
Multi-Product-Formeln (MPF)
Multi-Product-Formeln verbessern die Genauigkeit von Simulationen der Quanten-Zeitentwicklung, indem sie mehrere Näherungen kombinieren. Konkret erstellst du Circuits mit unterschiedlicher Anzahl an Trotter-Schritten, sodass du eine gewichtete Kombination der Circuit-Ergebnisse verwenden kannst. Für eine gegebene Zielgenauigkeit kann MPF oft flachere Circuits verwenden als Standard-Trotter-Methoden. Der Preis dafür ist, dass du mehrere Circuits ausführen und ihre Ergebnisse klassisch kombinieren musst.
AQC-Tensor
AQC-Tensor führt approximative Quantenkompilierung mit Tensornetzwerk-Methoden durch. Ein häufiger Anwendungsfall ist, einen Teil eines tiefen Circuits durch eine flachere variationelle Näherung zu ersetzen. Der resultierende Circuit kann bei deutlich geringerer Tiefe eine ähnliche Genauigkeit erreichen.

Transpilation
Du hast Transpilation in diesem Kurs bereits oft verwendet. Du weißt, dass ein abstrakter Circuit nach seiner Konstruktion für die Ausführung auf Hardware vorbereitet werden muss. Die einzelnen Phasen der Transpilation haben wir bisher jedoch noch nicht im Detail untersucht.
Zu den wichtigsten Transpilation-Phasen gehören:
-
Layout: logische Qubits auf physische Qubits abbilden
-
Translation: Operationen mit dem nativen Gate-Satz des Backends umschreiben
-
Routing: SWAP-Operationen einfügen und optimieren, die durch die Hardware-Konnektivität erforderlich sind
Diese Prozesse hängen miteinander zusammen. So sollte das Layout beispielsweise die Tiefe auch nach Berücksichtigung des Routings minimieren. Das Layout sollte außerdem die fehleranfälligsten Qubits und Verbindungen meiden. Diese Phasen laufen oft automatisch ab, aber fortgeschrittene Nutzer können bei Bedarf eigene Layouts oder andere Einschränkungen festlegen.

Mehr über Transpilation erfährst du im Leitfaden Einführung in die Transpilation.
Überprüfe dein Verständnis
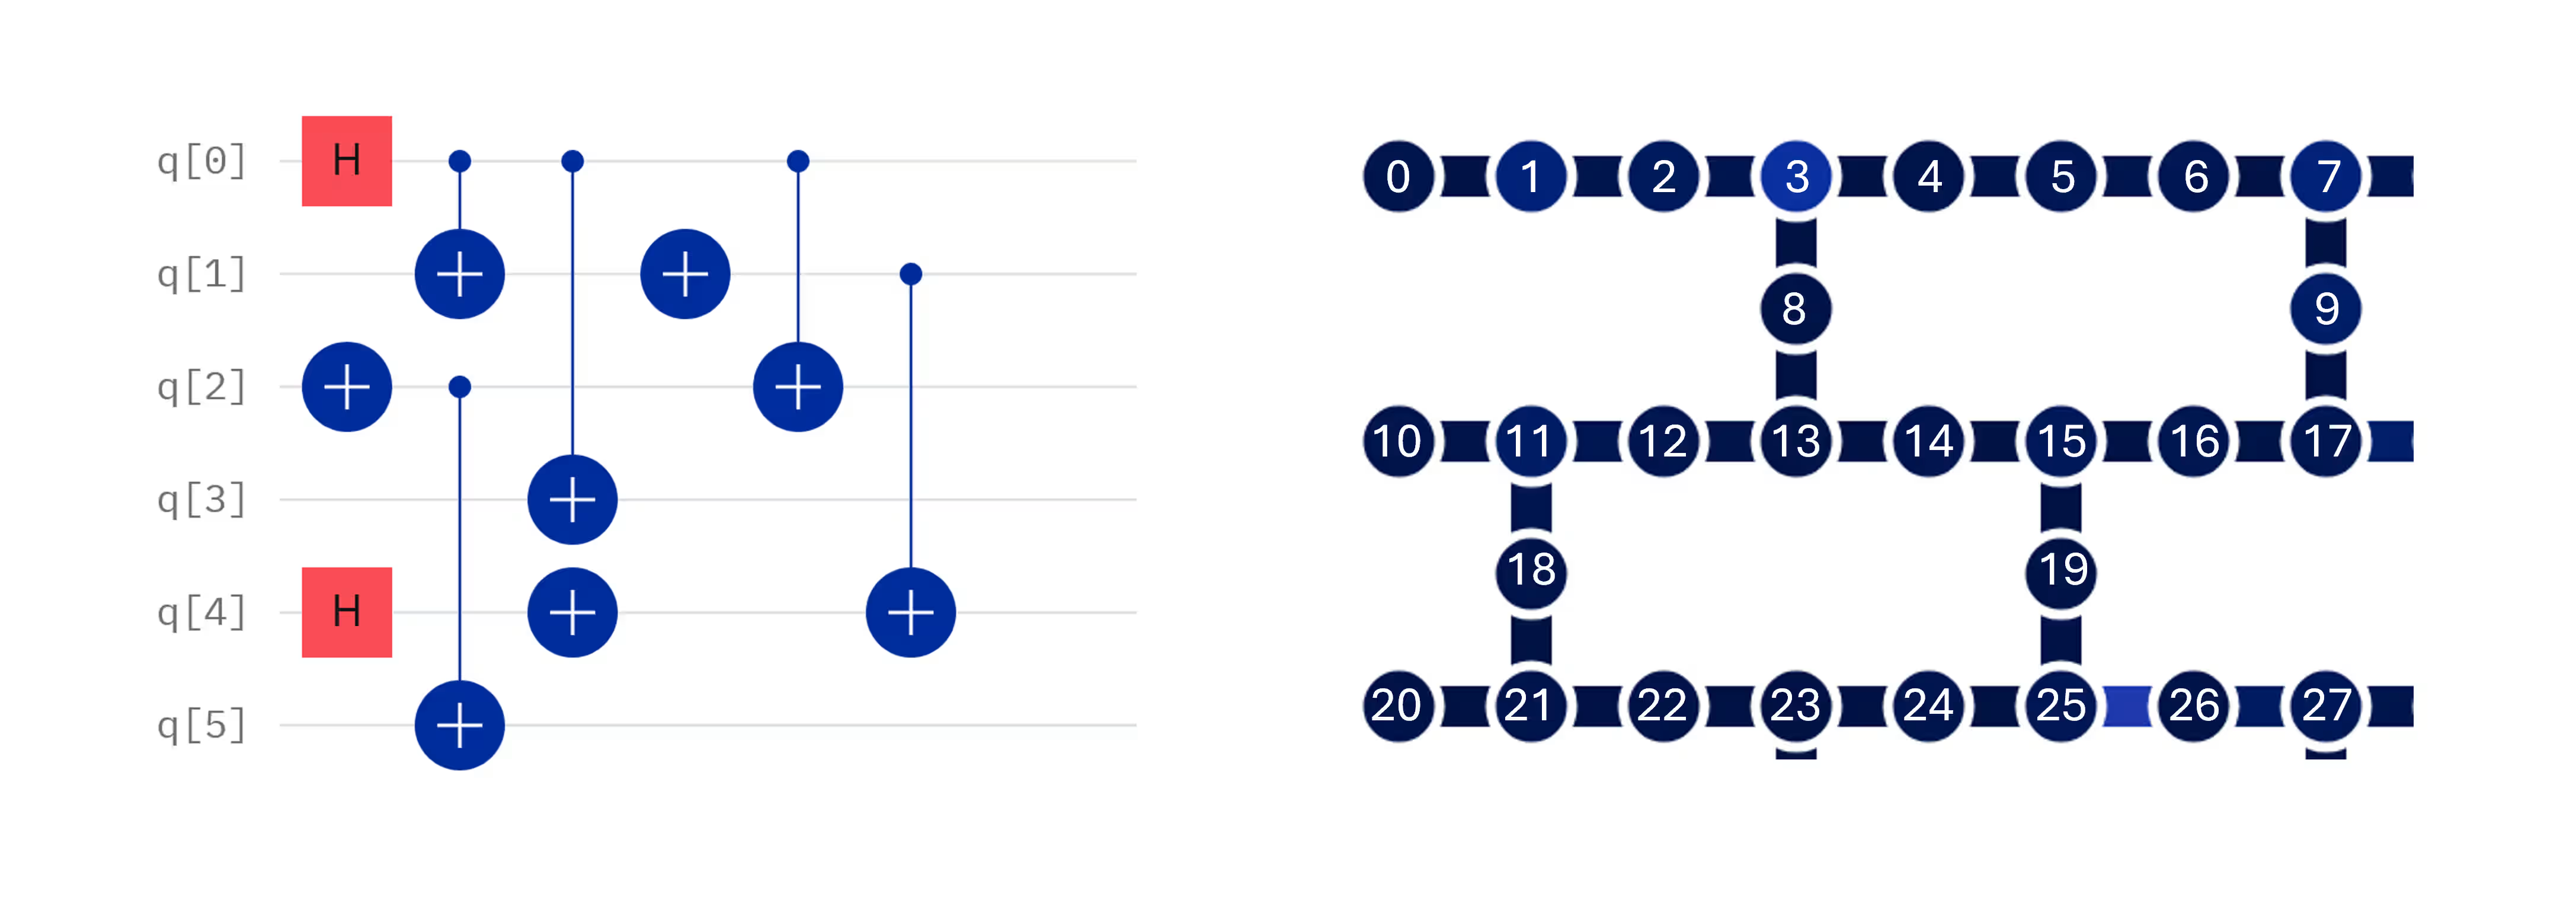
Sieh dir den folgenden Quanten-Circuit an und nimm an, dass du ihn auf einem Quantencomputer mit Heavy-Hex-Layout ausführen musst, von dem ein Teil gezeigt wird. (a) Schlage eine Zuordnung von den Qubit-Nummern im abstrakten Circuit zu den Qubit-Nummern im physischen Quantencomputer vor, die die Anzahl der benötigten SWAP-Gates minimiert. (b) Ist deine Wahl eindeutig, oder könnte es andere gleich gute Wahlmöglichkeiten geben? (c) Selbst wenn deine Wahl das einzige optimale Layout zur Reduzierung von SWAP-Gates ist: Aus welchen Gründen könnte der Transpiler eine andere Zuordnung wählen?
Antwort
(a) Es kann viele richtige Antworten geben, aber beachte, dass nur das abstrakte Qubit 0 verschränkende (Zwei-Qubit-)Gates mit drei Nachbarn hat. Alle anderen nehmen nur mit zwei Nachbarn an Zwei-Qubit-Operationen teil. Dieser Circuit lässt sich ohne SWAP-Gates auf eine Heavy-Hex-Topologie abbilden. Jedes Layout, das dies erreicht, ist akzeptabel. Mit für das abstrakte Qubit null und für das transpilierte Qubit null ist ein solches Layout:
(b) Dieses Layout ist nicht eindeutig. Viele andere Layouts vermeiden SWAP-Gates ebenfalls vollständig. Ein weiteres Beispiel ist:
(c) Manchmal ist ein bestimmtes Qubit fehleranfälliger als die meisten anderen auf dem Chip. Auch sind manche Verbindungen zwischen Qubits fehleranfälliger als andere. Der Transpiler versucht, ein Layout zu finden, das unnötige SWAP-Gates vermeidet, aber auch die Qubits und Verbindungen mit der höchsten Fidelity verwendet, die auf dem gewählten Quantencomputer verfügbar sind.
Die Auswirkungen von Rauschen und Fehlern verringern
Mehrere Qiskit-Addons konzentrieren sich gezielt darauf, die Auswirkungen von Rauschen und Hardware-Unvollkommenheiten zu verringern.
Operator-Backpropagation und rauschbewusste Circuit-Transformationen
Wir haben die Operatorpropagation bereits im Zusammenhang mit kohärenten Pauli-Checks in der Fehlerkorrektur besprochen. Operatorpropagation ist jedoch ganz allgemein nützlich. Es gibt zwei Hauptwege, die Propagation eines Operators durch einen Quanten-Circuit zu nutzen: (1) die letzten Layer eines Quanten-Circuits in die gemessenen Observablen absorbieren und (2) die wahrscheinlichen Auswirkungen von Fehlern im Circuit berücksichtigen und sie durch die Messung einer anderen Observablen kompensieren. Die nächsten beiden Werkzeuge nutzen diese Ansätze.
Operator-Backpropagation
Operator-Backpropagation verringert die Circuit-Tiefe, indem Gates vom Ende eines Circuits in die gemessene Observable absorbiert werden. Betrachte zum Beispiel den folgenden Circuit.

Dieser Circuit enthält Rotations- und Verschränkungs-Layer, die nichttrivial erscheinen, gefolgt von einer Leiter aus CNOT-Gates und einer Messung von Z an Qubit 5. Dieser Circuit hat eine Zwei-Qubit-Tiefe von 7. Diese Tiefe gilt vor der Transpilation. In der Praxis wendest du Backpropagation typischerweise nach der Transpilation an, aber dieses Beispiel dient nur zu Lehrzwecken. Erinnere dich, dass es Regeln für die Propagation einer Observablen an einem Gate vorbei gibt. Insbesondere gilt: Wenn ein CNOT-Gate das Ziel und die Kontrolle hat, wird eine Observable auf bei Rückwärtspropagation am CNOT-Gate vorbei zu : . Wenn du in diesem Beispiel-Circuit die Observable rückwärts durch die gesamte Leiter aus CNOT-Gates propagierst, erhältst du die Observable , in der üblichen Qiskit-Notation einfach . Wenn wir diese Observable statt nur messen, können wir die gesamte Leiter aus CNOT-Gates entfernen, was die Zwei-Qubit-Tiefe von 7 auf 2 verringert. Diese Observable erfordert weiterhin nur eine Messung in einer einzigen Basis pro Qubit, sodass sich die Anzahl der benötigten Shots nicht erhöht. Das ist nicht immer so. Im Allgemeinen erfordern kompliziertere Observablen mehr Shots und manchmal mehr Messungen in verschiedenen Basen.
Die Gesamtstrategie der Operator-Backpropagation umfasst die folgenden Schritte:
-
Den ausgeführten Circuit verkürzen
-
Die ursprüngliche Observable durch eine erweiterte Observable ersetzen
-
Circuit-Tiefe gegen erhöhten Sampling-Bedarf eintauschen
Der vorherige Circuit ist ein offensichtliches Beispiel, bei dem Backpropagation vorteilhaft ist. Im Allgemeinen ist es jedoch nicht einfach, die Circuits zu identifizieren, die am meisten von Backpropagation profitieren. Um zu entscheiden, wann du Backpropagation einsetzt, prüfe, wie viel Tiefe du aus deinem Circuit entfernen kannst, und wäge diese Verringerung gegen den erhöhten Sampling-Bedarf ab.
Propagated Noise Absorption (PNA)
Propagated Noise Absorption ist strukturell der Operator-Backpropagation ähnlich. Statt jedoch einen Operator rückwärts durch die idealen Gates eines Circuits zu propagieren, bezieht PNA ein gelerntes Rauschmodell ein und propagiert die Auswirkungen des Rauschens direkt in die Observable. PNA geht wie folgt vor:
-
Lernt das Rauschverhalten von der Hardware
-
Propagiert das Rauschmodell durch den Circuit
-
Erzeugt eine modifizierte Observable, die Gate-Rauschen kompensiert
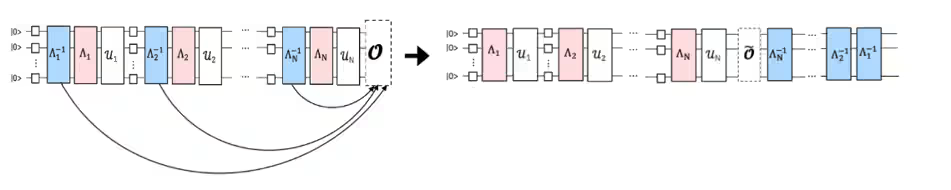
Wenn die modifizierte Observable auf verrauschter Hardware gemessen wird, nähern sich die resultierenden Erwartungswerte dem idealen rauschfreien Ergebnis besser an. PNA hat zwei Arten von Overhead. Erstens musst du das Rauschmodell lernen, was die Ausführung zusätzlicher Circuits erfordert. Zweitens kann PNA kompliziertere Observablen erzeugen, was den Sampling-Bedarf erhöhen kann.
Circuit Cutting
Circuit Cutting zerlegt einen großen Circuit in kleinere Subcircuits, die unabhängig voneinander ausgeführt werden können. Anschließend führst du genügend Messungen durch, um die Ergebnisse wieder zusammenzuführen. Circuit Cutting leistet Folgendes:
-
Verringert die Hardwareanforderungen
-
Ermöglicht Berechnungen, die größer sind als die verfügbare Qubit-Anzahl (breitere Circuits)
-
Hilft, Einschränkungen bei Tiefe und Konnektivität zu überwinden (tiefere Circuits)
-
Rekonstruiert das ursprüngliche Ergebnis durch klassische Nachverarbeitung

Samplomatic
Viele der Techniken aus den vorherigen Abschnitten ergänzen andere Methoden zur Unterdrückung und Minderung von Fehlern, die in diesem Kurs behandelt wurden, darunter:
-
Dynamical Decoupling
-
Pauli-Twirling
-
M3
-
TREX
-
Zero-Noise-Extrapolation (ZNE)
-
Probabilistic Error Cancellation (PEC)
In vielen Workflows kannst du verschiedene Techniken auf verschiedene Bereiche desselben Circuits anwenden. Wie wir gesehen haben, bringen viele dieser Techniken zudem einen Quanten-Overhead mit sich. Deshalb brauchen wir manchmal eine feine, detaillierte Kontrolle über Noise Learning, Sampling und die Anwendung von Twirling-Sequenzen. Das sind einige der Beweggründe hinter Samplomatic.
Samplomatic ist eine Open-Source-Bibliothek, die angepasste Sampling-, Randomisierungs- und Fehlerminderungs-Workflows ermöglicht.
Ihre erste Aufgabe besteht darin, einen Circuit zu analysieren und in beschriftete Bereiche, sogenannte Boxen, zu unterteilen. Diese Boxen erfüllen zwei Zwecke:
-
Sie unterteilen den Circuit visuell.
-
Sie erzeugen indizierte Bereiche, die unabhängig voneinander konfiguriert werden können.
Nutzer können Annotationen anhängen, die beschreiben, wie jede Box während der Ausführung behandelt werden soll. Beispiele sind:
-
Pauli-Twirling auf alle Boxen anwenden
-
Twirling nur auf ausgewählte Boxen anwenden
-
Unterschiedliche Twirling-Gruppen in verschiedenen Bereichen verwenden
-
Gelerntes Rauschen in bestimmte Layer einspeisen
-
Minderungsstrategien auf feingranularer Ebene anpassen
Samplomatic erkennt außerdem wiederholte Box-Bereiche. Da identische Layer typischerweise ähnliche Rauscheigenschaften aufweisen, musst du das Noise Learning nur einmal für jeden einzigartigen Layer durchführen.
Samplomatic-Ausgaben
Samplomatic erzeugt zwei primäre Objekte:
-
Template-Circuit
-
Samplex
Der Template-Circuit ist ein mit Boxen versehener, transpilierter, parametrisierter Circuit, der bereit zur Ausführung ist. Das Samplex enthält alle Informationen, die zum Erzeugen und Verarbeiten von Circuit-Varianten erforderlich sind. Der Inhalt des Samplex umfasst:
-
Parameterwerte für parametrisierte Circuits
-
Randomisierungsauswahlen
-
Sampling-Verteilungen
-
Informationen zur Nachverarbeitung
-
Zusätzliche Ausführungsmetadaten
Formal ist ein Samplex eine Wahrscheinlichkeitsverteilung über die Parameter eines Template-Circuits, zusammen mit Zusatzinformationen, die für die Ausführung und Nachverarbeitung erforderlich sind. Ein wichtiger praktischer Vorteil besteht darin, dass sowohl der Template-Circuit als auch das Samplex lokal auf der Client-Seite erstellt werden. Dadurch kannst du sie prüfen, validieren und debuggen, bevor du Hardwareressourcen verwendest.
Samplomatic bietet viele Vorteile, darunter fein abgestimmte Kontrolle über die adaptive Shot-Zuteilung und die Randomisierung. Es hat auch logistische Vorteile, etwa strukturierte Nachverarbeitungs-Workflows. Einer der wichtigsten Vorteile ist die Wiederverwendung gelernter Rauschinformationen über identische Layer hinweg, wodurch sich beim Noise Learning erhebliche Quantenrechenzeit einsparen lässt.
Shaded Lightcones
Bevor du entscheidest, wo du aufwendige Mitigationstechniken anwendest, ist es hilfreich, die Bereiche eines Circuits zu identifizieren, die für die gemessene Observable am wichtigsten sind. Dieser Bedarf motiviert das Addon Shaded Lightcones. Die Idee des Lichtkegels stammt aus der Relativitätstheorie, in der kausale Beziehungen durch die endliche Geschwindigkeit begrenzt sind, mit der sich Information ausbreiten kann.
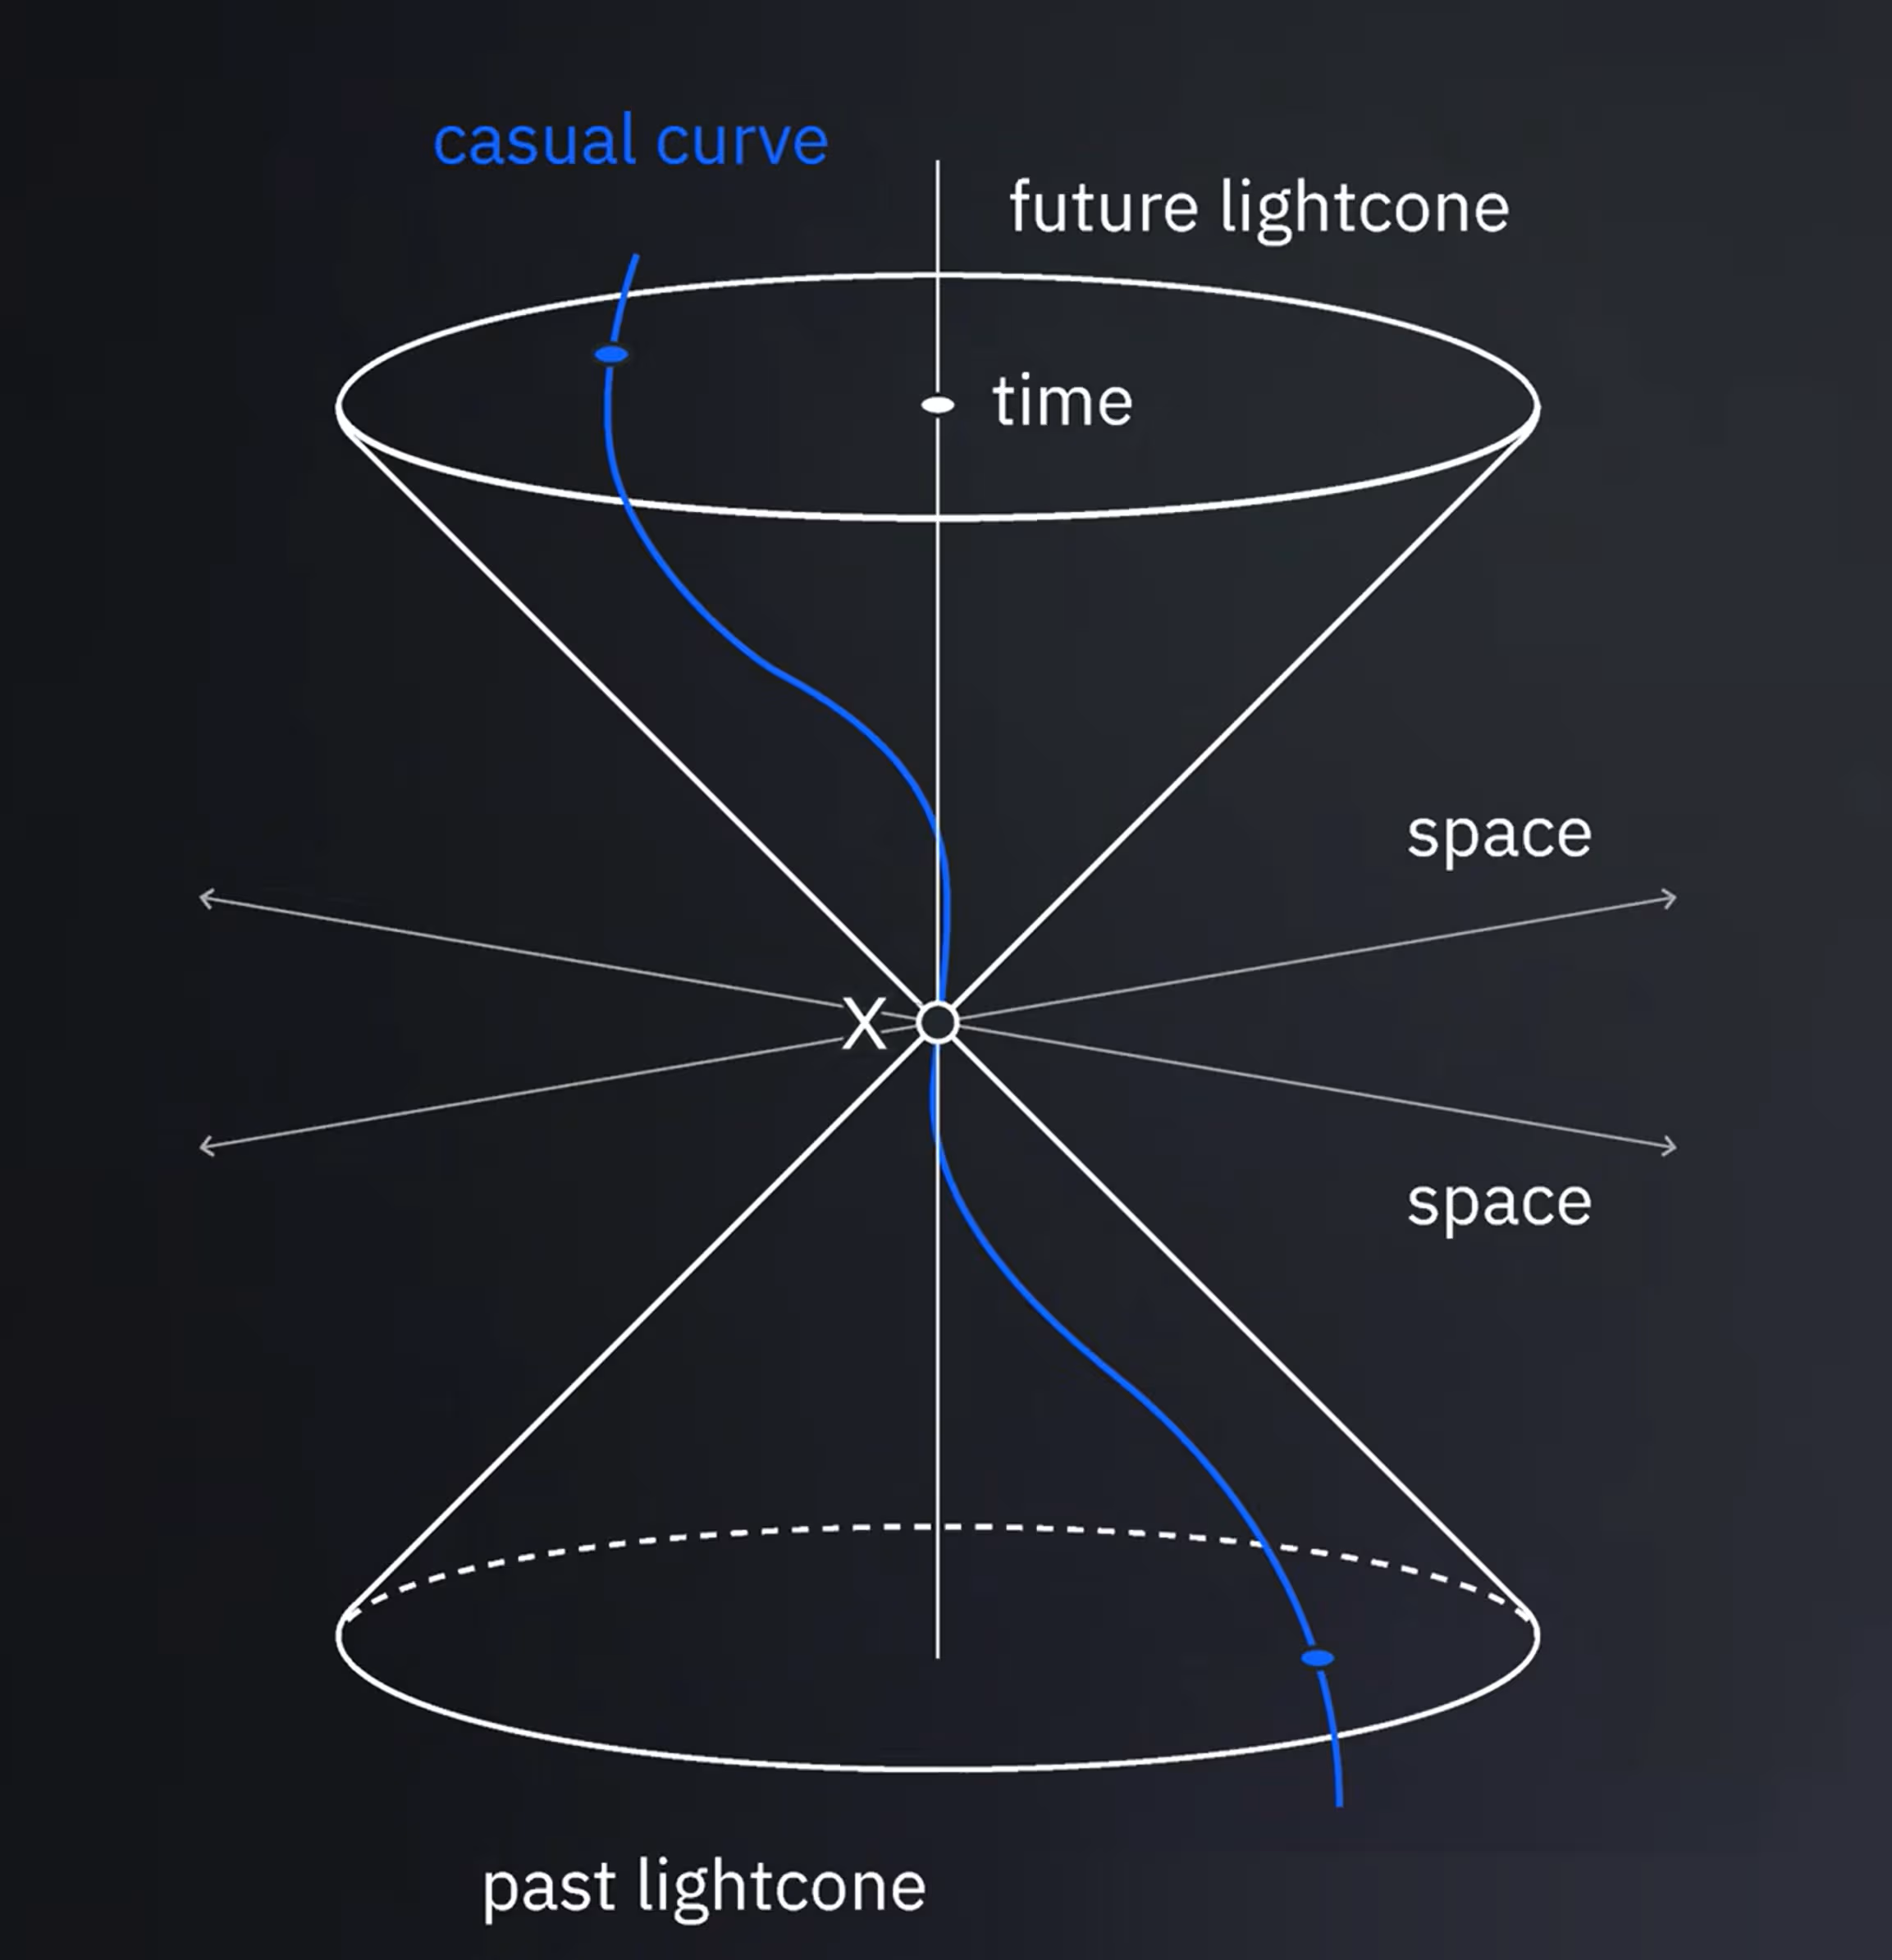
Ein ähnliches Konzept gilt für Quantencircuits.
Betrachte einen großen Circuit, bei dem nur eine Observable mit niedrigem Gewicht von Interesse ist. Eine Observable mit niedrigem Gewicht wirkt nur auf wenige Qubits nichttrivial. Observablen mit niedrigem Gewicht sind aus vielen Gründen interessant. Sie können zum Beispiel Folgendes darstellen:
-
Einzelne Terme innerhalb eines größeren Hamiltonoperators
-
Eine lokalisierte Wechselwirkungsregion
-
Information, die auf einer kleinen Menge von Ancilla-Qubits gesammelt wird
-
Andere Observablen, die nur wenige Qubits betreffen
Nicht jeder Fehler im Circuit kann das Messergebnis beeinflussen. Das gilt besonders für Pauli-Fehler oder jeden Fehler, der sich als Menge von Pauli-Operationen modellieren lässt. Sieh dir zum Beispiel den folgenden Circuit an:
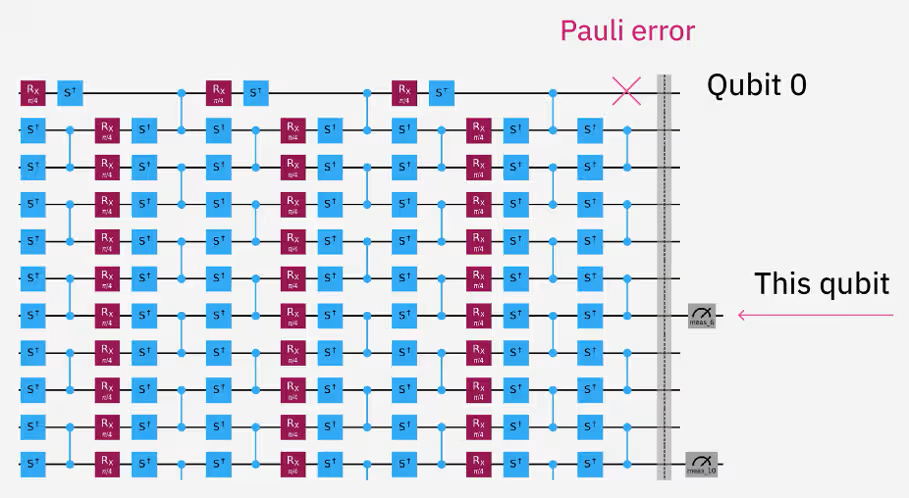
Ein Pauli-Fehler auf Qubit 0 in der letzten Layer kann die Messung auf Qubit 6 nicht beeinflussen, da es kein verbindendes Gate gibt, das den Fehler von Qubit 0 auf Qubit 6 übertragen könnte. Beachte, dass dieses Argument nicht für bestimmte nicht-unitäre Fehler gilt. Zum Beispiel lässt ein T1-artiger Übergang in den Grundzustand auf Qubit 0 das Qubit 0 in einen Zustand der Rechenbasis kollabieren. Wenn die Qubits 0 und 6 zuvor verschränkt waren (wie in diesem Circuit), kann der nicht-unitäre Fehler auf Qubit 0 Qubit 6 beeinflussen. Die folgende Diskussion konzentriert sich auf Fehler, die sich als Pauli-Operationen oder als probabilistische Mischungen von Pauli-Operationen darstellen lassen.
In der letzten Layer kann nur ein Pauli-Fehler auf Qubit 5 oder Qubit 6 die Messung auf Qubit 6 direkt beeinflussen.
In der davorliegenden verschränkenden Layer sind die Qubits 5 und 6 mit den Qubits 4 bzw. 7 verschränkt. Daher kann ein Pauli-Fehler auf einem dieser vier Qubits in dieser verschränkenden Layer oder kurz davor die spätere Messung beeinflussen. Du kannst den Circuit weiter rückwärts verfolgen, um die Teilmenge der Gates und Qubits zu finden, die kausal mit der Messung verbunden sind. Diese kausale Menge bildet in Raum (Qubits) und Zeit (Layer) eine kegelförmige Region, woher der Begriff Lichtkegel stammt. Die genaue Form der Region variiert von Circuit zu Circuit. Da diese Analyse von der Hardware-Konnektivität und der Platzierung der Gates abhängt, ist sie nach der Transpilation, dem Routing und der Layout-Optimierung am nützlichsten.
Jenseits der kausalen Konnektivität
Shaded Lightcones erweitern diese Idee, indem sie zusätzlich berücksichtigen, welche Fehlertypen eine Rolle spielen.
Beachte zum Beispiel Folgendes:
-
Ein Z-Fehler unmittelbar vor einer Messung in der Z-Basis hat keinen Einfluss auf das Messergebnis.
-
Ein X-Fehler unmittelbar vor einer Messung in der Z-Basis kann das Ergebnis drastisch verändern.
Manche Fehlertypen verdienen daher mehr Mitigationsaufwand als andere. Diese Unterscheidung kann den Overhead von Techniken wie PEC erheblich verringern. In der Praxis erzeugt das Addon separate Sensitivitätsanalysen für jeden der folgenden Fehlertypen:
-
X errors
-
Z errors
-
Y-Fehler (oder XZ bis auf eine Phase)
Diese Fehlersensitivität sieht für jeden Fehlertyp im Allgemeinen anders aus, weil unterschiedliche kausal verbundene Fehler unterschiedliche Auswirkungen auf die Messung haben. Beachte außerdem, dass sich die Sensitivität im Verlauf des Circuits ändert. Ein X-Fehler unmittelbar vor der Messung kann sehr schädlich sein, während ein Fehler, der viele Layer früher auftritt, nach der Ausbreitung durch einen stark verschränkten Zustand eine geringere Wirkung haben kann.
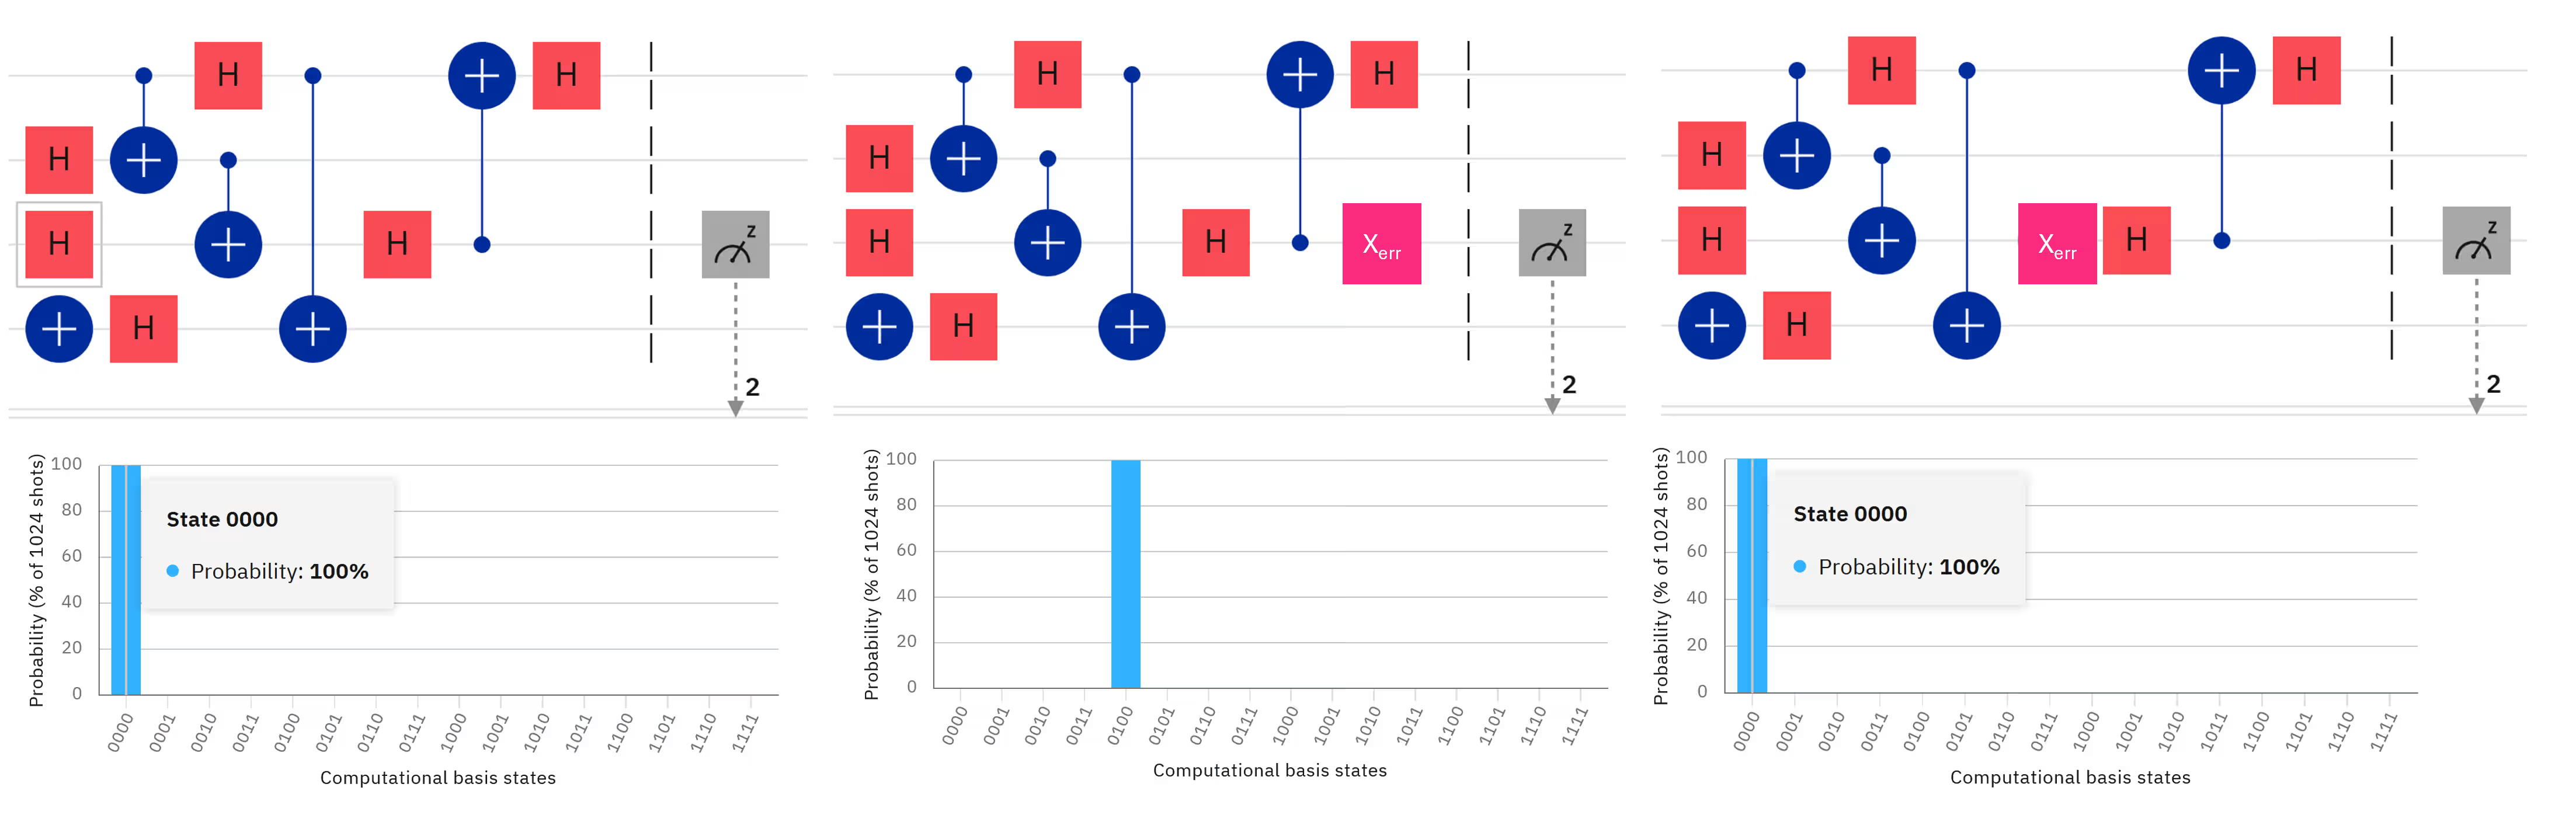
Shaded Lightcones quantifizieren diesen Unterschied, indem sie potenziellen Fehlern im gesamten Circuit einen Sensitivitätswert zuweisen.
Die resultierenden Karten zeigen Folgendes an:
-
Wo Fehler eine Rolle spielen
-
Welche Fehlertypen eine Rolle spielen
-
Wie stark sie die finale Observable beeinflussen
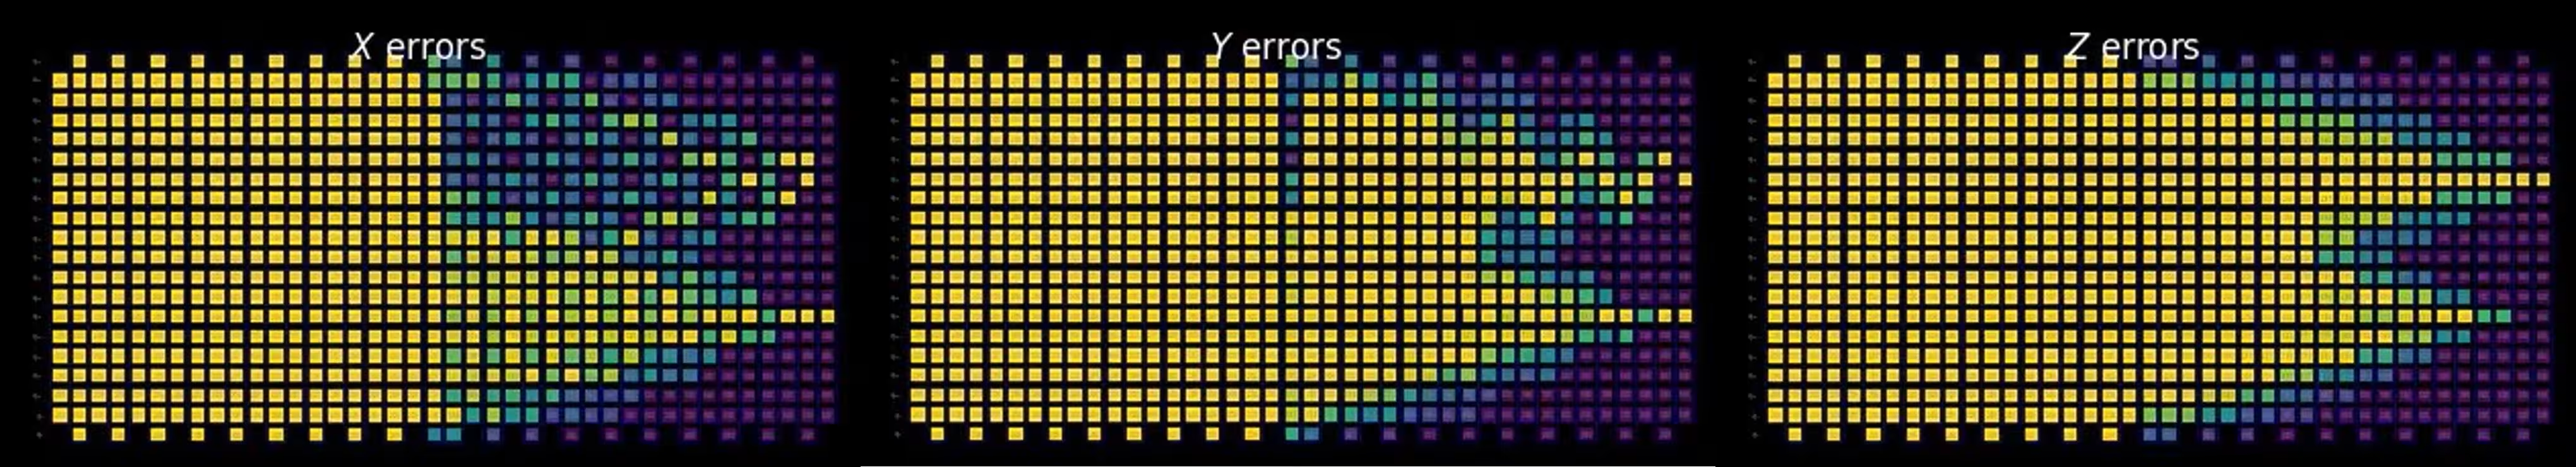
Shaded Lightcones mitigieren Fehler nicht selbst, können aber helfen, den Mitigationsaufwand dort zu konzentrieren, wo er den größten Nutzen bringt.
Rauschen lernen und injizieren
Nachdem ein Circuit erstellt, optimiert und annotiert wurde, bleiben zwei komplementäre Aufgaben: das Rauschen zu lernen und das Rauschmodell zu verwenden (zum Beispiel, um Rauschen zu injizieren oder die Auswirkungen des Rauschens zu propagieren).
NoiseLearnerV3
NoiseLearnerV3 ist das aktuelle Werkzeug für das Noise Learning. Die frühere NoiseLearner-Schnittstelle akzeptierte vollständige Circuits und erzeugte Pauli-Lindblad-Rauschmodelle. NoiseLearnerV3 arbeitet stattdessen direkt auf Circuit-Anweisungen in Boxen. Zusammengefasst tut NoiseLearnerV3 Folgendes:
-
Akzeptiert Sammlungen beschrifteter Circuit-Layer
-
Verwendet Informationen aus wiederholten Layern wieder
-
Unterstützt das Lernen von Messrauschen
-
Unterstützt die Nachverarbeitung gelernter Modelle
-
Ermöglicht Workflows zur Rauschinjektion und -skalierung
Dieses Design passt eng zum Layer-orientierten Workflow von Samplomatic. Insbesondere verwendet NoiseLearnerV3 für jede Anweisungsmenge die folgenden Methoden:
-
Pauli-Lindblad-Lernen für Gate-Operationen
-
TREX-basiertes Lernen für Messungen
Du kannst ein gelerntes Rauschmodell dann in vielen der Methoden verwenden, die wir bereits behandelt haben. Erinnere dich zum Beispiel daran, dass Zero-Noise-Extrapolation (ZNE) mit Gate-Folding zu nicht handhabbar tiefen Circuits führen kann. Die alternative Methode zur Skalierung des Rauschens bestand in diesem Fall darin, aus einem bekannten Rauschmodell zu samplen, was das Rauschniveau effektiv erhöht, sogar um nicht ganzzahlige Faktoren. Diese Methode, die probabilistische Fehleramplifikation (PEA), ist ein gutes Beispiel dafür, wie du ein Rauschmodell zur Fehlermitigation nutzen kannst. Ein gutes Rauschmodell ist auch für die probabilistische Fehlerauslöschung (PEC) und die propagierte Rauschabsorption (PNA) erforderlich.
Kurz gesagt: Mit einem hochwertigen Rauschmodell wird Rauschen zu einer programmierbaren Ressource und nicht mehr nur zu einer Fehlerquelle.
Shaded Lightcones im Vergleich zu NoiseLearnerV3
NoiseLearnerV3 und SLC sind eng verwandt, haben aber unterschiedliche Eingaben und beantworten unterschiedliche Fragen. SLC bestimmt, worauf der Mitigationsaufwand konzentriert werden soll. NoiseLearnerV3 charakterisiert das tatsächlich vorhandene Rauschen in diesen Bereichen. Diese Prozesse sind außerdem mit unterschiedlichen Arten von Overhead verbunden. Die folgende Tabelle fasst diese Unterschiede zusammen.
| Shaded Lightcones | NoiseLearnerV3 | |
|---|---|---|
| Zweck | Identifiziert, wo Mitigation wichtig ist | Lernt, wie sich Fehler verhalten |
| Overhead | Hauptsächlich klassischer Overhead | Erfordert Hardwareausführungen |
| Ausgabe | Erzeugt Sensitivitätskarten | Erzeugt Beschreibungen von Rauschkanälen |
| Eingabe | Verwendet Circuit-Struktur und Operatorpropagation | Verwendet Circuit-Struktur und experimentelle Hardwaredaten |
Executor und Runtime-Ausführung
Executor führt den abschließenden Ausführungsschritt durch. Er kann mit einer der folgenden Eingaben arbeiten:
-
Einem von Samplomatic erzeugten Template-Circuit und Samplex
-
Einem herkömmlichen Quantencircuit ohne Samplomatic
Durch diese Flexibilität kannst du so viele oder so wenige Komponenten des Workflows der gerichteten Ausführung übernehmen, wie du brauchst.
Executor arbeitet eng mit Samplomatic zusammen, das Randomisierungsentscheidungen, Shot-Zuteilung, Auswahlen zur Rauschinjektion und zugehörige Ausführungsmetadaten verwaltet, wie zuvor beschrieben.
Praktische Beispiele für das Modell der gerichteten Ausführung findest du im Leitfaden Modell der gerichteten Ausführung sowie in den Tutorials und der Dokumentation der Qiskit-Addons auf der IBM Quantum® Platform.
Fazit
Moderne Quanten-Workflows stützen sich zunehmend auf eine Sammlung komplementärer Werkzeuge statt auf ein einzelnes Ausführungsprimitiv.
Diese Werkzeuge unterstützen jede Phase des Workflows:
-
Problemabbildung
-
Circuit-Konstruktion
-
Transpilation und Optimierung
-
Fehlerunterdrückung
-
Fehlermitigation
-
Noise Learning
-
Strukturierte Ausführung
-
Nachverarbeitung
Zusammen bieten Werkzeuge wie Samplomatic, Executor, NoiseLearnerV3, Shaded Lightcones, propagierte Rauschabsorption, Circuit Cutting und AQC-Tensor deutlich mehr Kontrolle als frühere Ausführungsmodelle.
Das Feld entwickelt sich weiterhin rasant. Mit größeren und stärker vernetzten Quantenprozessoren werden diese Techniken voraussichtlich eine immer wichtigere Rolle dabei spielen, nützlichen Quantenvorteil zu erreichen und sich schließlich nahtlos in fehlertolerante Quantencomputing-Workflows zu integrieren.