Fehlermitigation
Diese Lektion vermittelt Hintergrundwissen zu verschiedenen Techniken der Fehlermitigation, damit du ein Gespür dafür entwickelst, wie und wann sie am besten eingesetzt werden. Wichtig: Moderne Anwendungen dieser Techniken nutzen ausgefeiltere Werkzeuge wie Samplomatic, Shaded Lightcones und Executor. Diese Workflows werden in späteren Lektionen behandelt.
Dieses Video gibt einen Überblick über Techniken der Fehlermitigation. Der folgende Text liefert mehr Details und untersucht diese Methoden mit Qiskit.
Überblick über Techniken der Fehlermitigation
Fehlermitigation bezeichnet jeden Prozess, der versucht, die Auswirkungen von Fehlern in Quantenberechnungen zu verringern, nachdem sie aufgetreten sind. Sie unterscheidet sich von der Fehlerunterdrückung, die versucht, Fehler zu verhindern, und von der Fehlerkorrektur, die Informationen über viele physikalische Qubits kodiert und die Konsistenz dieser Informationen prüft, um die Information in einem einzelnen logischen Qubit zu bewahren. In dieser gesamten Lektion lassen sich Techniken der Fehlermitigation am besten als Methoden verstehen, bessere Schätzer idealer Erwartungswerte oder bessere Sampler von Wahrscheinlichkeitsverteilungen zu konstruieren, nicht als Methoden zur Korrektur von Quantenzuständen während der Ausführung. Wir untersuchen die folgenden Methoden der Fehlermitigation, die alle in Qiskit und seinen Addons verfügbar sind und vielversprechende Werkzeuge auf dem Weg zum Quantenvorteil darstellen.
Twirled Readout Error Extinction (TREX) randomisiert den Messprozess, indem vor der Messung zufällig ausgewählte Pauli-Operationen angewendet und ihre bekannten Effekte auf die beobachteten Bitstrings anschließend klassisch rückgängig gemacht werden. Unter geeigneten Annahmen über das Messrauschen wandelt dies den Auslesefehlerkanal in eine einfachere und symmetrischere Form um, die sich leichter kalibrieren und mitigieren lässt.
Matrix-free Measurement Mitigation (M3) ist eine skalierbare Technik zur Mitigation von Messfehlern, die es vermeidet, die Zuordnungsmatrix oder ihre Inverse explizit aufzubauen.
Zero-Noise-Extrapolation (ZNE) approximiert den Wert, den eine Observable ohne Rauschen hätte, indem das Rauschen künstlich um einen bekannten Faktor skaliert und auf den rauschfreien Fall zurückextrapoliert wird. Dies setzt voraus, dass das Rauschen auf vorhersehbare Weise skaliert. Diese Vorhersehbarkeit kann weitere in dieser Lektion besprochene Methoden erfordern (Pulse Stretching, Gate Folding und Probabilistic Error Amplification (PEA)).
Probabilistic Error Cancellation (PEC) gehört zu den leistungsfähigsten, aber auch rechenaufwendigsten Techniken der Fehlermitigation. Sie lernt das Rauschverhalten des Systems und versucht, das Rauschen rückgängig zu machen, indem sie statistisch eine erwartungstreue Schätzung der idealen Berechnung konstruiert. PEC liefert statistisch korrigierte Observablen, keine fehlerkorrigierten Ergebnisse.
Wir tauchen nun in jede dieser Methoden ein.
M3
Messfehler gehören zu den hartnäckigsten und hardwarespezifischsten Rauschquellen in Quantengeräten der nahen Zukunft. Selbst wenn ein Quantenzustand korrekt präpariert und entwickelt wurde, kann der abschließende Auslesevorgang das tatsächliche Ergebnis in der Rechenbasis falsch melden. Diese Fehler entstehen durch unvollkommene Unterscheidung zwischen den physikalischen Zuständen, die und entsprechen, durch Relaxation während der Messung und durch Unvollkommenheiten der Messelektronik. Dadurch ist die beobachtete Verteilung der Bitstrings oft eine verzerrte Version der wahren (idealen) Verteilung, bei der Wahrscheinlichkeit fälschlich zwischen Ergebnissen umverteilt wird.
Die Messmitigation löst dieses Problem, indem sie explizit modelliert, wie Messergebnisse falsch zugeordnet werden. In der Standardformulierung wird dieses Verhalten durch eine Zuordnungsmatrix erfasst, deren Elemente die Wahrscheinlichkeit angeben, das Ergebnis aufzuzeichnen, wenn der wahre Basiszustand war. Wenn das Messrauschen klassisch und stationär ist, hängt der beobachtete Wahrscheinlichkeitsvektor über eine einfache lineare Beziehung mit der idealen Verteilung zusammen,
Beachte, dass die Zuordnungsmatrix eine klassische stochastische Abbildung ist, kein Quantenkanal. Sie wirkt auf klassische Ausleseergebnisse, nicht auf die zugrunde liegenden Quantenzustände, die zur Gewinnung der Ausleseergebnisse gesampelt wurden.
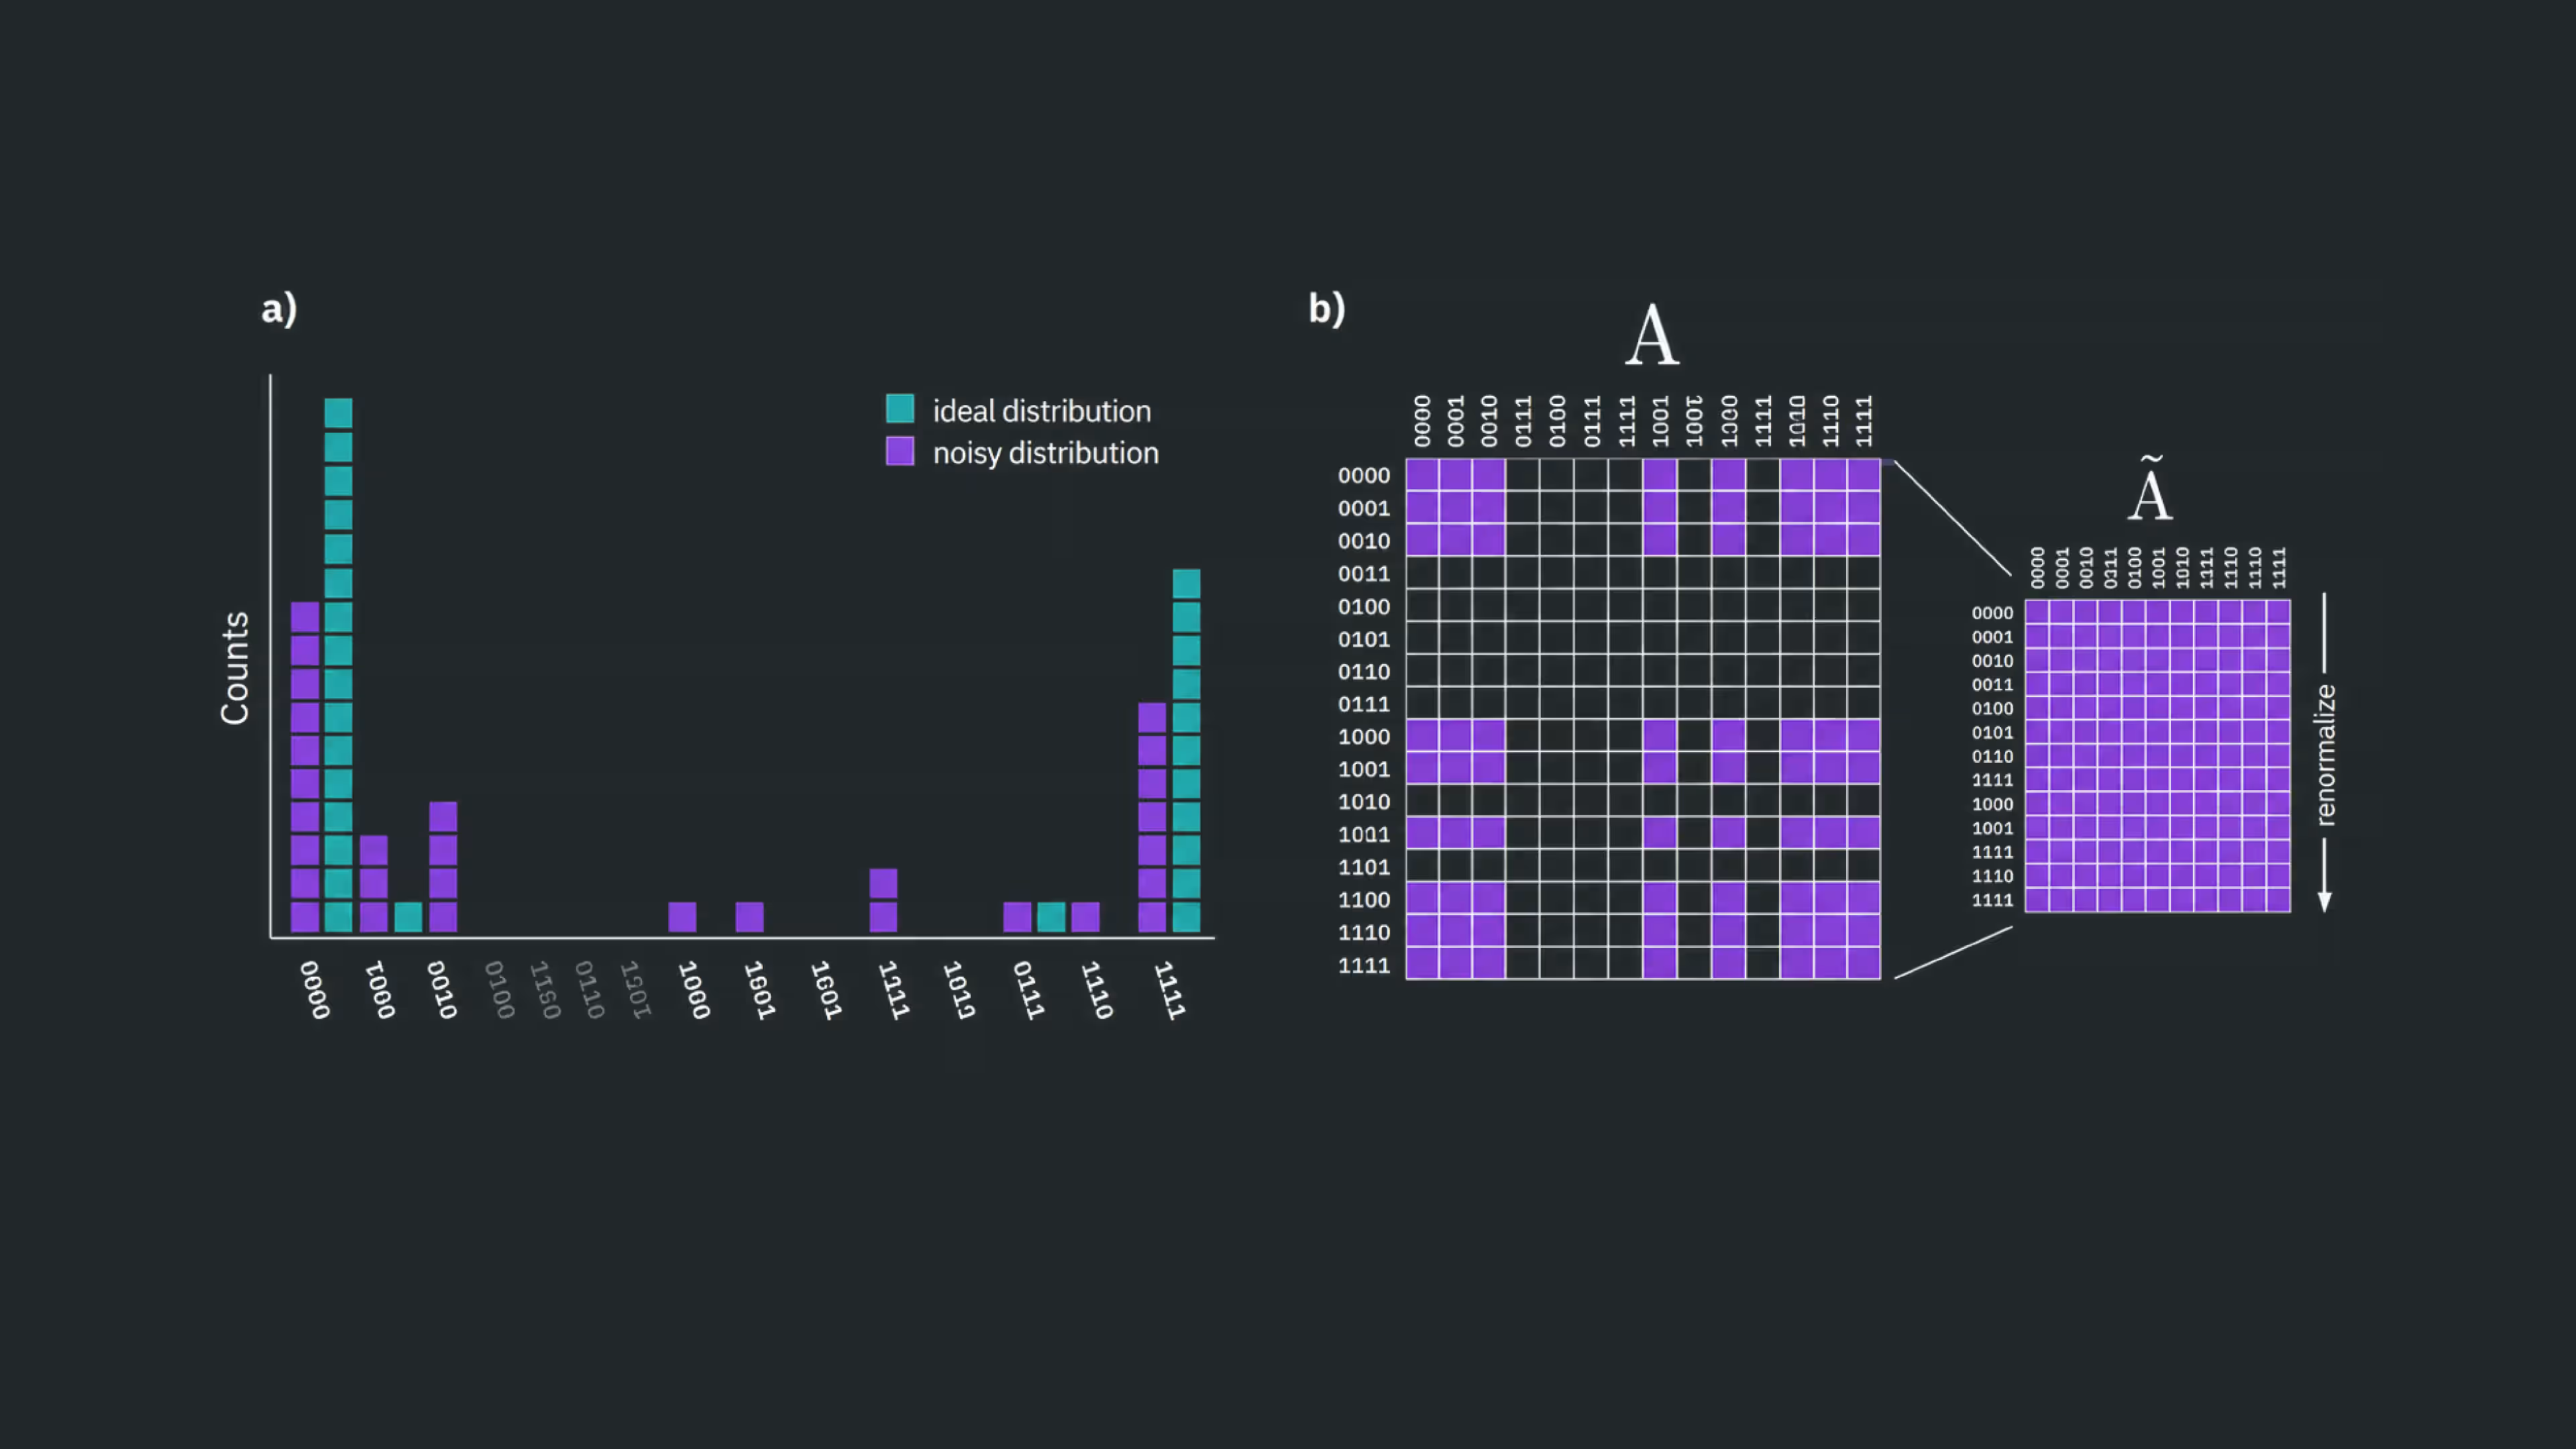
Matrix-free Measurement Mitigation (M3) nutzt diese Struktur, um eine mitigierte Schätzung von zu konstruieren, ohne jemals die vollständige Matrix aufzubauen oder zu invertieren, was bei vielen Qubits nicht machbar wäre. Stattdessen nutzt M3 die Tatsache, dass viele Quanten-Workloads der nahen Zukunft stark gepeakte Verteilungen mit niedriger Entropie erzeugen, sodass sich die Mitigation nur auf die Teilmenge der Ergebnisse konzentriert, die wesentlich zur beobachteten Verteilung beitragen.
Um das Zuordnungsmodell aufzubauen, müssen zusätzliche Kalibrierexperimente auf der Quantenhardware ausgeführt werden. Dabei werden typischerweise bekannte Zustände der Rechenbasis präpariert und aufgezeichnet, wie das Messsystem sie meldet. Der Kalibrieraufwand skaliert mit der Anzahl der gemessenen Qubits, während die Rechenkosten der Mitigation von der Struktur der beobachteten Verteilung abhängen. Diese Kosten sind weit geringer als der Aufwand, die vollständige -Zuordnungsmatrix explizit zu charakterisieren. Dieser Kalibrieraufwand ist zwar real, aber im Vergleich zu Techniken auf Circuit-Ebene wie Zero-Noise-Extrapolation oder Probabilistic Error Cancellation gering, was M3 zu einem praktischen und weit verbreiteten Werkzeug zur Mitigation von Auslesefehlern in Quantenexperimenten der nahen Zukunft macht.
Beachte, dass die Kalibrierung nur insoweit nützlich ist, als der Messprozess zwischen den Kalibrierläufen und dem Zielexperiment hinreichend stabil bleibt.
Zunächst führen wir einen einfachen Fall von Hand durch, um die Funktionsweise zu veranschaulichen, und verwenden dann in Qiskit integrierte Werkzeuge, um M3 in einem realistischeren Maßstab zu zeigen.
Kleines M3-Beispiel
Wir beginnen mit dem Aufbau eines einfachen Bell-Zustands.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Wir können einen Simulator mit Rauschmodell verwenden, weil wir dieses Beispiel auf einen sehr kleinen Circuit beschränken. Wir konfigurieren unser Rauschmodell explizit mit einem Auslesefehler der folgenden Form:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Diese Auslesefehlerraten sind viel höher als bei echten IBM®-Quantencomputern. Die hohen Werte wurden aus didaktischen Gründen gewählt, damit wir den Effekt von M3 deutlich sehen können.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Wir können den Circuit auf dem verrauschten Simulator ausführen, um die Auswirkungen des Auslesefehlers zu beobachten.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
In unserem Spielbeispiel haben wir den Auslesefehler für unser Rauschmodell definiert. Bei einem echten Quantencomputer ist der Auslesefehler jedoch a priori nicht bekannt. Stattdessen muss er experimentell geschätzt werden. Dafür erstellen wir Circuits, die ein Qubit in einem bekannten Zustand der Rechenbasis oder präparieren, und messen es. Ohne Auslesefehler würden wir genau den präparierten Zustand messen. Durch das Sammeln von Statistiken aus diesen Messungen können wir eine Zuordnungsmatrix aufbauen, die den Auslesefehler beschreibt. In diesem Spielbeispiel sollte sie der von uns definierten ähneln.
Für ein realistischeres System müssten Statistiken für jedes physikalische Qubit gesammelt werden. Das ist manchmal nicht trivial, weil die Transpilation einen abstrakten Circuit auf die Hardware abbildet und sich die Qubit-Nummer ändert. Darauf kommen wir im nächsten Beispiel zurück. In diesem Simulatorbeispiel haben wir jedem Qubit dasselbe Auslesefehlermodell zugewiesen, sodass eine einzige Charakterisierung genügt.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Beachte, dass dies der Auslesefehlermatrix, mit der der Simulator aufgebaut wurde, sehr nahe kommt.
Auch hier hätten wir bei einem echten Quantencomputer solche Statistiken für mehrere physikalische Qubits. Für diesen Simulator nehmen wir an, dass die beiden Qubits identische und unabhängige Auslesefehler haben, sodass wir die Zwei-Qubit-Zuordnungsmatrix A_2q als Tensorprodukt der entsprechenden Ein-Qubit-Matrizen konstruieren können. Beachte außerdem, dass es bei M3 nicht darum geht, die gesamte Zuordnungsmatrix aufzubauen. Stattdessen konzentriert sich M3 auf die Teilmenge der Ergebnisse, die wesentlich zur beobachteten Verteilung beitragen. Wir bauen für unser sehr kleines Beispiel die gesamte Matrix auf, um zu sehen, wie es funktioniert. Die Implementierung von M3 in qiskit-ibm-runtime ist ausgefeilter als dieses Spielbeispiel, weil sie viele Qubits mit unterschiedlichen Ausleseeigenschaften verarbeiten muss und dennoch den Aufbau der vollständigen Zuordnungsmatrix vermeidet.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Für dieses Beispiel nehmen wir an, dass Auslesefehler auf verschiedenen Qubits unabhängig sind, sodass die Zwei-Qubit-Zuordnungsmatrix als Tensorprodukt der entsprechenden Ein-Qubit-Matrizen konstruiert werden kann.
Wir erhalten die rohen und die mitigierten Ergebnisse zum Vergleich.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
An diesem Punkt haben wir experimentell charakterisiert, wie der Messprozess die idealen Ergebniswahrscheinlichkeiten verzerrt. Unser Ziel ist nun, diese Verzerrung rückgängig zu machen und die resultierende Korrektur auf die rohen Wahrscheinlichkeiten anzuwenden.
Da wir eine lineare Inversion statt einer physikalischen Korrektur durchführen, müssen die resultierenden "Wahrscheinlichkeiten" nicht immer positiv sein. Sehr kleine negative Quasi-Wahrscheinlichkeiten sind zu erwarten und spiegeln die Tatsache wider, dass die Messmitigation einen Schätzer und keine physikalische Wahrscheinlichkeitsverteilung erzeugt.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Wir wandeln diese zum Plotten in Counts um.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Schließlich betrachten wir die rohe, die mitigierte und die ideale Verteilung. Die mitigierten "Counts" unten sind nur eine Visualisierungshilfe, die durch Umskalieren der mitigierten Quasi-Wahrscheinlichkeiten gewonnen wurde.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
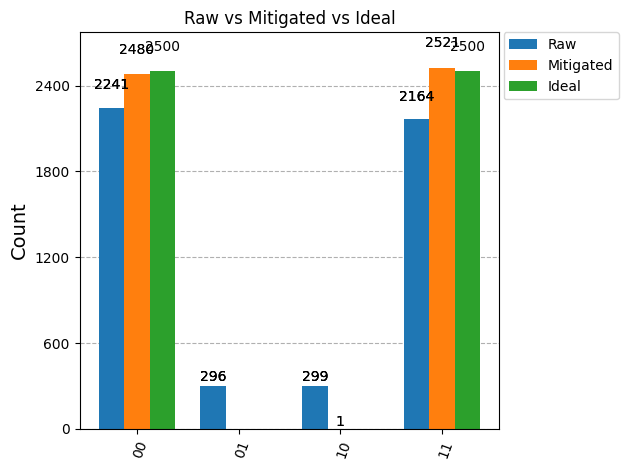
Die M3-mitigierten Ergebnisse liegen eindeutig viel näher an den idealen Verteilungen, und wir können sehen, warum.
Die Anwendung von M3 auf realistischere Workflows ist deutlich komplexer. Bedenke:
- Echte Quantencomputer enthalten viele physikalische Qubits, jedes mit eigenen Auslesefehlereigenschaften. Diese Fehler müssen modelliert und angemessen kombiniert werden.
- Die vollständige Zuordnungsmatrix wächst exponentiell mit der Anzahl der Qubits und lässt sich schnell nicht mehr praktikabel explizit aufbauen. Deshalb konzentriert sich M3 auf die Teilmenge der Ergebnisse, die wesentlich zur beobachteten Verteilung beitragen, statt die gesamte Zuordnungsmatrix aufzubauen.
- Bei realen Problemen von Interesse ist die ideale Verteilung möglicherweise nicht bekannt.
Aus all diesen Gründen ist der vollständige Mitigations-Workflow im Qiskit-Addon mthree gekapselt.
Größeres M3-Beispiel
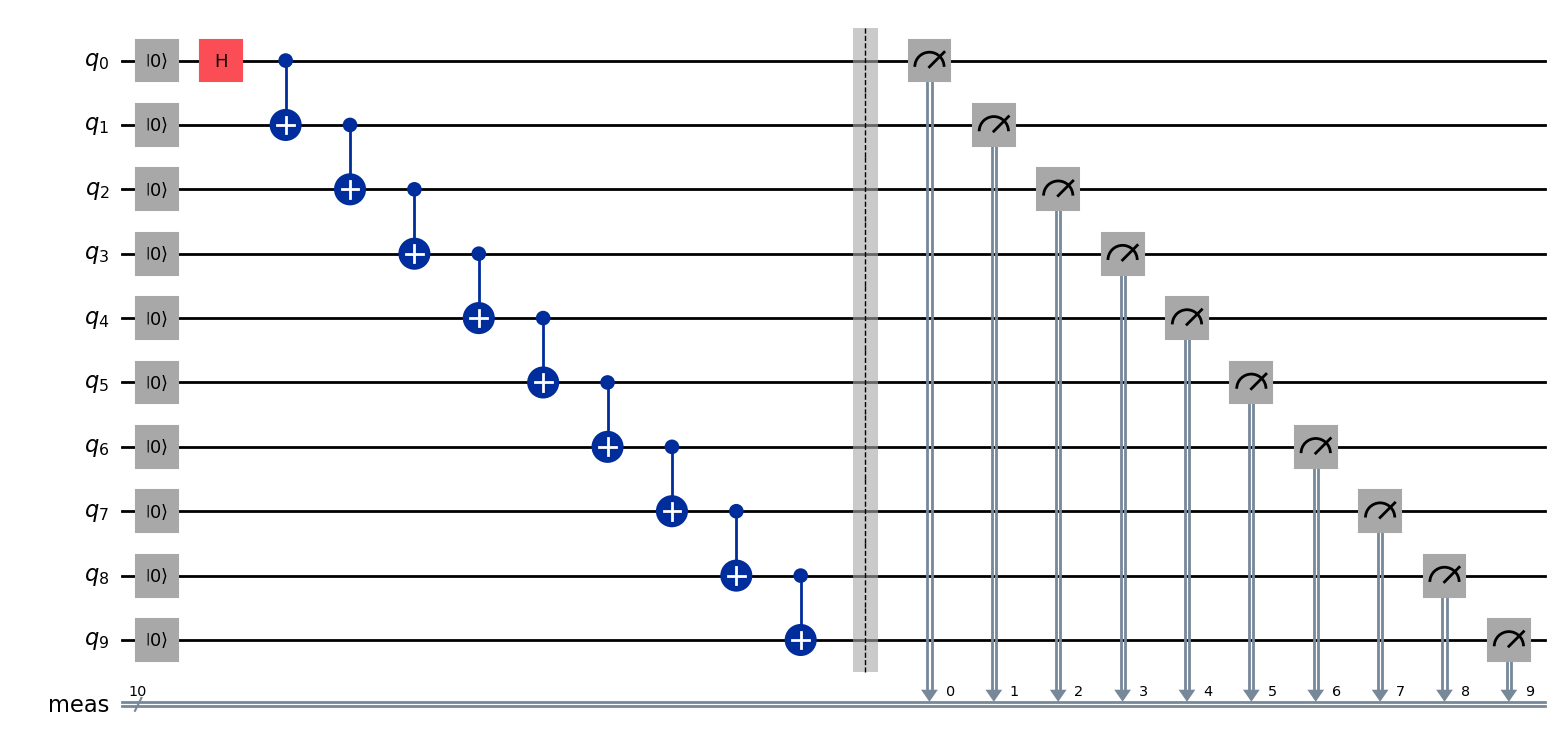
Wir wenden M3 nun auf einen größeren Circuit an, bei dem die Bestimmung des relevanten Unterraums von von Hand umständlich wäre, der aber immer noch einfach genug ist, dass wir die ideale Verteilung kennen: ein GHZ-Zustand. Wir beginnen mit dem Importieren des Pakets mthree und der Definition eines GHZ-Quantencircuits.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
Um dies auf einem echten Quantencomputer auszuführen, importieren wir qiskit_ibm_runtime und weitere benötigte Pakete. Wir verwenden SamplerV2, um eine Verteilung der Ausgaben zu erhalten.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Nun transpilieren wir den Circuit für unser Backend. Wir setzen das Optimierungslevel hier auf 0, um uns auf die Effekte von M3 zu konzentrieren, ohne zusätzliche Werkzeuge einzubeziehen. Das bedeutet, dass die endgültige Fidelity nicht repräsentativ dafür ist, was auf IBM Quantum®-Hardware mit der vollen Palette verfügbarer Werkzeuge erreichbar ist, aber so können wir uns gezielt auf den Nutzen von M3 konzentrieren.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Wir konfigurieren nun den Sampler, wobei wir zusätzliche Techniken zur Fehlerunterdrückung wie Dynamical Decoupling und Twirling erneut deaktivieren.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Schließlich führen wir unseren Job aus.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Wir können die rohen Counts aus dem obigen Circuit extrahieren.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Nun führen wir mthree auf unserem Backend aus, um das für die Messmitigation verwendete Zuordnungsmodell zu charakterisieren. Mit diesen Informationen skalieren wir die rohe Verteilung um. Beachte, dass dies manchmal zu sehr kleinen negativen Wahrscheinlichkeiten führen kann (daher der Begriff Quasi-Wahrscheinlichkeiten).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Die mthree-Korrektur erzeugt Quasi-Wahrscheinlichkeiten statt Counts. Wir können von Hand in Counts umskalieren. Die folgende Hilfsfunktion wandelt in Counts um und rundet auf ganzzahlige Werte. Außerdem gibt es bei großen Circuits viele fehlerhafte Strings mit sehr wenigen Counts, die ein Histogramm unübersichtlich machen. Die zweite Hilfsfunktion unten entfernt alle Strings mit weniger Counts als einem von uns gewählten Schwellenwert, damit wir die dominanten Terme der Verteilung klar sehen.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Zum Vergleich können wir auch leicht die theoretische, ideale Verteilung erzeugen, in der der Null-Zustand und der Eins-Zustand gleiche Wahrscheinlichkeiten haben und alle anderen Ergebnisse die Wahrscheinlichkeit null.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Schließlich können wir unsere Ergebnisse visualisieren.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
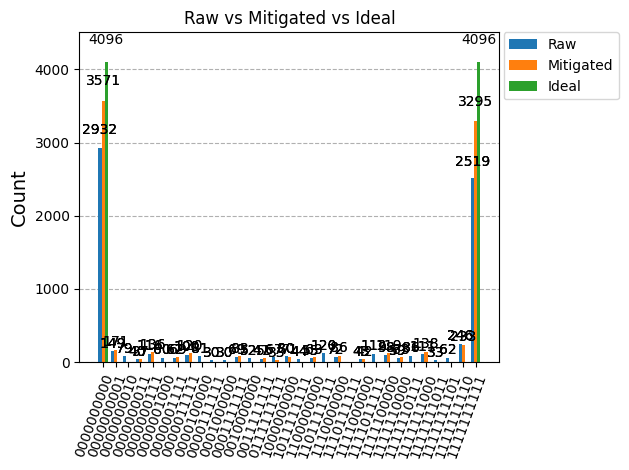
Die mitigierten Ergebnisse liegen näher an der idealen Verteilung als die nicht mitigierten. Anhand der Counts für die idealen Bitstrings können wir das besser quantifizieren.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Dieses einfache Werkzeug hat unsere Fidelity mit recht geringem Aufwand um 26 % gegenüber der nicht mitigierten Fidelity verbessert. M3 kann eindeutig sehr wertvoll sein. Der GHZ-Circuit wurde jedoch als guter Anwendungsfall gewählt, weil er auf zwei Ausgabezuständen stark gepeakt ist. Manche Probleme führen zu gleichmäßiger verteilten Counts (Zustände mit hoher Entropie). Bei sehr tiefen Circuits mit vielen Qubits führen Gate-Fehler und nicht messbezogenes Rauschen oft zu einem Zustand mit hoher Entropie. In solchen Fällen arbeitet M3 auf einem recht großen Zustandsraum. Dafür gibt es drei mögliche Ansätze:
(1) Akzeptiere, dass dies eine Einschränkung von M3 ist.
(2) Beachte, dass die obere Schranke für den Raum der von M3 gebildeten Matrix num_shots num_shots beträgt statt , wobei Ersteres für eine große Anzahl von Qubits viel kleiner ist.
(3) Entferne nur mit großer Vorsicht Bitstrings mit sehr geringer Wahrscheinlichkeit aus den rohen Counts, die in M3 eingespeist werden. Dies kann einen Bias einführen, und die Einschränkung des Trägers deiner Zustände kann die Konvergenz bei Ansätzen wie der Krylov-Methode beeinträchtigen. Das sollte nur geschehen, wenn du genau weißt, warum du es tust, und alle Auswirkungen vorhersehen kannst. Deshalb ist ein solches Trimmen keine integrierte Funktion von M3.
Weitere Informationen zum Qiskit-Addon mthree findest du in seiner Dokumentation mit Beispielen, Installationsanleitungen, Hintergrund und API-Referenzen.
Twirled Readout Error Extinction (TREX)
Twirled Readout Error Extinction (TREX) ist eine Technik zur Mitigation von Messfehlern, die auf modernen Quantencomputern eingesetzt wird. Ihr Ziel ist es, den durch klassische Auslesefehler verursachten Bias zu entfernen, ohne die Zuordnungsmatrix der Messung vollständig charakterisieren oder invertieren zu müssen.
TREX ist keine Fehlerkorrektur und verbessert nicht die Zustandsfidelity. Stattdessen stellt sie sicher, dass Schätzer für Erwartungswerte bezüglich des Ausleserauschens bis auf den statistischen Fehler erwartungstreu sind, indem über randomisierte Messbasen gemittelt und umskaliert wird. Auf IBM Quantum-Hardware ist TREX die Standardmethode zur Mitigation bei der Erwartungswertschätzung und entspricht resilience_level = 1 im IBM Quantum Estimator-Primitive.
Natur der Auslesefehler auf supraleitender Hardware
Bei supraleitenden IBM-Qubits werden Auslesefehler dominiert von:
-
Asymmetrischen Bitflip-Wahrscheinlichkeiten (zum Beispiel häufiger als umgekehrt)
-
Zustandsabhängiger Relaxation während der Messung selbst
-
Geringem, aber nicht vernachlässigbarem Übersprechen zwischen benachbarten Ausleseresonatoren
Wichtig ist, dass sich diese Fehler oft als klassischer stochastischer Prozess modellieren lassen, der auf die Messergebnisse wirkt. TREX nutzt eine Standardidee des Noise Tailoring: die Randomisierung (Twirling) des Messvorgangs. TREX verläuft typischerweise in zwei Phasen:
-
Twirling und klassisches "Untwirling"
-
Umskalierung der Erwartungswerte mithilfe von Kalibrier-Circuits
Angenommen, ein Erwartungswert der Observablen hängt mit verrauschten Schätzungen zusammen, wie folgt:
wobei ein fester Faktor ist, der die Schätzung skaliert, und ein Bias aus den oben beschriebenen Quellen. Wir verwenden hier als Erinnerung daran, dass wir hier nur den Auslesefehler behandeln; der Gate-Fehler muss weiterhin berücksichtigt werden.
Unmittelbar vor der Messung wird jedes Qubit zufällig mit einem Pauli-Operator (wie I oder X) konjugiert. Die Messergebnisse werden danach klassisch enttwirlt.
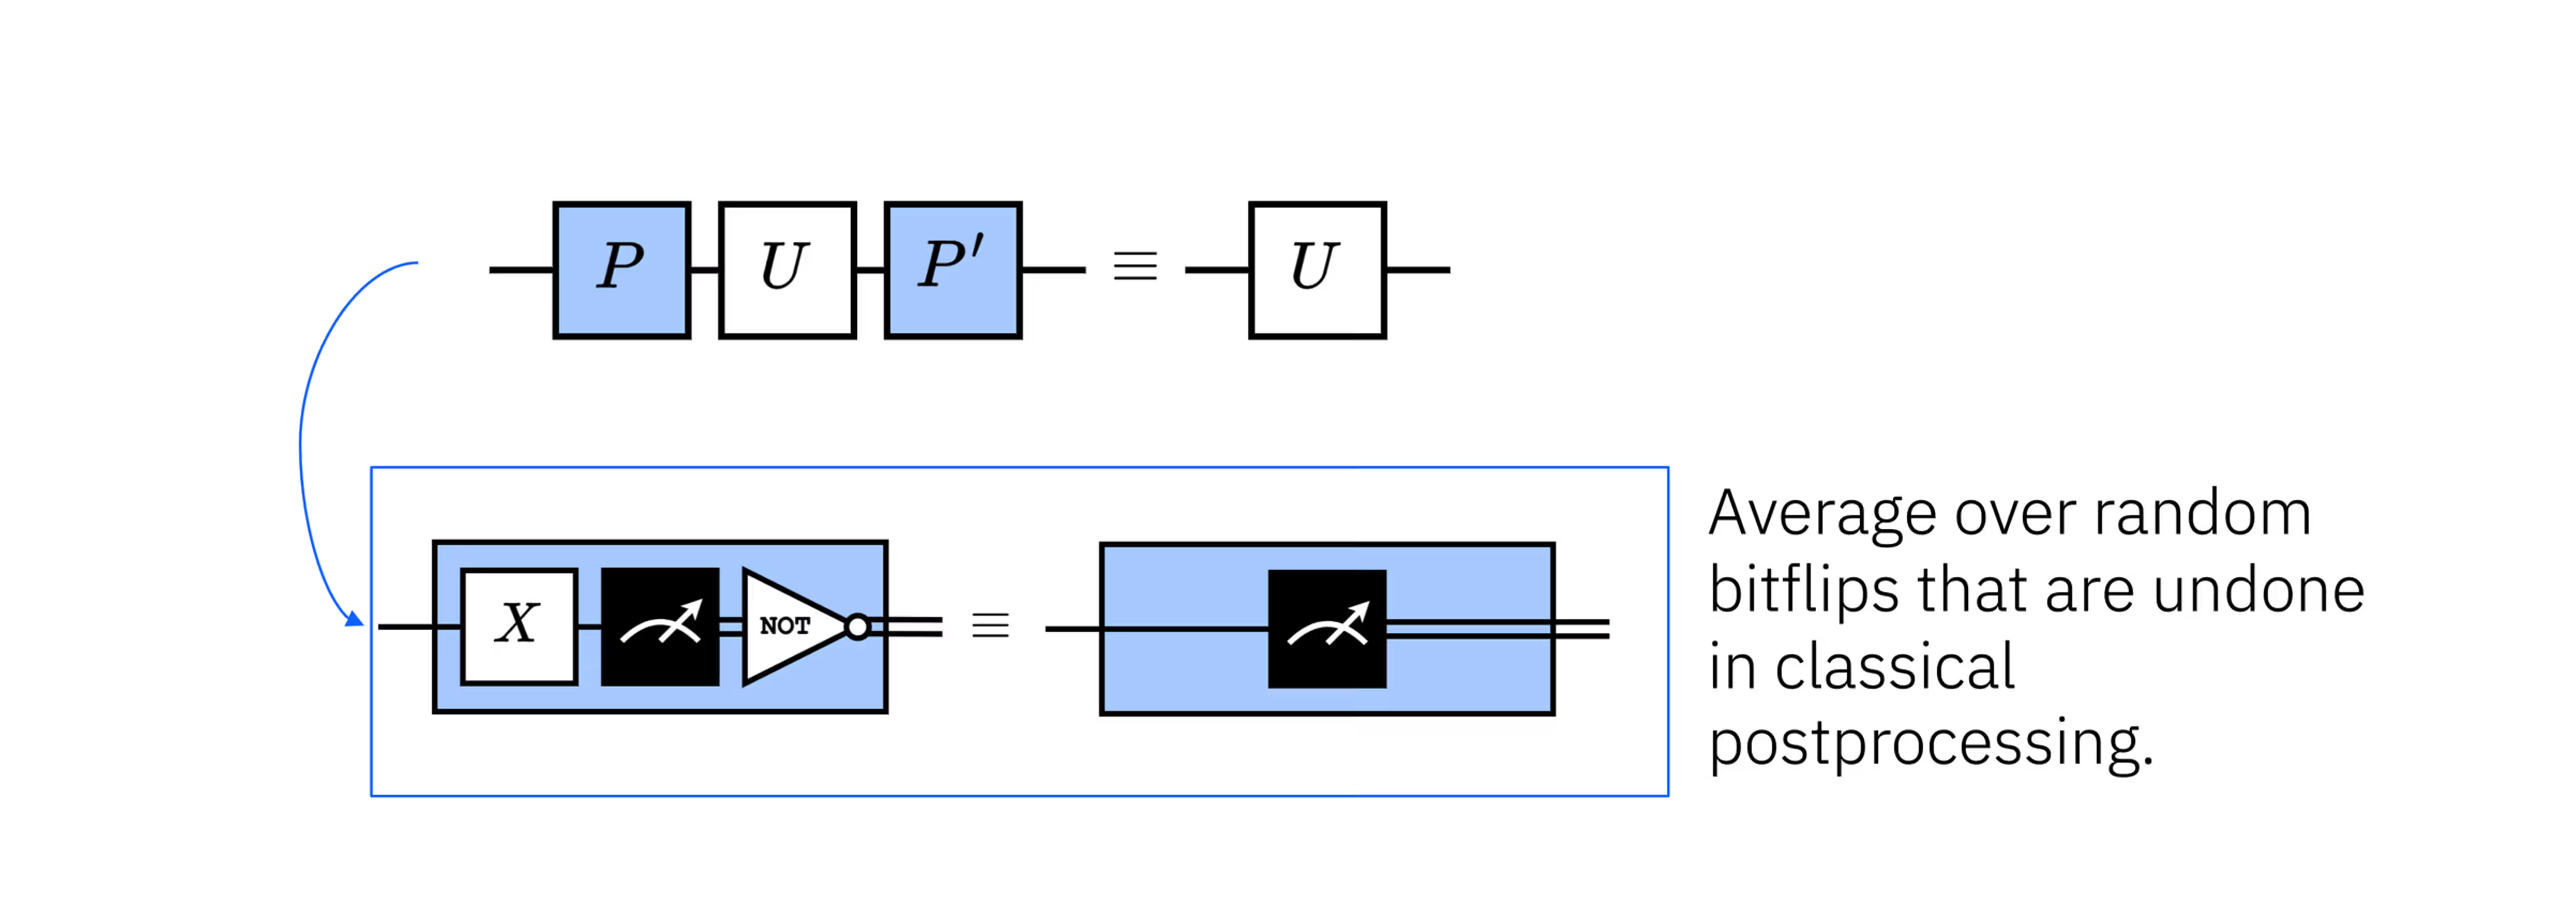
Die Mittelung über diese Randomisierungen symmetrisiert den Auslesekanal. Dadurch werden systematische Asymmetrien im Ausleseprozess in einen symmetrischeren Fehlerkanal umgewandelt, dessen verbleibende Wirkung sich durch Kalibrierung und Umskalierung behandeln lässt. Einfach gesagt: Wenn es zum Beispiel einen Bias in Richtung des Zustands gäbe, würden uns einige Messungen von fehlen. Durch das Twirling um die Messung vertauschen wir zufällig, welches logische Ergebnis dem physikalischen Ausleseprozess zugeordnet ist, und machen diese Vertauschung danach klassisch rückgängig. Die Mittelung über viele solcher randomisierten Messungen beseitigt die systematische Bevorzugung eines gemeldeten Ergebnisses gegenüber dem anderen. Dies entfernt unter den Annahmen des TREX-Modells den dominanten Messbias, sodass wir Folgendes haben:
Erwartungswerte müssen jedoch möglicherweise weiterhin umskaliert werden. Die zweite Phase verwendet Kalibrier-Circuits (Circuits mit bekannten Ergebnissen), um den Skalierungsfaktor zu schätzen. Dieser kann dann verwendet werden, um eine stark verbesserte Schätzung zu erhalten.
Erwartungswerte von Pauli-Observablen werden zu erwartungstreuen Schätzern ihrer idealen Werte. Es wird kein explizites Rauschmodell gelernt oder invertiert, weshalb TREX numerisch stabil und kostengünstig ist. Auch hier wurde der Gate-Fehler nicht behandelt.
Bei der Schätzung eines Erwartungswerts der Observablen kann es Varianz durch endliches Sampling geben, viele Arten inkohärenter und kohärenter Fehler, und außerdem einen Bias durch Auslesefehler. Dieser Bias entsteht durch Quellen wie die besprochenen asymmetrischen Übergänge. In der Praxis lässt sich dieser Bias typischerweise gut als klassischer stochastischer Kanal modellieren, der nach der Quantenentwicklung wirkt. TREX transformiert den effektiven Messkanal so, dass der Schätzer von bezüglich des Auslesefehlers erwartungstreu ist. Das lässt sich am einfachsten am Beispiel der einfachsten Twirling-Gates sehen: X. Wenn im Vergleich zu asymmetrisch ist, wir aber zufällig vertauschen, welcher Zustand ausgelesen wird (und später klassisch zurücktauschen), dann beseitigt dies offensichtlich die systematische Asymmetrie (auch wenn endliches Sampling bedeutet, dass es eine leichte stochastische Asymmetrie bei der Messung geben kann). In der Praxis sind Twirling-Gates für TREX nicht auf I und X beschränkt, aber für eine Erklärung genügt dies.
TREX ermöglicht es uns, eine Schätzung eines Erwartungswerts zu erhalten, die frei von Bias durch Auslesefehler ist. Es kann weiterhin einen Bias aus anderen Quellen geben (wie kohärente Überrotation); TREX zielt nur auf das Auslesen. Da TREX systematischen Bias durch randomisierte Symmetrisierung ersetzt, wandelt es Bias im Allgemeinen in zusätzliche stochastische Varianz um und erhöht so die Varianz des Schätzers bei gleichen Sampling-Kosten.
Verständnis prüfen
Angenommen, wir verwenden Estimator auf einem Circuit, der den Zustand präpariert hat, bei der Schätzung von . Weiter angenommen, Messfehler führen dazu, dass Ergebnisse, die entsprechen, in 10 % der Fälle als gemeldet werden, während Ergebnisse, die entsprechen, nur in 1 % der Fälle als gemeldet werden. Die Asymmetrie zwischen diesen Meldefehlern führt zu einem Messbias.
(a) Welchen idealen Erwartungswert hätte die Observable ohne solche Messfehler?
(b) Welchen Erwartungswert hat die Observable mit den asymmetrischen Mess- bzw. Auslesefehlern?
(c) Betrachte eine begrenzte Menge von Pauli-Twirling-Gates: I und X. Nimm an, dass I und X über mehrere Shots zufällig mit jeweils 50 % Wahrscheinlichkeit angewendet werden. Es gelten weiterhin dieselben Messfehlerraten. Anschließend wird das Pauli-Gate (I oder X) klassisch rückgängig gemacht. Erstelle eine Tabelle aller möglichen Ergebnisse und ihrer Wahrscheinlichkeiten aufgrund der anfänglichen Superposition, der asymmetrischen Messfehler und der zufällig zugewiesenen Pauli-Gates.
(d) Bestimme anhand der Tabelle den Erwartungswert mit der Twirling-Strategie.
(e) Vergleiche die Erwartungswerte: ideal, ohne Twirling und mit Twirling.
(f) Was wurde in dieser Betrachtung weggelassen, das in einer vollständigen TREX-Anwendung enthalten ist?
Antwort
(a) Du kannst einfach mit Intuition und Symmetrie argumentieren, dass ist. Explizit gezeigt:
(b) Der Zustand könnte bei der Messung zu oder kollabieren, jeweils mit 50 % Wahrscheinlichkeit. Von den 50 %, die zum Zustand kollabieren, werden aber 1 % (oder 0,5 % aller Fälle) fälschlich als gemeldet. Von den 50 %, die zu kollabieren, werden 10 % (oder 5 % aller Fälle) fälschlich als gemeldet. Das ergibt:
- 54,5 %
- 45,5 % Wenn wir alle anderen möglichen Fehlerarten ignorieren, erhielten wir eine Schätzung von
(c)
| Pauli | Ideales Messergebnis | Ergebnis nach Pauli | Auslesefehler | Pauli rückgängig | Final gemeldetes Ergebnis | Wahrscheinlichkeit |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Keiner | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Keiner | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Keiner | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Keiner | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Aus den vorherigen Teilen kennen wir die Erwartungswerte von Z in jedem der Endzustände. Wir müssen nur den gewichteten Mittelwert bilden:
(e) In diesem sehr einfachen Fall hat unsere Anwendung des Twirling genau den idealen Erwartungswert wiederhergestellt. Das ist nicht typisch. Typisch ist, dass das Twirling Bias wie den durch asymmetrische Übergänge eingeführten aufhebt und einen Erwartungswert näher am idealen zurückgibt.
(f) Dies ist eine Anwendung eines Spielmodells. Es könnten mehrere Dinge fehlen. Insbesondere haben wir hier keine Kalibrier-Circuits ausgeführt, um einen Umskalierungsfaktor zu schätzen. Das ist typischerweise notwendig.
Implementierungsdetails
TREX wird automatisch angewendet, wenn das EstimatorV2-Primitive mit resilience_level = 1 (dem Standard) verwendet wird. Beachte, dass es nicht automatisch auf das Sampler-Primitive angewendet wird, weil Sampler vollständige Wahrscheinlichkeitsverteilungen statt Erwartungswerte zurückgibt.
Wenn TREX aktiviert ist, erzeugt die Runtime messungs-getwirlte Circuit-Varianten, indem unmittelbar vor der Messung zufällige Ein-Qubit-Paulis eingefügt werden. Die klassische Nachverarbeitung macht diese Paulis rückgängig. Diese Circuit-Varianten sind über verschiedene Shots hinweg und auch über verschiedene Qubits innerhalb eines Shots zufällig. Alle Circuit-Varianten werden anschließend zu einem einzigen Schätzer kombiniert.
TREX ist sehr gut skalierbar. Es erfordert zusätzliche Kalibrier-Circuits, sodass der Sampling-Overhead typischerweise ein kleiner konstanter Faktor ist (oft 2-4x). Die Mitigation ist jedoch observablenspezifisch und erhält die Verteilung nicht.
TREX ist so konzipiert, dass es sich sauber mit vielen Methoden zur Fehlerunterdrückung und Fehlermitigation integrieren lässt, darunter die folgenden:
-
Dynamical Decoupling (DD) - wirkt während Leerlaufzeiten, orthogonal zur Auslese-Mitigation.
-
Gate- oder Pauli-Twirling - oft komplementär; TREX stützt sich bereits auf Twirling, zielt aber nur auf Ausleserauschen.
-
Zero-Noise-Extrapolation (ZNE) - ZNE zielt auf Gate-Rauschen, während TREX den Messbias behandelt. Diese Kombination wird bei Resilience-Level 2 verwendet.
-
Probabilistic Error Amplification und Probabilistic Error Cancellation in Estimator-Workflows.
Einige Methoden können jedoch nicht (oder sollten nicht) mit TREX kombiniert werden:
-
Korrektur der Wahrscheinlichkeiten auf Sampler-Ebene: TREX liefert keine korrigierten Bitstring-Wahrscheinlichkeiten.
-
Nachträgliche Mitigation auf bereits mit TREX mitigierten Daten: Doppelte Korrektur kann Bias wieder einführen.
Die Kombination von TREX mit einer auf Zuordnungsmatrizen basierenden Auslesefehler-Mitigation wie M3 ist heikel. M3 geht von einem festen Messkanal aus. TREX randomisiert die Messung absichtlich und macht damit die von M3 verwendete Annahme ungültig. In diesem Sinne lassen sich diese Techniken nicht einfach kombinieren. Wenn du jedoch während der in M3 verwendeten Kalibrierung ein Measurement-Twirling anwendest, kannst du möglicherweise gleichzeitig einen zuordnungsmatrixartigen Ansatz und einen Twirling-Ansatz zur Fehlermitigation nutzen (wobei dieser Twirling-Ansatz nicht ganz dasselbe ist wie TREX). Das ist ein wiederkehrendes Thema bei der Kombination von Techniken zur Fehlermitigation und -unterdrückung: Techniken blind zu addieren scheitert; sie so sorgfältig zu addieren, dass sie sich "der anderen bewusst" sind, kann funktionieren und sehr vorteilhaft sein.
TREX garantiert nur Erwartungswerte, die frei von Verzerrungen (Bias) durch Auslesefehler sind; es verringert weder die Varianz noch schützt es vor anderen Arten von Bias. Es korrigiert sicherlich nicht alle Fehler. Es ist jedoch oft eine erhebliche Verbesserung und mit deutlich geringerem Aufwand erreichbar als einige andere Methoden, die das Erlernen vollständiger Rauschmodelle erfordern. TREX ist häufig die kostengünstigste und robusteste verfügbare Auslesefehler-Mitigation und damit eine hervorragende Standardwahl für Experimente.
TREX mit Qiskit
Hier erstellen wir einen einfachen Zwei-Qubit-Circuit und verwenden Estimator, um den Erwartungswert einer sehr einfachen Observablen, ZX, zu schätzen. Der ideale Erwartungswert ist 1. Wir vergleichen die Erwartungswerte mit und ohne TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Erstelle den einfachen Quantenschaltkreis (Circuit).
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpiliere den Circuit mithilfe eines Pass Managers.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Wende dasselbe Layout aus der Transpilation auf die Observable an.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Führe das Experiment auf einem echten Quantencomputer aus. Zuerst verwenden wir reslience_level = 1; das ist der Standardwert, aber wir haben ihn explizit angegeben, um die beiden Fälle zu unterscheiden.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Jetzt setzen wir resilience_level auf 0, um ohne TREX auszuführen.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Der Erwartungswert liegt mit TREX erwartungsgemäß deutlich näher am Idealwert (1). Natürlich war das ein einzelner Erwartungswert an einem einzelnen Qubit. Wir bereiten nun einen Circuit mit Nicht-Clifford-Gates und vielen Qubits vor, um zu testen, ob die Verbesserung durch TREX in einem anderen Setting robust bleibt.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Am Rotationswinkel ist hier nichts Besonderes. Wir haben einfach irgendeine ungleiche Superposition von und gewählt, um die Effekte asymmetrischer fehlerhafter Übergänge zu untersuchen und zu sehen, wie TREX damit umgeht. Für diesen Zustand wäre der ideale Erwartungswert von Z an jedem Qubit, in Abwesenheit jeglicher Fehler (beim Auslesen oder anderweitig):
Wir hoffen daher, an allen Qubits Erwartungswerte nahe -0,924 zu erhalten. Wir werden sehen, ob TREX jeden Erwartungswert einzeln verbessert und ob es auch den Durchschnitt über alle Qubits verbessert.
Überprüfe dein Verständnis
Überprüfe den obigen Erwartungswert durch direkte Berechnung.
Antwort
Wir transpilieren mithilfe eines Pass Managers.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Jetzt konstruieren wir eine Observable pro Qubit, damit wir alle zwanzig Erwartungswerte in einem einzigen Workflow schätzen können. Das heißt: Für das -te Qubit wollen wir eine Observable mit lauter Identitäten , außer an der -ten Position, an der wir ein wollen. Denke daran, dein transpiliertes Layout auch auf deine Observablen anzuwenden.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Jetzt können wir ausführen. Die Codezelle unten verwendet den session mode; wenn du keinen Zugriff auf Sessions hast, kannst du ihn durch den batch mode ersetzen, um denselben Workflow auszuführen, allerdings mit möglichen Wartezeiten zwischen den Circuits.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Hier vergleichen wir die mittleren absoluten Fehler mit und ohne TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
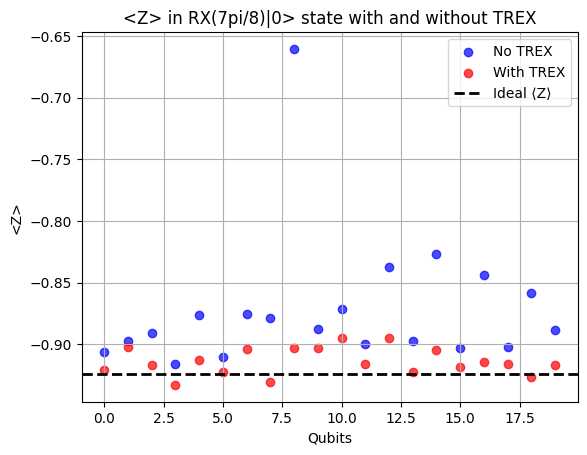
TREX hat offenbar durchaus geholfen. Der Erwartungswert hat sich an jedem Qubit verbessert, mit der einzigen Ausnahme von Qubit 16. Ein solcher Ausreißer ist zu erwarten. Wir können die Gesamtwirkung von TREX auf den Circuit quantifizieren, indem wir die Durchschnittswerte bilden.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Im Durchschnitt hat TREX unsere Ergebnisse um etwa 2,9 % näher an die idealen Ergebnisse gebracht und uns ein Ergebnis geliefert, das im Durchschnitt nur um 0,4 % vom theoretischen Ideal abweicht. Das ist großartig, und genau diese Verbesserung mit geringem Aufwand ist der Grund, warum TREX die Standard-Fehlerminderung in Estimator ist. Wir müssen aber noch einmal betonen, dass TREX einen Bias im Auslesefehler entfernt und nicht alle unsere Fehler korrigiert. Wir haben einen Anfangszustand gewählt, der mit hoher Wahrscheinlichkeit von einer Asymmetrie beim Auslesen betroffen ist. Der Effekt wäre ein anderer gewesen, wenn wir jedes Qubit in einem anderen Zustand präpariert hätten. Für ein triviales Argument, warum das so sein muss, überlege, was passieren würde, wenn wir jedes Qubit im Grundzustand ließen. Es gäbe keine Möglichkeit, eine Asymmetrie des Auslesefehlers zwischen den Zuständen und zu beobachten (oder zu korrigieren).
Zero-Noise-Extrapolation (ZNE)
Zero-Noise-Extrapolation (ZNE) ist eine der am weitesten verbreiteten Techniken zur Fehlerminderung. Die allgemeine Strategie ist ebenfalls leicht zu verstehen, auch wenn die Details der Umsetzung komplex sind. ZNE funktioniert so:
-
Ein Ziel-Circuit wird bei mehreren "Rauschniveaus" ausgeführt — Modifikationen am Circuit, die sein Rauschen auf vorhersagbare Weise skalieren lassen
-
Die interessierende Observable wird für jede Rauschskalierung geschätzt.
-
Mit einem Anpassungsmodell (linear, polynomial, exponentiell usw.) wird auf null Rauschen zurückextrapoliert.
Das Ergebnis ist eine Schätzung dessen, was die Observable im durch das Extrapolationsmodell implizierten Grenzfall ohne Rauschen gewesen wäre.
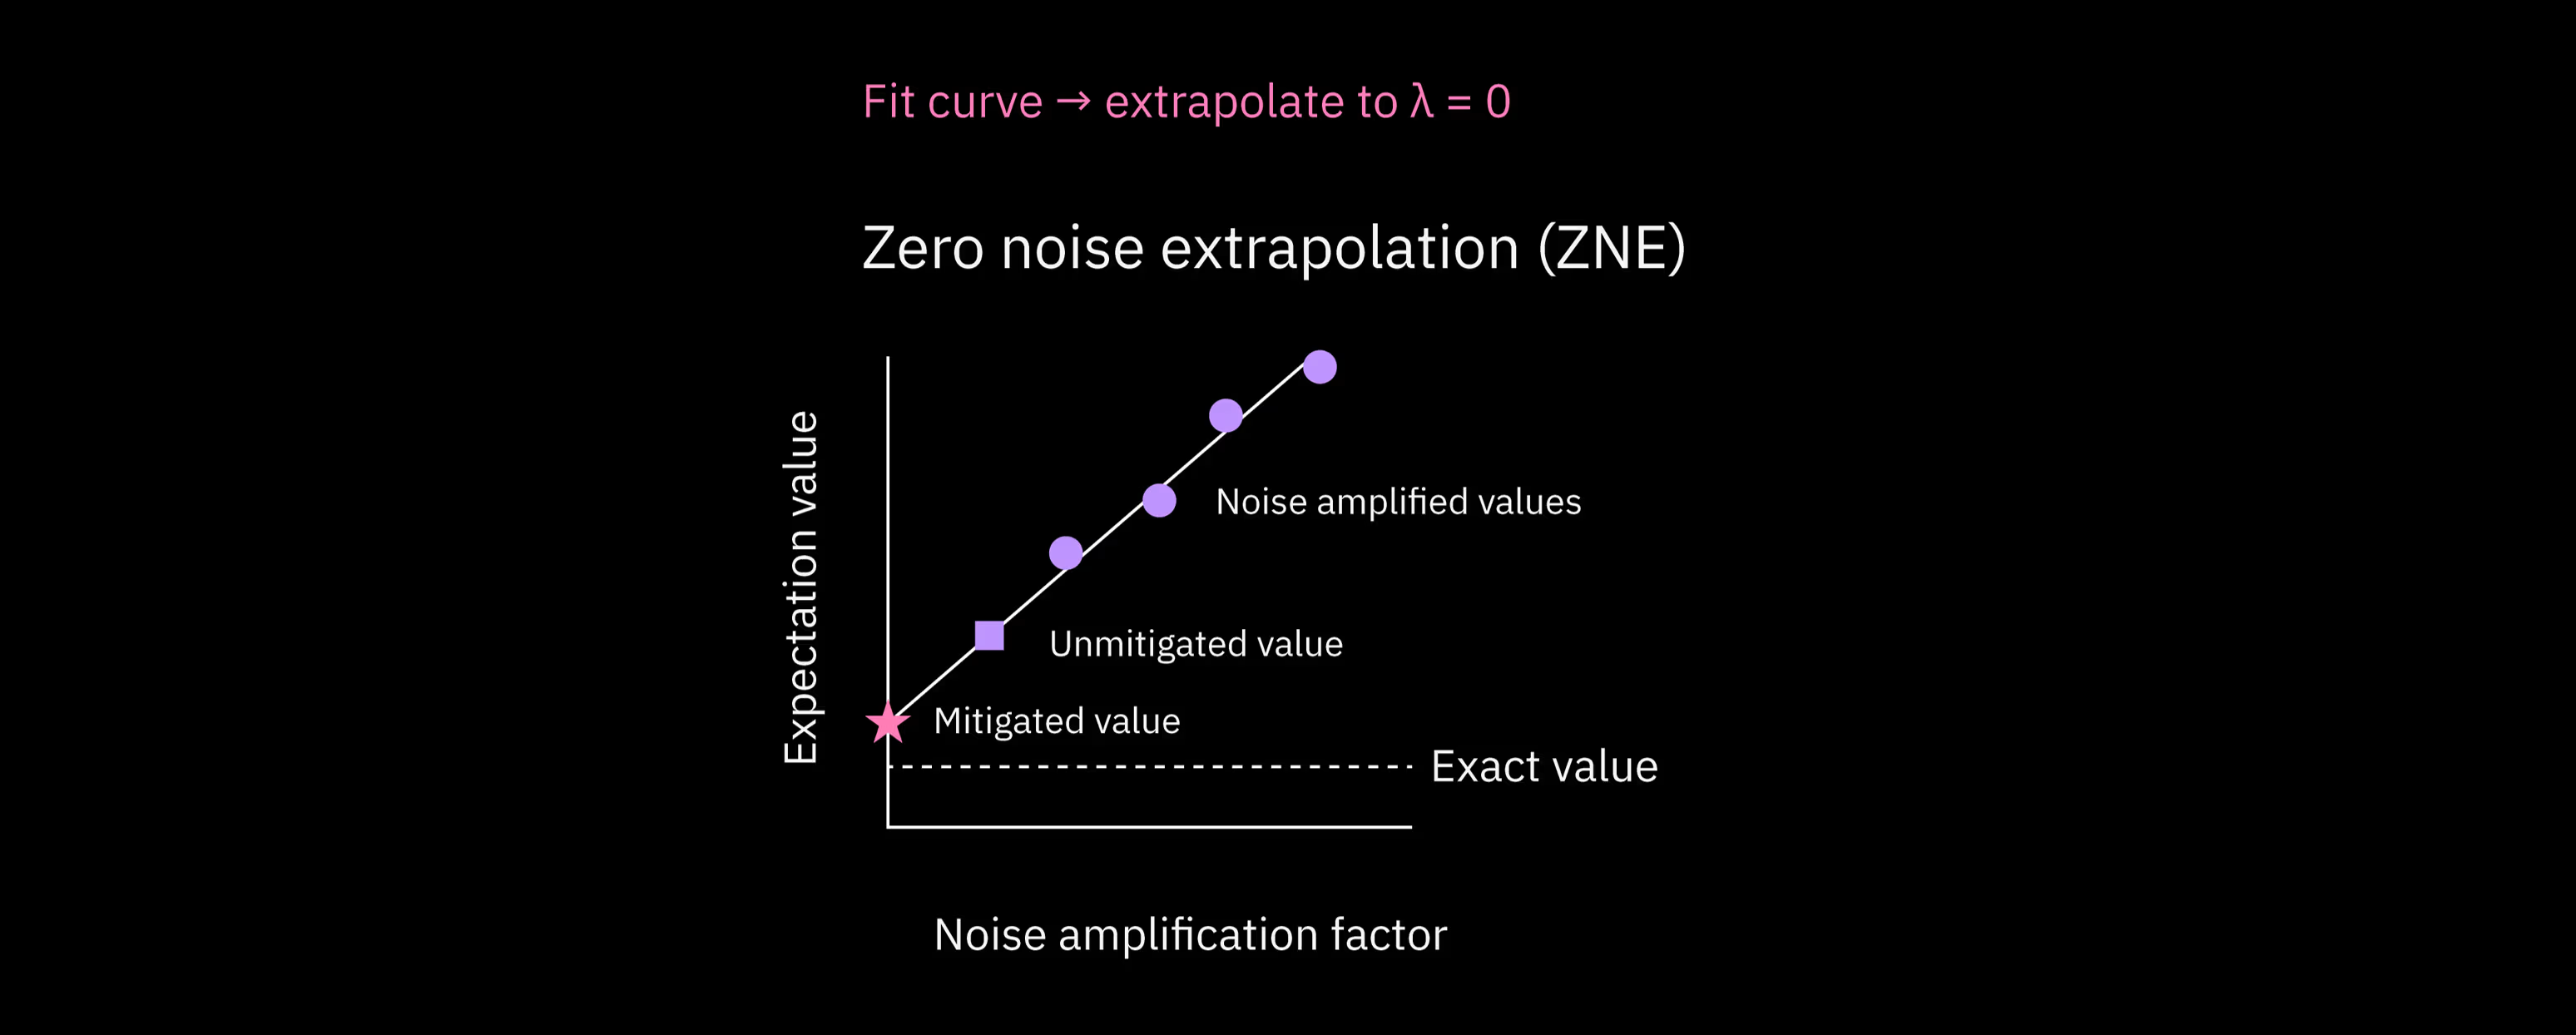
ZNE garantiert nicht, dass das Rauschen gleichmäßig oder linear zunimmt, wenn wir Circuits modifizieren. Stattdessen nimmt es an, dass die Rauschskalierung hinreichend gutartig ist, um eine Extrapolation zu ermöglichen. Die Komplexität bei ZNE liegt darin, wie man Circuits modifiziert, um diese Annahme so gut wie möglich zu erfüllen. Wir werden in dieser Lektion einige Ansätze untersuchen.
Ressourcenskalierung bei ZNE
Bei ZNE ist der Mehraufwand überwiegend Quantenaufwand. Um Erwartungswerte bei Rauschniveaus zu erhalten, musst du dein Experiment nämlich auf Circuits ausführen, jeweils mit vielen Shots. Um eine feste statistische Genauigkeit beizubehalten, steigt die Gesamtzahl der Samples im Allgemeinen, wenn zusätzliche rauschskalierte Circuits eingeführt werden.
Die Anzahl der Rauschniveaus , die du untersuchst, hängt von der Methode zur Skalierung des Rauschens ab. Bei einer einfachen Technik zur Rauschskalierung ("Gate-Folding", unten besprochen) liegt üblicherweise zwischen 3 und 5. Eine andere Methode (Probabilistic Noise Amplification, PNA) erlaubt nicht ganzzahlige Rauschfaktoren und führt typischerweise zu niedrigeren Rauschniveaus als Gate-Folding. Der Gesamtaufwand skaliert grob wie:
wobei die Basis-Shot-Anzahl ist. Außerdem solltest du bedenken: Wenn die Rauschskalierung wiederholte Gates beinhaltet, kann die Circuit-Tiefe um einen Faktor steigen, der proportional zum Rauschskalierungswert ist. Die mit der erhöhten Tiefe einhergehende Rauschskalierung ist der Zweck, aber behalte die Gesamttiefe im Blick.
ZNE eignet sich gut für Probleme, bei denen die folgenden Punkte zutreffen:
-
Du brauchst eine universell einsetzbare Methode zur Fehlerminderung, die bei vielen Fehlerarten wirksam ist.
-
Die Circuit-Tiefe ist nicht zu groß; ZNE scheitert, wenn der skalierte Circuit zu verrauscht zum Extrapolieren wird.
-
Du kannst einen moderaten Laufzeit-Mehraufwand für höhere Genauigkeit in Kauf nehmen.
In der Praxis macht das ZNE ideal für viele variationelle Circuits, die Schätzung von Erwartungswerten und andere Quantenalgorithmen der nahen Zukunft. Es ist in Estimator mit resilience_level = 2 implementiert. Beachte, dass ZNE in einem Raum extrapoliert, der ein einzelnes Ergebnis als Funktion des Rauschens im gesamten Circuit hat. Das bedeutet, dass es sich für Schätzprobleme eignet, aber nicht für Sampling-Probleme. Es ist nicht dafür ausgelegt, auf Verteilungen von Bitstrings zu arbeiten.
Rauschfaktoren
Wie genau können wir das Rauschniveau in einem Circuit erhöhen? Es gibt zwei Hauptwege, auch wenn es viele Varianten gibt.
-
Ersetze ein Gate oder einen Block von Gates durch . Da Gates auf Quantencomputern unitär sind, wissen wir, dass , sodass logisch gilt: . Jede Wiederholung von oder fügt jedoch einen ähnlichen oder identischen Fehler hinzu, sodass wir das Rausch- bzw. Fehlerniveau hochskalieren können. Beachte, dass die oben gezeigte Ersetzung uns vom ursprünglichen Rauschen des Gates (Rauschniveau 1) zum Dreifachen dieses Rauschniveaus in (Rauschniveau 3) bringt. In der Praxis können wir die letzten beiden Gates -mal wiederholen: , um ein Rauschniveau zu erhalten. Das nennt man Gate-Folding, und es ist eine sehr gängige Technik zur Rauschskalierung.
-
Es gibt weitere Methoden zur Erhöhung des Rauschniveaus, etwa Probabilistic Error Amplification (PEA). Bei PEA lernen wir zunächst ein geeignetes Rauschmodell für den Circuit, typischerweise als Pauli-Kanal ausgedrückt. Das Rauschen wird dann verstärkt, indem aus einer reskalierten Version dieses gelernten Rauschkanals gesampelt wird. Durch Anpassen des Samplings kannst du die effektive Rauschstärke kontinuierlich skalieren, auch auf nicht ganzzahlige Werte.
In der Praxis kann Gate-Folding Fehler sehr zuverlässig skalieren, kann aber auch zu sehr tiefen Circuits führen. Wenn du nur drei Rauschniveaus (1, 3 und 5) brauchst, bedeutet das, die Circuit-Tiefe um den Faktor 5 zu erhöhen und trotzdem vernünftige Ergebnisse zu erhalten. Wenn dein Ziel-Circuit also eine transpilierte Zwei-Qubit-Tiefe von 60 oder mehr hat, ist PEA wahrscheinlich besser geeignet als Gate-Folding.
Gates können entweder lokal gefaltet werden (das heißt, du wiederholst für jedes Zwei-Qubit-Gate, sobald es auftritt), oder sie können zu einem Block von Gates gruppiert und der Block wiederholt werden (wie bei den Gates ). Oft ist lokales Folding im Hinblick auf die Annahmen von ZNE vorzuziehen, aber beides ist möglich.
In die statistische Behandlung rauschskalierter Ergebnisse bei ZNE fließt viel Nuance ein. Zum Beispiel haben deine Ergebnisse beim Fünffachen des Rauschniveaus mit Sicherheit eine höhere Varianz und sind weniger zuverlässig. Sollte man sie mit demselben Gewicht behandeln wie Datenpunkte mit weniger Rauschen? Nein. Um ZNE in Aktion zu sehen, ignorieren wir jedoch einen Teil dieser Komplexität für ein Spielzeugmodell-Experiment, in dem wir gefaltete Circuits von Hand bauen und eine naive Extrapolation mit gleichen Gewichtungen durchführen, um die wesentlichen Schritte zu veranschaulichen. Danach folgt aber ein Experiment mit der in Qiskit integrierten ZNE-Funktionalität, und wir werden sehen, dass sie die Komplexität, die wir überspringen, wesentlich besser handhabt.
ZNE von Hand
Wir beginnen mit der Auswahl eines Quantenschaltkreises (Circuit) und einer Observablen, für die wir den idealen Erwartungswert in Abwesenheit von Rauschen und Fehlern berechnen können. Wir wählen einen GHZ-Zustand mit einer geraden Anzahl von Qubits. Unsere Observable ist . Wir wählen sie aus mehreren Gründen:
- Der Erwartungswert ist im idealen Fall trivial zu berechnen. Da die Anzahl der Qubits gerade ist, erhalten wir entweder von jedem eine
1, die miteinander multipliziert werden, oder von jedem eine-1, die geradzahlig oft miteinander multipliziert werden. - Sie reagiert ziemlich empfindlich auf Fehler und Rauschen, da ein einzelner Fehler an einem Qubit das Gesamtergebnis dieses Shots von +1 auf -1 kippen kann.
- Der Erwartungswert liegt weit von 0 entfernt. ZNE kann auf Schwierigkeiten stoßen, wenn der ideale Erwartungswert sehr nahe bei null liegt, weil hohe Rauschniveaus die Ergebnisse tendenziell randomisieren und sie ebenso oft positiv wie negativ machen. Die Folge ist, dass hohe Rauschwerte am Ende Werte nahe dem Idealwert liefern; das kann die Extrapolation sehr knifflig machen.
Mit dieser Motivation im Hinterkopf bauen wir unsere Circuits.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Beachte die Feinheit, dass hier gilt. Obwohl Gate-Folding als Operatoren der Form beschrieben wurde, sieht dieselbe Struktur hier wie CNOT CNOT CNOT aus.
Stellen wir sicher, dass unser -er Circuit tatsächlich der normale GHZ-Circuit ist:
ghz_amp[0].draw("mpl")
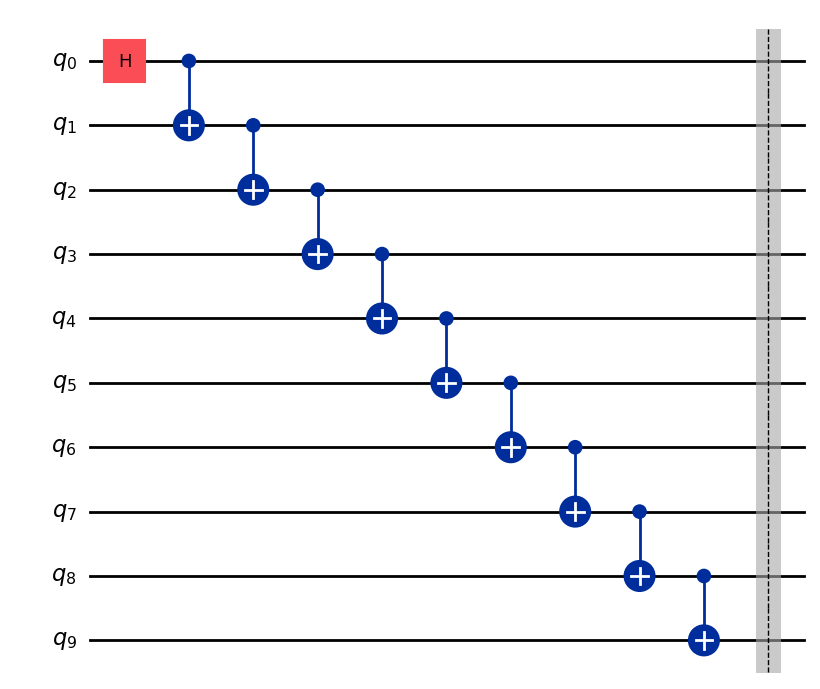
Du kannst dir die anderen Circuits ansehen, um zu überprüfen, dass sie die erwartete Struktur haben.
Jetzt bauen wir unsere Observablen.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Wir bauen einen Pass Manager und wenden ihn auf unsere Circuits an. Anschließend nehmen wir die Layouts und wenden sie auf unsere Observablen an.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Formatiere die pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Jetzt führen wir Estimator aus. Wir möchten uns auf die Rolle von ZNE konzentrieren und könnten daher resilience_level = 0 setzen, um die Effekte des Twirlings nicht mit dem Effekt von ZNE zu vermischen. Wir wollen unser "von Hand" gebautes ZNE aber auch mit den in Qiskit integrierten ZNE-Einstellungen vergleichen, die Twirling einschließen. Deshalb setzen wir hier resilience_level = 1. Mit resilience_level = 2 werden die ZNE-Einstellungen von Qiskit aufgerufen, die wir gleich verwenden werden.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Jetzt geben wir die Rauschniveaus und Erwartungswerte aus.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Das ist der Teil, bei dem wir am nachlässigsten vorgehen: Wir führen eine lineare Anpassung an diese Daten durch, ohne auf die Varianz jedes erhaltenen Werts zu achten und ohne theoretisch vorherzusagen, ob die Anpassung linear sein muss. Auch hier leistet das integrierte ZNE deutlich bessere Arbeit als das, was wir von Hand tun.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Wir erstellen vor der Interpretation zunächst den Plot.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
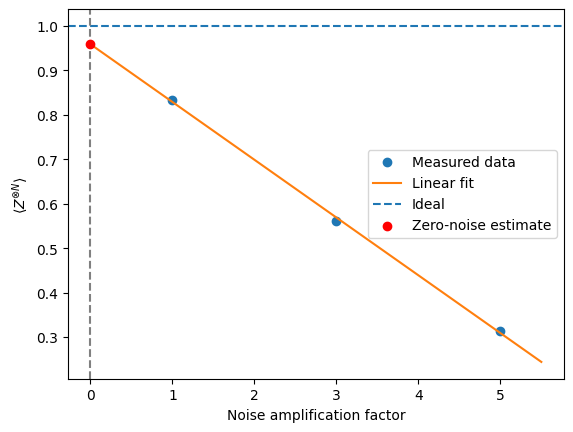
Zum Zeitpunkt der Erstellung dieser Lektion erhalten wir aus der Extrapolation auf den Fall ohne Rauschen einen Erwartungswert von 0,959. Deine Werte können abweichen. Das ist deutlich besser als der Erwartungswert des Roh-Circuits von 0,83, etwa 13 % näher am Idealwert. Du kannst aber auch sehen, dass wir einen Datenpunkt verwenden, bei dem der Erwartungswert nur bei 0,31 lag. Offensichtlich ist dieser Datenpunkt von schlechterer Qualität. Hätte man diesem Datenpunkt in unserer linearen Näherung ein geringeres Gewicht gegeben und die Gerade stärker an die ersten beiden Datenpunkte angepasst, hätte die auf null extrapolierte Schätzung höher gelegen (näher am Idealwert). Solche Überlegungen werden im in Estimator integrierten ZNE automatisch behandelt.
In Estimator integriertes ZNE
Sehen wir uns nun an, was passiert, wenn wir die in Estimator integrierte ZNE-Funktionalität verwenden. Wir beginnen mit der Definition eines einfachen GHZ-Circuits ohne Gate-Folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Wir definieren dieselbe Observable wie zuvor.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Wir definieren erneut einen Pass Manager, diesmal mit optimization_level = 1. Auf diese Wahl kommen wir weiter unten zurück.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpiliere den Circuit und wende das Layout auf die Observablen an.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Wir führen Estimator mit ZNE und Twirling aus und vergleichen die Ergebnisse mit unserer von Hand umgesetzten ZNE-Implementierung. Insbesondere vergleichen wir sie mit dem Ergebnis ohne ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Wir können die Werte bei jedem Rauschfaktor mit der Syntax job_zne.result()[0].data.evs_noise_factors abrufen. Wie zuvor könnten wir diese Ergebnisse naiv für eine lineare Anpassung und Extrapolation auf den Fall ohne Rauschen verwenden, aber der Estimator mit resilience_level = 2 hat bereits bessere Arbeit geleistet und dabei Varianz und andere Aspekte berücksichtigt. Unten zeigen wir, was eine lineare Extrapolation ergeben würde, und was das integrierte ZNE tatsächlich ergeben hat.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
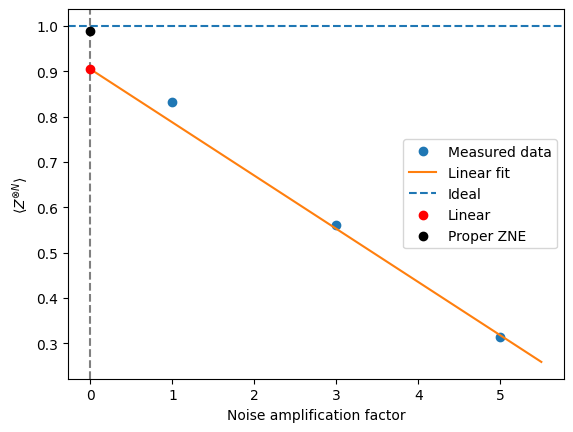
Wir sehen, dass das integrierte ZNE unsere Schätzung um über 15 % verbessert hat und deutlich besser funktionierte als unser Versuch von Hand.
Bevor wir weitermachen, beachte, dass wir während dieser gesamten ZNE-Untersuchung im Pass Manager optimization_level = 1 gesetzt haben. Höhere Optimierungsstufen verringern den Fehler, und manchmal kann die Fehlerreduktion dazu führen, dass die Fehler weniger vorhersagbar skalieren. Wie so oft gilt es, ein Gleichgewicht zu finden: Fehler reduzieren, außer wenn du sie absichtlich um einen bekannten Faktor erhöhst.
Methoden kombinieren
ZNE beruht auf Folgendem:
-
Ein wohldefinierter Rauschskalierungsparameter
-
Hinreichend glatte und vorhersagbare Skalierung der Erwartungswerte mit
-
Derselbe effektive Rauschkanal mit unterschiedlichen Stärken
-
Kein Bias, der nicht mit skaliert
ZNE lässt sich sauber mit Techniken kombinieren, die nicht skalierende Biases entfernen (wie M3) oder das Rauschen regelmäßiger machen (wie Twirling), steht aber im Konflikt mit Techniken, die entweder versuchen, Rauschen vollständig auszulöschen (PEC) oder es dynamisch umzuformen (DD).
Insbesondere behandelt M3 nur Mess-/Auslesefehler, die sich in der Praxis getrennt von Gate-Fehlern betrachten lassen (auf die sich die Rauschskalierungsverfahren bei ZNE konzentrieren). M3 ist weitgehend unabhängig vom Gate-Folding; es lässt sich sauber mit ZNE kombinieren. TREX ist sehr ähnlich und kann mit ZNE kombiniert werden.
Pauli-Twirling konzentriert sich im Gegensatz zu M3 und TREX tatsächlich auf Gates. Denke jedoch daran, dass Pauli-Twirling Fehler/Rauschen nicht direkt mindert, sondern es verändert, um es vorhersagbarer zu machen. Pauli-Twirling kann für den ZNE-Prozess sogar vorteilhaft sein, indem es Gate-Fehler linearer skalieren lässt und die Extrapolation dadurch genauer macht.
Dynamical Decoupling (DD) ist differenzierter. DD verändert das Rauschverhalten dynamisch, indem es bestimmte Fehler durch das Hinzufügen von Gate-Sequenzen teilweise aufhebt. Wenn es möglich ist, Circuits so zu konstruieren, dass sich DD auch bei gefalteten Gates oder Blöcken gleich verhält, könnte man ZNE und DD prinzipiell kombinieren, in der Praxis stört DD die Skalierung aber manchmal. Wenn du sie kombinieren willst, solltest du Folgendes bedenken:
- Wird DD bei allen Rauschniveaus konsistent angewendet?
- Bleibt die DD-Struktur beim Folding erhalten?
- Verhält sich die resultierende Rauschskalierung weiterhin monoton?
Die letzte Methode zur Fehlermitigation, die wir als eigenständigen Ansatz besprechen, ist nicht mit ZNE kompatibel: Probabilistic Error Cancellation.
Probabilistic Error Cancellation (PEC)
Anders als ZNE oder Messfehlermitigation versucht PEC, Rauschen auf Gate-Ebene auszulöschen, indem es den idealen Kanal im Erwartungswert rekonstruiert. Probabilistic Error Cancellation (PEC) ist die leistungsstärkste und aufwendigste Technik zur Fehlermitigation, die in dieser Lektion behandelt wird. PEC beruht auf der expliziten Inversion des Rauschkanals, die statistisch statt physikalisch durchgeführt wird. PEC funktioniert so:
-
Das Rauschmodell wird anhand einer Basis von "Fehleroperationen" charakterisiert.
-
Das Inverse des Rauschkanals wird als Quasi-Wahrscheinlichkeitsverteilung über physikalische Operationen ausgedrückt.
-
Aus dieser Verteilung wird während der Circuit-Ausführung gesampelt, um statistisch eine erwartungstreue Schätzung der idealen Berechnung zu konstruieren.
Konzeptionell ist PEC wie eine virtuelle Fehlerkorrektur — es "macht" Rauschen "rückgängig", indem es verrauschte Operationen in sorgfältig gewichteten Zufallsmustern kombiniert. Prozedural ist PEC jedoch nicht eng mit Fehlerkorrektur- oder Fehlererkennungscodes verwandt. Die erwartungstreue Schätzung des idealen, rauschfreien Erwartungswerts durch PEC geht auf Kosten eines sehr großen Sampling-Mehraufwands und einer starken Abhängigkeit von einer genauen Rauschcharakterisierung.
Auf IBM-Quantencomputern ist PEC am besten als Präzisionswerkzeug statt als universelle Schicht zur Fehlerminderung zu verstehen: Es eignet sich am besten für kleine Circuits oder kleine Teile größerer Circuits, Benchmarking-Aufgaben und hochgenaue Studien, bei denen ein hoher Quantenaufwand akzeptabel ist.
Den Rauschkanal charakterisieren
Bei PEC wird jedes ideale Gate in einem Quantenschaltkreis als idealer unitärer Kanal gefolgt von einem Rauschprozess modelliert. Sei die Dichtematrix des Quantenzustands. Das ideale Gate wird durch eine unitäre Matrix dargestellt, die einen Quantenkanal induziert:
Auf echter Hardware wird diese ideale Entwicklung durch Rauschen verfälscht. Wir modellieren die physikalische Implementierung des Gates als effektiven verrauschten Kanal:
wobei ein Rauschkanal ist, der die mit dem Gate verbundenen stochastischen Fehler erfasst. In dieser gesamten Diskussion sind , und lineare Abbildungen, die auf Dichteoperatoren wirken. Der ideale Kanal ist unitär und reversibel, während der Rauschkanal (und damit ) eine vollständig positive, spurerhaltende (CPTP) Abbildung ist.
PEC setzt voraus, dass der Rauschkanal bekannt oder näherungsweise bekannt ist. Auf IBM-Quantum-Hardware stammen diese Informationen typischerweise aus Kalibrierdaten des Geräts, aus Fehlerraten, die aus Benchmarking-Experimenten abgeleitet werden, und aus vereinfachten Rauschmodellen wie Pauli- oder Depolarisierungsnäherungen für kleine Gate-Mengen. PEC erfordert zwar kein perfekt genaues Rauschmodell, doch seine Leistung verschlechtert sich rapide, je weiter der angenommene Rauschkanal vom tatsächlichen Hardwareverhalten abweicht.
Quasi-Wahrscheinlichkeitszerlegung des inversen Rauschkanals
Die zentrale Idee von PEC ist, die Wirkung des Rauschens im Erwartungswert auszulöschen, indem eine stochastische Näherung des Inversen des Rauschkanals konstruiert wird. Formal ist das Ziel, eine lineare Abbildung anzuwenden, die näherungsweise rückgängig macht, sodass gilt:
im Erwartungswert über viele Circuit-Ausführungen.
Das Inverse ist hier als algebraisches Inverses von definiert, wobei als lineärer Superoperator betrachtet wird, der auf Operatoren wirkt. Dieses Inverse existiert nur, wenn vollen Rang hat; nicht invertierbare Rauschprozesse lassen sich mit PEC nicht exakt mindern.
Wenn eine Inversion möglich ist, drückt PEC den inversen Rauschkanal als Linearkombination physikalisch implementierbarer Operationen aus:
Hier ist jedes eine verrauschte Operation, die auf der Hardware ausgeführt werden kann (typischerweise native Gates oder kurze Gate-Sequenzen), und die reellen Koeffizienten bilden eine Quasi-Wahrscheinlichkeitsverteilung. Anders als gewöhnliche Wahrscheinlichkeiten können die Koeffizienten negativ sein oder 1 überschreiten.
Die Quasi-Wahrscheinlichkeitsnorm:
quantifiziert die Kosten der Rauschinversion. Für jeden nichttrivialen Rauschkanal gilt . Auf IBM-Quantum-Hardware wird diese Zerlegung typischerweise wie folgt durchgeführt:
- pro Gate oder pro kleiner Gate-Menge,
- unter Annahme eingeschränkter Rauschmodelle (oft Pauli-diagonale Näherungen),
- unter Verwendung Backend-spezifischer nativer Operationen und Scheduling-Beschränkungen.
Monte-Carlo-Rekonstruktion des idealen Circuits
Um den Erwartungswert einer Observablen zu schätzen, verwendet PEC Monte-Carlo-Sampling auf Basis der obigen Zerlegung. Für jedes Auftreten eines verrauschten Gates im Circuit wird das folgende Verfahren angewendet:
-
Wähle zufällig eine Operation mit der Wahrscheinlichkeit:
-
Weise ein klassisches Gewicht zu:
-
Führe den resultierenden randomisierten, verrauschten Circuit auf dem Quanten-Backend aus.
-
Multipliziere das gemessene Ergebnis mit dem Produkt aller akkumulierten Gewichte.
-
Mittle die gewichteten Ergebnisse über viele Circuit-Ausführungen.
Der resultierende Schätzer erfüllt
sofern das Rauschmodell die Hardware genau beschreibt. PEC führt daher im Erwartungswert keinen systematischen Bias ein, ersetzt den Bias aber durch große statistische Varianz. Jeder Durchlauf liefert eine verrauschte, aber gewichtete Schätzung; erst nach der Mittelung vieler solcher Durchläufe ergibt sich der ideale Erwartungswert.
Konzeptionelle Interpretation
PEC wird manchmal als virtuelle Fehlerkorrektur beschrieben. Diese Formulierung ist zwar nicht ganz falsch, sollte aber nicht mit echter Quantenfehlerkorrektur verwechselt werden. PEC beinhaltet keine logische Kodierung, keine Syndromextraktion und keine Echtzeit-Rückkopplung. Fehler werden während der Circuit-Ausführung weder verhindert noch korrigiert.
Stattdessen löscht PEC Rauschen statistisch aus, indem viele verrauschte Circuit-Realisierungen mit vorzeichenbehafteten klassischen Gewichten kombiniert werden, sodass sich Fehler erst nach der klassischen Nachverarbeitung aufheben. Informationen werden während der Ausführung nicht geschützt; ideale Ergebnisse werden im Nachhinein rekonstruiert.
Ressourcenskalierung und Kosten
Die dominierenden Kosten von PEC entstehen durch Varianzverstärkung. Die Varianz des PEC-Schätzers skaliert wie:
was bedeutet:
Diese Skalierung ist fundamental und lässt sich durch klassische Nachverarbeitung nicht verbessern.
Bei Circuits mit vielen verrauschten Gates trägt jedes Gate einen Faktor bei, sodass die gesamte Quasi-Wahrscheinlichkeitsnorm näherungsweise multiplikativ wächst:
wobei die Circuit-Tiefe ist. Auf IBM-Quantum-Hardware führt dies typischerweise zu exponentiellem Wachstum der Sampling-Kosten mit der Circuit-Tiefe, mit besonders starker Empfindlichkeit gegenüber Zwei-Qubit-Gate-Fehlern. Diese Skalierung setzt der Anwendbarkeit von PEC praktische Grenzen.
PEC ist derzeit nur praktikabel, wenn eine oder alle der folgenden Bedingungen erfüllt sind:
-
Circuits sind sehr klein oder flach (oft Gates),
-
Rauschmodelle sind einfach und gut validiert (zum Beispiel Pauli-Rauschen),
-
Hohe statistische Kosten sind akzeptabel,
-
Das Ziel ist Genauigkeit statt Durchsatz.
Aus diesem Grund wird PEC oft angewendet auf:
-
Isolierte Teil-Circuits innerhalb größerer Workflows,
-
Kurzzeit-Entwicklungsschritte,
-
Zustandspräparations- oder Messroutinen,
-
Benchmarking- und Validierungsexperimente.
Der IBM-Software-Stack (IBM Quantum Compute und Tools zur Fehlerminderung) spiegelt das wider, indem er PEC als spezialisierte Option und nicht als Standardschicht zur Fehlerminderung behandelt.
Typische PEC-Anwendungsfälle sind:
-
Präzisions-Benchmarking von Quantenhardware,
-
Verifikation kleiner Quantenalgorithmen,
-
hochgenaue Quantenchemie auf reduzierten Systemen,
-
Gegenprüfung von ZNE oder anderen Mitigationsmethoden.
Das Verhältnis von PEC zu anderen Mitigationsmethoden
Viele andere Mitigationstechniken tauschen Genauigkeit gegen Skalierbarkeit ein; PEC macht genau das Gegenteil und konzentriert sich vor allem auf Genauigkeit.
Weil PEC möglicherweise nur auf einem Teilcircuit eingesetzt wird, ist hier besonders wichtig zu fragen, welche anderen Mitigationsmethoden sich damit kombinieren lassen. Um klar über die Kompatibilität mit PEC nachzudenken, hilft es, Techniken danach zu kategorisieren, was sie mit dem Rauschen machen. Betrachte diese allgemeinen Kategorien:
-
Rauschauslöschung – der Versuch, Fehlerkanäle zu invertieren
-
Rauschskalierung – das Rauschen gezielt erhöhen, um zu extrapolieren
-
Rauschumformung – die Struktur oder das Spektrum des Rauschens verändern
-
Bias-Entfernung – Fehler korrigieren, die nicht mit dem Gate-Rauschen skalieren
PEC gehört eindeutig zu Kategorie (1). Jede Methode, die den Rauschkanal verändert oder skaliert, muss sorgfältig geprüft werden.
Zusammenfassende Tabelle (Überblick)
| Technik | Kompatibel mit PEC | Hinweise |
|---|---|---|
| ZNE | Nein | Rückgängigmachen versus Skalieren und manchmal Anpassen des Fehlers |
| Pauli twirling | Ja (mit Vorsicht) | Beeinflusst das Fehlerverhalten, kann das Erlernen aber erleichtern |
| TREX | Ja | Keine Überschneidung im Workflow. Voll kompatibel. |
| Dynamical decoupling | Meist nein | Verändert den Fehlerkanal |
PEC und ZNE adressieren dieselben Fehlerquellen (Gate-Fehler), jedoch über zueinander inkompatible Annahmen oder Arbeitsabläufe, oder beides. Bei ZNE nehmen wir zum Beispiel an, dass sich der Fehler in einem Parameter entwickeln lässt:
und dass sich der Fehler wirksam skalieren lässt, um diese Entwicklung abzubilden. PEC würde genau den Fehler rückgängig machen, auf den wir uns bei der Skalierung stützen. Der Parameter würde bedeutungslos. Man kann es auch so sehen:
-
Wendest du ZNE vor PEC an, verändert das den Rauschkanal, den du invertieren möchtest.
-
Wendest du PEC vor ZNE an, entfernt das genau das Rauschen, auf das ZNE für die Extrapolation angewiesen ist.
PEC und ZNE sollten als alternative Paradigmen der Fehlermitigation betrachtet werden, nicht als kombinierbare Schichten. Sie nebeneinander zu vergleichen ist lehrreich, sie zu kombinieren dagegen nicht.
PEC und Pauli twirling sind im Allgemeinen kompatibel und oft vorteilhaft. Twirling kann PEC helfen, weil es kohärente Fehler in stochastische Pauli-Fehler umwandelt. Das vereinfacht den Rauschkanal und erleichtert es, ihn darzustellen und zu invertieren. Für PEC ist das äußerst wertvoll, und zwar aus folgenden Gründen:
-
Quasi-Wahrscheinlichkeitszerlegungen sind für Pauli-Kanäle deutlich einfacher
-
Die Quasi-Wahrscheinlichkeitsnorm ist oft erheblich kleiner
-
Die Stichprobenvarianz wird verringert
Viele PEC-Demonstrationen setzen Pauli-getwirltes Rauschen voraus oder bauen es ein. Es ist wichtig klarzustellen, dass Pauli-Twirling Fehler nicht von selbst mitigiert; es formt das Rauschen in eine Form um, die Probabilistic Error Cancellation effizienter handhaben kann.
PEC kann und sollte mit TREX kombiniert werden. Diese Ansätze sind voll kompatibel und spielen orthogonale Rollen. TREX wirkt nur bei der Messung, entfernt den Auslese-Bias über randomisierte Twirls des Messkanals und beeinflusst weder das Gate-Rauschen noch die Circuit-Dynamik. PEC wirkt auf das Gate-Rauschen. Da der Messfehler additiv statt kompositionell ist, ist er unabhängig von den Gate-Sequenzen. Es ist unbedenklich und oft wünschenswert, TREX zusammen mit PEC anzuwenden.
Die Reihenfolge dieser Methoden ist die, die du erwarten würdest:
- PEC-randomisierten Circuit ausführen
- TREX anwenden, um den Auslesefehler zu mitigieren
- PEC-Gewichtung und Mittelung anwenden
PEC und DD sind im Allgemeinen inkompatibel, es sei denn, die für PEC verwendete Rauschcharakterisierung wird bei aktivem DD durchgeführt. PEC setzt voraus, dass stationär, wiederholbar und genau charakterisierbar ist. DD formt den Rauschkanal explizit zeitlich um, indem es die System-Umgebungs-Wechselwirkungen moduliert und nicht triviale Pulszeiteffekte einführt. Daher ist das effektive Rauschen mit DD nicht derselbe Kanal wie ohne DD. Verkompliziert wird dies dadurch, dass der Rauschkanal empfindlich vom Circuit-Scheduling abhängen kann. Das Ergebnis ist, dass die Rauschinvertierung schlecht definiert oder ungültig wird.
Theoretisch ist es möglich, das Rauschen bei aktivem DD zu charakterisieren und ein entsprechendes PEC-Modell aufzubauen, aber das ist hochgradig fortgeschritten und derzeit kein empfohlener Workflow.
PEC von Hand anwenden
PEC ist komplex, und es wird nicht empfohlen, es von Hand zu implementieren. Dennoch wollen wir die Mathematik einer einfachen Anwendung auf einem einzelnen Qubit durcharbeiten, um zu verstehen, welche Schritte der Prozess umfasst. Wir wählen einen gemischten, aber nicht trivialen Zustand, damit wir numerische Effekte klar sehen können.
Nimm ein Qubit, das sich im reinen Zustand
befinden sollte.
Die ideale Dichtematrix lautet:
Wir haben diese Dichtematrix gewählt, weil sie nicht diagonal ist und nur ein einzelnes Qubit betrifft, sodass sie sich „von Hand“ gut untersuchen lässt.
Nun wenden wir ein sehr einfaches, aber realistisches Rauschmodell an: einen Ein-Qubit-Depolarisationskanal mit kleiner Stärke .
Damit die Rechnung übersichtlich bleibt, nehmen wir . Dieser Kanal ist vollständig positiv und spurerhaltend (CPTP), wie es sein muss. Er ist ein realistischer Rauschkanal für echte Hardware oder zumindest realistisch, um einen Teil des Rauschens zu beschreiben. Außerdem ist dieser Rauschkanal als lineare Abbildung analytisch invertierbar. Mit anderen Worten: Es gibt eine inverse Matrix, aber das bedeutet nicht, dass diese Matrix einem physikalischen CPTP-Kanal entspricht, und sie entspricht ganz sicher keiner Unitären, die auf Hardware implementiert werden könnte.
Nun wenden wir unseren Depolarisationskanal auf unsere Ein-Qubit-Dichtematrix an und erhalten:
Mit : und .
So:
Angewandt auf unseren Zustand:
Explizit berechnet:
Dies ist weiterhin eine physikalische Dichtematrix und hat weiterhin die Spur eins — ist jetzt aber stärker gemischt.
Nun berechnen wir den idealen inversen Kanal, wobei wir uns darauf einstellen, dass er möglicherweise nicht physikalisch ist. Wir werden prüfen, ob er es ist. Mathematisch lautet die inverse lineare Abbildung:
Wäre diese inverse Wirkung selbst ein gültiger physikalischer Kanal, wären wir versucht, sie exakt zu implementieren. Natürlich müssten wir noch herausfinden, wie sich das mit unitären Operationen und klassischen Schritten umsetzen lässt, aber genau das wäre das Ziel. Es stellt sich jedoch heraus, dass sie nicht CPTP ist, und im Allgemeinen gibt es keine Garantie, dass solche inversen Abbildungen CPTP sind. Das ist für unsere aktuelle Diskussion entscheidend, denn es ist der Grund, warum es PEC gibt.
Vielleicht siehst du schon beim bloßen Hinsehen, dass sie nicht CPTP ist. Eine todsichere Prüfung besteht darin, sie auf eine Dichtematrix anzuwenden und zu schauen, ob sie physikalische Ergebnisse liefert. Das bleibt als Übung, um dein Verständnis zu überprüfen.
Überprüfe dein Verständnis
Prüfe, ob die inverse Abbildung von oben CPTP ist, indem du sie auf eine neue Dichtematrix anwendest:
Interpretiere die Ergebnisse als physikalisch oder nicht physikalisch.
Antwort
Als physikalische Dichtematrix entspricht dies einer klassischen Wahrscheinlichkeit von mehr als 1, dass sich das System im Zustand befindet, und einer negativen Wahrscheinlichkeit, im Zustand zu sein. Offensichtlich kann diese Abbildung unsinnige Dichtematrizen liefern. Außerdem sehen wir durch Inspektion, dass die Eigenwerte der resultierenden Dichtematrix 1.0625 und -0.0625 sind, also nicht alle Eigenwerte positiv sind. Die Abbildung ist somit nicht „vollständig positiv“, das „CP“ in CPTP.
Überprüfe dein Verständnis
Prüfe durch explizite Rechnung, dass die obige inverse Operation den Rauschkanal rückgängig macht und den rauschfreien Zustand zurückliefert.
Antwort
Wende sie auf den verrauschten Zustand an:
Das ist genau der ursprüngliche Zustand (bis auf Rundung).
Zur absoluten Klarheit noch einmal: Wir können den Rauschkanal nicht exakt invertieren; die Inverse ist nicht CPTP und auch kein gültiger physikalischer Kanal. Wir können den Kanal jedoch effektiv als Linearkombination physikalischer Kanäle invertieren.
Für den Depolarisationskanal:
wobei: usw.
Die Inverse lässt sich schreiben als:
with:
-
= physikalisch implementierbare Clifford-Kanäle
-
= Quasi-Wahrscheinlichkeiten
-
Some
Das ist die Kernidee hinter PEC:
-
Kanäle gemäß ∣ samplen
-
Den Messergebnissen Vorzeichen zuordnen
-
Erwartungswerte konvergieren gegen den rauschfreien Wert
Wir wenden PEC „von Hand“ auf die Schätzung von an, indem wir die Dichtematrix verwenden, und sehen, ob wir die Ergebnisse für wiederherstellen können. Für erwarten wir:
Beachte außerdem, dass wir für die verrauschte Dichtematrix Folgendes erhalten:
Das hat die richtige Größenordnung, liegt aber deutlich vom Idealfall entfernt.
Nun gehen wir Schritt für Schritt durch, wie wir mit dem PEC-Prozess den erwartungstreuen Erwartungswert aus der verrauschten Dichtematrix rekonstruieren können. In echten Workflows ist dies probabilistisch und wird automatisiert. In diesem „Von-Hand“-Workflow wählen wir probabilistische Werte, die realistisch, für unsere Darstellung aber vielleicht bequem sind. Das sollte nicht als Behauptung verstanden werden, dass PEC perfekt ist. Es soll dir lediglich ein plausibles Szenario zeigen, wie es innerhalb der PEC-Pakete auftreten könnte.
Erinnere dich, dass unser Rauschkanal die Form hat:
Die Inverse lässt sich (exakt) schreiben als:
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Für diese Einführung ist es einfacher, sich auf die Wirkung des Kanals auf unsere Dichtematrix zu konzentrieren. So können wir mit vertrauten Objekten wie Dichtematrizen und Erwartungswerten arbeiten. Überlege dazu, was für die Wirkung dieser inversen Operation auf unseren Schätzprozess gelten muss: Der von PEC erzeugte Schätzer muss normiert und unverzerrt sein. Das entspricht zwei Bedingungen:
-
Normierung: Damit diese Operation die Skala der Observablen nicht verändert, verlangen wir . Um zu sehen, warum das so ist, könnten wir entweder die Wirkung der Inversen auf eine Dichtematrix betrachten oder ihre Wirkung auf den Erwartungswert von etwas Trivialem wie selbst.
-
Kalibrierung: In einem echten Workflow verwenden wir Kalibrierungscircuits, um das Rauschverhalten auf Gate-Ebene zu lernen. Dann nutzen wir das Wissen über das Rauschverhalten auf Gate-Ebene und die Linearität der Erwartungswerte, um das gelernte Rauschmodell auf den größeren Circuit anzuwenden. In unserem Fall sind wir von dem künstlichen Wissen ausgegangen, dass der ideale Erwartungswert ist. Es wäre aber sehr einfach, einen Zustand zu finden, für den wir theoretisch wissen, dass dies der ideale Wert ist, und dann echte Messungen zur Kalibrierung zu verwenden. Ein wichtiger Punkt ist, dass man bei PEC typischerweise kein vollständiges Rauschmodell des gesamten Circuits lernt. Stattdessen lernt man lokale Rauschmodelle für einzelne Gates oder Circuit-Schichten und nutzt diese, um die Quasi-Wahrscheinlichkeitszerlegung zu konstruieren.
Wir verwenden diese Bedingungen, um und zu bestimmen. Wir betrachten den Ansatz
and apply it to an arbitrary single-qubit density matrix .
Erinnere dich, dass die Pauli-Kanäle durch Konjugation wirken:
Die Anwendung von auf ergibt:
Bilden wir die Spur, erhalten wir:
Jeder Pauli-Operator ist unitär, sodass die Konjugation die Spur erhält:
Therefore,
Damit der PEC-Schätzer normiert ist, muss die effektive inverse Abbildung die Spur aller Dichtematrizen erhalten. Das heißt, wir verlangen:
Das impliziert die Normierungsbedingung:
In unserem Fall ergibt dies jedoch die Bedingung:
Nun nutzen wir die Kalibrierungsinformation, um den beobachteten Erwartungswert mit dem bekannten idealen in Beziehung zu setzen.
Or equivalently,
Wenn wir unsere beiden Bedingungen nach und auflösen, erhalten wir:
Diese Koeffizienten summieren sich zu 1, aber einer von ihnen ist negativ.
Wir können den idealen Erwartungswert wiederherstellen, indem wir den Circuit zufällig modifizieren, messen, das Ergebnis mit einem vorzeichenbehafteten Gewicht multiplizieren und mitteln. Insbesondere werden keine Dichtematrizen rekonstruiert, und es wird kein inverser Kanal physikalisch implementiert.
Der entscheidende Schritt: Das ist PEC
Für unsere Rauschstärke lässt sich der inverse Kanal schreiben als:
Wichtige Fakten:
-
Die Koeffizienten summieren sich zu 1
-
Ein Koeffizient ist negativ
-
Jeder Term ist physikalisch implementierbar
-
Die Negativität wandert in die klassische Nachverarbeitung
Wir bilden eine Sampling-Verteilung aus den Beträgen der Gewichte:
(jeweils für X, Y, Z)
Gesamtgewicht:
Für die Sampling-Wahrscheinlichkeiten wird durch W geteilt.
| Operation | Wahrscheinlichkeit | Vorzeichen |
|---|---|---|
| Nichts tun () | 1.1875 / 1.375 ≈ 0.864 | + |
| X anwenden | 0.0625 / 1.375 ≈ 0.045 | - |
| Y anwenden | 0.0625 / 1.375 ≈ 0.045 | - |
| Z anwenden | 0.0625 / 1.375 ≈ 0.045 | - |
Das Vorzeichen stammt vom ursprünglichen Koeffizienten, nicht von der Wahrscheinlichkeit.
Jeder Shot besteht aus diesen Schritten:
-
Den Zustand präparieren
-
Die Hardware den verrauschten Circuit anwenden lassen
-
Zufällig eine Operation aus der obigen Tabelle wählen, gemäß den zugehörigen Wahrscheinlichkeiten
-
Apply it
-
messen und erhalten
-
Das Ergebnis mit multiplizieren
-
Diese Zahl festhalten
Nun gehen wir Beispiele für mehrere Shots durch.
Shot 1 (Identitätsfall)
Angenommen, unsere zufällig gewählte Operation ist die Identität (oder gleichbedeutend: nichts tun). Nach den Überlegungen und der Tabelle oben passiert das in 86.4 % der Fälle. Weil der Koeffizient von in der Inversen des Rauschkanals positiv ist, wählen wir das Vorzeichen . Unsere Messung von Z könnte leicht liefern. Nehmen wir an, sie liefert .
Der PEC-korrigierte Beitrag dieses Shots wäre:
Shot 2 (wieder die Identität)
Angenommen, wir erhalten wieder als zufällige Operation (das Vorzeichen des Terms ist also zunächst weiterhin ), aber diesmal liefert unsere Messung von Z den Wert . Diesmal ist der Beitrag:
Shot 3 (X gewählt)
Diesmal ist unsere zufällige Operation X. Dieser Term in der Inversen ist negativ, also behalten wir das Vorzeichen . Wir wenden X an und messen dann Z. Wieder könnten wir einen der beiden Eigenwerte erhalten; sagen wir, wir erhalten . Der Beitrag dieses Terms ist:
Shot 4 (Z gewählt)
Die zufällige Operation ist Z. Das ergibt laut Tabelle das Vorzeichen . Angenommen, wir messen Z und erhalten . Der Beitrag ist:
Shot 5 (Y gewählt)
Die zufällige Operation ist Y. Das ergibt laut Tabelle das Vorzeichen . Angenommen, wir messen Z und erhalten . Der Beitrag ist:
Mittelung der Ergebnisse
Stell dir vor, wir sammeln viele solcher PEC-gewichteten Ergebnisse:
Per Konstruktion wenden wir in 86.4 % der Fälle die Identität an. Jedes der anderen Gates wenden wir in 4.5 % der Fälle an. In einem echten Workflow kennen wir weder die genauen zugrunde liegenden Zustände noch den gesamten Rauschkanal. Wir kennen aber den Gewichtungsfaktor von oben und die relative Wahrscheinlichkeit, mit der wir jede Operation anwenden. In einem echten Workflow verlassen wir uns darauf, dass die unbekannte Dichtematrix uns Messergebnisse liefert. Wir werden hier überprüfen, dass dieses Verfahren die richtigen Ergebnisse liefern würde.
Wir wollen den Mittelwert aller gewichteten, vorzeichenbehafteten Messungen berechnen, einschließlich der Anwendungen von Pauli-Operatoren vor der Messung. Die Gesamtzahl aller Shots nennen wir . Die Menge aller Shots, bei denen der Pauli-Operator angewendet wurde, nennen wir und indizieren diese Shots mit . Das Messergebnis des -Shots bei Anwendung des -Pauli-Operators nennen wir . Wir können diesen Mittelwert schreiben als:
Der Pauli-Operator wird probabilistisch mit der Wahrscheinlichkeit angewendet. Im Limes einer großen Zahl von Shots gilt
Damit können wir schreiben:
wobei der Erwartungswert von Z nur über das Ensemble der Shots ist, in denen angewendet wurde. Das ist nützlich, weil wir aus der Dichtematrix wissen, wie jeder dieser Erwartungswerte aussehen muss. Auch hier gilt: In einem echten Workflow würde er sich aus der Messung ergeben, nicht aus einer bekannten Dichtematrix.
Überprüfe dein Verständnis
Verifiziere die obigen Erwartungswerte durch Rechnung oder logisches Schlussfolgern.
Antwort
Y und Z verlaufen genau wie oben.
Wir können nun unseren gesamten Erwartungswert wie folgt umschreiben:
Wenn wir die Parameter und für unser Gate-Rauschen kennen (oder mehr Parameter für komplexere Rauschkanäle), genügt das, um (1) den Gesamtgewichtungsfaktor und (2) die Wahrscheinlichkeiten zu bestimmen, mit denen wir die Pauli-Operatoren anwenden sollten. Das obige Ergebnis zeigt: Wenn wir so vorgehen, mitigieren wir das Rauschen und erhalten erwartungstreue Erwartungswerte. Der Durchschnitt über alle diese Shots konvergierte gegen , obwohl:
-
einzelne Shots Beiträge liefern, die größer als ±1 sind
-
einige Shots ein negatives statistisches Gewicht haben
-
jede Quantenoperation physikalisch war
Überblick über den PEC-Workflow
Bei PEC sind alle Schritte auf dem Quantencomputer:
-
Rauschlernen
-
Zustandspräparation für deinen Ziel-Circuit
-
Pauli-Gates probabilistisch anwenden, wie oben beschrieben
-
Measurement
Die effektive inverse Rauschabbildung wird statistisch in der klassischen Nachbearbeitung realisiert. Das ermöglicht eine allgemeinere Inversion von Rauschkanälen, die andernfalls nicht-physikalische Schritte wie negative Wahrscheinlichkeiten erfordert hätten.
Der Preis dafür ist Varianz. Jeder Shot hatte zuvor eine „Größe“, die den möglichen Messergebnisgrößen entsprach. Nach der Skalierung mit dem Gewichtungsfaktor hat er die Größe (1.375 in unserem Beispiel oben).
Das ist der Ursprung des Sampling-Overheads von PEC.
Integriertes PEC
Jetzt verwenden wir PEC so, wie es in die IBM Quantum Primitives integriert ist. Dabei ist es wichtig, zwischen vollständigem PEC auf Gate-Ebene und einem lokalen Rauschlernmodell für skalierbareres PEC zu unterscheiden, das von den IBM Quantum Primitives verwendet wird. Der Overhead von vollständigem PEC würde dessen Anwendung auf kleine Circuits beschränken. Das ist in Ordnung, aber nützlicher ist ein Werkzeug, das auf eine Größe skaliert, bei der Quantencomputing für reale Probleme wertvoll wird. Aus diesem Grund verwenden die IBM Quantum Primitives ein schichtweises PEC mit einem gelernten Pauli-Lindblad-Rauschmodell und strengen Skalierbarkeits-Schutzmechanismen. Bei dieser Implementierung von PEC wird das Rauschen pro wiederholter Circuit-Schicht gelernt, nicht pro Gate-Instanz, und das Rauschmodell ist Pauli-getwirlt, lokal und markovsch. Clifford-Gates werden in das Rauschmodell absorbiert, während Nicht-Clifford-Gates die Mitigationskosten dominieren. Der Sampling-Overhead wird begrenzt, um exponentielles Anwachsen zu vermeiden.
Wir wenden das in die IBM Quantum Primitives integrierte PEC in zwei Größenordnungen an: klein (sechs Qubits) und mittelgroß (30 Qubits), um zu sehen, wie die Kosten in dieser PEC-Version beherrschbar bleiben. Innerhalb jedes Größenexperiments vergleichen wir die PEC-Ergebnisse außerdem explizit mit denen ohne Mitigation, mit ZNE und mit dem idealen Wert.
Wir beginnen mit dem Import einiger notwendiger Pakete.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Wir wählen eine zu schätzende Observable. Die untenstehende Observable ist der Hamiltonian einer Kette ising-artiger Spins mit Nächste-Nachbarn-Kopplung nur in der -Komponente ihrer Wechselwirkung und einem Einzel-Qubit-Term in , wie durch ein externes Feld in .
Es gibt keinen besonderen Grund für die Wahl dieses Hamiltonians. Wir brauchen lediglich eine nicht-triviale Kombination aus Observable und Circuit, damit die Fehlermitigation ihre Wirkung entfalten kann. Wir skalieren den Hamiltonian explizit (über die Koeffizienten) und teilen durch die Anzahl der Qubits, sodass die Energie bei wachsender Qubit-Zahl in derselben Größenordnung bleibt. Wir beginnen mit nur sechs.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Wie bei der Wahl des Hamiltonians ist auch der Circuit zur Zustandspräparation unten nicht aus physikalischen Gründen gewählt. Er wurde vielmehr so gewählt, dass er eine ausreichende Zwei-Qubit-Tiefe und genügend Nicht-Clifford-Gates hat, damit PEC nützlich sein kann. Es gibt keinen Grund anzunehmen, dass dieser Circuit zum Beispiel eine gute Näherung des Grundzustands dieser Spinkette ist.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
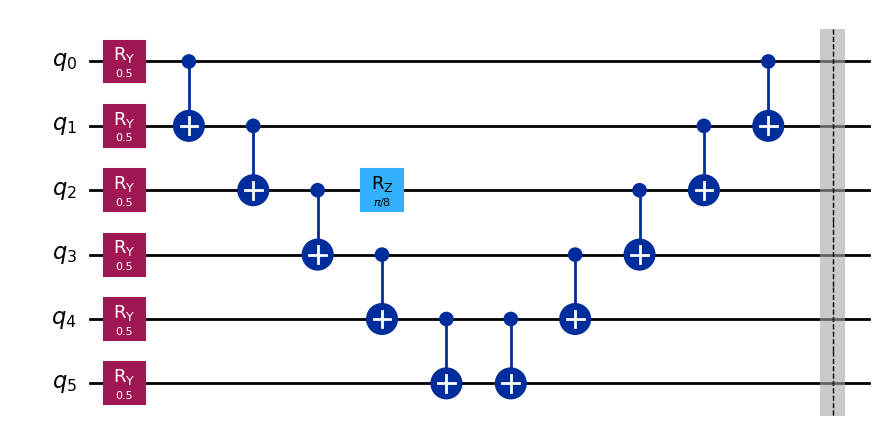
Wir transpilieren unseren Circuit und wenden das resultierende Layout auf unsere Observablen an.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Wir erhalten den idealen Erwartungswert mit dem Statevector-Simulator.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Wir erwarten, dass andere ideale Werte ähnlich groß sind. Jetzt führen wir das auf einem echten IBM-Quantencomputer ohne Fehlermitigation aus.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Jetzt wenden wir ZNE auf dasselbe Problem an.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Zum Schluss wenden wir PEC an.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Unten stellen wir unsere Ergebnisse grafisch dar und vergleichen sie.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
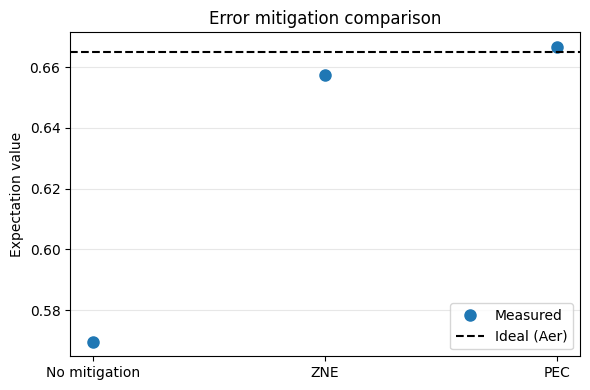
Das hat sehr gut funktioniert. Unsere Schätzung mit PEC weicht nur 0.2 % vom idealen Wert ab.
Aber denk daran, wie der Quanten-Overhead exponentiell wächst. Wir haben einen maximalen Overhead von max_overhead = 100 erzwungen. Nach der Laufzeit und der Qualität der Ergebnisse zu urteilen, scheinen wir dieses Maximum nicht erreicht zu haben. Wenn wir unsere Berechnung jedoch hochskalieren und dieses Maximum beibehalten, werden wir es erreichen, und unsere Ergebnisse werden darunter leiden.
Wir können sehen, was passiert, wenn wir unseren Circuit auf 30 Qubits hochskalieren. Interessanterweise läuft der Statevector-Simulator auf vielen Laptops bei etwa 24-28 Qubits in ein Timeout. Wir könnten rechnerische Wege drumherum finden. Aber stattdessen nehmen wir die Tatsache an, dass Quantencomputer einige Probleme in einem Maßstab lösen können, mit dem klassische Computer nicht mithalten können. Das ist der Punkt. Was können wir dann tun, um unsere Quantencomputing-Ergebnisse in diesen Fällen zu validieren? Es gibt mehrere mögliche Antworten:
- Manche Probleme sind schwer zu lösen, aber leicht zu überprüfen (wie die Primfaktorzerlegung im Shor-Algorithmus).
- Manche Probleme haben Parameterbereiche oder Varianten, die in ihrer Komplexität reduziert sind und klassisch oder sogar analytisch gelöst werden können, um einige Punkte zu vergleichen. In diesem Fall haben wir einen Hamiltonian gewählt, der intrinsisch ist (wir haben durch die Anzahl der Qubits geteilt). Der ideale Erwartungswert sollte ziemlich stabil sein. Schauen wir, wie der ideale Erwartungswert mit der Anzahl der Qubits variiert, und ob wir klassische Vorhersagen über den Wert bei 30 Qubits treffen können.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Tatsächlich sehen wir, dass wir einen Hamiltonian und einen Zustand gewählt haben, die sich mit der Anzahl der Qubits nicht ändern. Das ist für eine Forschungsanwendung des Quantencomputings sehr ungeeignet, für das Benchmarking von Fehlermitigationstechniken aber ausgezeichnet. Wir können diesen festen Erwartungswert zuversichtlich als idealen Wert verwenden, auch wenn wir die Anzahl der Qubits für das Testen der Fehlermitigation hochskalieren.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Jetzt führen wir diesen größeren Circuit mit ZNE aus.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Zum Schluss führen wir das 30-Qubit-Beispiel mit PEC aus.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
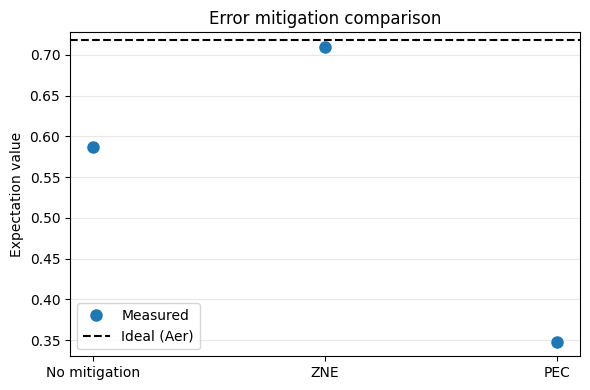
PEC dauerte nicht nur viel länger als die anderen Optionen, wir haben auch deutlich unsere maximale Overhead-Schwelle erreicht. Die PEC-Ergebnisse zahlten den Overhead-Preis, aber die Overhead-Begrenzung verhinderte eine ausreichend genaue Aufhebung des gelernten Rauschmodells. Das ist entscheidend. Bei sechs Qubits konnten wir PEC nutzen und bessere Ergebnisse mit nur einem moderaten Anstieg des Quanten-Overheads (etwa Faktor 5) erzielen. Bei 30 Qubits zahlten wir einen viel höheren Preis (etwa um den Faktor 60 höher), und die Ergebnisse waren sogar schlechter als die Schätzung ohne Mitigation. Das heißt nicht, dass PEC mit 30 Qubits nie funktionieren kann; das könnte vom Circuit abhängen. Die Botschaft ist einfach, dass das exponentielle Wachstum des Quanten-Overheads die Ausführung für große Circuits schwierig macht.
Wichtigste Erkenntnisse:
-
Messmitigation hilft oft und verursacht meist wenig Overhead: Sie beseitigt einen Bias, der nicht mit der Circuit-Tiefe skaliert, und lässt sich sauber mit fast allem kombinieren.
-
Einige Techniken lassen sich nicht kombinieren. Auch wenn sie sich kombinieren lassen, achte darauf, sie so konsistent zu kombinieren, dass die eine die andere nicht aufhebt. Ein gutes Beispiel ist sicherzustellen, dass Twirling während der Kalibrierung für M3 aktiv ist, wenn diese Methoden kombiniert werden sollen.
-
PEC und ZNE sollten als Alternativen zueinander betrachtet werden. Sie lösen dasselbe Problem mit entgegengesetzten Kompromissen:
-
PEC: liefert erwartungstreue Erwartungswerte auf Kosten exponentieller Varianz.
-
ZNE liefert im Allgemeinen einen Rest-Bias, der vom Extrapolationsmodell abhängt, aber zu moderaten Kosten.
-
-
DD kann bei langen Leerlaufzeiten helfen, verändert aber das Rauschmodell und kann Annahmen der Extrapolation oder Inversion ungültig machen.
-
Pauli-Twirling reduziert das Rauschen nicht. Es formt es um und ermöglicht es oft, dass andere Techniken (ZNE und PEC) besser funktionieren.