Backend-Eigenschaften mit Echtzeit-Benchmarking aktualisieren
Geschätzte Nutzungsdauer: 3 Minuten auf ibm_kingston (HINWEIS: Dies ist nur eine Schätzung. Deine tatsächliche Laufzeit kann abweichen.)
Lernziele
-
Warum die von einer QPU gemeldeten Eigenschaften dem aktuellen Verhalten des Geräts hinterherhinken können und wann es sich lohnt, sie selbst neu zu messen
-
Was jedes der fünf Standard-Charakterisierungsexperimente (Readout, Single-Qubit Randomized Benchmarking, Layered-Two-Qubit Randomized Benchmarking, und ) misst
-
Wie man die vollständige Charakterisierungs-Suite in einem einzigen Aufruf oder Schritt für Schritt ausführt und ein Backend-Objekt mit aktualisierten Eigenschaften zurückerhält
-
Wie man die gemessenen Eigenschaften mit den gemeldeten vergleicht und warum manche Unterschiede eher auf die Messmethodik als auf Gerätedrift zurückzuführen sind
Voraussetzungen
-
Der Qiskit-Patterns-Workflow
-
Qiskit Runtime-Ausführungsmodi, insbesondere der batch mode
-
Wie man QPU-Informationen erkundet, wie zum Beispiel Backend-Eigenschaften und Kalibrierungsdaten
Hintergrund
Jede IBM Quantum®-QPU meldet eine Reihe von Eigenschaften, die beschreiben, wie gut jedes ihrer Qubits derzeit funktioniert: Relaxationszeiten (), Kohärenzzeiten (), Readout-Fehler sowie Ein- und Zwei-Qubit-Gate-Fehler. Diese Werte sind in der Praxis wichtig. Der Transpiler nutzt sie, um zu entscheiden, auf welchen physischen Qubits dein Circuit ausgeführt werden soll, Fehlermitigationstechniken verlassen sich auf sie, und du könntest sie nutzen, um zu beurteilen, ob ein Gerät für ein Experiment gut genug funktioniert.
Die gemeldeten Eigenschaften stammen aus Kalibrierungsverfahren, die typischerweise etwa einmal täglich durchgeführt werden. Supraleitende Qubits können jedoch auf kürzeren Zeitskalen driften, und transiente Defekte (sogenannte Zwei-Niveau-Systeme) können ein Qubit, das zum Kalibrierungszeitpunkt hervorragend aussah, vorübergehend verschlechtern. Außerdem wird ein Job oft lange bevor er tatsächlich ausgeführt wird transpiliert, sodass auf den gemeldeten Eigenschaften basierende Entscheidungen auf veralteten Informationen beruhen können. Das Tutorial Echtzeit-Benchmarking für die Qubit-Auswahl zeigt, wie stark diese Eigenschaften von Tag zu Tag schwanken können, und baut manuell einen vollständigen Charakterisierungs-Workflow aus einzelnen Qiskit Experiments auf.
Dieses Tutorial zeigt die optimierte Version dieses Workflows, indem es das BackendCharacterization-Dienstprogramm aus Qiskit Device Benchmarking verwendet, das die Experimentkonstruktion, Job-Einreichung und Kurvenanpassung in wenigen Aufrufen zusammenfasst. Du verbrauchst etwa 70 Sekunden QPU-Zeit und erhältst ein Backend-Objekt zurück, dessen Eigenschaften das Gerät genau jetzt widerspiegeln, bereit, mit den gemeldeten Werten verglichen oder an nachgelagerte Tools weitergegeben zu werden.
Die Charakterisierungsexperimente
Die Suite misst fünf Eigenschaften, jede mit einem Standardexperiment:
-
Readout-Fehler (
readout): Jedes Qubit wird in oder präpariert und sofort gemessen. Die Wahrscheinlichkeit, den falschen Zustand auszulesen, ergibt den State-Preparation-and-Measurement-Fehler (SPAM). -
Single-Qubit-Gate-Fehler (
rb_1q): Randomized Benchmarking (RB) führt Sequenzen zufälliger Single-Qubit-Clifford-Gates aus, die sich idealerweise zur Identität zusammensetzen. Die Art, wie die Überlebenswahrscheinlichkeit mit der Sequenzlänge abnimmt, liefert den durchschnittlichen Fehler pro Gate, unabhängig von SPAM-Fehlern. -
Zwei-Qubit-Gate-Fehler (
rb_2q): Dieselbe RB-Idee, angewendet auf vollständige Schichten nicht überlappender Zwei-Qubit-Gates, die gleichzeitig ausgeführt werden, wie in einem Layer-Fidelity-Experiment. Da viele Gates gleichzeitig laufen, enthalten die resultierenden Fehlerraten Crosstalk-Effekte und kommen dem näher, was ein tiefer Circuit tatsächlich erfährt. -
(
t1): Jedes Qubit wird angeregt und nach zunehmenden Verzögerungen gemessen. Der Zerfall der Population des angeregten Zustands ergibt die Relaxationszeit. -
(
t2): Ein Hahn-Echo-Experiment versetzt jedes Qubit in eine Superposition, wendet auf halber Strecke einer Verzögerung einen Echo-Puls an und misst, wie schnell die Phasenkohärenz verloren geht. Standardmäßig wird ein einzelnes Echo verwendet; eine Multi-Echo-Variante (im CPMG-Stil) wird am Ende dieses Tutorials demonstriert.
Was die Aktualisierung bewirkt und was nicht
Beachte drei Punkte bei der Verwendung dieses Workflows:
-
Die aktualisierten Eigenschaften existieren nur in dem an dich zurückgegebenen Backend-Objekt. Am Gerät selbst oder an den Kalibrierungsdaten, die IBM Quantum anderen Nutzern meldet, ändert sich nichts.
-
Die gemessenen Werte sind eine Momentaufnahme, die mit einer bestimmten Methodik erfasst wurde. Einige davon, insbesondere die geschichteten Zwei-Qubit-Fehler und die parallelen Single-Echo--Werte, werden anders gemessen als die gemeldeten Kalibrierungsdaten, sodass ein Teil jeder beobachteten Abweichung methodisch bedingt ist und nicht auf Gerätedrift zurückzuführen ist. Dieses Tutorial weist darauf hin, wo das der Fall ist.
-
Die Charakterisierung selbst kostet QPU-Zeit (etwa 70 Sekunden für die vollständige Suite auf einem Heron-r2-Prozessor), was der Preis für aktuelle Informationen ist.
Der Workflow folgt den vier Schritten eines Qiskit Pattern:
-
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden. Wähle das Gerät und die Menge der zu messenden Eigenschaften aus.
-
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren. Das Dienstprogramm erstellt die Experiment-Circuits direkt in den nativen Gates des Geräts und parallelisiert sie über den gesamten Chip.
-
Schritt 3: Mit Qiskit-Primitives ausführen. Die Experimente laufen als Sampler-Jobs innerhalb eines Batches.
-
Schritt 4: Nachbearbeiten und Ergebnis im gewünschten klassischen Format zurückgeben. Fitte die Messdaten zu qubitweisen Fehlerkarten, aktualisiere das Backend und vergleiche die gemessenen Eigenschaften mit den gemeldeten.
Voraussetzungen
Stelle sicher, dass du Folgendes installiert hast, bevor du mit diesem Tutorial beginnst:
-
Qiskit SDK v2.0 oder höher, mit Unterstützung für Visualisierung
-
Qiskit Runtime v0.40 oder höher (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, das auch Qiskit Experiments installiert (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Setup
Importiere die erforderlichen Bibliotheken.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Die Charakterisierungs-Suite erstellt mehrere Experimente, reicht mehrere Jobs ein und fittet die Ergebnisse, was insgesamt einige Minuten dauern kann. Aktiviere Logging auf INFO-Ebene, damit jede Phase ihren Fortschritt laufend ausgibt.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Kleines Simulator-Beispiel
Dieses Tutorial enthält kein Simulator-Beispiel. Der Workflow misst die physischen Unvollkommenheiten eines bestimmten Geräts: wie schnell seine Qubits relaxieren und dephasieren und wie oft seine Gates und sein Readout versagen. Ein idealer Simulator hat keine dieser Unvollkommenheiten, sodass es nichts zu charakterisieren gibt. Du könntest ein synthetisches Rauschmodell an ein Fake-Backend anhängen, aber die Experimente würden dann nur die Werte zurückliefern, die du selbst eingegeben hast. Aus diesem Grund gehen wir direkt zur Hardware über, aufgeteilt in die vier Schritte eines Qiskit Pattern.
Großes Hardware-Beispiel
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
In diesem Workflow ist das „Problem“ das Gerät selbst: Die klassischen Eingaben sind die QPU, die du charakterisieren möchtest, und die Liste der zu messenden Eigenschaften, und die Quantenexperimente sind die daraus erzeugten Charakterisierungs-Circuits.
Wähle zunächst ein Backend aus. Dieses Tutorial verwendet ibm_kingston, einen 156-Qubit-Heron-r2-Prozessor; du kannst jedes IBM Quantum-Gerät, auf das du Zugriff hast, dafür einsetzen (oder eines mit service.least_busy() auswählen).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Wähle als Nächstes aus, welche Eigenschaften gemessen werden sollen. Du kannst eine beliebige Teilmenge der folgenden Experimente übergeben:
-
readout: SPAM-Experiment (State Preparation and Measurement) -
rb_1q: isoliertes Single-Qubit Randomized Benchmarking -
rb_2q: simultanes Two-Qubit Randomized Benchmarking aus einem Layer-Fidelity-Experiment -
t2: -Hahn-Echo-Experiment (standardmäßig ein einzelnes Echo) -
t1: -Relaxationsexperiment
Führe die vollständige Suite aus, um ein vollständiges Bild des Geräts zu erhalten; entferne Einträge aus der Liste, wenn dich nur bestimmte Eigenschaften interessieren und du QPU-Zeit sparen möchtest.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren
In den meisten Tutorials würdest du an dieser Stelle deine Circuits transpilieren. Hier übernimmt BackendCharacterization das intern. Es baut die Experiment-Circuits direkt in den nativen Gates des Geräts auf, führt die Single-Qubit-Experimente parallel auf allen Qubits aus und plant das Zwei-Qubit-Benchmarking über disjunkte Schichten der Coupling Map, sodass das gesamte Gerät mit einer Handvoll Jobs abgedeckt wird. Aufgrund dieser Parallelisierung verbraucht die gesamte Suite nur etwa 70 Sekunden QPU-Zeit.
Initialisiere die Klasse, die den Workflow verwaltet:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Schritt 3: Mit Qiskit-Primitiven ausführen
Die Methode run_experiments baut die Circuits auf und reicht sie als Sampler-Jobs ein. Führe sie innerhalb eines Batch-Kontexts aus, damit die Jobs gemeinsam auf der QPU geplant werden; die Methode kehrt zurück, sobald alle Jobs eingereicht wurden. (Du kannst sie auch außerhalb eines Batches oder innerhalb einer Session ausführen.)
Es kann sein, dass du eine Warnung siehst, dass ein Backend übergeben wird, während ein Session-Kontextmanager geöffnet ist. Dies ist erwartet und kann gefahrlos ignoriert werden.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Die Methode gibt die eingereichten Jobs als ein nach Experiment indiziertes Dictionary zurück, was nützlich ist, um sie im IBM Quantum Platform-Dashboard zu verfolgen oder zur Fehlersuche.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Schritt 4: Nachbearbeiten und Ergebnis im gewünschten klassischen Format zurückgeben
Die Ergebnisse analysieren
Die Methode analyze_results wartet, bis die Jobs abgeschlossen sind, und fittet die Messdaten: exponentielle Zerfälle für und , Überlebenswahrscheinlichkeits-Zerfälle für die RB-Experimente sowie Zuordnungsmatrizen für das Readout. Sie gibt ein Dictionary von Fehlerkarten zurück, einen Eintrag pro gemessener Eigenschaft, wobei jede einem Qubit (oder Qubit-Paar) seinen gemessenen Wert zuordnet.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Die Karten umfassen den Readout-Fehler, die Single-Qubit-Gate-Fehler x und sx, die geschichteten Zwei-Qubit-Fehler (lf_error_map, aus dem Layer-Fidelity-Experiment) sowie die - und -Zeiten in Sekunden.
Die Backend-Eigenschaften aktualisieren
Die Methode update_backend schreibt die gemessenen Werte in die Eigenschaften einer Kopie des Backends und gibt diese zurück. Das ursprüngliche backend-Objekt behält die gemeldeten Kalibrierungsdaten, sodass wir die beiden vergleichen können, wie unten gezeigt. Denke daran, dass dieses Update rein lokal für deine Python-Sitzung ist; es ändert nichts am Gerät oder für andere Nutzer/innen.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Die gemessenen Eigenschaften mit den gemeldeten vergleichen
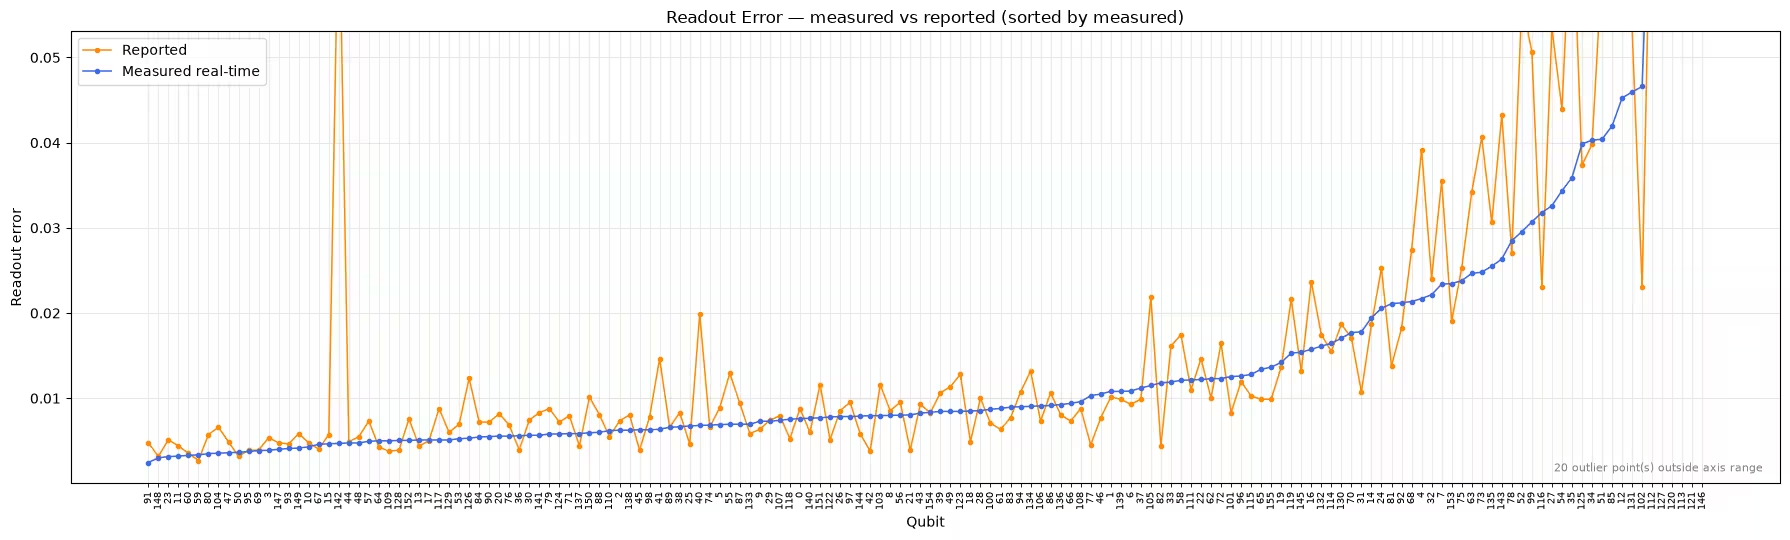
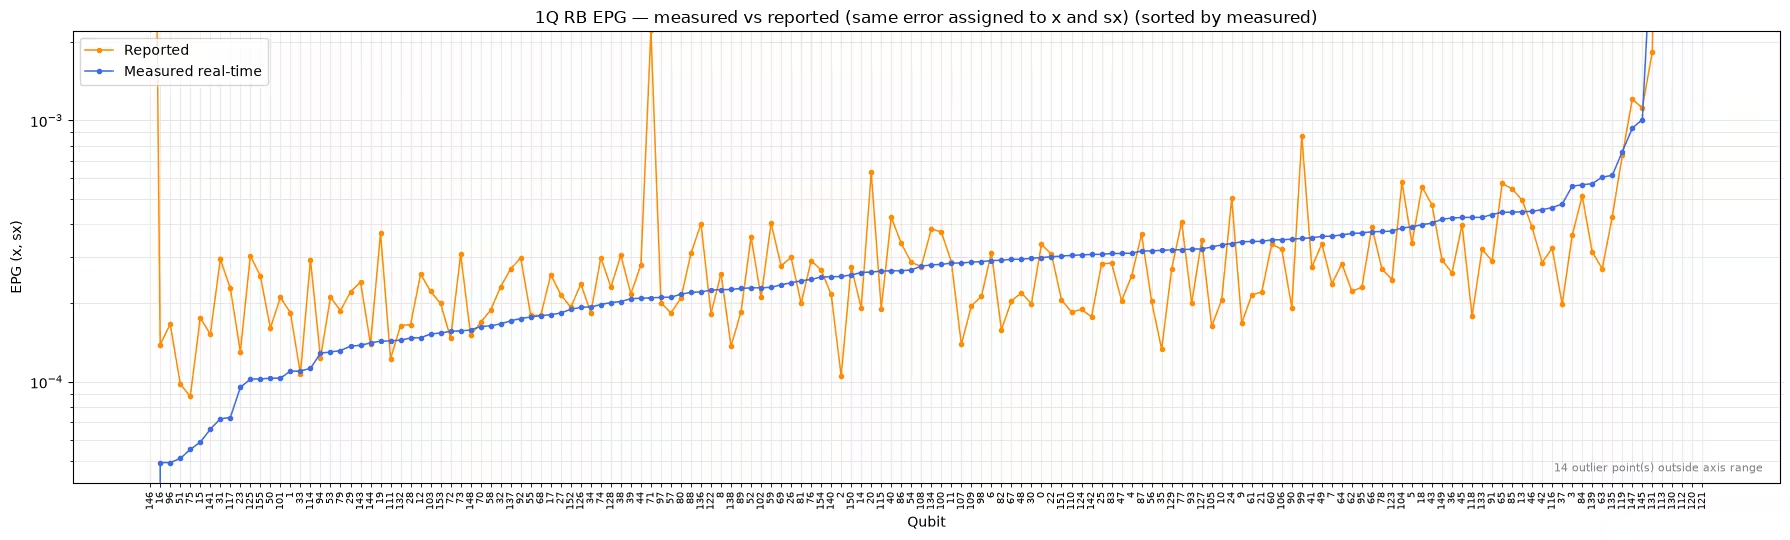
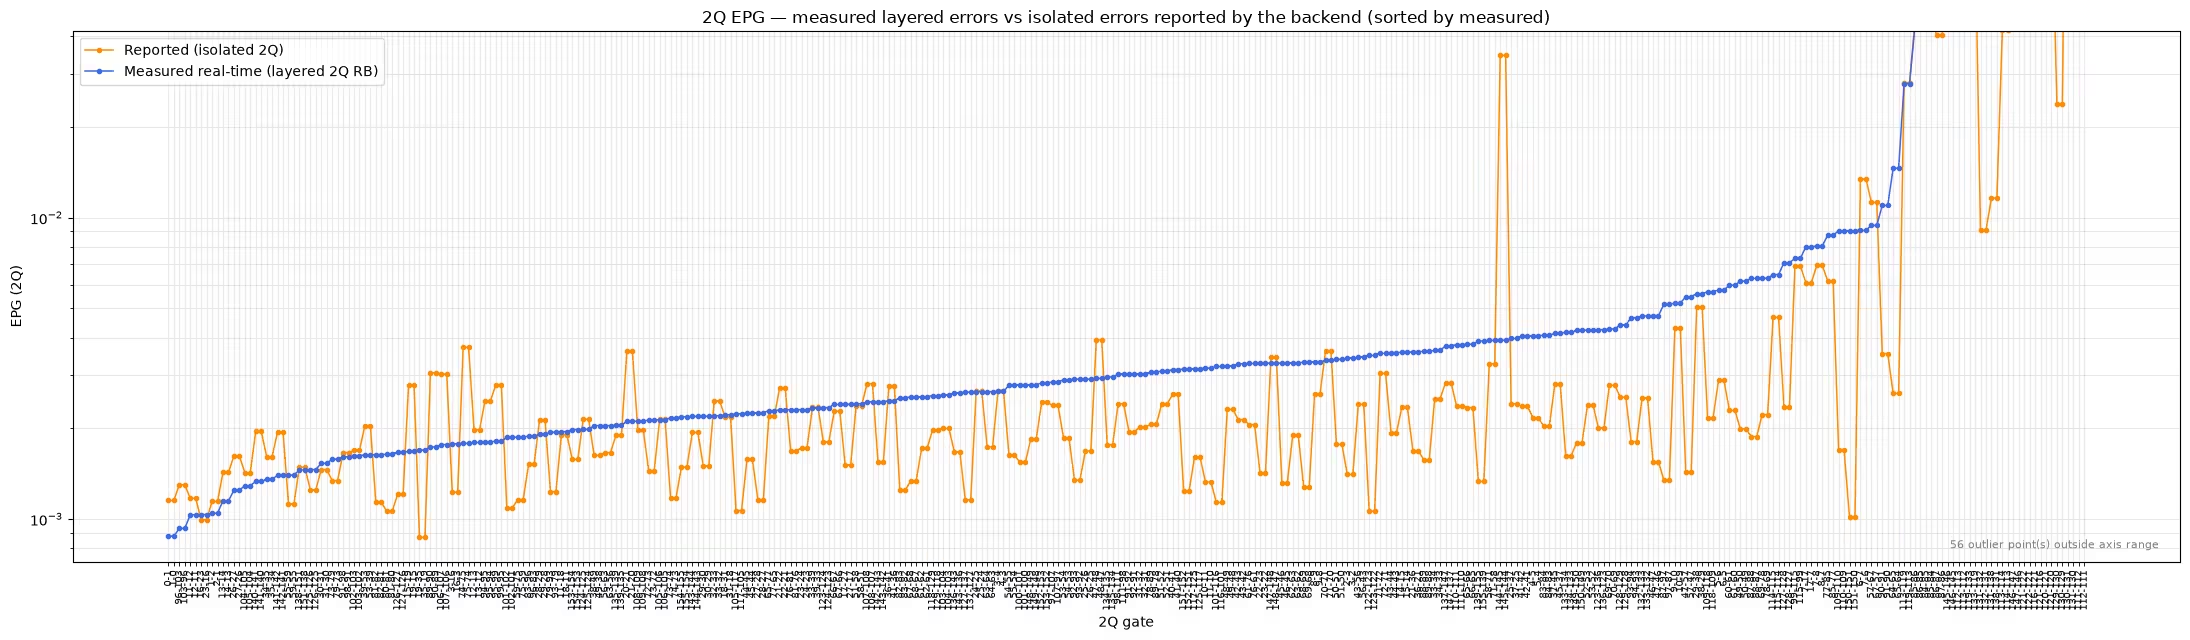
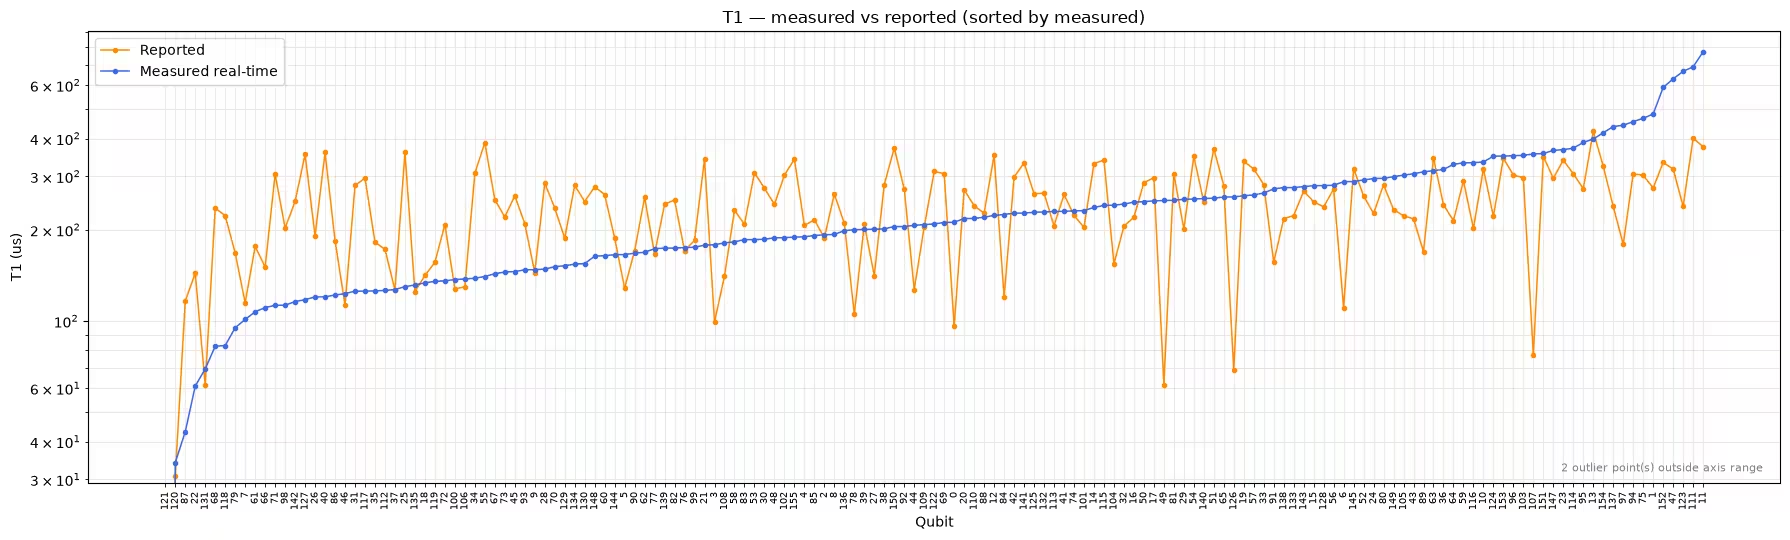
Plotte zum Schluss die gemessenen Echtzeit-Eigenschaften gegen die vom Backend gemeldeten Werte. In jedem Panel sind die Qubits (oder Qubit-Paare) nach dem gemessenen Wert sortiert, sodass die gemessene Kurve konstruktionsbedingt glatt ist und die Streuung der gemeldeten Werte um sie herum zeigt, wo die beiden voneinander abweichen. Für Single-Qubit-RB wird nur ein einzelner Plot gezeigt, da derselbe gemessene Fehler pro Gate sowohl dem x- als auch dem sx-Gate zugewiesen wird. Die Achsengrenzen werden aus dem Großteil der Daten gewählt, sodass wenige extreme Ausreißer die Plots nicht stauchen; alle Punkte außerhalb des Bereichs werden in einer Anmerkung auf dem Plot gezählt (oder übergib ylim, um die Grenzen zu überschreiben).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
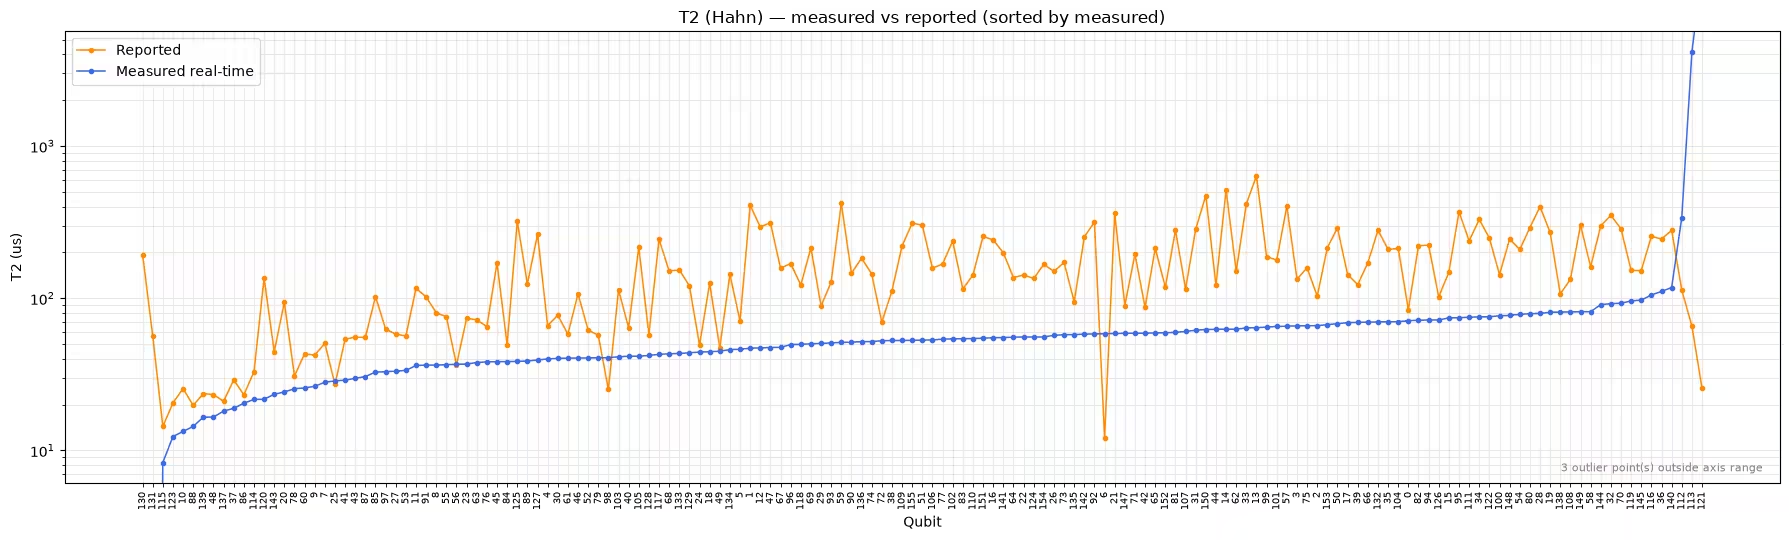
Diese Plots erfordern eine sorgfältige Lektüre, da nicht jede Lücke zwischen den beiden Kurven bedeutet, dass das Gerät gedriftet ist:
-
Readout- und Single-Qubit-Fehler: Die gemessenen Werte folgen bei den meisten Qubits den gemeldeten Werten, während der gemeldete Wert bei einer Handvoll Qubits weit von der gemessenen Kurve abweicht. Diese lokalisierten Abweichungen sind die Drift, die dieser Workflow erkennen soll.
-
: Die beiden Datensätze streuen ohne systematischen Versatz umeinander, was dazu passt, dass von Natur aus über die Zeit schwankt.
-
Zwei-Qubit-Fehler: Die gemessenen Werte liegen systematisch über den gemeldeten Werten. Das ist zu erwarten, da die gemeldeten Werte an isolierten Gates gemessen werden, während das Layer-Fidelity-Experiment viele Gates gleichzeitig ausführt und daher Crosstalk einschließt. Die geschichteten Werte sind für tiefe Circuits relevanter, aber nicht direkt mit den gemeldeten Kalibrierungsdaten vergleichbar.
-
: Die gemessenen Werte liegen bei den meisten Qubits deutlich unter den gemeldeten Werten. Auch hier spielt die Methodik eine große Rolle, wie im nächsten Abschnitt untersucht wird.
Einzelne Experimentergebnisse untersuchen
Du kannst auch die Rohergebnisse der einzelnen Charakterisierungsexperimente über die Eigenschaft experiment_data einsehen, die die zugrunde liegenden Qiskit Experiments ExperimentData-Objekte zurückgibt. Das Folgende zeigt beispielsweise die gemessene -Zerfallskurve eines einzelnen Qubits, was nützlich ist, um die Qualität eines Fits zu prüfen, bevor du der daraus resultierenden Zahl vertraust.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

T2 mit einem Dynamical-Decoupling-Zug messen
Standardmäßig wendet das -Experiment ein einzelnes Hahn-Echo an und misst alle Qubits parallel, was, wie der Vergleichsplot oben zeigte, deutlich niedrigere -Werte ergeben kann, als das Backend meldet. Eine Hypothese betrifft die Anzahl der Echos: Die gemeldeten Werte könnten mit Dynamical Decoupling kalibriert worden sein, das niederfrequentes Rauschen unterdrückt. Um dies zu testen, führe eine reine -Charakterisierung durch, bei der t2_num_echoes auf einen größeren Wert gesetzt wird, was einen Zug von Echo-Pulsen im CPMG-Stil anwendet. Die Verzögerungen stellen in beiden Fällen die gesamte freie Entwicklungszeit dar, sodass die gefitteten -Werte direkt mit den Einzel-Echo-Ergebnissen vergleichbar sind.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
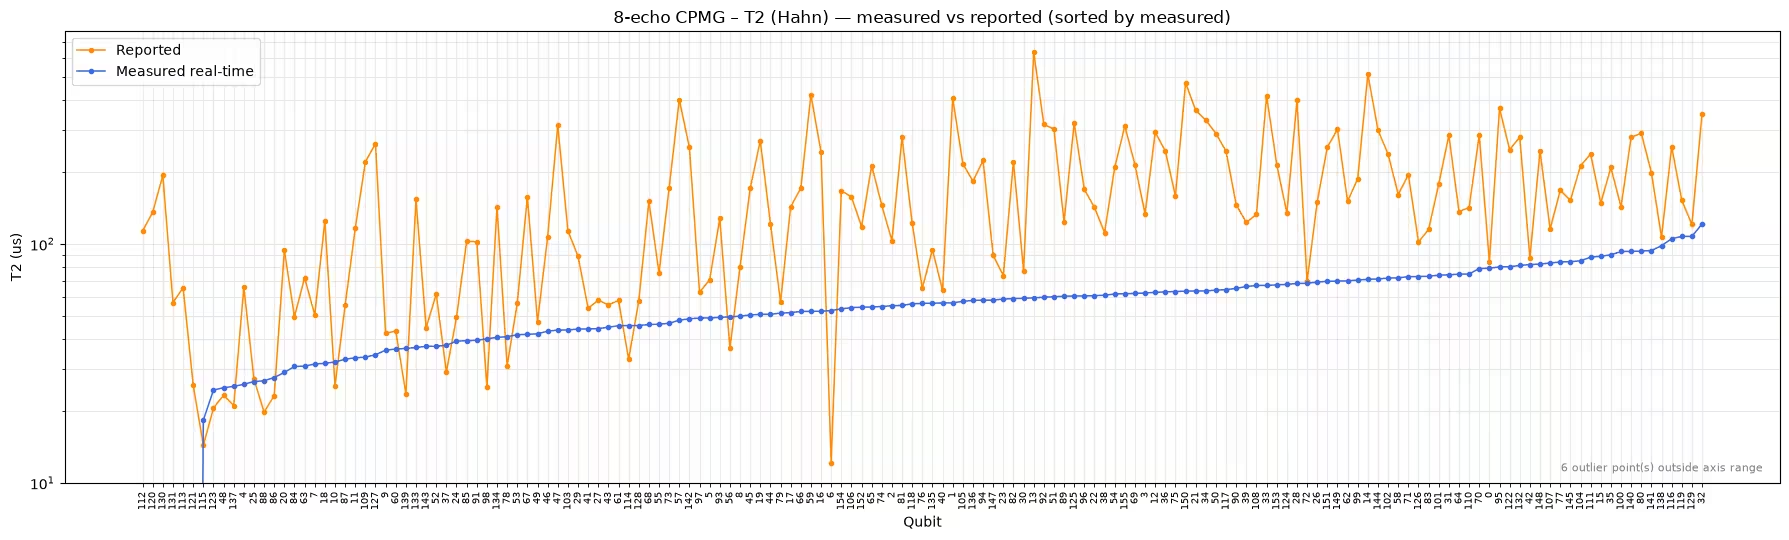
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
In diesem Durchlauf änderten die zusätzlichen Echos das Ergebnis kaum: Der Median mit 8 Echos (56 µs) liegt nahe am Median mit einem Echo (53 µs), und beide bleiben weit unter dem gemeldeten Median (142 µs). Die Anzahl der Echos allein erklärt diese Lücke nicht; andere methodische Unterschiede spielen eine Rolle, etwa Details des Kalibrierungsverfahrens, das parallele statt isolierte Messen aller Qubits und so weiter.
Die praktische Lehre daraus ist, Vergleiche von (und dem geschichteten Zwei-Qubit-Fehler) über verschiedene Methodiken hinweg mit Vorsicht zu behandeln. Die aktualisierten Werte sind eine in sich konsistente Momentaufnahme, die unter Bedingungen nahe einer realen Arbeitslast erfasst wurde, was sie gut geeignet macht, um Qubits miteinander zu vergleichen oder ein Gerät über die Zeit zu verfolgen. Eine Abweichung von den gemeldeten Kalibrierungsdaten ist jedoch nicht automatisch ein Beweis für Drift.
Schritte 1–4 zu einem einzigen Aufruf zusammengefasst
Für den alltäglichen Gebrauch benötigst du die Zwischenergebnisse selten. Die Methode run_and_update verkettet alles, was du oben gemacht hast (Aufbauen, Einreichen, Fitten und Aktualisieren), zu einem einzigen Aufruf, der das aktualisierte Backend zurückgibt. Sie akzeptiert dieselbe experiments-Liste (und leitet Optionen wie t2_num_echoes weiter) und kann ebenso in einen Batch- oder Session-Kontext eingebettet werden.
Die folgende Zelle gibt erst zurück, wenn alle Jobs und die Nachbearbeitung abgeschlossen sind.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Das aktualisierte backend_updated-Objekt ist nun einsatzbereit, wo immer Backend-Eigenschaften in deinen Workflow einfließen. Probiere diesen Prozess in Verbindung mit dem Tutorial Echtzeit-Benchmarking für die Qubit-Auswahl aus, um beim Transpilieren eines Circuits die leistungsstärksten Qubits auszuwählen. Da das Gerät weiterhin driftet, aktualisiere die Eigenschaften kurz vor der tatsächlichen Ausführung deiner Arbeitslast.
Nächste Schritte
Wenn du diese Arbeit interessant findest, könnten dich die folgenden Materialien interessieren:
- Verwende die aktualisierten Eigenschaften, um im Tutorial Echtzeit-Benchmarking für die Qubit-Auswahl bessere Qubits auszuwählen
- Erfahre im Leitfaden QPU-Informationen, wie die gemeldeten Kalibrierungsdaten bereitgestellt werden
- Erkunde die einzelnen Charakterisierungsexperimente in der Qiskit Experiments-Dokumentation
- Durchstöbere weitere Benchmarks auf Geräteebene im Qiskit Device Benchmarking-Repository