Die Natur simulieren
Schau dir dieses Video von Olivia Lanes über die Simulation der Natur mit Quantencomputern an, oder öffne es in einem separaten Fenster auf YouTube.
Diese Lektion verwendet Inhalte aus diesem Tutorial:
Tutorial zur Fehlerminderung im Utility-Maßstab mit Probabilistic Error Amplification
Einleitung
Eine der überzeugendsten Anwendungen von Quantencomputern ist ihre Fähigkeit, natürliche Phänomene zu simulieren. In dieser Lektion werden wir untersuchen, wie Quantencomputer zur Lösung von Quantendynamikproblemen eingesetzt werden – konkret, wie sie uns helfen, die Zeitentwicklung eines Quantensystems zu verstehen.
Zunächst werden wir einen allgemeinen Überblick über die Schritte bei der Durchführung dieser Simulationen geben. Dann werden wir ein konkretes Beispiel untersuchen: das Experiment, das IBM 2023 präsentierte und das das Konzept der Quantum Utility demonstrierte. Dieses Experiment dient als exzellente Fallstudie zum Verständnis der praktischen Schritte und Implikationen der Simulation von Quantendynamik mit echter Quantenhardware. Am Ende wirst du ein klareres Bild davon haben, wie Forscher diese Herausforderungen angehen und warum die Quantensimulation ein solches Versprechen für das Vorantreiben unseres Verständnisses der natürlichen Welt birgt.
Richard Feynman hielt 1959 einen hocheinflussreichen Vortrag am Caltech. Er trug den berühmten Titel „There's Plenty of Room at the Bottom" (Es ist viel Platz am Boden), in spielerischer Anspielung auf die riesigen, unerforschten Möglichkeiten im mikroskopischen Maßstab. Feynman argumentierte, dass vieles der Physik auf atomarer und subatomarer Ebene noch entdeckt werden musste.
Die Bedeutung des Vortrags wuchs in den 1980er Jahren mit dem technologischen Fortschritt. In dieser Zeit griff Feynman diese Ideen in einem weiteren wichtigen Vortrag am Caltech wieder auf und präsentierte ein Paper mit dem Titel „Simulating Nature with Computers" (Die Natur mit Computern simulieren). Dort stellte er eine kühne Frage: Könnten Computer verwendet werden, um exakte Simulationen durchzuführen, die das Verhalten der Natur auf Quantenebene replizieren? Feynman schlug vor, dass wir anstatt grober Näherungen zur Modellierung atomarer Prozesse Computer verwenden könnten, die die Gesetze der Quantenmechanik selbst nutzen – nicht nur um die Natur zu modellieren, sondern sie zu emulieren.
Es ist genau diese Art von physikalischer Simulation, die wir in dieser Lektion untersuchen werden.
Erinnere dich an diese Timeline-Grafik, die in einer früheren Episode eingeführt wurde. An einem Ende des Spektrums sehen wir Probleme, die einfach zu lösen sind und nicht die erhöhte Geschwindigkeit erfordern, die Quantencomputing bringen könnte.
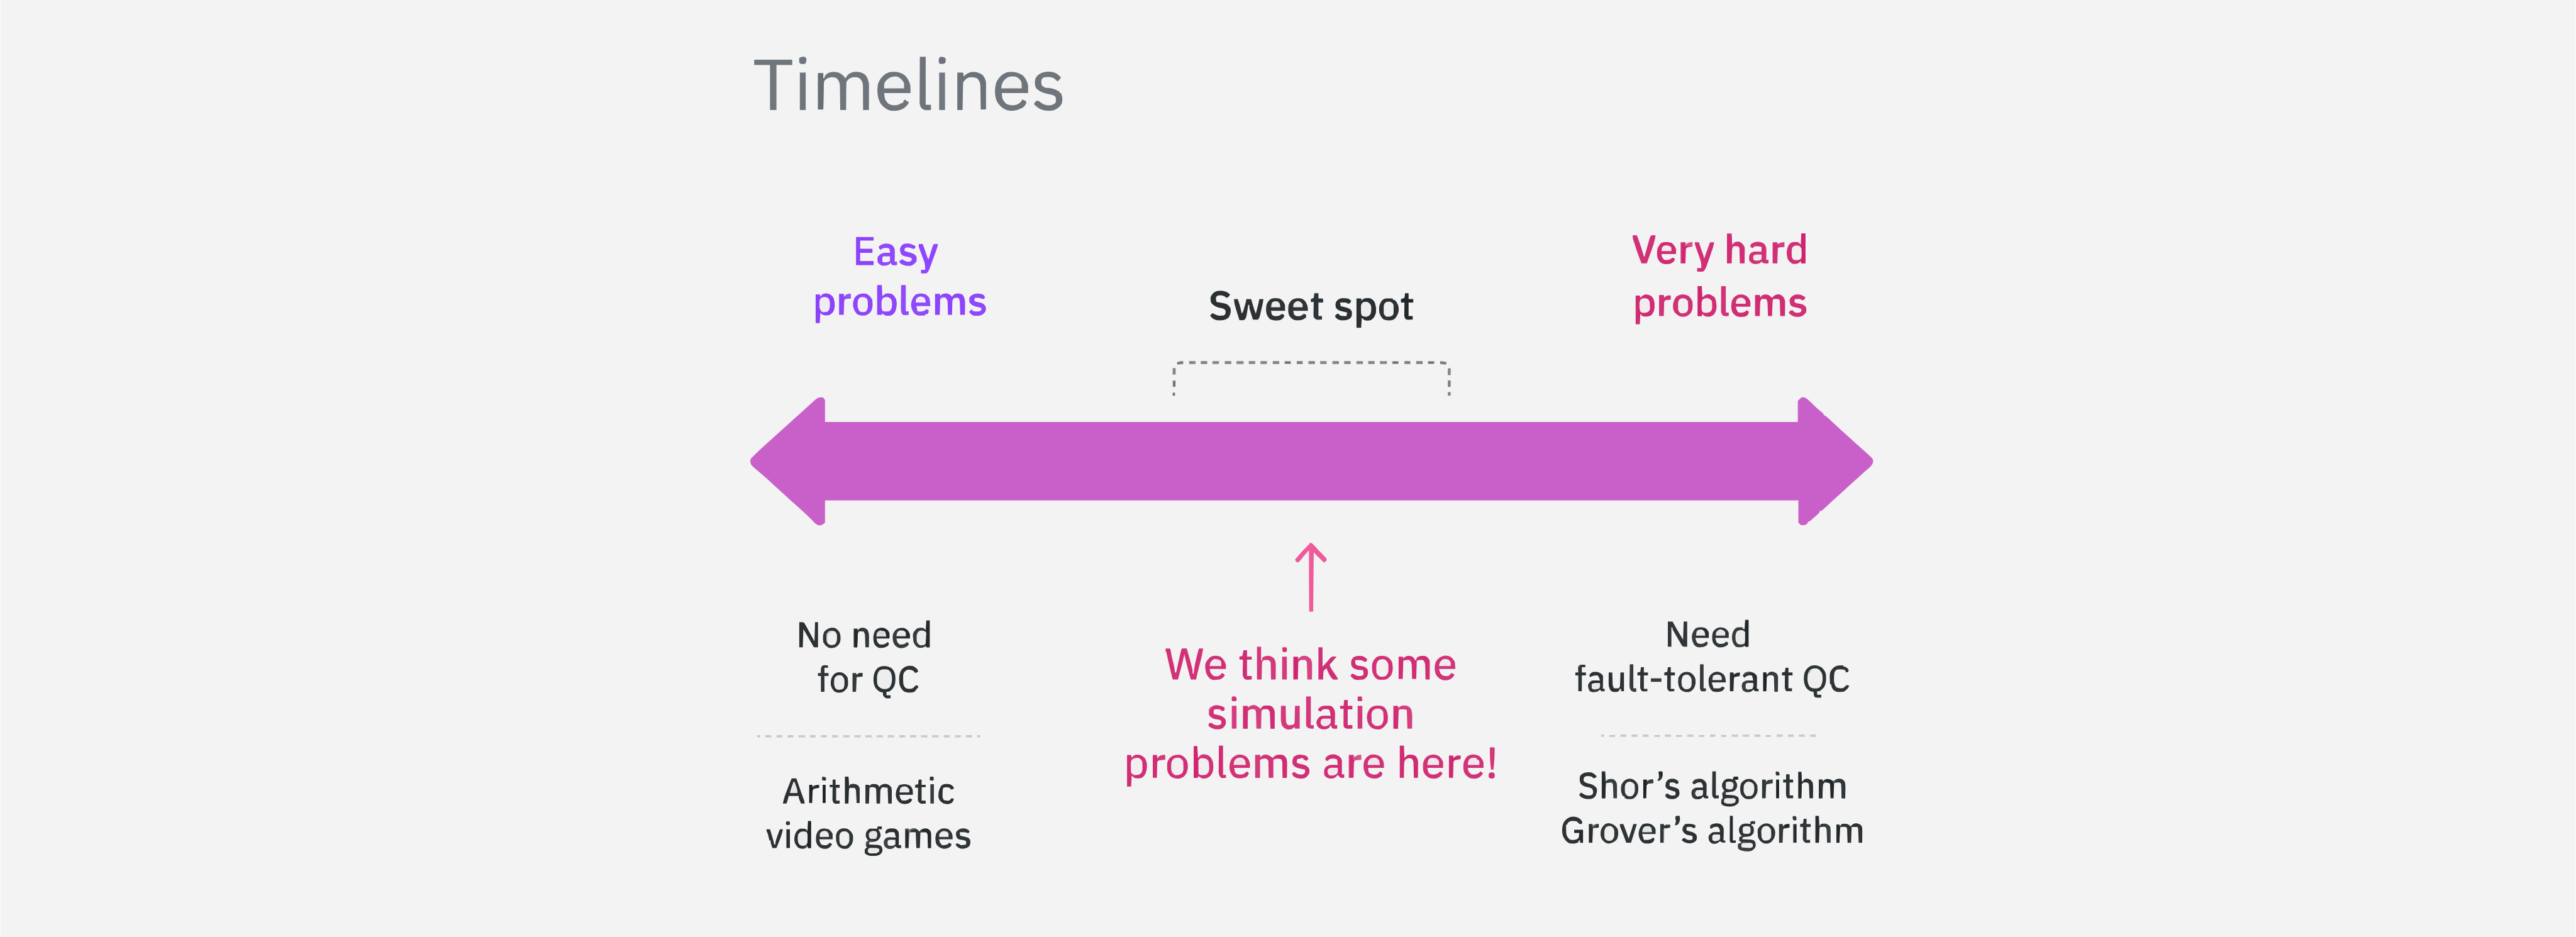
Am anderen Ende befinden sich extrem schwierige Probleme, die vollständig fehlertolerante Quantenmaschinen erfordern – Technologie, die noch nicht verfügbar ist. Glücklicherweise wird angenommen, dass viele Simulationsprobleme irgendwo in der Mitte dieser Timeline liegen, im Bereich, wo die heutigen Quantencomputer bereits effektiv eingesetzt werden können. Es gibt viele Gründe für Begeisterung und Faszination angesichts dieser Aussicht, da die Simulation der Natur die Grundlage für eine breite Palette vielversprechender Anwendungen bildet.
Die folgenden Informationen behandeln den allgemeinen Workflow in Natursimulationen und dann eine spezifische Instanz des Workflows, um Ergebnisse einer bekannten Studie zu replizieren.
Allgemeiner Workflow
Bevor jemand Quantencomputing auf diese aufregenden Bereiche anwenden kann, ist es wichtig, zunächst die grundlegenden Schritte in einem typischen Simulations-Workflow zu verstehen:
-
System-Hamiltonoperator identifizieren
-
Hamiltonoperator-Kodierung
-
Zustandspräparation
-
Zeitentwicklung des Zustands
-
Circuit-Optimierung
-
Circuit-Ausführung
-
Nachverarbeitung
Der Prozess beginnt mit der Identifikation eines interessierenden Quantensystems. Dies hilft dabei, den Hamiltonoperator zu bestimmen, der seine Zeitentwicklung bestimmt, sowie eine aussagekräftige Beschreibung seiner Anfangseigenschaften bzw. seines Zustands. Als Nächstes musst du eine geeignete Methode auswählen, um die Zeitentwicklung dieses Zustands zu implementieren. Beachte, dass die ersten vier Schritte dieses Workflows alle Teil des Mapping-Schritts im Qiskit-Patterns-Framework sind.
Nachdem der Zeitentwicklungscircuit eingerichtet wurde, umfassen die folgenden Phasen die Durchführung des eigentlichen Experiments. Dies beinhaltet typischerweise die Optimierung des Quantencircuits, der den Zeitentwicklungsalgorithmus implementiert, das Ausführen des Circuits auf Quantenhardware und die Nachverarbeitung der Ergebnisse. Sie entsprechen den letzten drei Schritten im Qiskit-Patterns-Framework.
Als Nächstes besprechen wir, was diese Schritte bedeuten, bevor wir mit dem Programmieren beginnen.
1. Den System-Hamiltonoperator identifizieren
Der erste wesentliche Schritt bei der Durchführung eines Simulationsexperiments besteht darin, den Hamiltonoperator zu bestimmen, der das System beschreibt. In vielen Fällen ist der Hamiltonoperator bereits gut etabliert. Häufig konstruieren wir ihn jedoch, indem wir die Energiebeiträge kleinerer Teile des Systems aufsummieren. Dies wird typischerweise als Summe von Termen ausgedrückt:
wobei jeder Term auf eines der lokalen Subsysteme (wie ein einzelnes Teilchen oder eine kleine Gruppe von Teilchen) des Gesamt-Hamiltonoperators wirkt. Bei ununterscheidbaren Elementarteilchen ist es wichtig zu bestimmen, ob es sich beim System um Fermionen oder Bosonen handelt, wobei Fermionen dem Pauli-Ausschlussprinzip gehorchen, was bedeutet, dass keine zwei identischen Fermionen denselben Quantenzustand einnehmen können, wie zum Beispiel Elektronen. Im Gegensatz zu Fermionen können mehrere Bosonen denselben Quantenzustand einnehmen, und dieser Unterschied wirkt sich auf die Statistik des Systems und darauf aus, wie es modelliert werden muss.
In der Praxis interessiert man sich oft für physikalische Systeme, bei denen die Elemente als gut voneinander getrennt oder gekennzeichnet und somit unterscheidbar angenommen werden, wie etwa bei Spins auf einem Gitter.
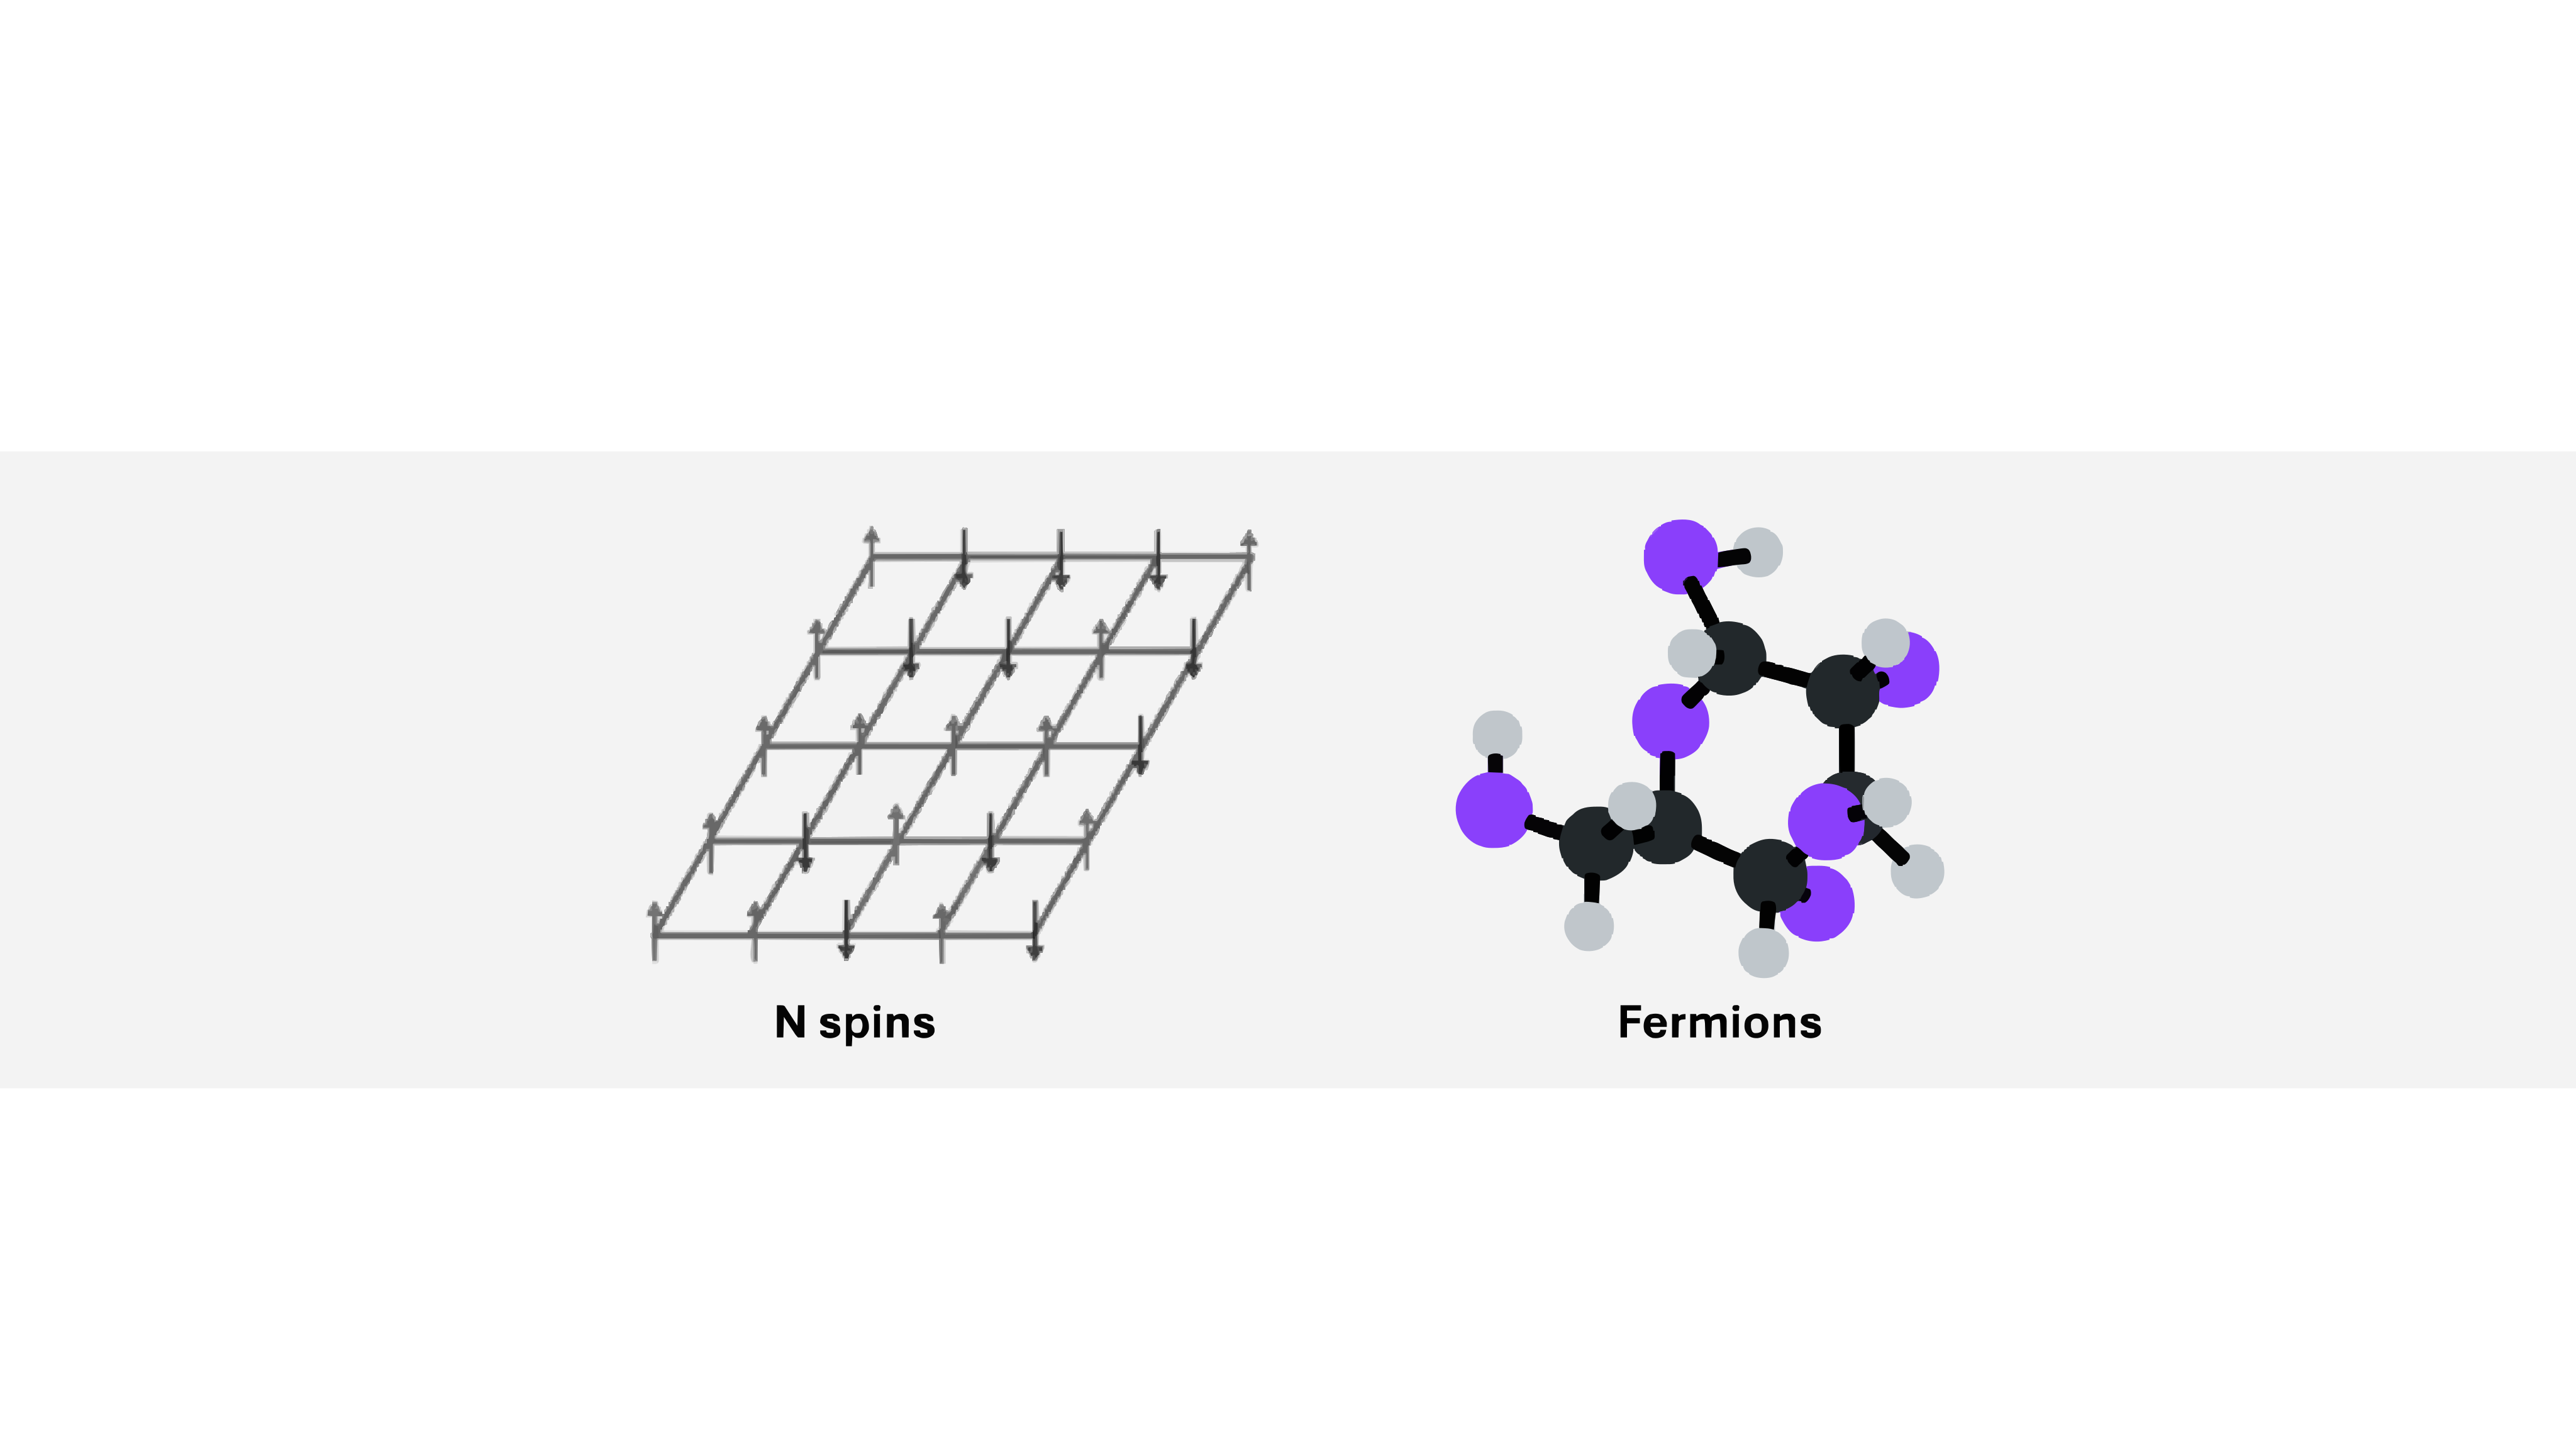
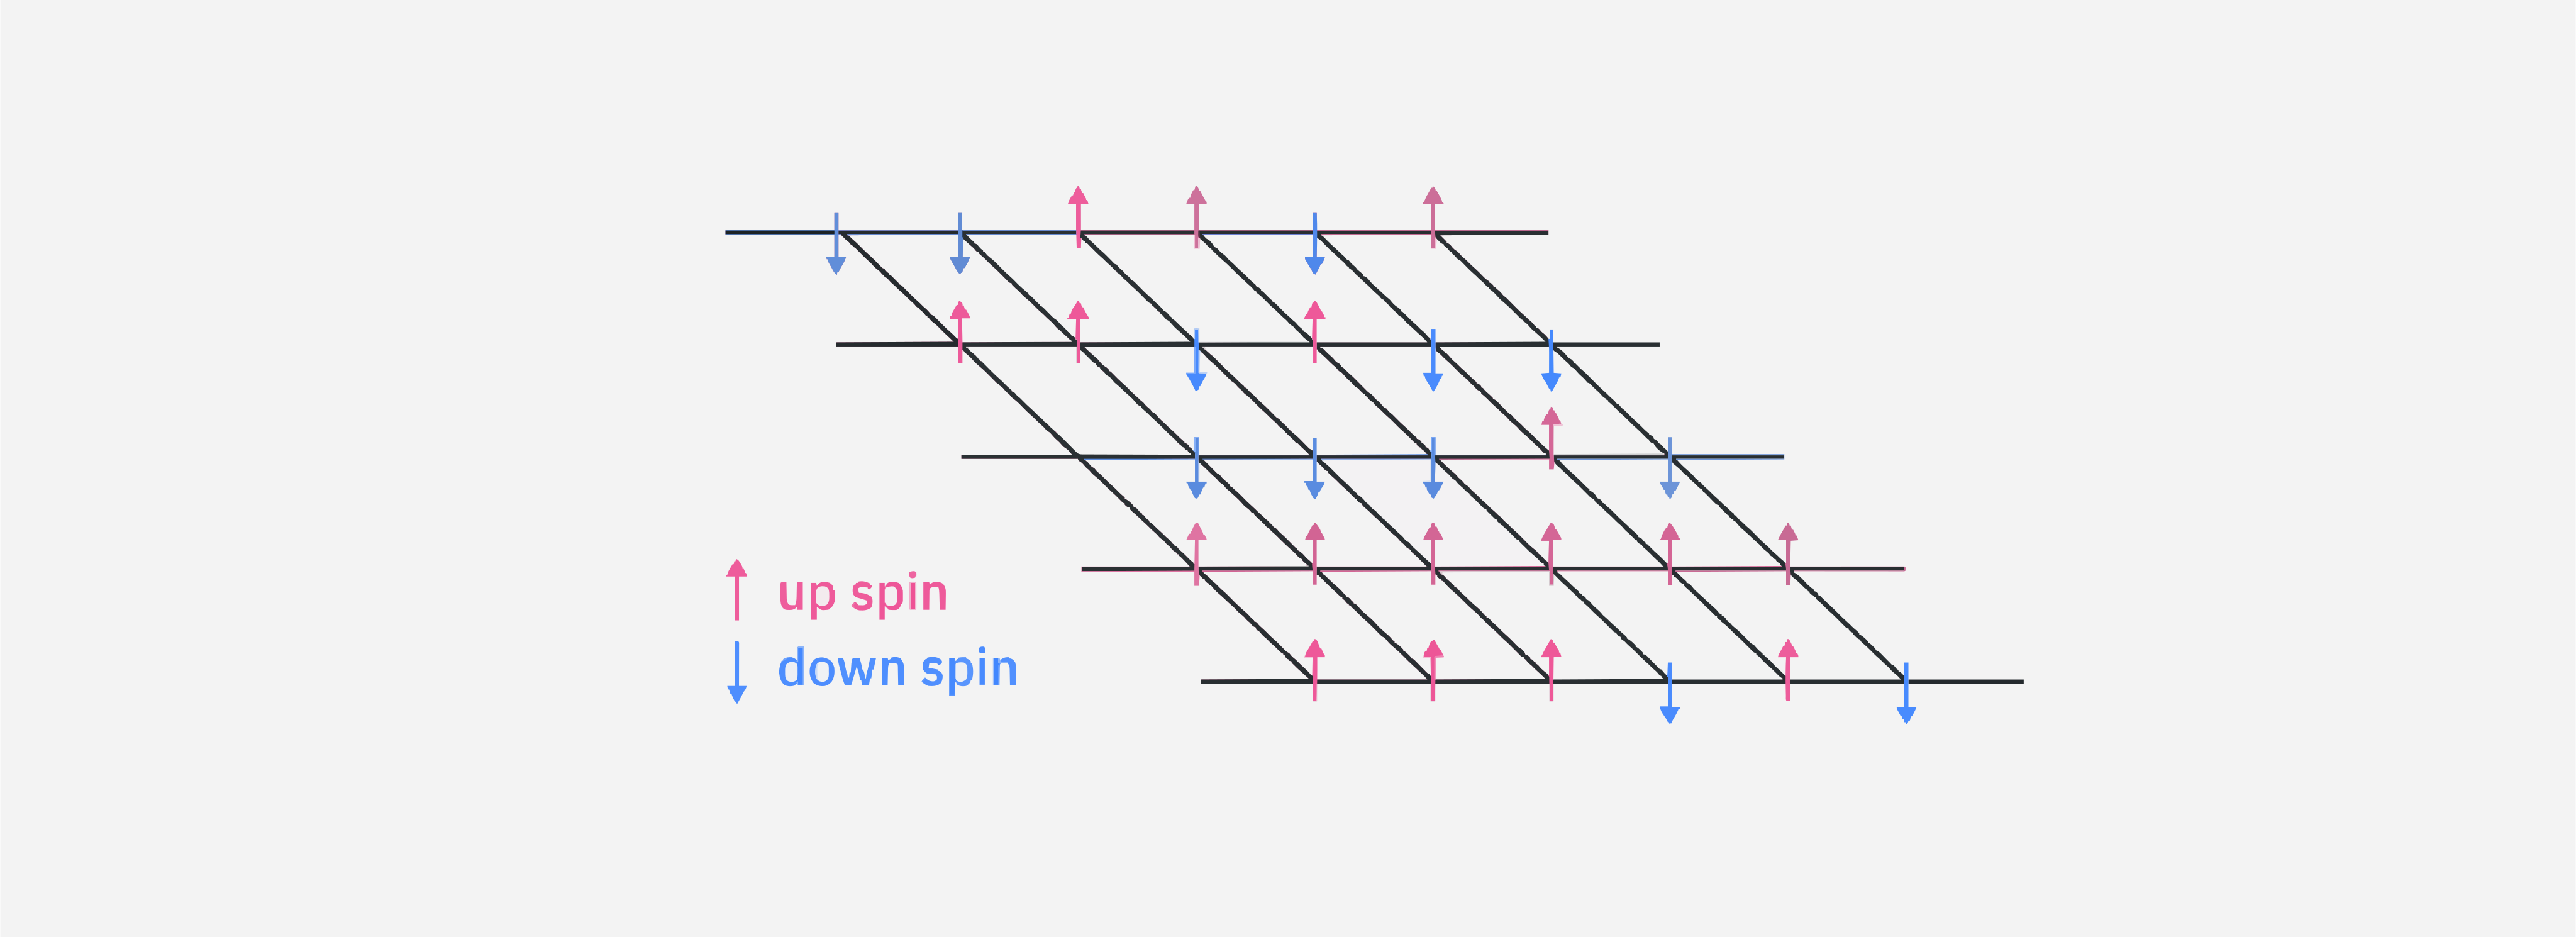
Dieses System besteht aus magnetischen Dipolspins, die auf einem Gitter angeordnet sind und die durch das Zählen ihrer Adresse als unterscheidbare Teilchen behandelt werden. Dieses System wird durch das Transversalfeld-Ising-Modell beschrieben, und sein Hamiltonoperator wird aus der Summe zweier Teile konstruiert:
Dabei repräsentiert der erste Term die Wechselwirkungsenergie zwischen benachbarten Spins. Hier gibt an, dass wir über alle Paare von Spins summieren, die direkt auf dem Gitter miteinander verbunden sind, und sind die Pauli-Z-Matrizen, die den Zustand der Spins an den Stellen und repräsentieren, und ist die Kopplungskonstante, die die Stärke dieser Wechselwirkung definiert. Der zweite Term repräsentiert den Einfluss eines externen Magnetfelds, das auf das gesamte System angewendet wird. Hier ist die Pauli-X-Matrix, die auf den einzelnen Spin an der Stelle wirkt, und gibt die Stärke dieses externen Feldes an.
2. Hamiltonoperator-Kodierung
Der nächste Schritt besteht darin, den Hamiltonoperator in eine Form zu übersetzen, die ein Quantencomputer verarbeiten kann – diesen Prozess nennen wir Kodierung. Dieser Kodierungsprozess hängt entscheidend von der Art der Teilchen im System ab: unterscheidbar oder ununterscheidbar sowie, falls die Teilchen ununterscheidbar sind, Fermion oder Boson.
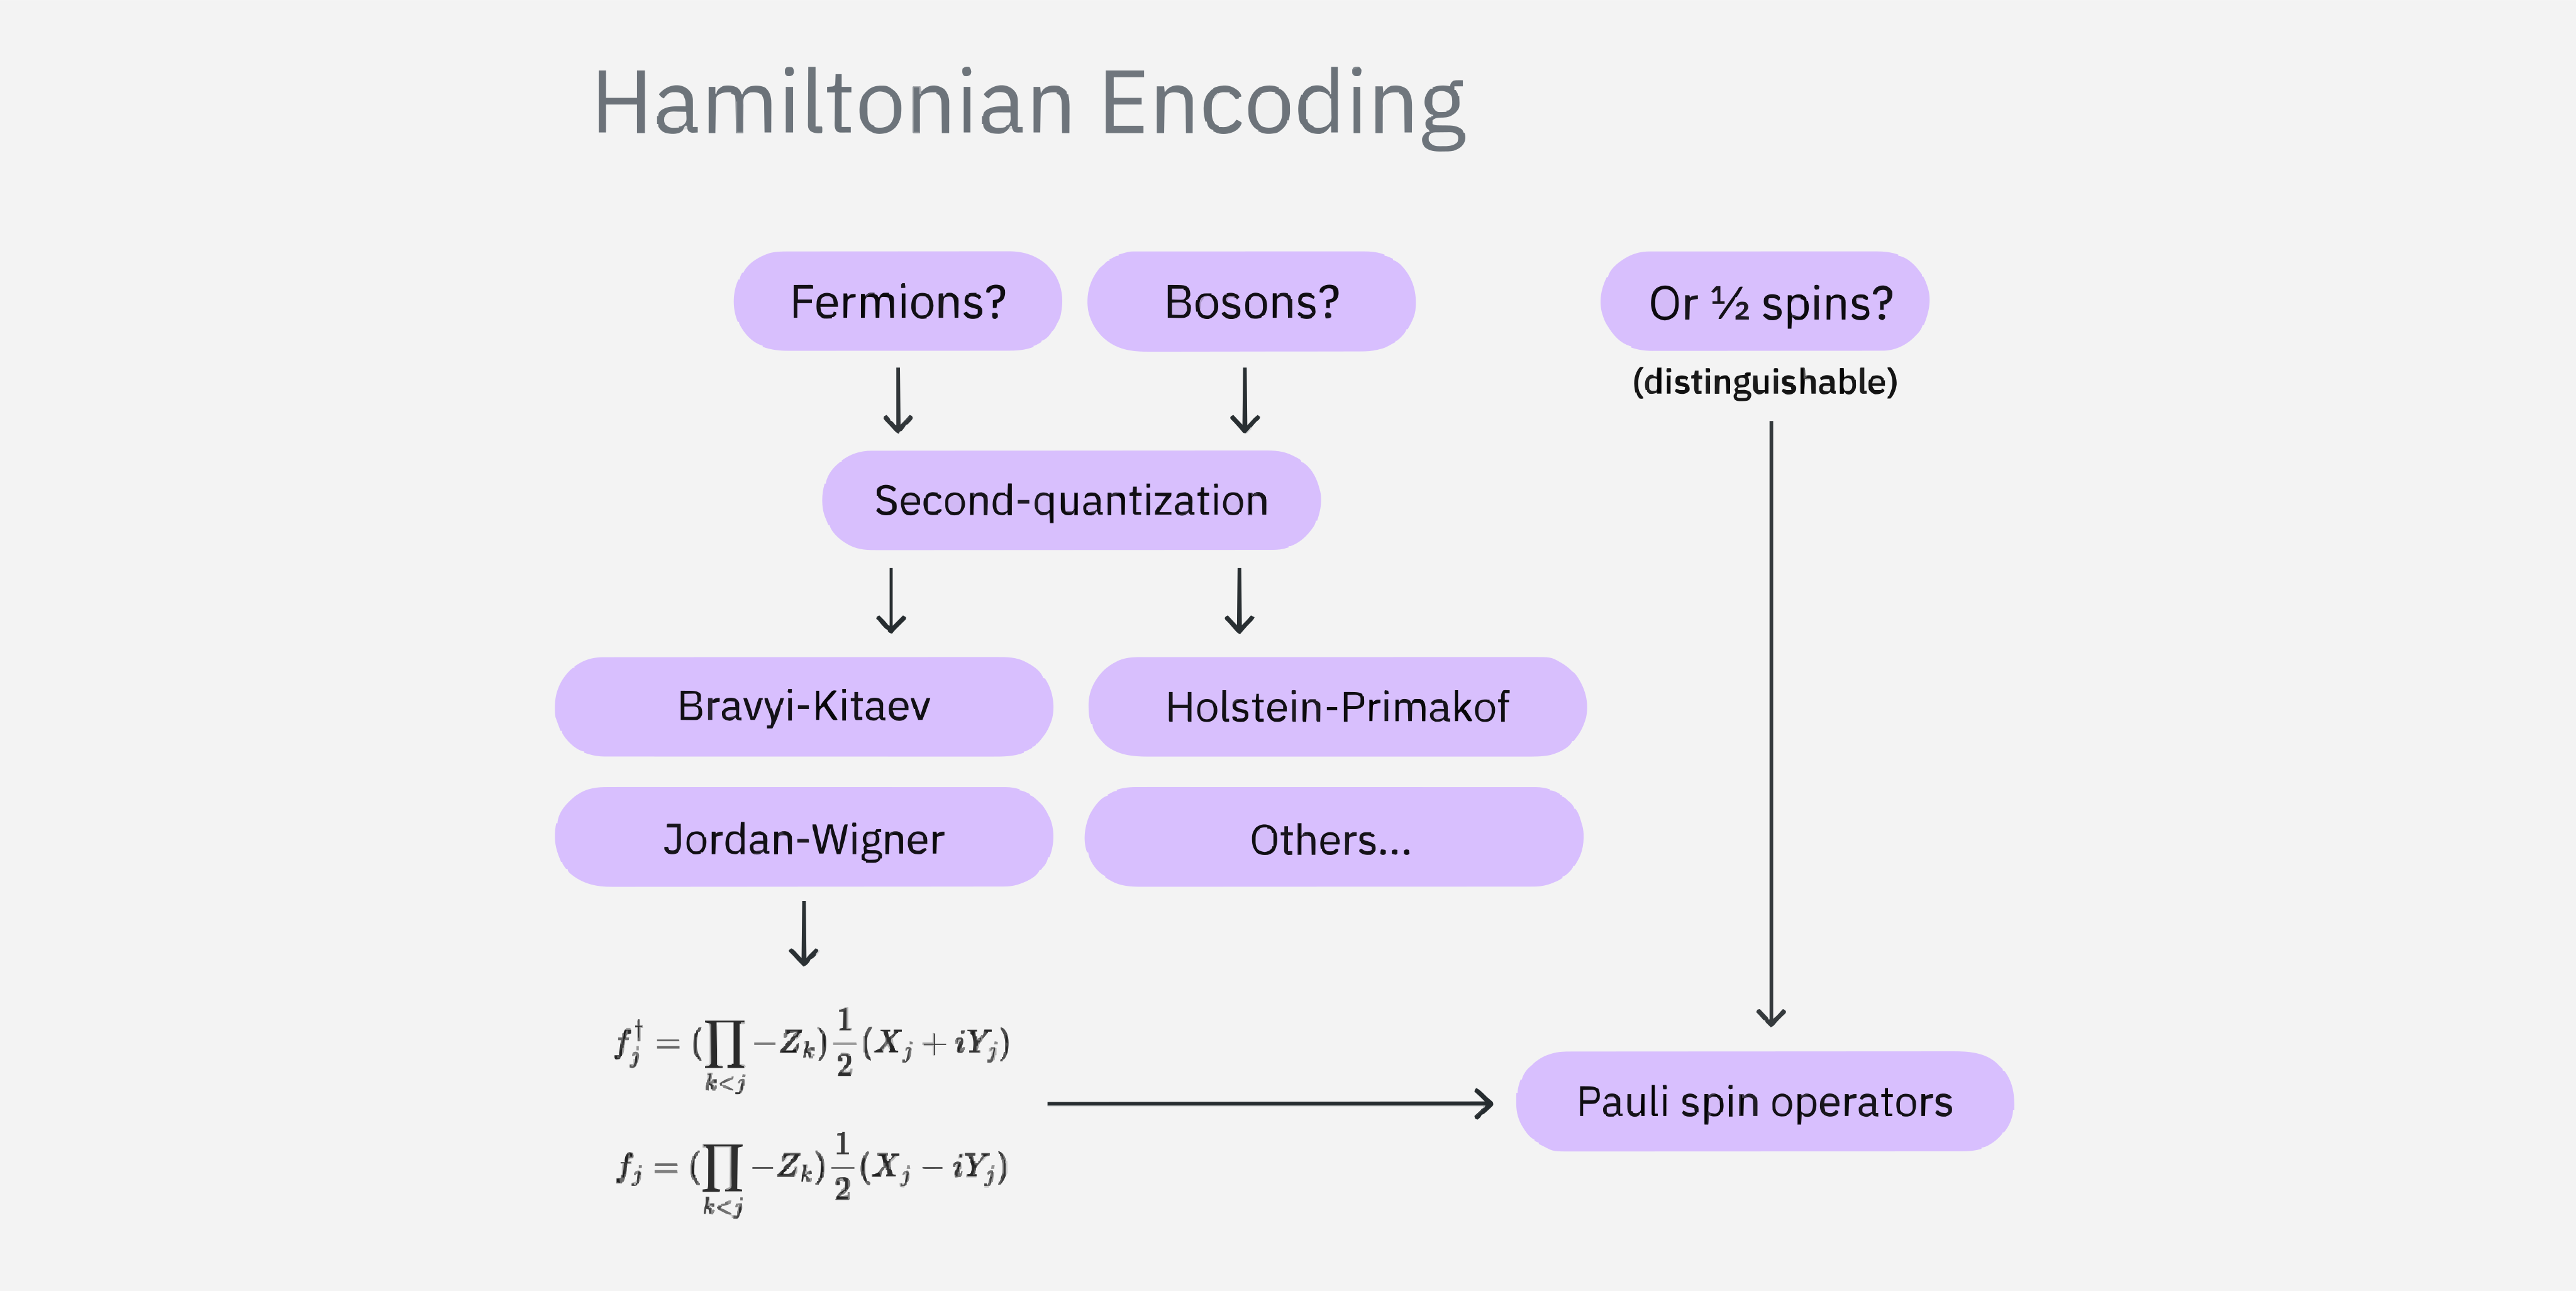
Wenn du ein System mit unterscheidbaren Teilchen hast, wie etwa -Spins, die auf einem Gitter fixiert sind und die wir oben kurz betrachtet haben, ist der Hamiltonoperator oft bereits in einer mit Qubits kompatiblen Sprache geschrieben. Der Pauli-Z-Operator beschreibt beispielsweise auf natürliche Weise, ob ein Spin nach oben oder unten zeigt, und es ist keine spezielle Kodierung erforderlich.
Bei der Simulation ununterscheidbarer Teilchen wie Fermionen oder Bosonen ist es notwendig, eine Kodierungstransformation anzuwenden. Diese Teilchen werden in einem speziellen mathematischen Rahmen beschrieben, der second quantization genannt wird und die Besetzungszahl jedes Quantenzustands verfolgt, indem creation- und annihilation-Operatoren eingeführt werden, wobei der Erzeugungsoperator ein Teilchen zum Zustand hinzufügt, während der Vernichtungsoperator ein Teilchen aus dem Zustand entfernt. Basierend auf diesem Rahmen der zweiten Quantisierung kann das Fermion durch Bravyi-Kitaev und Jordan-Wigner transformiert werden. Die Jordan-Wigner-Transformation definiert den fermionischen Erzeugungsoperator
, der den -ten Quantenzustand mit einem Fermion füllt, und den fermionischen Vernichtungsoperator , der ein Fermion aus dem -ten Zustand entfernt. Weitere Details zu dieser Jordan-Wigner-Transformation findest du in unserer Folge Quantum Computing in Practice, Episode 5 - Mapping. Ebenso benötigen Bosonen eigene Kodierungsmethoden, wie etwa die Holstein-Primakoff-Transformation, um durch Qubits dargestellt zu werden.
Letztlich ist es, egal ob der Weg direkt ist oder eine Übersetzung erfordert, das Ziel dasselbe: den Hamiltonoperator des Systems in Form von Pauli-Spin-Operatoren auszudrücken, die ein Quantencomputer verstehen und ausführen kann.
3. Zustandspräparation
Nach der Kodierung des gewünschten Hamiltonoperators in den Gate-Satz des Quantencomputers besteht der nächste wichtige Schritt darin, einen geeigneten Anfangszustand für den Beginn der Simulation auszuwählen. Die Wahl des Anfangszustands beeinflusst nicht nur die Konvergenz von Variationsalgorithmen wie dem Variational Quantum Eigensolver (VQE), sondern wirkt sich auch auf die Genauigkeit und Effizienz der Zeitentwicklung und des Samplings aus. Im Wesentlichen dient der Anfangszustand als Ausgangspunkt für die Berechnung und legt den Grundstein für die Extraktion nützlicher Observablen aus dem modellierten Quantensystem. Idealerweise sollte dieser Zustand eine physikalisch sinnvolle Konfiguration des untersuchten Systems darstellen.
Für viele quantenchemische Simulationen kann der Hartree-Fock-Zustand ein guter Ausgangspunkt sein. In der Sprache der zweiten Quantisierung wird der Hartree-Fock-Zustand () erzeugt, indem Erzeugungsoperatoren () für jedes der Orbitale mit der niedrigsten Energie auf den Vakuumzustand () angewendet werden, einen Zustand ohne Elektronen.
Außerdem kann ein leicht vorzubereitender Ansatz mit signifikanter Überlappung zum wahren Grundzustand als guter Anfangszustand für chemische Probleme dienen, etwa zur Bestimmung der Grundzustandsenergie.
Allgemeiner können wir einen beliebigen -Qubit-Zustand als Überlagerung von Rechenbasiszuständen mit Koeffizienten schreiben, die Normierungsbedingungen erfüllen. Die Vorbereitung eines solchen Zustands kann im Allgemeinen dadurch erfolgen, dass ein bestimmter Operator auf den Anfangszustand angewendet wird, der per Konvention typischerweise der Standardbasiszustand mit lauter Nullen ist.
Dieser Prozess erfordert jedoch oft eine exponentielle Anzahl von CNOT-Gates, was ihn im Allgemeinen ressourcenintensiv macht. Wir konzentrieren uns daher oft auf die Präparation von Anfangszuständen, deren Implementierungsaufwand bescheidener ist. Aus diesem Grund konzentrieren wir uns häufig auf die Präparation weniger komplexer Anfangszustände. Eine gängige und praktische Wahl ist ein Produktzustand, bei dem die Qubits nicht verschränkt sind und der sich allein mit Einzelqubit-Operationen präparieren lässt, was den Ressourcenbedarf der Zustandspräparation und die Komplexität deutlich reduziert. 4. Zeitentwicklung des Zustands
Nachdem der Anfangszustand nun festgelegt ist, können wir endlich mit der eigentlichen Simulation beginnen - wir untersuchen, wie sich der Zustand des Systems nach einer gewissen Zeit in verändert. In der Quantenmechanik wird diese Entwicklung durch eine einzige mathematische Operation beschrieben, die als Zeitentwicklungsoperator bezeichnet wird:
wobei wir per Konvention gesetzt haben. Wendet man diesen Operator auf unseren Anfangszustand an, erhalten wir den Endzustand:
Der Bau einer Quantenschaltung, die den vollständigen Operator direkt implementiert, ist jedoch in der Regel unmöglich, wenn unser Hamiltonoperator eine Summe verschiedener Teile ist. Deshalb benötigen wir die Trotterisierung.
Vereinfacht gesagt ist die Trotterisierung eine Technik zur Approximation der Exponentiation einer Matrix (hier des Hamiltonoperators ), insbesondere wenn der Exponent nicht kommutierende Operatoren enthält (). Oft besteht der Hamiltonoperator aus mehreren Operatoren, die nicht kommutieren. In diesem Fall kannst du ihre Exponentiale nicht trennen:
Ein sinnvoller Ansatz besteht darin, ihre Zeitentwicklungs-Exponentiale abwechselnd über kleine Zeitintervalle, , insgesamt Mal anzuwenden. Für diese beiden nicht kommutierenden Beiträge würden wir schreiben
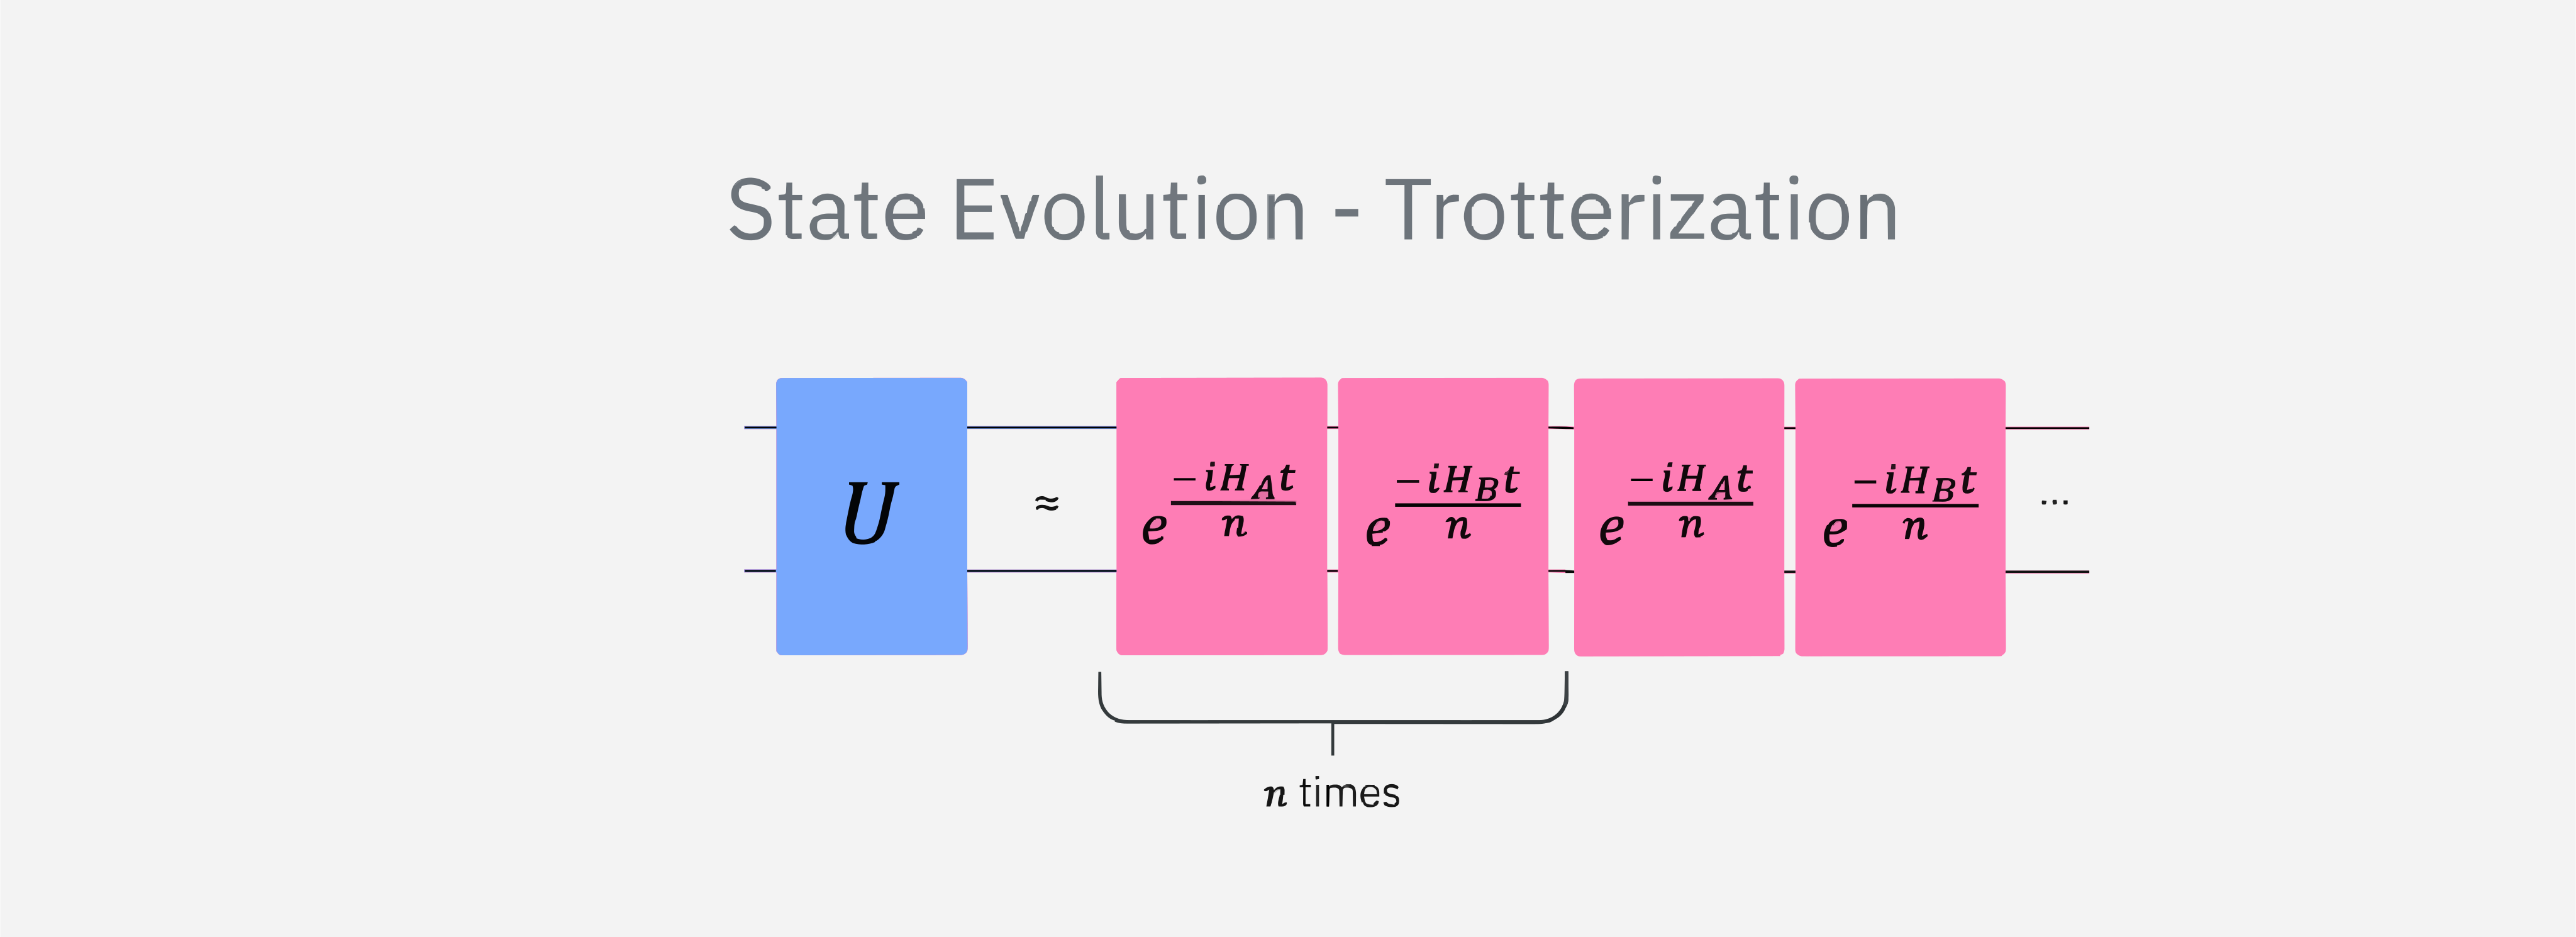
Der durch diese Approximation eingeführte Fehler wird als Trotter-Fehler bezeichnet. Wir können diesen Fehler verringern, indem wir erhöhen, was jedoch mit Kosten verbunden ist. Es gibt auch fortgeschrittenere Formeln höherer Ordnung (die Formel zweiter Ordnung und andere Varianten). Die Formel zweiter Ordnung bietet beispielsweise eine bessere Genauigkeit, indem die Schritte in einem symmetrischen Muster angewendet werden.
Hierbei ist die Anzahl der nicht kommutierenden Terme, , im Hamiltonoperator, der auf diese Weise aufgeteilt wird, und ist die Anzahl der kleinen Zeitschritte, in die diese Entwicklung unterteilt wird. Beachte die umgekehrte Reihenfolge der Operatoren im zweiten Produkt bei der Behandlung zweiter Ordnung.
Weitere Details findest du im Abschnitt zur Trotterisierung im Kurs Quantum Diagonalization Algorithms. 5. Schaltungsoptimierung
Nach der Erstellung des trotterisierten Circuits ist der Mapping-Schritt abgeschlossen, und wir können mit der Circuit-Optimierung fortfahren. Dieser Prozess umfasst mehrere Schlüsselaufgaben:
-
Qubit-Layout festlegen, das die abstrakten Qubits des Circuits auf die physischen Qubits der Hardware abbildet. Dieser Schritt ist notwendig, weil die Architektur der Hardware oft spezifische Konnektivitätsbeschränkungen hat, während Quantencircuit-Designs typischerweise davon ausgehen, dass jedes Qubit mit jedem anderen interagieren kann.
-
SWAP-Gates einfügen, falls erforderlich, um Wechselwirkungen zwischen Qubits zu ermöglichen, die auf dem Gerät nicht direkt verbunden sind.
-
Die Gates des Circuits in ISA-Anweisungen (Instruction Set Architecture) übersetzen, die die Hardware direkt ausführen kann.
-
Circuit-Optimierungen durchführen, um die Circuit-Tiefe und die Gate-Anzahl zu reduzieren. Diese Optimierung kann auch früher auf den virtuellen Circuit angewendet werden, bevor die Qubits bestimmten Hardware-Verbindungen zugewiesen werden.
Es ist wichtig zu beachten, dass ein Großteil dieses Optimierungsprozesses automatisch durch Qiskit-Tools abgewickelt wird. Wir werden später in dieser Lektion genau erkunden, wie das funktioniert.
6. Circuit-Ausführung
Nach dem Abschluss des Optimierungsschritts sind wir bereit, den Circuit mithilfe eines Primitives auszuführen. Wir betrachten ein Simulationsexperiment, bei dem das Ziel darin besteht zu verstehen, wie sich bestimmte Eigenschaften des Systems im Laufe der Zeit ändern. Für diesen Zweck ist das Estimator-Primitive die geeignetste Wahl, da es dir ermöglicht, die Erwartungswerte von Observablen zu messen, die diesen Eigenschaften entsprechen.
Als nächstes verwenden wir Optionen einschließlich Error-Suppression- und Error-Mitigation-Techniken, um die Genauigkeit des Estimators zu verbessern. Schließlich führen wir das Experiment durch, um die Ergebnisse zu sammeln.
7. Nachverarbeitung
Der letzte Schritt ist die Nachverarbeitung der gesammelten Daten. Dies beinhaltet die Extraktion der gemessenen Erwartungswerte oder, wenn das Sampler-Primitive verwendet wurde, der abgetasteten Wahrscheinlichkeitsverteilung in der Rechenbasis. Wenn nur die Erwartungswerte der relevanten Observablen benötigt werden, können diese direkt vom Estimator-Primitive abgerufen werden, sowohl als Rohergebnisse als auch mit angewendeter Fehlerminderung. Oft dienen diese gemessenen Erwartungswerte als Ausgangspunkt für weitere Berechnungen anderer interessierender Größen. Solche zusätzlichen Berechnungen erfordern typischerweise keine Quantenberechnung und können effizient auf einem klassischen Computer durchgeführt werden.
Das „Utility"-Paper replizieren
Dieser Teil ist ein allgemeiner Walkthrough des Tutorials Fehlerminderung im Utility-Maßstab mit Probabilistic Error Amplification, das die Ergebnisse des Papers Evidence for the Utility of Quantum Computing Before Fault Tolerance repliziert. Wir empfehlen dir dringend, das referenzierte Tutorial zusammen mit dieser Sitzung zu öffnen.
Wir werden nun ein konkretes Beispiel aus einem hocheinflussreichen Paper untersuchen, das IBM 2023 veröffentlichte und das den Titel Evidence for the Utility of Quantum Computing Before Fault Tolerance trägt, oft als „Utility-Paper" bezeichnet.
Nach seiner Veröffentlichung wurde diese Arbeit schnell zu einer Meilenstein-Studie in der Quantencomputing-Community. Ihre zentrale These ist, dass ein verrauschter Quantencomputer mit 127 Qubits und 2.880 Gates genaue Erwartungswerte für Quantencircuits liefern kann, die jenseits der Reichweite von Brute-Force-klassischen Simulationsmethoden liegen, die versuchen, dieselben Circuits exakt zu simulieren.
Diese Studie war besonders bedeutsam, weil sie demonstrierte, dass Quantencomputer zur Überprüfung oder zum Vergleich von Ergebnissen mit approximativen klassischen Simulationsmethoden wie Tensornetzwerkalgorithmen verwendet werden können – besonders in Szenarien, in denen die exakte Lösung im Voraus nicht bekannt ist.
Ein weiterer bemerkenswerter Aspekt dieser Arbeit ist, dass sie weit verbreitet reproduziert wurde: Forscher und Nutzer haben jetzt die Möglichkeit, das Experiment mithilfe von IBMs cloudbasierten Quantensystemen und dem Qiskit-Software-Framework zu replizieren und zu verifizieren. Im Folgenden werden wir dich durch die Schritte führen, diese Replikation selbst durchzuführen, indem wir IBMs Tutorial Schritt für Schritt durchgehen.
In dieser Lektion besprechen wir die spezifischen Schritte, die erforderlich sind, um das Problem in Eingaben zu übersetzen, die ein Quantengerät verarbeiten kann. Wir konzentrieren uns auf die Simulation der Dynamik der Gesamtmagnetisierung in einem System magnetischer Dipolspins, die auf einem Gitter angeordnet und einem äußeren Magnetfeld ausgesetzt sind. Dieses System kann durch ein Ising-Modell mit einem transversalen Magnetfeld beschrieben werden. Wir stellen es mit einem parametrisierten Quantencircuit dar, wobei die Parameter den einstellbaren Werten der Spin-Spin-()-Wechselwirkungen und der Stärke des äußeren, transversalen Magnetfeldes (, parametrisiert mit ) entsprechen.
Da diese Serie den Titel „Quantum Computing in Practice" trägt, werden wir zusätzliche Details der experimentellen Techniken behandeln, die zur Verbesserung der Ergebnisqualität verwendet werden. Ein wichtiges Verfahren ist die Identifizierung und Entfernung von „schlechten" Qubits – solche mit geringen Gate-Fidelitäten oder kurzen Dekohärenzzeiten –, die das Ergebnis des Experiments erheblich beeinträchtigen könnten. Solche problematischen Qubits können durch schlechte Kalibrierung oder Wechselwirkungen mit Zwei-Niveau-Systemen (TLS) entstehen. Das Entfernen dieser Qubits verändert die native Topologie der Hardware und damit effektiv das Gitter, auf dem das System simuliert wird.
Darüber hinaus werden wir besprechen, wie man den parametrisierten Quantencircuit konstruiert, der die Zeitentwicklung des Systems mithilfe von Trotterisierung implementiert. Ein wesentlicher Teil dieses Prozesses ist die Identifizierung von Verschränkungsschichten innerhalb des Circuits, die eine entscheidende Rolle bei der wichtigsten Fehlerminderungstechnik spielen.
Qiskit Patterns Schritt 1: Abbilden (Map)
Das Tutorial führt den Mapping-Schritt ähnlich wie der oben beschriebene allgemeine Ansatz durch. Spezifisch für dieses Problem führt das Tutorial folgendes durch:
-
Erstellt einen parametrisierten Ising-Modell-Circuit
-
Erstellt Verschränkungsschichten und entfernt schlechte Qubits
-
Generiert eine trotterisierte Version des Circuits
Im Tutorial beginnen wir früh im Notebook damit, eine Reihe von Hilfsfunktionen zu erstellen. Diese Funktionen sind darauf ausgelegt, den Prozess zu vereinfachen, während wir fortfahren. Diese sind kein erforderlicher Teil des Verfahrens, aber es ist eine gute gängige Praxis bei ähnlichen Experimenten: das Problem in handhabbare Komponenten aufteilen. Die Funktionen umfassen:
-
Qubit-Kopplungen entfernen
-
Qubit-Kopplungen definieren
-
Schichtkopplungen konstruieren
-
Die Verschränkungsschicht konstruieren
-
Den trotterisierten Circuit definieren
Hier wollen wir Themen im Zusammenhang mit diesen Funktionen etwas genauer erkunden. Schichtkopplungen
Schichtkopplungen legen fest, wie Qubits während der Simulation mit ihren Nachbarn interagieren. Unsere Quantengeräte nutzen ein heavy-hexagonales Layout, ein charakteristisches Muster zur Verbindung von Qubits. Innerhalb dieses Layouts lassen sich die Verbindungen zwischen Qubits – bekannt als „Kanten“ – in drei unterschiedliche Gruppen einteilen. Wichtig ist dabei, dass sich innerhalb derselben Gruppe keine zwei Verbindungen ein Qubit teilen. Diese Organisation berücksichtigt eine zentrale Hardware-Einschränkung: Auf einem echten Quantencomputer kann ein Qubit zu jedem Zeitpunkt nur an einem Zwei-Qubit-Gate beteiligt sein.
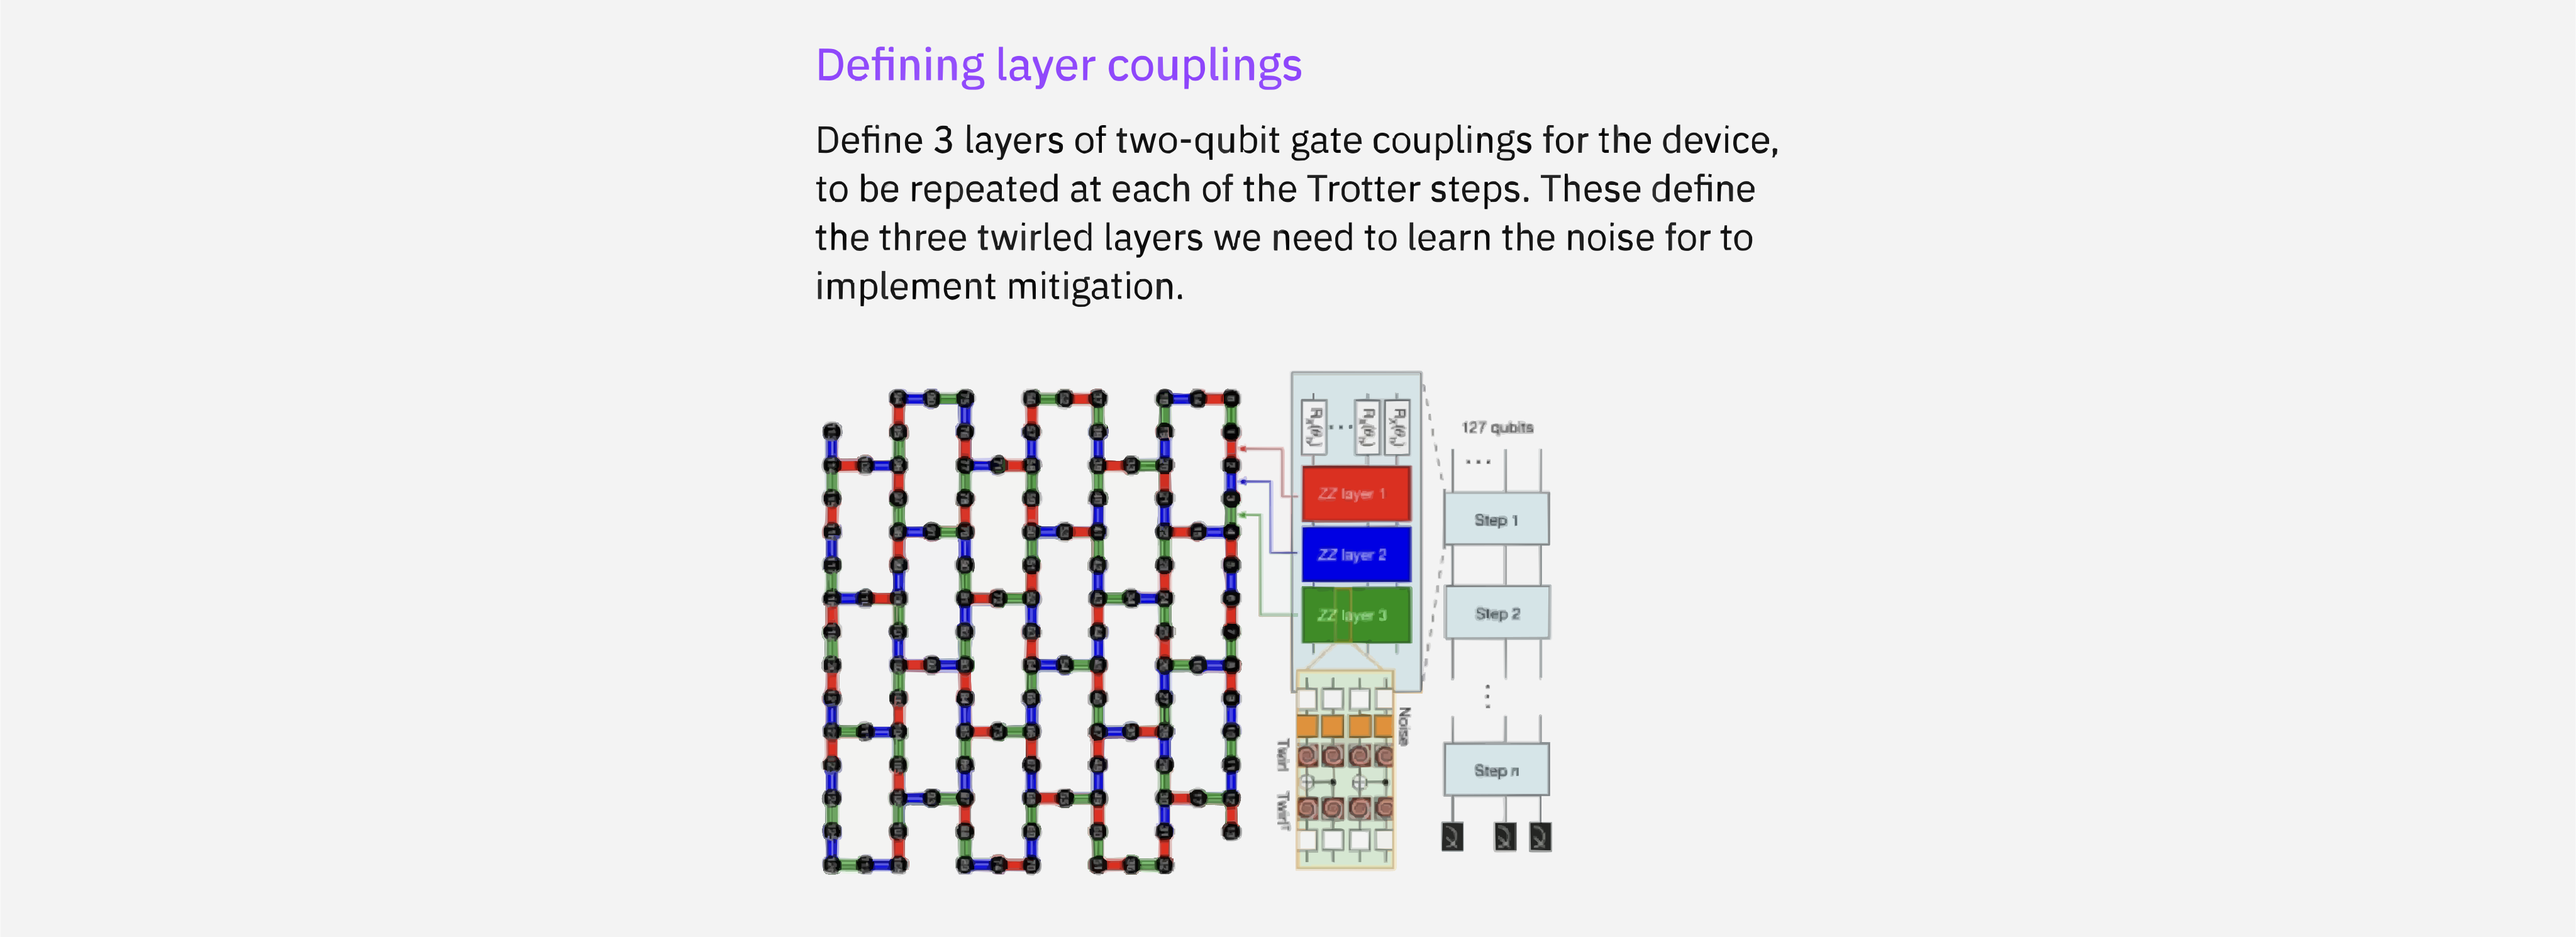
Indem alle Verbindungen in drei separate Schichten strukturiert werden, können Zwei-Qubit-Gates in drei aufeinanderfolgenden Runden auf dem gesamten Gerät angewendet werden. Das stellt sicher, dass kein Qubit an mehr als einem Gate pro Schicht beteiligt ist. Diese Gates implementieren die ZZ-Wechselwirkung im Ising-Modell und werden bei jedem Zeitschritt der Simulation (jedem Trotter-Schritt) wiederholt.
Zusätzlich wird eine Technik namens Twirling eingesetzt, um die Rauscheigenschaften des Geräts zu verändern. Twirling transformiert das Rauschen so, dass selbst einfache Rauschmodelle die physikalischen Fehler genauer wiedergeben. Diese Verfeinerung ermöglicht eine präzisere Charakterisierung des Rauschens, die anschließend genutzt werden kann, um Fehlerminderungsstrategien zu verbessern. Entfernen „schlechter“ Qubits
Der nächste Schritt besteht darin, die „schlechten“ Qubits aus der Liste der für das Experiment verfügbaren physischen Qubits zu entfernen. Ein Qubit kann aus verschiedenen Gründen „schlecht“ werden. Manchmal handelt es sich einfach um eine mangelhafte Kalibrierung, die durch eine erneute Kalibrierung behoben werden kann. In anderen Fällen ist das Problem komplexer und hängt mit einem sogenannten Zwei-Niveau-System-Defekt (TLS) zusammen. Diese TLS-Defekte verursachen Schwankungen der Qubit-Parameter und Relaxation. Die Behebung erfordert oft, das gesamte System aufzuwärmen und anschließend wieder abzukühlen – ein Prozess, der einige Zeit in Anspruch nehmen kann und beim Fernzugriff auf Quantenhardware über die Cloud nicht praktikabel ist.
Der einfachste Ansatz besteht vorerst darin, diese problematischen Qubits aus dem Pool der physischen Qubits auszuschließen, die im Experiment verwendet werden. Mit der IBM Quantum Platform® lässt sich leicht erkennen, welche Qubits auf einer QPU unterdurchschnittlich abschneiden. Du kannst entweder die QPU öffnen und dir ihre Eigenschaften direkt auf der Plattform anzeigen lassen oder die Daten als CSV-Datei von der Plattform herunterladen. Erstelle anschließend eine Liste der auszuschließenden Qubits und entferne sie aus der Gesamtmenge der physischen Qubits auf dem Gerät.
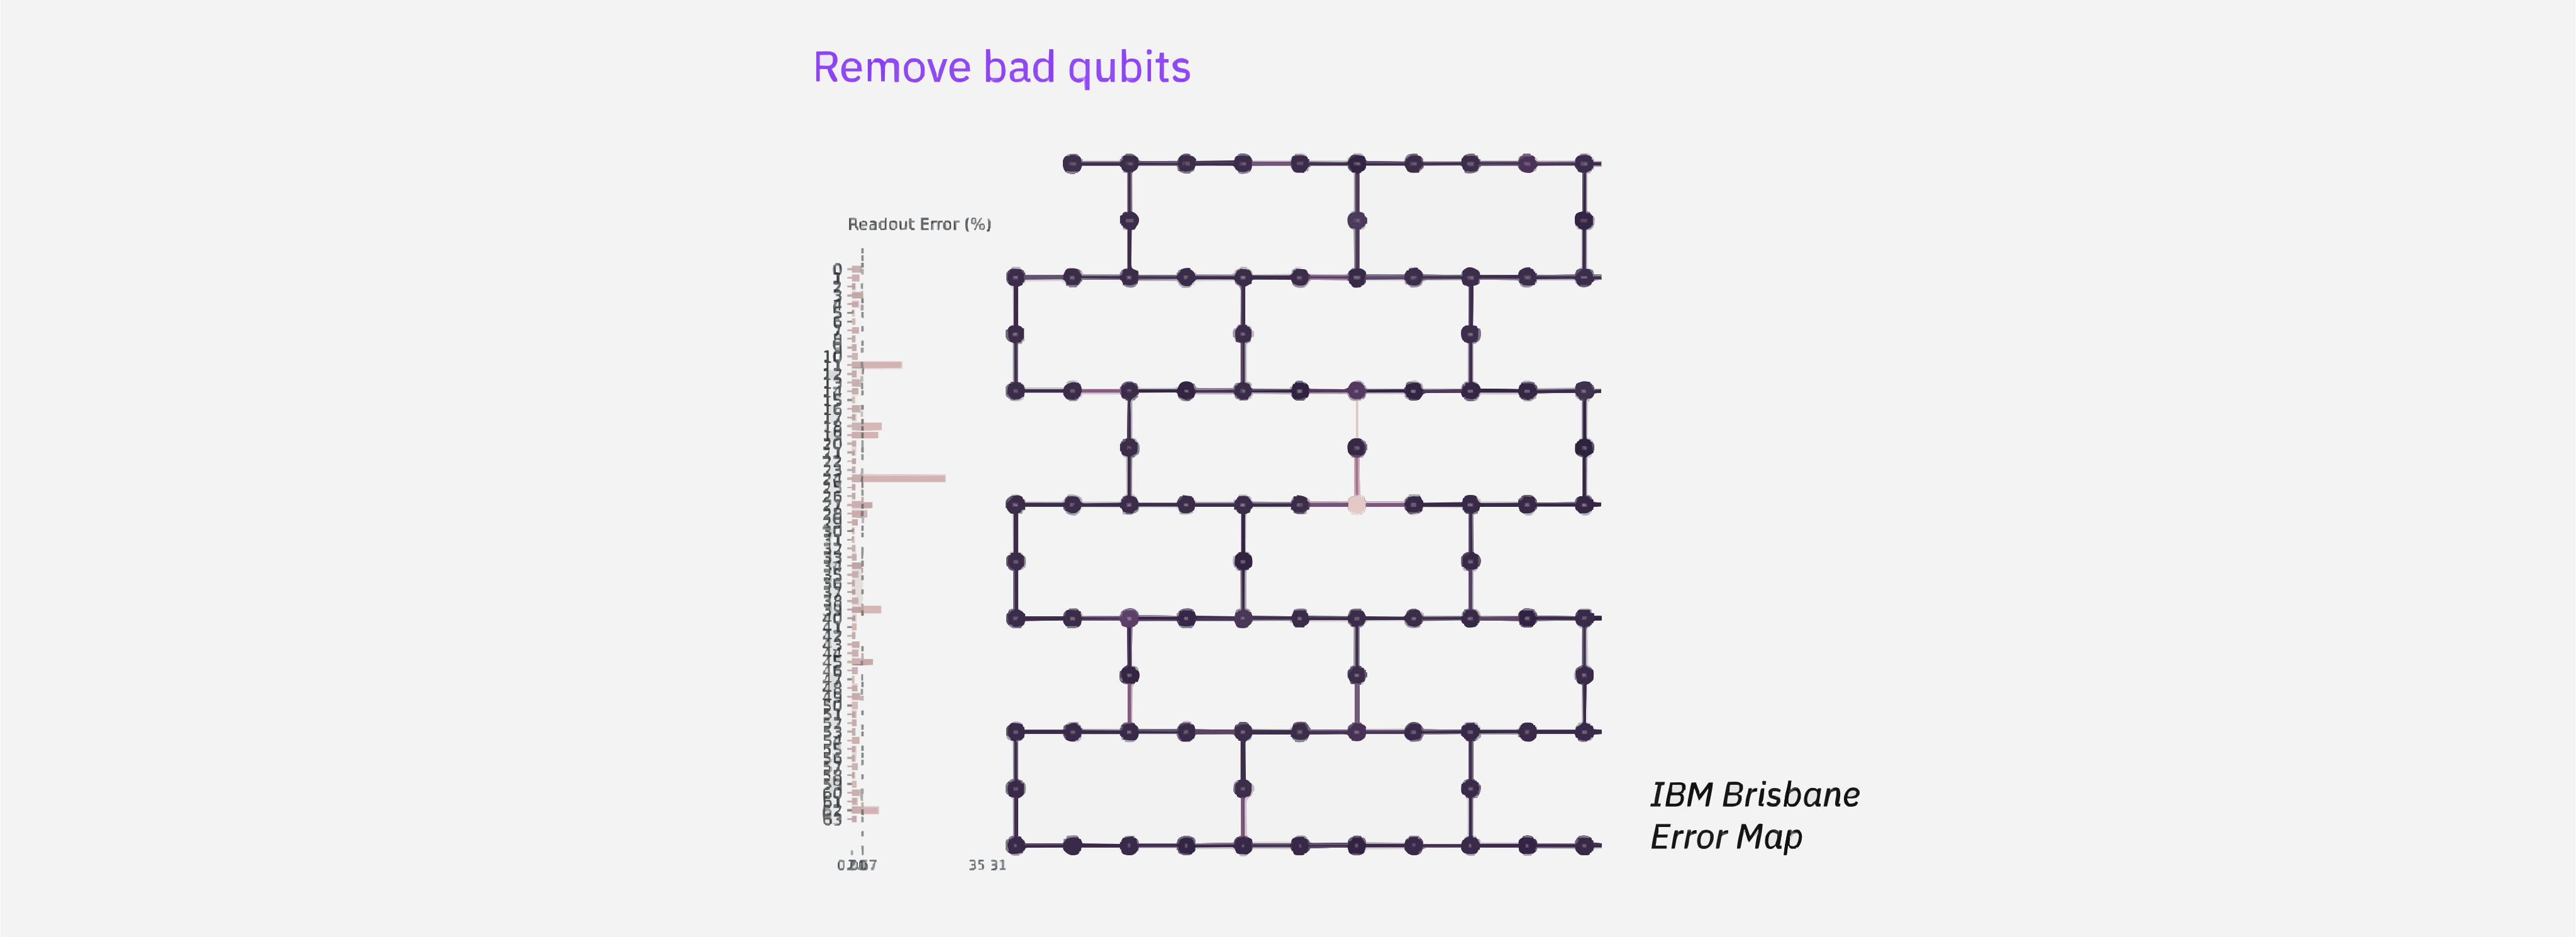
Das Entfernen unzuverlässiger Qubits sorgt dafür, dass sich das Verhalten des Systems besser vorhersagen lässt, was die Genauigkeit des Experiments verbessert. Außerdem ermöglicht es eine bessere Rauschmodellierung, die für die Umsetzung effektiver Fehlerminderungsstrategien unerlässlich ist. Trotterisierte Schaltung
Nun ist es an der Zeit, unsere trotterisierte Schaltung zu erstellen. Wie bereits besprochen, zerlegt die Trotterisierung die Zeitentwicklung in diskrete Schritte, sodass wir festlegen müssen, wie viele Schritte verwendet werden sollen. Für dieses Beispiel wählen wir sechs Schritte. Im Allgemeinen geht es bei diesem Ansatz darum, den Trotter-Fehler – einen durch den Algorithmus eingeführten Approximationsfehler – gegen die durch Dekohärenz verursachten Fehler abzuwägen. Eine Erhöhung der Anzahl der Trotter-Schritte verringert den Approximationsfehler, erfordert aber tiefere Quantenschaltungen, die anfälliger für Dekohärenzrauschen sind.
Der Circuit wird anhand mehrerer Parameter definiert: dem Theta-Parameter, der die Stärke des externen Magnetfelds darstellt, den Kopplungen zwischen den Schichten, der Anzahl der Schritte, der Anzahl der Qubits und natürlich der Wahl des Backends. Da die Magnetisierung des Systems von der Stärke des externen Magnetfelds abhängt, ist es sinnvoll, die Simulation bei verschiedenen Magnetfeldwerten durchzuführen. Diese Variation entspricht unterschiedlichen Rotationswinkeln für das RX-Gate im Circuit.
from qiskit.circuit import Parameter

num_steps = 6           #Trotter steps
theta = Parameter("theta")
circuit = trotter_circuit(
        theta, layer_couplings, num_steps, qubits = good_qubits, backend = backend
)
num_params = 12

# 12 parameter values for Rx between [0,p/2].
#Reshape to outer product broadcast with observables

parameter_values = np.linspace(0,np.pi/2,num_params).reshape((num_params,1))
num_params = parameter_values.size
Qiskit Patterns Schritt 2: Optimieren (Optimize)
Nachdem wir unseren Circuit generiert haben, besteht der nächste Schritt darin, ihn zu optimieren. Der erste Teil dieses Prozesses beinhaltet das Definieren eines Pass Managers. Im Kontext des Qiskit SDK ist die Transpilierung der Prozess der Transformation eines Eingabe-Circuits in eine Form, die für die Ausführung auf einem Quantengerät geeignet ist. Diese Transformation erfolgt durch eine Folge von Schritten, die als Transpilierungsdurchläufe bezeichnet werden.
Ein Pass Manager ist ein Objekt, das eine Liste dieser Transpilierungsdurchläufe enthält und sie auf einen Circuit anwenden kann. Um einen zu erstellen, initialisierst du einen PassManager mit der gewünschten Liste von Transpilierungsdurchläufen. Letztendlich erzeugt der Pass Manager einen ISA-Circuit – einen Circuit, der in Termen der Instruction Set Architecture (ISA) des Backends ausgedrückt ist. Das bedeutet, der Circuit wird mit Gates dargestellt, die nativ für die Backend-Hardware sind, enthält jedoch noch keine Timing-Informationen, die erforderlich sind, um den Circuit auf dem Gerät auszuführen.
Qiskit Patterns Schritt 3: Ausführen mit Primitives
Jetzt ist es Zeit, unseren Circuit auszuführen. Wir werden den Estimator als unser primäres Werkzeug für dieses Experiment verwenden, da unser Ziel darin besteht, die Gesamtmagnetisierung des Systems zu messen. Der Estimator ist speziell dafür ausgelegt, die Erwartungswerte von Observablen zu schätzen, was ihn zur idealen Wahl macht. In dieser Phase ist es auch wichtig, unsere Fehlerminderungseinstellungen zu konfigurieren. Wir werden Zero Noise Extrapolation (ZNE) anwenden, um die Genauigkeit unserer Ergebnisse zu verbessern. Im Tutorial wirst du sehen, dass wir zwei oder mehr Rauschfaktorwerte angeben, bei denen die extrapolierten Modelle ausgewertet werden sollen, und wir wählen „Probabilistic Error Amplification" (PEA) als unsere Amplifikationsmethode. PEA ist für dieses Experiment vorzuziehen, da es deutlich besser skaliert als andere Optionen, was bei Systemen mit 100 oder mehr Qubits entscheidend ist.
Das ist alles, was erforderlich ist, um das Experiment durchzuführen.
Einschub zur Fehlerminderung
Bevor wir mit der Nachverarbeitung fortfahren, nehmen wir uns kurz Zeit, zu klären, was mit Zero Noise Extrapolation (ZNE) gemeint ist. Wir haben dieses Konzept in früheren Episoden kurz angesprochen, aber es lohnt sich, es kurz zu wiederholen. ZNE ist eine Fehlerminderungstechnik, die darauf ausgelegt ist, die Auswirkungen unbekannten Rauschens zu reduzieren, das während der Ausführung von Quantencircuits auftritt, vorausgesetzt, dieses Rauschen kann auf kontrollierte Weise skaliert werden. Die Methode basiert auf der Annahme, dass Erwartungswerte mit dem Rauschen gemäß einer bekannten Funktion skalieren:
wobei die Rauschstärke darstellt, die absichtlich verstärkt werden kann.
Der Prozess der Implementierung von ZNE besteht aus folgenden Schritten:
- Das Circuit-Rauschen für verschiedene Rauschfaktoren , , … amplifizieren.
- Jeden rauschverstärkten Circuit ausführen, um die entsprechenden Erwartungswerte , , … zu messen.
- Diese Ergebnisse auf den rauschfreien Grenzfall (Null-Rausch-Limes) zurückextrapolieren.
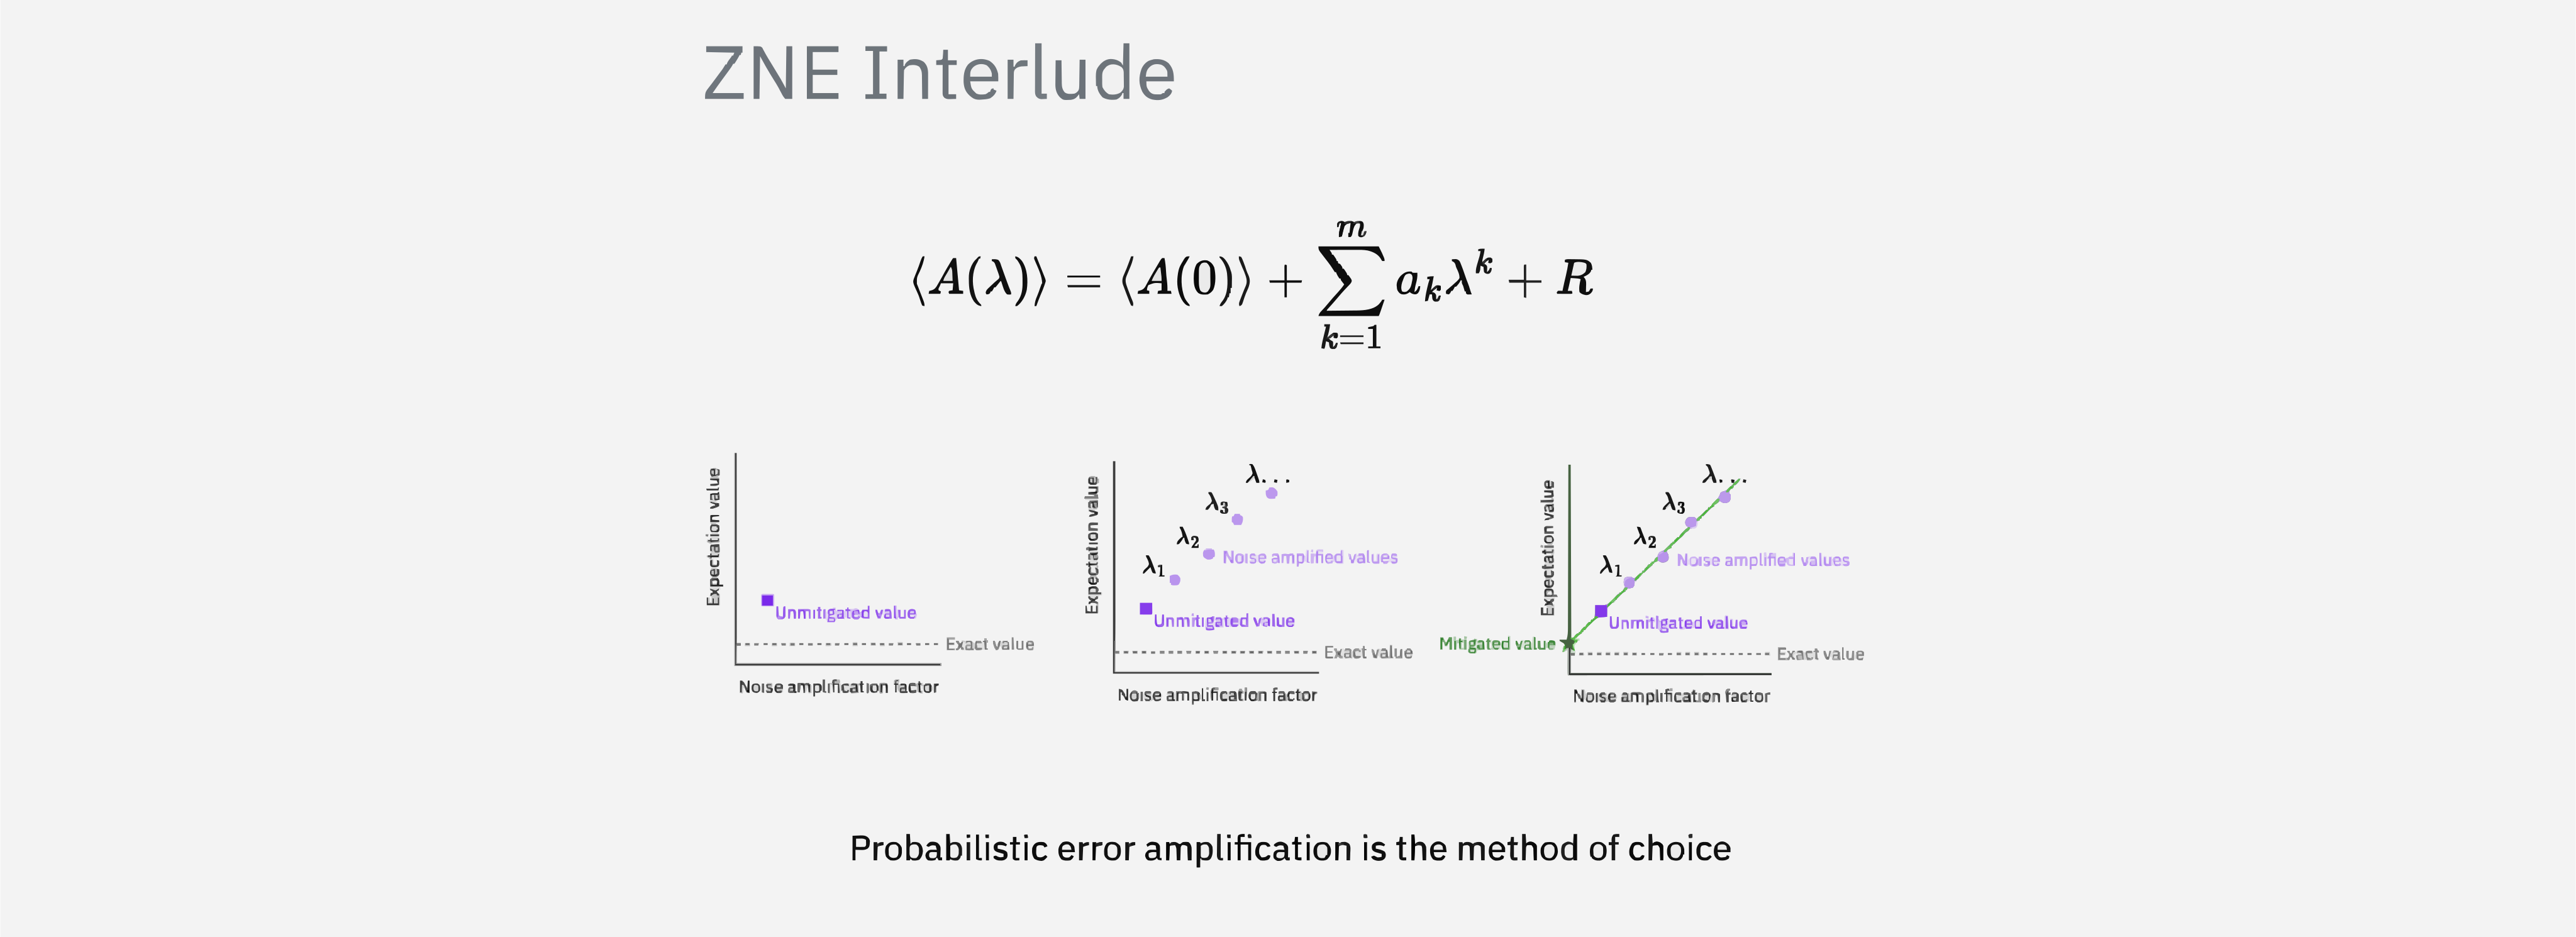
Diese Technik ermöglicht es uns, abzuschätzen, wie das Ergebnis ohne Rauschen aussehen würde, was die Genauigkeit von Quantenberechnungen verbessert.
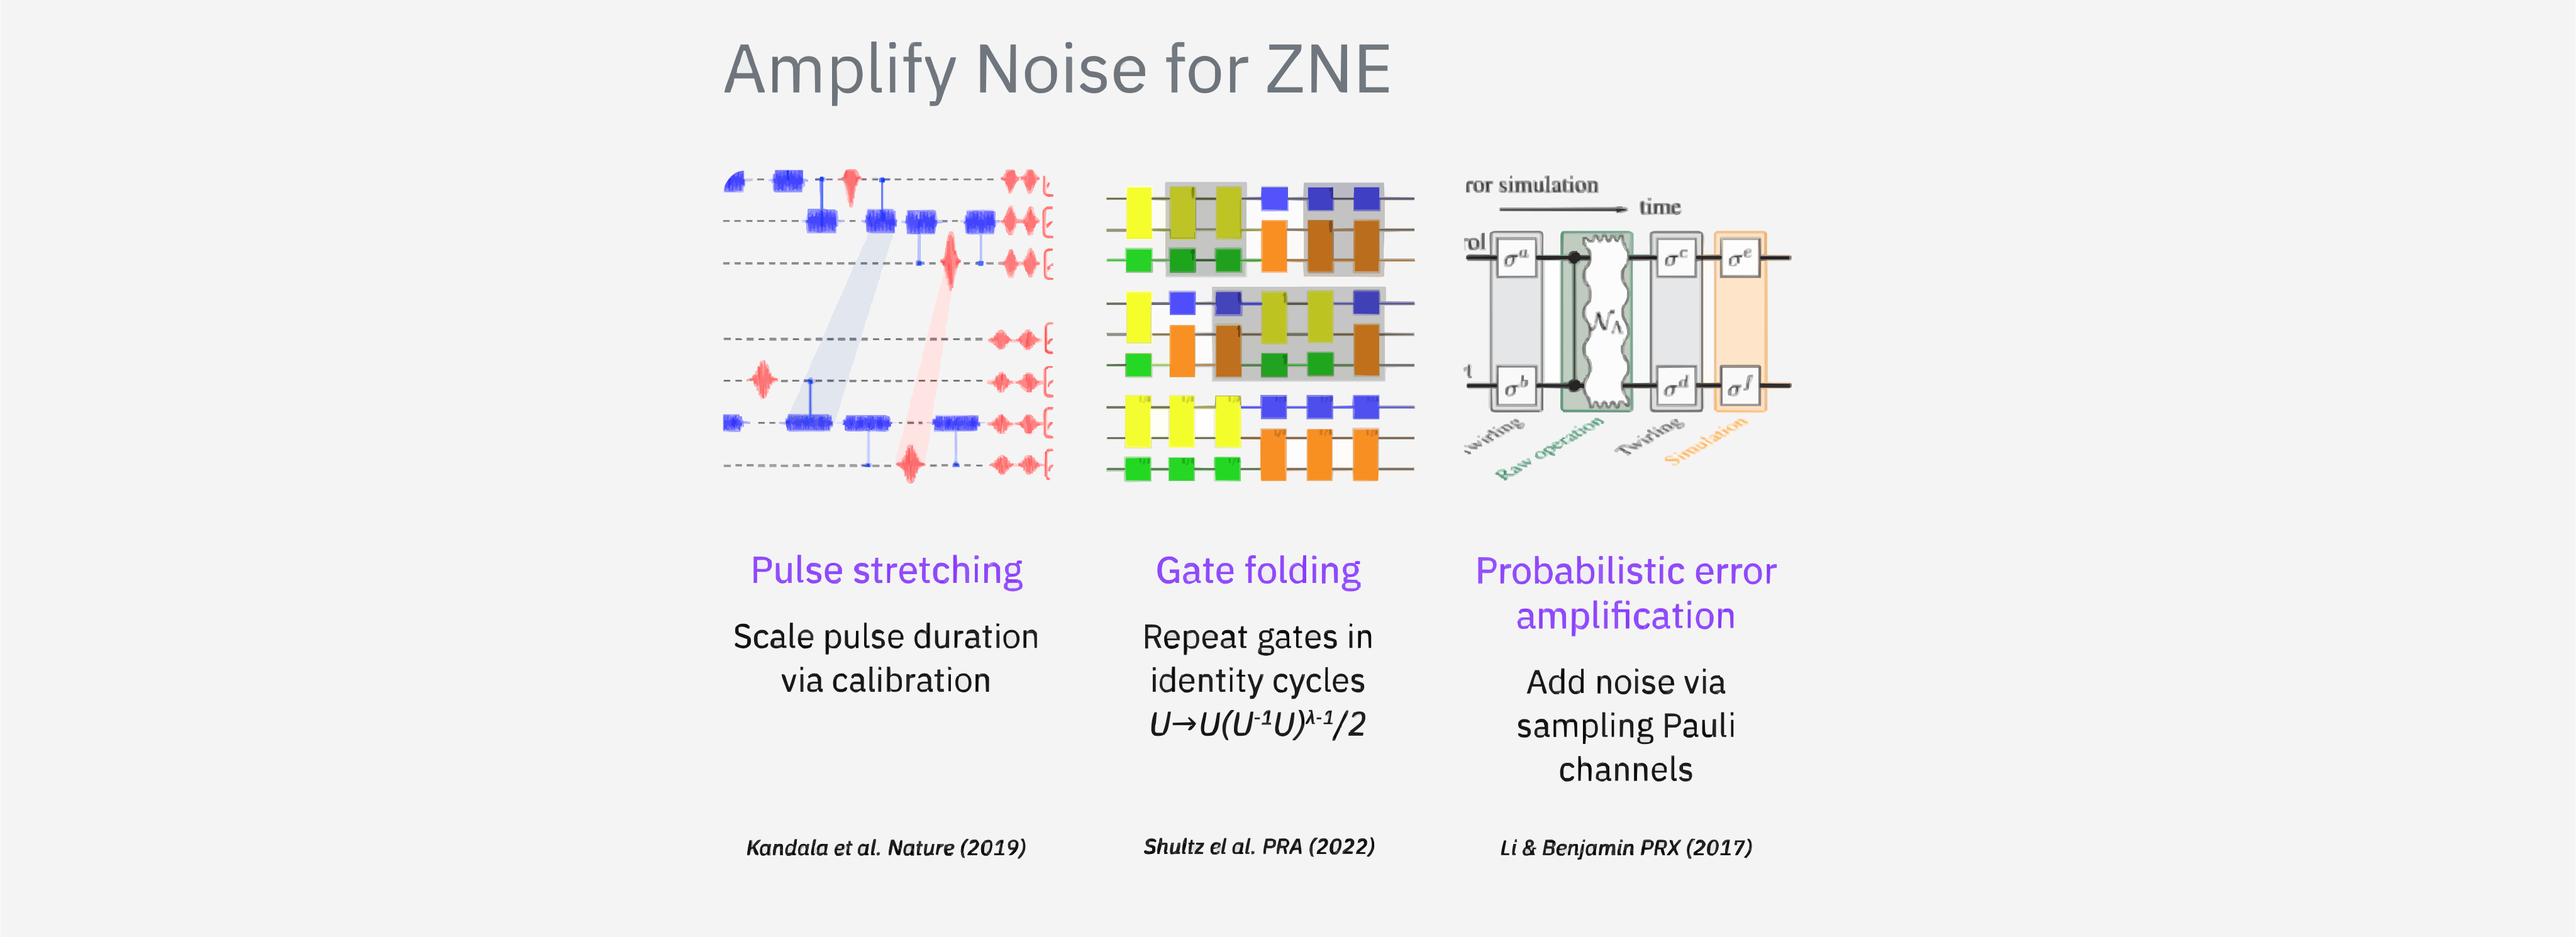
Die primäre Herausforderung bei der effektiven Implementierung von ZNE besteht darin, ein genaues Rauschmodell für den Erwartungswert zu entwickeln und das Rauschen auf kontrollierte und gut verstandene Weise zu amplifizieren. Gängige Techniken zur Fehleramplifikation in ZNE umfassen das Skalieren der Pulsdauer durch Kalibrierung, das Wiederholen von Gates mithilfe von Identitätszyklen und das Hinzufügen von Rauschen durch das Abtasten von Pauli-Kanälen – eine Methode, die als Probabilistic Error Amplification (PEA) bekannt ist.
Unter diesen ist PEA aus mehreren Gründen oft die bevorzugte Wahl:
-
Pulsdehnung verursacht hohe Rechenkosten.
-
Gate-Faltung, die Identitätseinfügungen verwendet, hat keine starken theoretischen Garantien für die Beibehaltung der Rauschverzerrung.
-
PEA ist auf jeden Circuit anwendbar, der mit einem nativen Rauschfaktor ausgeführt wird, obwohl es das vorherige Erlernen des Rauschmodells erfordert.
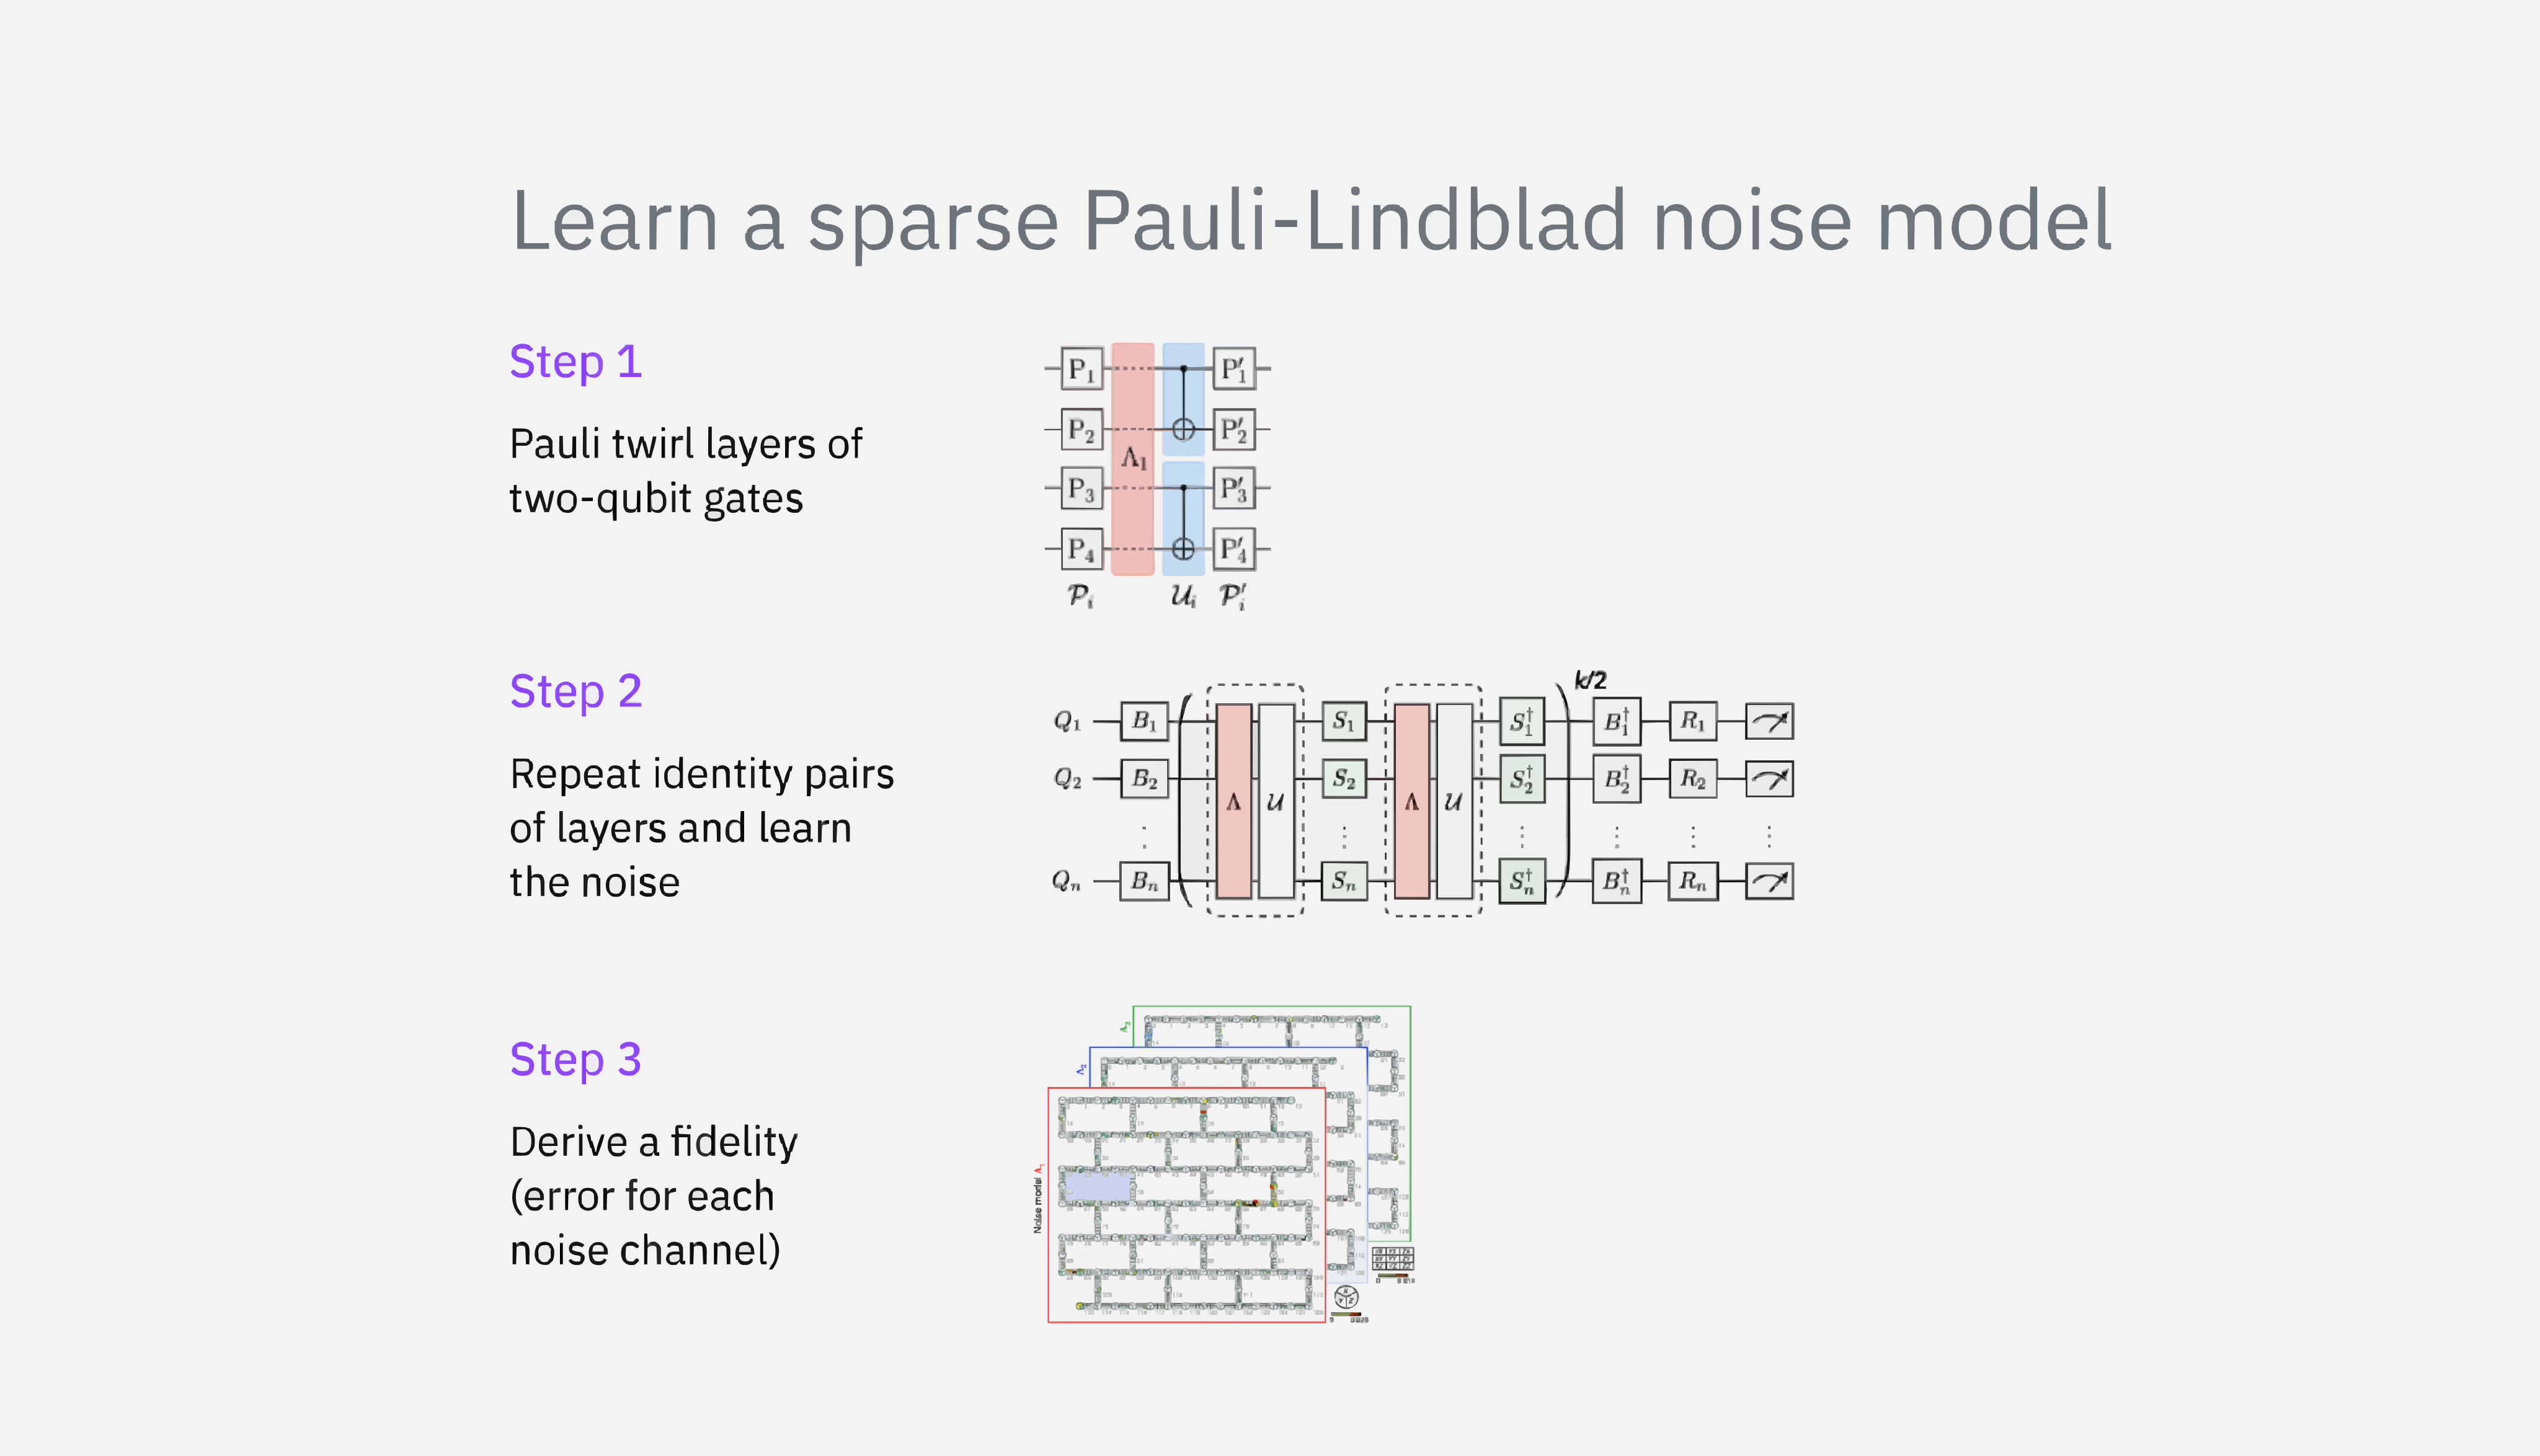
PEA arbeitet unter der Annahme eines schichtbasierten Rauschmodells, ähnlich dem bei der probabilistischen Fehlerbeseitigung (PEC) verwendeten. Im Gegensatz zu PEC vermeidet es jedoch den exponentiellen Stichprobenaufwand, der typischerweise mit dem Circuit-Rauschen wächst. Diese Effizienz macht PEA zu einem praktischen und robusten Ansatz für die Rauschverstärkung in ZNE, was eine zuverlässigere Quantenfehlerminderung ermöglicht. Um das Rauschmodell zu charakterisieren, müssen wir zunächst die unterschiedlichen Schichten von Zwei-Qubit-Operationen innerhalb des Circuits identifizieren. Für jede dieser Schichten wenden wir ein Pauli-Twirling-Verfahren auf die Zwei-Qubit-Gates an, das dazu beiträgt, dass das Rauschen durch ein Dämpfungsrauschmodell genau beschrieben werden kann. Als nächstes wiederholen wir Paare von Identitätsschichten in verschiedenen Tiefen, und schließlich passen wir die Fidelitätswerte an, um die Fehlerraten für jeden Rauschkanal zu bestimmen.
Obwohl es vorteilhaft ist, diese Methode konzeptionell zu verstehen, ist die manuelle Implementierung in Qiskit viel einfacher, wie im begleitenden Tutorial gezeigt.
Qiskit Patterns Schritt 4: Nachverarbeiten (Post-process)
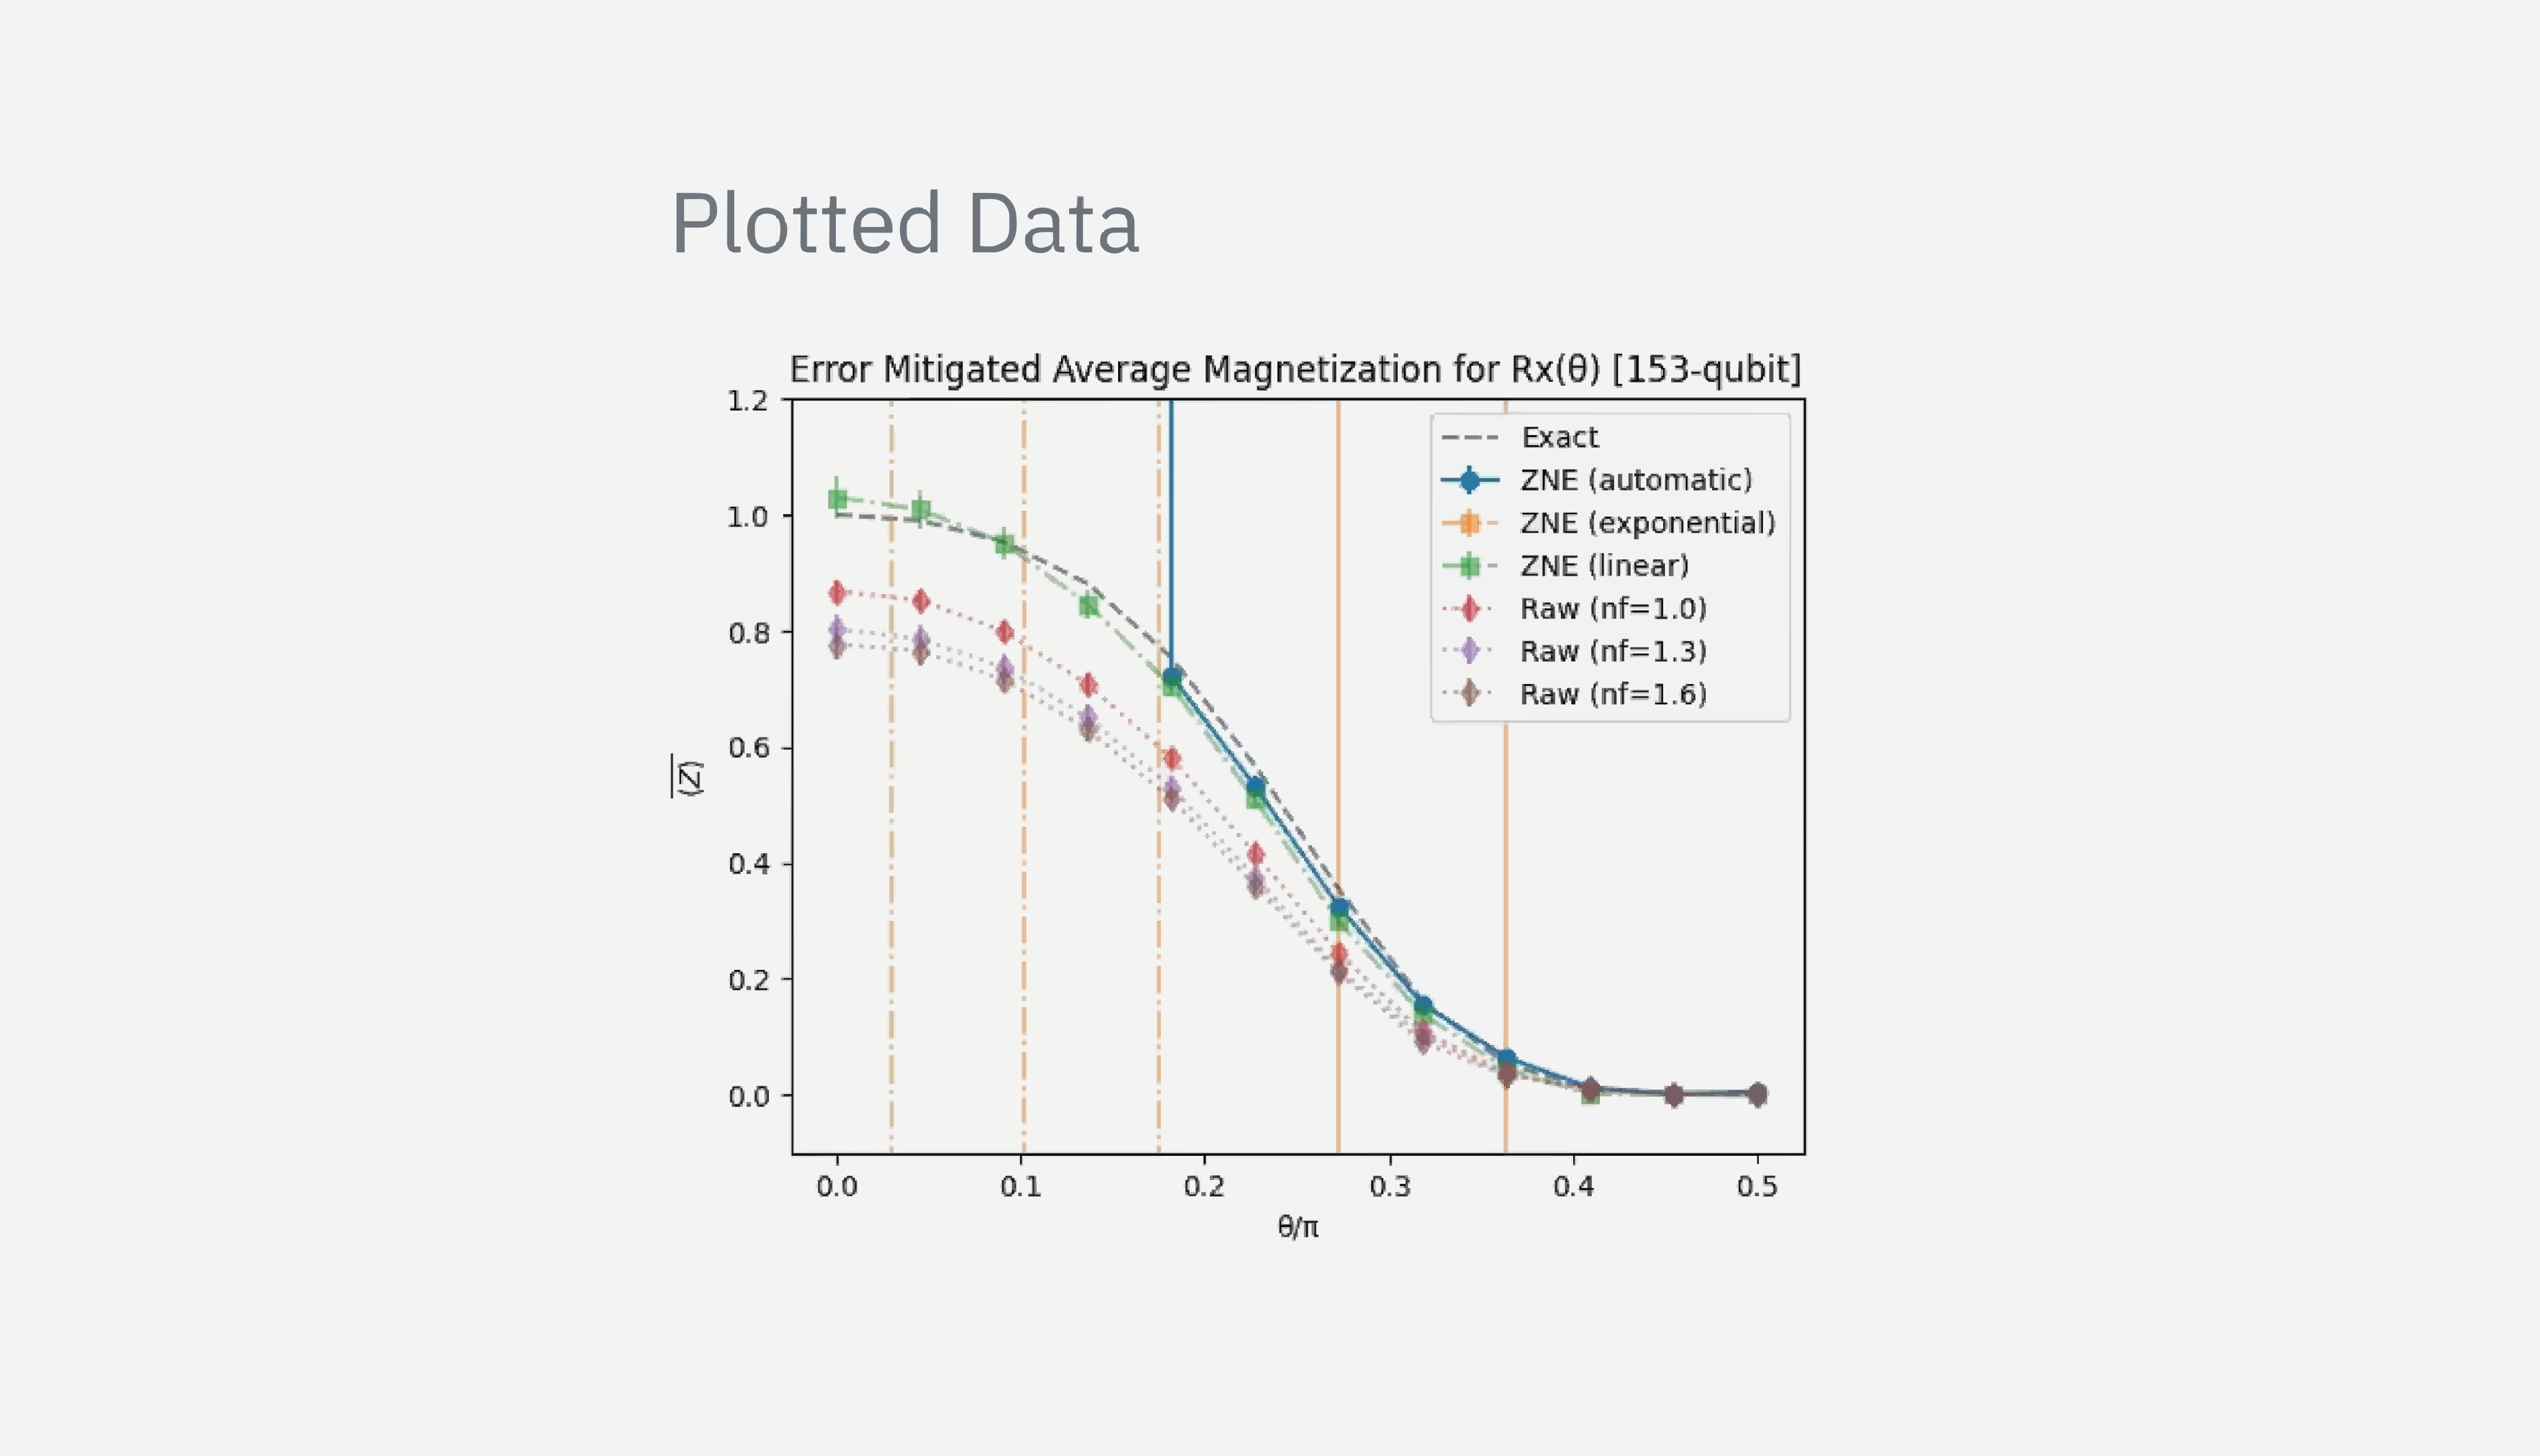
Nach Abschluss des Experiments kannst du das Ergebnis durch Nachverarbeitung anzeigen. Die gepunktete graue Linie in den dargestellten Daten stellt die mit approximativen klassischen Methoden erzielten Ergebnisse dar, wobei der Approximationsfehler auf einen niedrigen Grenzwert reduziert wurde. Die Rohdatenpunkte für die verschiedenen Rauschfaktoren, die zu Beginn ausgewählt wurden, sind deutlich von dieser gepunkteten Linie versetzt. Im Gegensatz dazu zeigt die durchgezogene blaue Linie die Daten nach der Anwendung unserer ZNE-Verarbeitung, die die Ergebnisse merklich näher an die exakten Werte bringt. Zusammenfassend zeigen die unter normalen Rauschbedingungen erhaltenen Werte (Rauschfaktor nf=1.0) eine erhebliche Abweichung von den exakten Ergebnissen. Dagegen stimmen die geminderten Werte eng mit den exakten überein und demonstrieren die Wirksamkeit der PEA-basierten Rauschminderungstechnik.
Zusammenfassung
Zusammenfassend, was wir gelernt haben:
-
Quantensimulation ist einer der vielversprechendsten Anwendungsbereiche kurz- bis mittelfristig.
-
Sie hat weitreichende Anwendungen, von Pharmazeutika über Hochenergiephysik bis hin zu Materialwissenschaften und mehr.
-
Das Utility-Paper von IBM, das 2023 veröffentlicht wurde, zeigte den Weg, Quantencomputer für wissenschaftliche Entdeckungen einzusetzen, und wir haben das zugehörige Tutorial durchgearbeitet, das mit dem Paper einhergeht.
-
Die Schritte zur Lösung eines Simulationsproblems von Anfang bis Ende sind relativ unkompliziert, und wir hoffen, dass du jetzt dieses Video und Tutorial als Leitfaden für noch mehr Simulationsprobleme nutzen kannst.
Kurs-Abschlussbefragung
Herzlichen Glückwunsch zum Abschluss dieses Kurses! Bitte nimm dir einen Moment Zeit, um uns bei der Verbesserung unseres Kurses zu helfen, indem du die folgende kurze Umfrage ausfüllst. Dein Feedback wird zur Verbesserung unseres Inhaltsangebots und der Nutzererfahrung verwendet. Vielen Dank!