Gepoolte sample-basierte Quantendiagonalisierung eines Kern-Hamiltonians
Geschätzte Nutzungsdauer: 2,5 Minuten auf einem Heron-Prozessor (HINWEIS: Dies ist nur eine Schätzung. Deine Laufzeit kann abweichen.)
Dieses Notebook stellt die Python-Implementierung vor. Die Fortran-Implementierung befindet sich im Fortran-Begleitverzeichnis dieses Dokumentations-Repositorys. Die Python-Version fügt einen selbstkonsistenten Konfigurations-Wiederherstellungsschritt hinzu, den der Fortran-Treiber nicht ausführt.
Lernziele
-
Lerne, wie ein nukleares Schalenmodell-Hamiltonian, tabelliert in einer -gekoppelten Basis von Orbitalen, zu einem Qubit-Hamiltonian im -Schema wird, bei dem ein Qubit einem Einteilchenzustand entspricht.
-
Baue einen festen, nicht-variationellen Anregungsansatz, dessen Winkel aus Störungstheorie zweiter Ordnung stammen, sodass keine klassische Optimierungsschleife erforderlich ist.
-
Vergleiche Qubit- und fermionische Anregungen und miss, wie sich die Wahl auf die Zwei-Qubit-Tiefe des Ensembles auswirkt.
-
Führe selbstkonsistente Konfigurationswiederherstellung mit
qiskit-addon-sqddurch, wenn die erhaltenen Größen Nukleonenzahlen, und Parität statt Elektronenzahlen und Spin sind. -
Wende einen Workflow von einem 24-Qubit-Problem, das du exakt überprüfen kannst, auf ein 40-Qubit-Problem mit fast zwei Millionen Basiszuständen an, das über die Kapazität der exakten Diagonalisierung dieses Tutorials hinausgeht.
Voraussetzungen
Sieh dir vor dem Start die folgenden Themen an:
-
Sample-basierte Quantendiagonalisierung und die SQD-Addon-API-Referenz.
-
Sample-basierte Quantendiagonalisierung eines Chemie-Hamiltonians, das Gegenstück dieses Tutorials für die Elektronenstruktur.
-
Transpilieren gegen ein Backend-Ziel und Einführung in Primitives.
-
Zweite Quantisierung und die Jordan-Wigner-Abbildung.
Hintergrund
Das nukleare Schalenmodell behandelt einen Kern als wenige Valenz-Nukleonen, die sich in einer kleinen Menge von Einteilchenorbitalen über einem inerten Kernrumpf bewegen und über eine empirische Zweikörperkraft wechselwirken, die an gemessene Spektren angepasst ist. Es wird häufig in der niederenergetischen Kernstruktur verwendet. Sein Rechenaufwand ist kombinatorisch: Die Basis besteht aus jeder Möglichkeit, die Valenzprotonen und -neutronen auf die verfügbaren Zustände zu verteilen, und dieses Wachstum begrenzt die Modellräume, die für die exakte Diagonalisierung zugänglich sind.
Gepoolte sample-basierte Quantendiagonalisierung (Pooled SQD) [1] teilt dieses Problem in zwei Teile. Ein Quanten-Circuit wird nur verwendet, um zu vorschlagen, welche Basiszustände relevant sind. Er wird in der Rechenbasis gemessen, und jeder gemessene Bitstring benennt eine Slater-Determinante. Der Hamiltonian wird dann klassisch im Spann dieser Determinanten aufgebaut und diagonalisiert. Da der klassische Schritt eine exakte Diagonalisierung innerhalb eines Unterraums ist, liefert er eine variationelle obere Schranke für die wahre Grundzustandsenergie, und die Schranke kann nur sinken, wenn Determinanten hinzugefügt werden.
Diese Arbeitsteilung macht die Methode rauschtolerant, mit einer wichtigen Einschränkung. Rauschen ändert, welche Determinanten der Circuit vorschlägt. Es geht nicht in den klassischen Hamiltonian ein und kann daher den Eigenwert eines gegebenen Unterraums nicht verändern: Ein Shot, der eine erhaltene Größe verletzt, wird verworfen oder repariert, und ein Shot, der übrig bleibt, ist ein legitimer Basisvektor, unabhängig davon, wie er erzeugt wurde. Rauschen kostet dich daher Unterraumqualität, nicht Korrektheit, und die Zahl, die du meldest, ist so oder so eine obere Schranke.
Die Kernstruktur liefert mehrere exakte Quantenzahlen zum Filtern von Samples. Eine physikalische Determinante muss die richtige Anzahl von Valenzprotonen und die richtige Anzahl von Valenzneutronen, die richtige totale Drehimpulsprojektion und die richtige Parität tragen. Jede kann mit einem Ganzzahltest an einem Bitstring überprüft werden. Der Anteil der verworfenen Samples hängt von der Randbedingung und dem Modellraum ab.
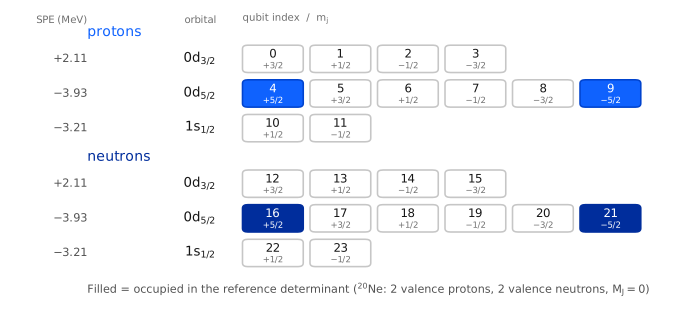
Jedes Qubit ist ein Einteilchenzustand im -Schema , und bedeutet besetzt. Das Register verwendet eine feste Reihenfolge: zuerst Protonen, dann Neutronen; innerhalb einer Spezies Orbitale in Dateireihenfolge; innerhalb eines Orbitals absteigendes . Die beiden Hälften eines Bitstrings sind daher die Protonenkonfiguration und die Neutronenkonfiguration. Dies ist die Bipartition, die von den Pooled-SQD-Nachverarbeitungswerkzeugen erwartet wird.
Der Workflow
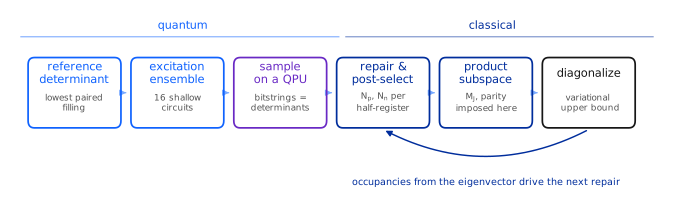
Zwei Stufen im Diagramm behandeln die nuklearen Symmetrien.
Reparatur und Nachauswahl behandeln Samples, die von Hardware-Rauschen betroffen sind. Die beiden Nukleonenzahlen der Registerhälften
sind Hamming-Gewichte, sodass qiskit-addon-sqd sie direkt verarbeitet: recover_configurations repariert einen
defekten Bitstring, indem es die Bits umdreht, die am wenigsten mit der aktuellen Schätzung der durchschnittlichen
Orbitalbesetzungen übereinstimmen, anstatt den Shot zu verwerfen.
Der Produkt-Unterraum führt ein. Da die beiden Hälften koppelt, ist es keine Eigenschaft von jeweils einer, sodass es nicht verwendet werden darf, um ganze Shots zu filtern: Ein Bitstring, dessen Protonenhälfte und Neutronenhälfte jeweils gültig sind, liefert weiterhin zwei gute Halbkonfigurationen, selbst wenn sein gesamtes falsch ist. Der Unterraum wird daher von jedem Produkt einer gesampelten Protonen- konfiguration mit einer gesampelten Neutronenkonfiguration aufgespannt, wobei die Produkte behalten werden, die im Ziel- - und Paritätssektor landen. Dies ist die Pooled-SQD-Unterraumkonstruktion, und sie bedeutet, dass wenige Tausend Bitstrings einen Unterraum aufspannen können, der weit größer ist als die Anzahl der Samples.
Zwei bestimmende Gleichungen
Der Schalenmodell-Hamiltonian ist ein Einteilchenterm plus eine Zweikörperwechselwirkung,
wobei -Schema-Zustände bezeichnen und für ein Proton, für ein Neutron gilt. Empirische Wechselwirkungen wie USDA [2] und GXPF1 [3] sind nicht im -Schema, sondern in der -gekoppelten Basis tabelliert, als Matrixelemente zwischen normierten antisymmetrisierten Zweikörperzuständen von Orbitalen . Die Wiedergewinnung des -Schema-Elements ist eine Clebsch-Gordan-Rückkopplung,
wobei die -Faktoren die Normierungskonvention der tabellierten Zustände rückgängig machen. Alles andere in diesem Tutorial baut auf diesen beiden Gleichungen auf.
Die drei Läufe
| Kern | Schale | Qubits | Symmetrieerlaubte Basis | Exakt überprüfbar? | |
|---|---|---|---|---|---|
| Kleinmaßstäblich | (2p + 2n) | 24 | 640 | Ja | |
| Großmaßstäblich | (2p + 2n) | 40 | 4,000 | Ja | |
| Großmaßstäblich | (4p + 4n) | 40 | 1,963,461 | Nein |
Der kleinmaßstäbliche Lauf ist die Schritt-für-Schritt-Anleitung. Beide großmaßstäblichen Läufe verwenden ein 40-Qubit-Register: Der erste ist noch klein genug, um exakt auf einem Laptop diagonalisiert zu werden, sodass du das Hardware-Ergebnis mit einer exakten Referenz vergleichen kannst. Der zweite übersteigt die Kapazität der exakten Diagonalisierung dieses Tutorials.
Jeder Lauf hier wird auf einer QPU ausgeführt. Dies ist eine Entscheidung, die für dieses Tutorial getroffen wurde, und keine Anforderung der Methode: Alle drei Läufe teilen sich ein Backend und ein Gate-Budget, sodass du ihre Leistung bei unterschiedlichen Problemgrößen vergleichen kannst.
Anforderungen
Installiere vor dem Start die folgenden Pakete:
-
Qiskit SDK v2.0 oder höher (
pip install qiskit) -
qiskit-ibm-runtimev0.40 or later (pip install qiskit-ibm-runtime) -
SQD-Addon v0.12 oder höher (
pip install qiskit-addon-sqd) -
NumPy, SciPy und Matplotlib (
pip install numpy scipy matplotlib)
Du benötigst außerdem ein IBM Quantum®-Konto mit lokal gespeicherten Zugangsdaten sowie Zugriff auf eine QPU mit mindestens 40 Qubits.
Es wird kein Simulator-Paket benötigt, und es müssen keine Datendateien heruntergeladen werden. Die beiden Wechselwirkungsdateien, die dieses Tutorial verwendet, sind in der folgenden Setup-Zelle eingebettet und werden in ein temporäres Verzeichnis geschrieben, wenn du sie ausführst.
Einrichtung
Dieser Abschnitt importiert die Werkzeuge und definiert die Schalenmodell-Hilfsfunktionen, die der Workflow benötigt, in der Reihenfolge, in der der Workflow sie verwendet. Die Physik hinter jeder einzelnen wird im Anhang hergeleitet; die Kommentare beschreiben die Rolle jeder Funktion im Workflow.
Zuerst werden zwei Wechselwirkungsdateien entpackt. Beide sind veröffentlichte Parametersätze, die hier eingebettet sind, damit das
Notebook eigenständig ist: usda.snt ist der USDA--Schalen-Hamiltonian [2] und
gxpf1.snt ist der GXPF1--Schalen-Hamiltonian [3].
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-sqd qiskit-ibm-runtime scipy
from __future__ import annotations

import base64
import gzip
import itertools
import tempfile
from dataclasses import dataclass
from functools import lru_cache
from math import factorial, sqrt
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np

from qiskit import QuantumCircuit
from qiskit.circuit.library import PauliEvolutionGate
from qiskit.quantum_info import Operator, SparsePauliOp
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_addon_sqd.configuration_recovery import recover_configurations
from qiskit_addon_sqd.counts import bit_array_to_arrays
from qiskit_addon_sqd.subsampling import postselect_by_hamming_right_and_left
from qiskit_ibm_runtime import QiskitRuntimeService, SamplerV2

from scipy.linalg import eigh

_USDA_SNT_GZ = (
    "H4sIAI5wqWoC/4WY224bRwyG7/UU9F0CONsZco5AUyBuC/QmQNG06KWhWGql1LYMy+kJefiOTrucGXJrQAgsf5nl8ecOr+CX"
    "D9+9g/0K9pv1/T389rx7gPLrsH+Cz/vVctg+vgAsrgB+HeDdAD9t7zYv6+dr+DDA+z8223/X17B8XMFN+ev9+m+4ed799XjA"
    "f9z8sy/4+s8BvoWYrsEERwbhFRqTXi+uCvOwW63vYf+0vFvDAgDo/AFIh8/hK7DH30354Omvb8o3V8c/vIUnMKtboK/wiGKF"
    "+gnFEfVn9PQUe8bthNIRtftbsGfUtQbAGXUFfawM8K0BF9SP6MWA0BpwQcMRvRhwBSX86+fl3ct2d4jq4+eHa3hYv2x2q7fX"
    "AJuPy+fb3cP69+Uh4luAT8djv95++eGV/fj6y6dvFudnmcX4lGOoBmttNOVncTL2FLs3NGT0l++ndJTv0cR8/t6NUanP8WMI"
    "6nPC6C8/5wp+vnn//QLOP9ank3k2wRszkDn/Zwv15xiv41l2SDmjhuEFM4PJ0QkYcgzM4A1Jp1GDkcvtaWMAR9tosAa9huHk"
    "AtoUBYwaF8hGarAxOywgxnoeN+Se2smF4H3QMPZQ653XMJpOi6GyrcLcZJtzLgoYcdsOyXKibV1Aom0fikJO0VLUMDeW3kAl"
    "qQLWpd66qGE02eZ9lXqSPD3UWyl5DeOeGnINJnmaUggCVrtgh2DJNm3fVy8WF3LSMFa9hYga5iYX0IQsYK2nmTpJkoq81Acy"
    "jLTTnPEaxqo3JGcbvZMeGnJVbw6mf2cUqcIsO80nFdOFq8JoSlY+Zb7FfNNZlnw2PqOE8SL3PtlSJhJGXGqsDRjbh4bmocWy"
    "oiIxSxjv09JYgaxlGLZxA9EFFOImuIBt3EB04TK3Z5S8wizrrFCJQ4Xpgl9hzDYbu0LCNm6HzkJHweUkYazITalyF7NjGAnh"
    "FZJFQniFZFHnqWgbdZ6qtoX50VZhvEJ81TJe7AUcQozH8yQMJ8ymUS07jLin6LXT3FRIhmwSTmtbJpEjr2AsvM7E1ra+ZaiM"
    "NoxewZinBlPQTmPJyikn7TQ2630SbWuz4CLlwzuGhCHPqbUmRZQwpkiBDn1vsoQ55oKjbEvNNVgbXls0WvA0NKnPpku91Fkx"
    "pahhXPDJtxVCQkBcMtJD27I8VJGAhWYYlVuZzc5e+jSIZWnLa57nOQ1iWZY+jSE3GP5/QIKi5E1Agqi9BbMZiUjEWNwChqKq"
    "KTZY11ku5ca2Pqc4YKk1o2DstBjJC1htW2nAgEZ4aDdPvQmmmLeY4tWFt9Y3VAdlpW+oDcpa3zpM1jdUB2XV9agOyqrrcWZQ"
    "sq7vMMffBseux5l5yjoLZ+Yp6yzU5mmt5DgzT5mSozZPoVIknJmnTJFQHZRV12OrlvpFQFbycoGKOWiYfl9QlXySGtSUvL9W"
    "VJi/YG4grC4CmuCX6CZrKUsY64UyJolCQoZJqWeKhDOCzxQJNcGXbZMEX7EtzF+gvCI1npxjmKaW5Q06ewVjOY0u2+Y0kt5D"
    "JhlETS2P+5CqyIMYkCI1NK50SO3TarSR2qfVaKOZPmXjg2beVJmS01zqp/CSmvoqvNSOD/kaS+qUoSGaTM2yz83fdjtMvsZy"
    "xOv7N44Fff/GT5q5tXWYfB3jWND3b9yumUvK5SQnvK6w/VuHyfu3DpP3bx0m7984FvT9W4fJ+zceWq/v3zpM3r9xLOj7tw6T"
    "928X053QgGz/1mHy/u3yZ8lTtn/jWND3b74NiDx2vRbeep56Lbz1oPRaeOv9G0dmxofXPK33bx0m798C1B9RuP4DPJ0WcLAa"
    "AAA="
)

_GXPF1_SNT_GZ = (
    "H4sIAI5wqWoC/4WcQY8dtw3H7/kU41sCeF8lUqKkQw9NgbaXoEHQQ26BkdiIEWdt2E6L9tNXb9+ORIn8PwdZILB/S3I4IsW/"
    "ZiYvjr//+P3f4nG8ef/x+PDm4dOvr9+9++rF8d3l+Mf7x99fvTz+dTn++fnTH7/1//z28pfL8e3H9/95fHm8evzl+lffvf3f"
    "H59e/fb26L9zHN//+t9Pl+OH1/++HH89JL88gkQO8esfvjm+phDomyvW//39/S+v3x2fPrz6+fVX/dfS889B4fpz/aN43P7p"
    "f3Bw/ynH8fD0Zy+uf/fn48MR3vxU/kRXlp7Z+PzDiqUnNn74iW8sb3azYvm0m29s2uxGxabTbryx2cZ7nGzu7KOKV2y8g5Un"
    "dsZbbLyDLafd53irjXew9bR7jffF8fbx8+uPr37+/Pb941dPv3P93ZH4W/If6kUohXCm+Jbmh3yR0jicybwl9CFeuFILy908"
    "HtIlcrlZyCNJ2q6MdGi7ZVy4tlvHJS52Y71FnHp8D+HCIYTlQuYFhdsv0yVxzZB6vsxwaZwJUumkIjWB1POdDhcqlR2KVo85"
    "SoDU8NgdNodiZevqMUqB1LCVWsO2ZMQlyYs+bXEFk4m5bMJJlVgSpGjaouhQvFKxUIbUjIvI85hWW4FNvubyDnMxMkFKRc8V"
    "Uml65OhQW1x9fe3XOAtsZPXJ36TIX18SaoQUnysnZsHUXPfcKqTyaSu36FHbWg0tN0jxWIXEAVLzbqcqkMpj3T8lwlBp9RhD"
    "qpAaHpnzni9nRXPh6lDbysmJBVLzDtU71KztnDxqW1+JhDaKnTtUa4DUzH00Hp0VXQMHSM3c16irlpf7GEcN1dogpfpEDpAa"
    "WRUOBKl0UqkIQ2qs+5IYU6OvthbFodIaF6/9i51VeF0TLZSN2lfh9T729utQOqtXKi/dl/21mihhW+M+BpIKqblypDWHSntc"
    "mSA1O3nMe+6dHp0DEaRmXCU0h9p7dOYCqVm1MehOnvy7nWphSKnuu+Q++X2Ca4uQGrYkxp3yMkFLL0ygavPovmR64dhFY5QM"
    "KVK1XRxqX4UydlHCXU44hY1ydndKuUBK11BzqH1NNOKNMvt27PMXVUWBemSqCVIjrr4nYFtzTSQJkJp3O7se09p9YygCKVL7"
    "UN4opx5DNnE5q5AlerZ2jyExpEYmggTtMYFrzC1Bak58jetGeSvHenSip9ROik0m5lqdsxzjrCYhTM1uImOHYZzVPvnWjXIm"
    "0RoaKyqhjjlqiEE3uWoYHqopbT/KY0pDD+Xtx9d8lvI0n6U8zWcpT/NpQqDms5Sn+TRVoOazlKf5LOVpPk1VqPl05AI1n6U8"
    "zaepAjWfpTzNp6kKNZ/OQoGaz1Ke5rOUp/k0VaHm03mvUPOd1+esL6X5LOVpPkt5ms9SnubTVIGaz1Ke5rOUp/ks5Wk+TVWo"
    "+SzlaT69mgVqPk0VqPks5Wk+S3maT1MVaj5dPwVqPkt5mk9TFWo+S3ma77x/8z56ms9SnuazlKf5LOVpPkt5ms9SnubTVIWa"
    "z1Ke5jupfRWumk9TBWo+S3maz1Ke5rOUp/k0VaHms5Sn+XTnLVDzWcrTfJqqUPNZytN85/1z7rbSfJbyNN/5t06fUJrPUp7m"
    "OykvE7T0wgqqdmo+Mb3Q03yCO6bSfII7ptJ8gruc0nxi+pen+eROL5yaT3CXU5pPx1Sh5hNcj0rzCajHVfMJqMdV88mdesyu"
    "xwo1n+B6VJpPcD0qzSe4HpXmE1yPSvMJrkelwERVR4Waz1Ke5hNTQ3THoxO90nzFZMLTfAVnVWm+grOqNF/BWVWaTxMVar6C"
    "r1FpvgK6yar56vbja76onormu8/5ViqOrNblZH6l0NPAlRq9sKaIbaFnhis15tUuH/E1oieLK1XOTIgsz3ROap9XpQ/SJWqK"
    "bCYcKm6K4tp9iUqqzbd1j4qO+g2tpTV6sll1qLipk6fnw32/isDWPSruPborwz7x9eakKbbry6Gi7RN9nrhuHr4tPXXsVLT9"
    "vvTdKlUQ18i9Q0Wn+2ZOlYpva0yiDhXthNz69p4S+7ZG7h0q2jma+/BIIfm2RnU4VLQ9R6hG4iWryVurhorOlNbzEJr4tubk"
    "bim6e25iqbFbJY4MKfREfaXGNXKK2aF2BSapD6Oy5162yd1S5Og0iq3k5tua1WEpsus+ZO4ZS76tqU4sRc7+mAtJyL6teR8t"
    "RVbDUO9yXM2a2O6jQ5GjdCi3HKpva04dluK7J1uWGtFLjhFS6J2HlZpKhzOm0JsRK5XnmjD7Izv5av0eBd7zVb5IsVU6ffTN"
    "oQXf1peoeveNjZWaNURFZ0L8fTsX1s9hwO4eeHkOA3Z3Zct6ZOccgPAM0O91hR4ZPEcWMAPkdBWQvsdZj72xZuTRs2U95qFY"
    "a8FZHVQpy/Mhd55YbGmPew2VGB2PRvOVsNlib0orYbO1U8fi0cbF6uQhw7jUycMybYs/dSiKwGxyLB5tXEmdM5WM4lKnGLFm"
    "FFeaPTruK8ehlEcbV55n2yIwrnlOXorAuPKsxyIwrjz7l3greptzSgve+tqo2lLbcu9MQ4oiPDMpjzaueR8rUUZxqaql/T46"
    "k5WiCM9fyuNpy5uZpM9WkvfaxpS1Ndd96JKV2LflUdrW1idaKOT0HNMnTCdnT/OZvcOZv5RHG5fqAJFhXLO2WykwrtlzJkV4"
    "llMebVxp7kOUMopr7h1dSmcUl9LuxesT2z6kPOq4ttkkk7sj1/1JWWWnHvfdfVKE50LlUV+jObPqs2hO+zViytpSJ+CFSyu+"
    "LY+yttRM3gf3HH1bHmVtzR5NXZQXcI0epW1tdyh2d86a2O52F9vR6V8FUgTm1dWjjWuepZUgMK45k2cKMC6PIjD7rh6j+gpi"
    "0Y904b675/n2h3u6QteTedkoc7qy2LIeaUxpkXNAHgeV53khozOYxZb1qDpTrvAa+TxBClECvEbPlvWY5o4cA7zGNDSfFIbX"
    "6NmyHmd1SEnwGgfVJ6YKr9GzZT3KebdDZIYe5bzGQLFAj54t7XHXfDkmJ6v789r17e7iTEMrxXhmUh5tXHNmainCuObMVBOO"
    "y6MYzEyrx9MW2VMf4cC9NWlbzpmVoqytucPkIO12SsZ4/lKUtTX7V6LGsfi2phadlLa1nX89naUHc437uYnQni/nlEzWN/S8"
    "s7TVo41LvUsW9+pwqFBl79HsPYkVr/sK9GjjYnVWSzBfqjoowXx5FN+ZC6dHG5d6WybjfM15ouYE8+VRDObC1aOOa3v+WEJq"
    "Tlzb2VCRELOtbYEU47NH5dHGpd5nagzj0s+HAozLoxjMq6tHnfutHmNjblz23G/1qChra3rMOT6f3jGefRVlbamZKfR1COKa"
    "PWdS1tZcXy3mnMm3pd4IGpS1Nd9Uai0Wir6t+fxxUtrWPvu27M1MG8XJ1KMz+yqK8Vmt8mjjmn1CKmcUF88zhVIzimtOtZNi"
    "fO6rPGpbW9XGLrg50G5rfwNhUueu7swmEtI55yQ0m/RpqI3JPd15ujVtWY9TSbcxpSU8dSShAj16tk4b3r6dmUlI2/L27Ulp"
    "W7vKLFK3uByK4nI2VP19SFEJ7EOrRxvXyESr413YhPchLsssV/0dRlEJ70PKo7a1n/vWa1rLbsu8mTooa0up8tpyEd+Wep42"
    "KG1rf6su5ebkvpqztLzl3qltRSVc28ojmTM+9F2TwNm3Qgp9/eSeKnaNXFtwqH3nk1KaJE05M6ZDOdNjv9NJIvm2Zr+3lFeP"
    "EvqGnH1bM/eWMtNQvFCRHnzUlJlzXMqZYFKqHHLxbdFUFIbiu+8XWmo+50vL6R06l1u/PBO/asN8B5zAmdXTDtP7r8h+jeWL"
    "lFOPocYumti39SWq3v0iTvxdtDw9hhmUq9N6PbaqvzJyqyNeMi0nIm51LLbojgIrOUKP+l2yBj16tghrqxib1gqg0pLknfIq"
    "bdoirJqkMMNrnDNATPgaPVuE9VBv0J7HbU107V42W44eUhSjPrF4JKyHUokZxqXeTV+exAI9pCjGp/zKIwE9dO2+XSTX1vbc"
    "b6pJUYT1UOCWWw2+rdmZJkVYD1Ef0Uoi39acySdFWA9RztLVjm9LPQ0cFAENc3unJjrVsWuY0mK297EYxbrbcs7vlUfCGib3"
    "bQ/GNWffMijCGkZRDHr0w+KRsIbpnem6dnZbe9VOitTsW7e3I+e7Pgnv7tfHQxvl7O7KlvU4zu95fouUUNV21RSGFk2oHhdb"
    "ZGbf+b4cXf8nRlnb8maASVlbc+UkSnSb0hKox4eFIjNHz7c/aHydkvC6T9Lydo3Je+u8ZSdf+xsu06O2ta2vPr70W1l2W9v6"
    "UhSbPoG+kwYnSDVnTKGvqYvfv3JuDVLom2vvpOZpvh9fizHuX71jVp79vqDcG8rrJolLnecTxe8TgMLfBTDoJteOGUVntYJr"
    "5PHOVsKnUaEuJw8oE9MWA5V5e2tA9wmQrw5xQB6RrernS33VkEB1PCmKW5f7P6zudeW7TwAA"
)

DATA = Path(tempfile.mkdtemp(prefix="nuclear_sqd_"))
for name, blob in (("usda.snt", _USDA_SNT_GZ), ("gxpf1.snt", _GXPF1_SNT_GZ)):
    (DATA / name).write_bytes(gzip.decompress(base64.b64decode(blob)))

    if not (DATA / name).is_file():
        raise RuntimeError(f"{name} did not unpack to {DATA}")
Der Modellraum und das Qubit-Register
Eine .snt-Datei enthält den Modellraum, die Einteilchenenergien und die -gekoppelten Zweikörper-
Matrixelemente. Für die hier verwendeten massenabhängigen Wechselwirkungen geben das dritte und vierte Feld des Zweikörper-
Headers die Referenzmasse
an, bei der die Wechselwirkung angepasst wurde, sowie den Exponenten ihrer Massenabhängigkeit. Beide
Dateien tragen den Exponenten , mit für USDA und für GXPF1, sodass die
tabellierten Matrixelemente für den betrachteten Kern um skaliert werden müssen
[2], [3]. Einteilchenenergien werden nicht skaliert. Wird dieser Schritt
übersprungen, ändert sich die Korrelationsenergie um einige Prozent.
Die im Folgenden angegebenen Energien sind Valenz-Energien, gemessen vom inerten Kernrumpf aus; sie sind keine experimentellen Separationsenergien.
@dataclass(frozen=True)
class Orbital:
    idx: int
    n: int
    ell: int
    j2: int
    tz: int  # j2 = 2j; tz = -1 proton, +1 neutron

@dataclass(frozen=True)
class SPState:
    """One m-scheme single-particle state, i.e. one qubit."""

    orb: int
    j2: int
    mj2: int
    tz: int
    ell: int
    spe: float  # mj2 = 2 * m_j

@dataclass
class ModelSpace:
    orbitals: list
    spes: dict
    tbmes: dict
    core_z: int
    core_n: int
    mass_number: int
    a_ref: int
    mass_exponent: float
    mass_factor: float

def read_snt(path, n_protons, n_neutrons):
    """Parse a .snt interaction file, applying its mass dependence for this nucleus.

    The two-body header line is ``n_tbme  method  A_ref  exponent``.  When ``method`` is 1 the
    tabulated matrix elements are rescaled by ``(A / A_ref) ** exponent``, where A is the mass
    number of the whole nucleus -- the core plus the valence nucleons.  A is derived from the
    file's own core numbers rather than passed in, so it cannot silently disagree with the
    valence counts the rest of the workflow uses.  Single-particle energies are not rescaled.
    """
    rows = [
        ln.split("!")[0].split() for ln in Path(path).read_text().splitlines()
    ]
    rows = iter([r for r in rows if r])

    n_p_orb, n_n_orb, core_z, core_n = (int(x) for x in next(rows)[:4])
    orbitals = [
        Orbital(*(int(x) for x in next(rows)[:5]))
        for _ in range(n_p_orb + n_n_orb)
    ]

    spes = {}
    for _ in range(int(next(rows)[0])):  # "i  i  <i|H(1b)|i>"
        field = next(rows)
        spes[int(field[0])] = float(field[2])

    n_tbme, method, a_ref, exponent = next(rows)[:4]
    n_tbme, method, a_ref, exponent = (
        int(n_tbme),
        int(method),
        int(a_ref),
        float(exponent),
    )
    mass_number = core_z + core_n + n_protons + n_neutrons
    factor = (mass_number / a_ref) ** exponent if method == 1 else 1.0

    tbmes = {}
    for _ in range(n_tbme):  # "a  b  c  d  J  value"
        field = next(rows)
        tbmes[tuple(int(x) for x in field[:5])] = float(field[5]) * factor

    return ModelSpace(
        orbitals,
        spes,
        tbmes,
        core_z,
        core_n,
        mass_number,
        a_ref,
        exponent,
        factor,
    )

def m_scheme_states(ms):
    """The qubit register: protons then neutrons, orbitals in file order, m_j descending."""
    return [
        SPState(o.idx, o.j2, m2, o.tz, o.ell, ms.spes[o.idx])
        for tz in (-1, +1)
        for o in ms.orbitals
        if o.tz == tz
        for m2 in range(o.j2, -o.j2 - 1, -2)
    ]
Clebsch-Gordan-Rückkopplung
Gleichung (2) erfordert Clebsch-Gordan-Koeffizienten für halbzahlige Drehimpulse. Jedes Argument wird
als doppelter physikalischer Wert übergeben, sodass als 5 eingeht und die Arithmetik exakt bleibt.
Interaction.v_ms übernimmt das Nachschlagen der Wechselwirkungsmatrixelemente. Eine .snt-Datei speichert jedes
Matrixelement einmal, sodass ein Nachschlagen auf beiden Seiten möglicherweise die antisymmetrisierte Paaraustauschphase
benötigt, und Bra und Ket können in beliebiger Reihenfolge gespeichert sein.
@lru_cache(maxsize=None)
def clebsch_gordan(j1_2, j2_2, J_2, m1_2, m2_2, M_2):
    """<j1 m1 j2 m2 | J M>.  Every argument is twice its physical value."""
    if m1_2 + m2_2 != M_2 or not abs(j1_2 - j2_2) <= J_2 <= j1_2 + j2_2:
        return 0.0
    if abs(m1_2) > j1_2 or abs(m2_2) > j2_2 or abs(M_2) > J_2:
        return 0.0
    if (j1_2 + j2_2 - J_2) % 2 or (j1_2 - m1_2) % 2 or (j2_2 - m2_2) % 2:
        return 0.0

    f, half = factorial, lambda x: x // 2
    prefactor = sqrt(
        (J_2 + 1)
        * f(half(j1_2 + j2_2 - J_2))
        * f(half(j1_2 - j2_2 + J_2))
        * f(half(-j1_2 + j2_2 + J_2))
        / f(half(j1_2 + j2_2 + J_2) + 1)
        * f(half(J_2 + M_2))
        * f(half(J_2 - M_2))
        * f(half(j1_2 - m1_2))
        * f(half(j1_2 + m1_2))
        * f(half(j2_2 - m2_2))
        * f(half(j2_2 + m2_2))
    )
    total = 0.0
    for k in range(half(j1_2 + j2_2 - J_2) + 1):
        d = [
            half(j1_2 + j2_2 - J_2) - k,
            half(j1_2 - m1_2) - k,
            half(j2_2 + m2_2) - k,
            half(J_2 - j2_2 + m1_2) + k,
            half(J_2 - j1_2 - m2_2) + k,
        ]
        if all(x >= 0 for x in d):
            total += (-1) ** k / (
                f(k) * f(d[0]) * f(d[1]) * f(d[2]) * f(d[3]) * f(d[4])
            )
    return prefactor * total

class Interaction:
    """Antisymmetrized m-scheme two-body matrix elements <pq||rs>, per Eq. (2)."""

    def __init__(self, model_space, sp):
        self.ms, self.sp, self._cache = model_space, sp, {}

    def _tbme(self, oa, ob, oc, od, J, j_ab_2, j_cd_2):
        """<oa ob; J|V|oc od; J>, allowing for how the file happens to order each pair."""
        table = self.ms.tbmes
        # |ba; J> = -(-1)^(j_a + j_b - J) |ab; J> for a normalized antisymmetrized pair;
        # dropping the leading minus makes v_ms symmetric instead of antisymmetric, and
        # the Hamiltonian then fails the rotational-invariance check in Step 1.
        phase_ab = -1.0 if (j_ab_2 // 2 - J) % 2 == 0 else 1.0
        phase_cd = -1.0 if (j_cd_2 // 2 - J) % 2 == 0 else 1.0
        for keys, phase in (
            (((oa, ob, oc, od), (oc, od, oa, ob)), 1.0),
            (((ob, oa, oc, od), (oc, od, ob, oa)), phase_ab),
            (((oa, ob, od, oc), (od, oc, oa, ob)), phase_cd),
            (((ob, oa, od, oc), (od, oc, ob, oa)), phase_ab * phase_cd),
        ):
            for key in keys:
                value = table.get(key + (J,))
                if value is not None:
                    return value * phase
        return 0.0

    def v_ms(self, p, q, r, s):
        """<pq||rs>, zero unless M_J and charge are conserved."""
        cached = self._cache.get((p, q, r, s))
        if cached is not None:
            return cached

        P, Q, R, S = (self.sp[i] for i in (p, q, r, s))
        value = 0.0
        if P.mj2 + Q.mj2 == R.mj2 + S.mj2 and P.tz + Q.tz == R.tz + S.tz:
            M = P.mj2 + Q.mj2
            # sqrt(1 + delta): undo the normalization of the tabulated pair states
            c12 = sqrt(2.0) if (P.tz == Q.tz and P.orb == Q.orb) else 1.0
            c34 = sqrt(2.0) if (R.tz == S.tz and R.orb == S.orb) else 1.0
            for J2 in range(
                max(abs(P.j2 - Q.j2), abs(R.j2 - S.j2)),
                min(P.j2 + Q.j2, R.j2 + S.j2) + 1,
                2,
            ):
                cg_bra = clebsch_gordan(P.j2, Q.j2, J2, P.mj2, Q.mj2, M)
                cg_ket = clebsch_gordan(R.j2, S.j2, J2, R.mj2, S.mj2, M)
                if abs(cg_bra) < 1e-12 or abs(cg_ket) < 1e-12:
                    continue
                value += (
                    c12
                    * c34
                    * cg_bra
                    * cg_ket
                    * self._tbme(
                        P.orb,
                        Q.orb,
                        R.orb,
                        S.orb,
                        J2 // 2,
                        P.j2 + Q.j2,
                        R.j2 + S.j2,
                    )
                )

        self._cache[(p, q, r, s)] = value
        return value
Matrixelemente und der Symmetrietest
Eine Determinante ist ein sortiertes Tupel besetzter Qubit-Indizes. Zwei Determinanten, die sich in mehr als zwei besetzten Zuständen unterscheiden, haben ein verschwindendes Matrixelement; andernfalls liefern die Slater-Condon-Regeln eine kurze Summe über die Wechselwirkung, multipliziert mit einem fermionischen Vorzeichen, das zählt, wie viele besetzte Zustände zwischen den Operatoren in der festen Registerreihenfolge liegen.
symmetry_allowed ist der Ganzzahltest, auf den sich alle vier exakten Quantenzahlen reduzieren. Er wird sowohl
zum Filtern von Samples als auch zum Aufzählen der exakten Basis für die Läufe verwendet, die klein genug zum Überprüfen sind.
def matrix_element(inter, det_a, det_b):
    """<A|H|B> for two determinants, each a sorted tuple of occupied qubit indices."""
    set_a, set_b = set(det_a), set(det_b)
    out_a, out_b = sorted(set_a - set_b), sorted(set_b - set_a)
    if len(out_a) != len(out_b) or len(out_a) > 2:
        return 0.0

    if not out_a:  # diagonal: one-body plus two-body
        return sum(inter.sp[i].spe for i in det_a) + sum(
            inter.v_ms(i, j, i, j)
            for i, j in itertools.combinations(det_a, 2)
        )

    if len(out_a) == 1:  # one state moves, p -> q
        p, q = out_a[0], out_b[0]
        crossings = sum(1 for k in set_a if min(p, q) < k < max(p, q))
        return (-1.0) ** crossings * sum(
            inter.v_ms(p, j, q, j) for j in det_a if j not in (p, q)
        )

    (p, r), (q, s) = out_a, out_b  # two states move
    crossings = sum(1 for k in set_a if p < k < r) + sum(
        1 for k in set_b if q < k < s
    )
    return (-1.0) ** crossings * inter.v_ms(p, r, q, s)

def subspace_hamiltonian(inter, dets):
    """Dense real-symmetric H projected onto the span of `dets`."""
    H = np.zeros((len(dets), len(dets)))
    for a, det_a in enumerate(dets):
        H[a, a] = matrix_element(inter, det_a, det_a)
        for b in range(a + 1, len(dets)):
            H[a, b] = H[b, a] = matrix_element(inter, det_a, dets[b])
    return H

def ground_state(inter, dets):
    """Lowest eigenvalue and eigenvector of H over `dets`."""
    values, vectors = np.linalg.eigh(subspace_hamiltonian(inter, dets))
    return values[0], vectors[:, 0]

def symmetry_allowed(
    sp, det, n_protons, n_neutrons, mj2_target=0, parity_target=0
):
    """The four exact shell-model quantum numbers, as integer tests on one determinant."""
    n_p = sum(1 for i in det if sp[i].tz == -1)
    return (
        n_p == n_protons
        and len(det) - n_p == n_neutrons
        and sum(sp[i].mj2 for i in det) == mj2_target
        and sum(sp[i].ell for i in det) % 2 == parity_target
    )

def full_basis(sp, n_protons, n_neutrons, **targets):
    """Every symmetry-allowed determinant.  Only tractable for small model spaces."""
    protons = [i for i, s in enumerate(sp) if s.tz == -1]
    neutrons = [i for i, s in enumerate(sp) if s.tz == +1]
    return [
        p + n
        for p in itertools.combinations(protons, n_protons)
        for n in itertools.combinations(neutrons, n_neutrons)
        if symmetry_allowed(sp, p + n, n_protons, n_neutrons, **targets)
    ]

def count_basis(sp, n_protons, n_neutrons, mj2_target=0, parity_target=0):
    """How many determinants `full_basis` would return, without enumerating them.

    A dynamic program over (occupied count, sum of 2*m_j, parity) per species.  This stays
    cheap when the basis itself is far too large to build, which is how the largest run below
    can report the size of the space it is sampling from.
    """

    def species(states, k):
        table = {(0, 0, 0): 1}
        for s in states:
            for key, value in list(table.items()):
                count, m_sum, parity = key
                if count < k:
                    nxt = (count + 1, m_sum + s.mj2, (parity + s.ell) % 2)
                    table[nxt] = table.get(nxt, 0) + value
        totals = {}
        for (count, m_sum, parity), value in table.items():
            if count == k:
                totals[(m_sum, parity)] = (
                    totals.get((m_sum, parity), 0) + value
                )
        return totals

    left = species([s for s in sp if s.tz == -1], n_protons)
    right = species([s for s in sp if s.tz == +1], n_neutrons)
    return sum(
        a * b
        for (mp, pp), a in left.items()
        for (mn, pn), b in right.items()
        if mp + mn == mj2_target and (pp + pn) % 2 == parity_target
    )
Die Referenzdeterminante
Der Ansatz baut auf einer einzelnen Determinante auf, daher sollte diese Determinante die bestmögliche sein. Das Füllen der niedrigsten Einteilchenenergien ignoriert die Zweikörperwechselwirkung. In diesen Modell- räumen liefert diese Wahl eine Energie 1–2 MeV über der Determinante mit der niedrigsten Energie.
Die Beschränkung auf Füllungen aus zeitumgekehrten -Paaren erzwingt exakt und lässt nur Kandidaten pro Spezies übrig (höchstens einige Tausend), sodass die beste durch Durchsuchen aller auf der vollständigen Diagonale gefunden werden kann. Gleichstände gehen an die am stärksten ausgerichteten Paare, wo die -Paarungskraft am stärksten ist. In jedem Fall in diesem Tutorial, der gegen eine vollständige Aufzählung überprüft werden kann, liefert die Suche die global niedrigste Diagonaldeterminante, die auch die größte einzelne Komponente des exakten Grundzustands ist.
def reference_determinant(sp, inter, n_protons, n_neutrons):
    """Lowest-diagonal determinant built from time-reversed (+m_j, -m_j) orbital pairs."""
    if n_protons % 2 or n_neutrons % 2:
        raise ValueError(
            "an odd valence count has no time-reversed paired reference at M_J = 0"
        )

    def species_pairs(tz):
        return [
            (
                q,
                next(
                    p
                    for p, t in enumerate(sp)
                    if t.tz == tz and t.orb == s.orb and t.mj2 == -s.mj2
                ),
            )
            for q, s in enumerate(sp)
            if s.tz == tz and s.mj2 > 0
        ]

    best = None
    for chosen_p in itertools.combinations(species_pairs(-1), n_protons // 2):
        protons = tuple(q for pair in chosen_p for q in pair)
        for chosen_n in itertools.combinations(
            species_pairs(+1), n_neutrons // 2
        ):
            det = tuple(
                sorted(protons + tuple(q for pair in chosen_n for q in pair))
            )
            # break ties toward the most aligned pairs, where J = 0 pairing is strongest
            score = (
                matrix_element(inter, det, det),
                -sum(abs(sp[q].mj2) for q in det),
            )
            if best is None or score < best[0]:
                best = (score, det)
    return best[1]
Der Anregungspool und seine störungstheoretische Rangfolge
Die Korrelation wird von Zweiteilchen-Zweiloch-Anregungen () von der Referenz getragen. Zwei Auswahlregeln reduzieren den Pool, bevor überhaupt ein Circuit gebaut wird: Eine Anregung muss erhalten, und das Lochpaar und das Teilchen- paar müssen an ein gemeinsames Gesamt- koppeln können, was einer Dreiecksungleichung entspricht.
Die verbleibenden Anregungen werden nach dem Epstein-Nesbet-Score zweiter Ordnung der selected configuration interaction [4] eingestuft,
der abschätzt, wie viel Korrelationsenergie jede Anregung trägt. Dieselben beiden Zahlen legen den Circuit-Winkel fest: Mit ist die Amplitude erster Ordnung . Der Anhang erklärt, warum die Amplitude erster Ordnung die in diesem Tutorial verwendete Wahl ist und nicht der exakte Zweiniveau-Winkel.
def excitation_pool(sp, occ):
    """2p2h quadruples (h1, h2, v1, v2): same-species pairs, then proton-neutron pairs."""
    holes = {tz: [i for i in occ if sp[i].tz == tz] for tz in (-1, +1)}
    virtuals = {
        tz: [i for i, s in enumerate(sp) if s.tz == tz and i not in occ]
        for tz in (-1, +1)
    }
    pool = [
        (h1, h2, v1, v2)
        for tz in (-1, +1)
        for h1, h2 in itertools.combinations(holes[tz], 2)
        for v1, v2 in itertools.combinations(virtuals[tz], 2)
    ]
    pool += [
        (h1, h2, v1, v2)
        for h1 in holes[-1]
        for h2 in holes[+1]
        for v1 in virtuals[-1]
        for v2 in virtuals[+1]
    ]
    return pool

def conserves_symmetry(sp, op):
    """Keeps M_J, and the hole and particle pairs share a reachable total J."""
    h1, h2, v1, v2 = op
    if sp[v1].mj2 + sp[v2].mj2 != sp[h1].mj2 + sp[h2].mj2:
        return False
    return max(abs(sp[v1].j2 - sp[v2].j2), abs(sp[h1].j2 - sp[h2].j2)) <= min(
        sp[v1].j2 + sp[v2].j2, sp[h1].j2 + sp[h2].j2
    )

def en_denominator(inter, occ, holes, virtuals, floor=0.1):
    """Epstein-Nesbet gap: bare gap, spectator rearrangement, and the pair's own term."""
    gap = sum(inter.sp[h].spe for h in holes) - sum(
        inter.sp[v].spe for v in virtuals
    )
    for k in occ:
        if k in holes:
            continue
        gap += sum(inter.v_ms(h, k, h, k) for h in holes)
        gap -= sum(inter.v_ms(v, k, v, k) for v in virtuals)
    gap += inter.v_ms(holes[0], holes[1], holes[0], holes[1])
    gap -= inter.v_ms(virtuals[0], virtuals[1], virtuals[0], virtuals[1])
    return gap if abs(gap) >= floor else (floor if gap >= 0 else -floor)

def rank_pool(inter, occ, pool):
    """Sort by descending PT2 score; return (operator, coupling, first-order amplitude)."""
    ranked = []
    for op in pool:
        h1, h2, v1, v2 = op
        coupling = inter.v_ms(v1, v2, h1, h2)
        gap = en_denominator(inter, occ, (h1, h2), (v1, v2))
        ranked.append((coupling**2 / abs(gap), op, coupling, coupling / gap))
    ranked.sort(key=lambda row: (-row[0], row[1]))  # deterministic on ties
    return [
        (op, coupling, amplitude) for _, op, coupling, amplitude in ranked
    ]
Qubit-Anregungsblöcke
Unter der Jordan-Wigner-Abbildung wird ein teilchenzahlerhaltender -Anregungsoperator zu einer Summe von acht Pauli-Strings, von denen jeder eine Kette von -Operatoren zwischen den äußersten Indizes trägt. Die -Ketten erzwingen fermionische Antisymmetrie, und sie sind teuer: Eine Proton-Neutron- Anregung überspannt die Grenze zwischen den beiden Hälften des Registers und beinhaltet eine Paritätskette über diese Grenze hinweg.
Das Weglassen der -Ketten ergibt den Qubit-Anregungs-Operator von Yordanov et al. [5]. Der von diesem Operator vorbereitete Zustand hat andere Amplituden, verbindet aber genau dieselben Determinantenpaare, sodass die Menge der Determinanten, die der Circuit erreichen kann, unverändert bleibt. Pooled SQD verwendet diese Determinanten für die klassische Diagonalisierung. Schritt 2 vergleicht den Träger der beiden Konstruktionen und misst ihre Hardwarekosten.
Der Aufbau der Pauli-Form aus , wobei die -
Kette optional ist, hält die beiden Konstruktionen nur ein einziges Flag voneinander entfernt. Alle acht Terme eines Generators
kommutieren, sodass ein einzelner PauliEvolutionGate-Schritt das exakte Exponential ist und keine Trotter-
Näherung davon.
def _ladder(num_qubits, q, dagger, parity):
    """Pauli form of a_q or a_q^dagger.  `parity` toggles the Jordan-Wigner Z string."""
    prefix = (
        ["Z"] * q + ["I"] * (num_qubits - q) if parity else ["I"] * num_qubits
    )
    x_part, y_part = list(prefix), list(prefix)
    x_part[q], y_part[q] = "X", "Y"
    return SparsePauliOp(
        ["".join(reversed(x_part)), "".join(reversed(y_part))],
        coeffs=[0.5, 0.5 * (-1j if dagger else 1j)],
    )

def excitation_generator(num_qubits, op, parity=False):
    """Hermitian H with exp(-i theta H) = exp(theta (T - T^dagger)) for T = a+ a+ a a."""
    h1, h2, v1, v2 = op
    T = SparsePauliOp("I" * num_qubits)
    for q, dagger in ((v1, True), (v2, True), (h2, False), (h1, False)):
        T = (T @ _ladder(num_qubits, q, dagger, parity)).simplify()
    return (1j * (T - T.adjoint())).simplify()

def excitation_block(op, theta, parity=False):
    """(window, circuit) for one excitation.

    A qubit excitation touches only its four qubits.  A fermionic excitation also carries Z
    operators on every qubit between the outermost indices, so its window is the whole span --
    which is exactly where its extra cost comes from.
    """
    window = list(range(min(op), max(op) + 1)) if parity else sorted(op)
    local = tuple(window.index(i) for i in op)
    generator = excitation_generator(len(window), local, parity=parity)
    return window, PauliEvolutionGate(generator, time=theta).definition

def excitation_ansatz(
    num_qubits, occ, operators, amplitudes, measure=True, parity=False
):
    """X gates for the reference determinant, then one evolution block per excitation."""
    qc = QuantumCircuit(num_qubits)
    for q in occ:
        qc.x(q)
    for op, theta in zip(operators, amplitudes):
        if abs(theta) < 1e-12:
            continue
        window, block = excitation_block(op, theta, parity=parity)
        qc.compose(block, qubits=window, inplace=True)
    if measure:
        qc.measure_all()
    return qc
Das Tiefenbudget und das Circuit-Ensemble
Ein einzelner tiefer Circuit, der jede eingestufte Anregung enthält, kann die Kohärenzzeit der Hardware überschreiten. Das Verteilen des Pools auf ein Ensemble flacher Circuits und das Zusammenführen ihrer Shots zu einer Determinantenmenge macht aus Schritt 2 ein Packproblem: Jede Anregung hat gemessene Kosten, jeder Circuit hat ein Budget, und die Frage ist, wie viel vom eingestuften Pool hineinpasst.
Das Budget wird in Zwei-Qubit-Tiefe (Schichten von Zwei-Qubit-Gates auf dem kritischen Pfad) gemessen und nicht in einer rohen Gate-Zahl, weil die Tiefe die Dauer des Circuits bestimmt und damit, wie viel von der Kohärenz des Geräts er verbraucht. Die Gesamtzahl wird daneben angegeben, da sie der bessere Näherungswert für den akkumulierten Gate-Fehler ist; die beiden beantworten unterschiedliche Fragen, und keine ersetzt die andere.
Beide Größen werden anhand der Arität extrahiert: eine Instruktion, die auf genau zwei Qubits wirkt, wie auch immer das Backend sein verschränkendes Gate nennt. Ein Abgleich anhand von Gate-Namen könnte stattdessen null für einen unbekannten Basissatz zurückgeben, wodurch der gesamte Pool fälschlicherweise in einen Circuit gepackt würde, ohne das berechnete Budget zu überschreiten.
Das Füllen des jeweils leersten Circuits in Rangordnung hält jeden Circuit nahe am Budget. Kosten werden am realen Backend-Ziel gemessen, jeweils eine Anregung nach der anderen, weil eine an einem abstrakten Circuit abgelesene Kosten nicht die Kosten sind, die der Transpiler erzeugt.
DIRECTIVES = ("barrier", "delay")

def is_two_qubit(instruction):
    """True for an operation on exactly two qubits, excluding directives.

    Selecting by arity rather than by gate name keeps this correct on any backend, whatever its
    two-qubit basis gate happens to be called -- cz on today's Heron devices, ecr on Eagle, or
    something newer tomorrow.  A gate-name allow-list silently returns zero on anything it has
    not heard of, which would collapse the whole pool into one circuit and pass every budget
    check.  Barriers are excluded because a barrier spanning two qubits is not a gate.
    """
    return (
        len(instruction.qubits) == 2
        and instruction.operation.name not in DIRECTIVES
    )

def two_qubit_count(qc):
    """How many two-qubit gates the circuit contains: the accumulated-gate-error proxy."""
    return sum(1 for instruction in qc.data if is_two_qubit(instruction))

def two_qubit_depth(qc):
    """Layers of two-qubit gates on the critical path: the duration and decoherence proxy.

    This is what the budget is measured in.  Two gates on disjoint qubit pairs run in the same
    layer, so depth tracks how long the circuit takes -- and therefore how much coherence it
    spends -- while the count above tracks how much gate error it accumulates.  Both are
    reported; only depth is budgeted.
    """
    return qc.depth(filter_function=is_two_qubit)

def excitation_costs(num_qubits, ranked, pm, parity=False):
    """Transpiled two-qubit depth of each excitation on its own."""
    return [
        two_qubit_depth(
            pm.run(
                excitation_ansatz(
                    num_qubits, (), [op], [amp], measure=False, parity=parity
                )
            )
        )
        for op, _, amp in ranked
    ]

def pack_ensemble(
    num_qubits, occ, ranked, costs, budget, n_circuits, parity=False
):
    """Fill n_circuits in rank order, always adding to whichever is currently emptiest."""
    bins, loads = [[] for _ in range(n_circuits)], [0] * n_circuits
    for (op, _, amplitude), cost in zip(ranked, costs):
        emptiest = min(range(n_circuits), key=lambda b: loads[b])
        if loads[emptiest] + cost > budget:
            break  # every circuit is full
        bins[emptiest].append((op, amplitude))
        loads[emptiest] += cost
    circuits = [
        excitation_ansatz(
            num_qubits,
            occ,
            [o for o, _ in b],
            [a for _, a in b],
            parity=parity,
        )
        for b in bins
    ]
    return circuits, bins

def pack_to_budget(
    num_qubits, occ, ranked, costs, budget, n_circuits, pm, attempts=6
):
    """Pack, transpile, and shrink the target until the assembled circuits really fit.

    Costs are measured one excitation at a time, but excitations that share qubits neither add
    nor parallelize cleanly once the transpiler routes them together, so the assembled depth is
    not the sum of its measured parts.  This loop closes that gap against the real transpiler,
    and it runs entirely before any job is submitted -- a budget failure must never cost shots.
    """
    target = budget
    for attempt in range(attempts):
        circuits, bins = pack_ensemble(
            num_qubits, occ, ranked, costs, target, n_circuits, parity=False
        )
        isa = pm.run(circuits)
        worst = max(two_qubit_depth(c) for c in isa)
        if worst <= budget:
            return circuits, bins, isa
        target = max(min(costs), int(target * budget / worst * 0.95))
    raise RuntimeError(
        f"could not fit {n_circuits} circuits inside a two-qubit depth of {budget} in "
        f"{attempts} attempts; raise N_CIRCUITS or DEPTH_BUDGET and re-run this cell. "
        "No QPU time was spent."
    )
Nachverarbeitung: reparieren, rekombinieren, diagonalisieren
Drei Hilfsfunktionen erledigen die Arbeit von Schritt 4.
half_configurations teilt jede gesampelte Zeile in eine Protonenhälfte und eine Neutronenhälfte auf und behält jede
Hälfte, die die richtige Nukleonenzahl hat. Eine Zeile mit einer gültigen Protonenhälfte trägt diese Hälfte bei, selbst wenn ihre
Neutronenhälfte die falsche Nukleonenzahl hat. Jede Hälfte trägt das gesamte gesampelte Gewicht der Zeilen, in denen sie erschien, was
sie einstuft, falls der Unterraum gekürzt werden muss.
grow_subspace rekombiniert die Hälften zu jedem Produkt, das im Ziel-- und Paritätssektor landet,
und fügt dem gegebenen Unterraum hinzu, anstatt ihn neu aufzubauen. Das hält aufeinanderfolgende
Unterräume verschachtelt, was die Energiesequenz monoton nicht-steigend macht, anstatt lediglich
um eine Schranke zu schwanken.
recovery_loop ist die selbstkonsistente Konfigurationswiederherstellung des Pooled-SQD-Papers
[1]: Repariere die beiden Nukleonenzahlen der Registerhälften anhand der aktuellen Besetzungs-
schätzung, rekombiniere, diagonalisiere und übernimm die nächste Besetzungsschätzung aus dem Eigenvektor.
Überprüfe die Bit-Ordnungskonventionen sorgfältig, um falsche Ergebnisse zu vermeiden. qiskit-addon-sqd schreibt Spalte 0 seiner
Bitstring-Matrix als den höchsten Qubit-Index, sodass das Umkehren einer Zeile eine nach Qubit indizierte Besetzung ergibt;
ihre „rechte“ Hälfte sind die niedrigen Qubit-Indizes, was der Protonenblock ist. Entsprechend
nimmt recover_configurations num_elec_a als die Protonenzahl und durchschnittliche Besetzungen geordnet als
(protons, neutrons) nach Qubit-Index. Das Addon nimmt an, dass Bit mit Bit gepaart ist; in diesem
Register sind Protonen-Qubit und Neutronen-Qubit derselbe -Zustand, sodass die
Annahme hier physikalisch bedeutsam ist und nicht bloß zufällig.
def half_configurations(
    bitstring_matrix, probabilities, sp, n_protons, n_neutrons
):
    """Split each row into proton and neutron halves, keeping each half on its own weight.

    Column 0 of the addon's matrix is the highest qubit index, so reversing a row gives
    occupation indexed by qubit.
    """
    protons, neutrons = {}, {}
    for row, weight in zip(
        bitstring_matrix, np.asarray(probabilities, dtype=float)
    ):
        occupied = np.flatnonzero(row[::-1])
        p = tuple(int(i) for i in occupied if sp[i].tz == -1)
        n = tuple(int(i) for i in occupied if sp[i].tz == +1)
        if len(p) == n_protons:
            protons[p] = protons.get(p, 0.0) + weight
        if len(n) == n_neutrons:
            neutrons[n] = neutrons.get(n, 0.0) + weight
    return protons, neutrons

def product_subspace(sp, protons, neutrons, n_protons, n_neutrons, **targets):
    """Every (proton half) x (neutron half) product that lands in the target sector."""
    return sorted(
        d
        for d in (
            tuple(sorted(tuple(p) + tuple(n)))
            for p in protons
            for n in neutrons
        )
        if symmetry_allowed(sp, d, n_protons, n_neutrons, **targets)
    )

def grow_subspace(
    sp,
    kept_protons,
    kept_neutrons,
    offered_protons,
    offered_neutrons,
    n_protons,
    n_neutrons,
    max_dimension=None,
    **targets,
):
    """Add as many offered halves as the dimension cap allows, never dropping a kept one."""
    kept_p, kept_n = list(kept_protons), list(kept_neutrons)
    new_p = [c for c in offered_protons if c not in set(kept_p)]
    new_n = [c for c in offered_neutrons if c not in set(kept_n)]

    if max_dimension is None:
        kept_p, kept_n = kept_p + new_p, kept_n + new_n
        return (
            product_subspace(
                sp, kept_p, kept_n, n_protons, n_neutrons, **targets
            ),
            kept_p,
            kept_n,
        )

    basis = product_subspace(
        sp, kept_p, kept_n, n_protons, n_neutrons, **targets
    )
    step = max(1, (len(new_p) + len(new_n)) // 24)
    taken_p = taken_n = 0
    while taken_p < len(new_p) or taken_n < len(new_n):
        try_p, try_n = (
            min(taken_p + step, len(new_p)),
            min(taken_n + step, len(new_n)),
        )
        candidate = product_subspace(
            sp,
            kept_p + new_p[:try_p],
            kept_n + new_n[:try_n],
            n_protons,
            n_neutrons,
            **targets,
        )
        if len(candidate) > max_dimension:
            if step == 1:
                break
            step = max(1, step // 2)
            continue
        basis, taken_p, taken_n = candidate, try_p, try_n
    return basis, kept_p + new_p[:taken_p], kept_n + new_n[:taken_n]

def occupancies(sp, dets, vector):
    """Average occupancy of each qubit in a subspace eigenvector, as (protons, neutrons)."""
    half = len(sp) // 2
    occ = np.zeros(len(sp))
    for weight, det in zip(np.abs(vector) ** 2, dets):
        for q in det:
            occ[q] += weight
    return occ[:half], occ[half:]

def sample_occupancies(sp, bitstring_matrix, probabilities):
    """The same quantity estimated directly from sampled bitstrings."""
    half = len(sp) // 2
    weights = np.asarray(probabilities, dtype=float)
    occ = (weights[:, None] * bitstring_matrix[:, ::-1]).sum(
        axis=0
    ) / weights.sum()
    return occ[:half], occ[half:]
def recovery_loop(
    inter,
    sp,
    bitstring_matrix,
    probabilities,
    reference,
    n_protons,
    n_neutrons,
    max_iterations=4,
    energy_tol=1e-4,
    max_dimension=None,
    seed=None,
    **targets,
):
    """Self-consistent configuration recovery, diagonalizing in the product subspace.

    `num_elec_a` is the proton number and `num_elec_b` the neutron number, matching the
    addon's right/left bipartition of the bitstring matrix.
    """
    half = len(sp) // 2
    p_ref = tuple(i for i in reference if sp[i].tz == -1)
    n_ref = tuple(i for i in reference if sp[i].tz == +1)

    survivors, survivor_probs = postselect_by_hamming_right_and_left(
        bitstring_matrix,
        np.asarray(probabilities, dtype=float).copy(),
        hamming_right=n_protons,
        hamming_left=n_neutrons,
    )

    if len(survivors):
        guess = sample_occupancies(sp, survivors, survivor_probs)
    else:  # nothing survived: start from the reference itself
        guess = (
            np.array([1.0 if q in p_ref else 0.0 for q in range(half)]),
            np.array(
                [1.0 if q + half in n_ref else 0.0 for q in range(half)]
            ),
        )

    weights_p, weights_n = {p_ref: np.inf}, {n_ref: np.inf}
    kept_p, kept_n = [p_ref], [n_ref]
    history, best = [], None

    for iteration in range(max_iterations):
        # keep the occupancy estimate strictly inside (0, 1): the heuristic divides by it
        clipped = tuple(np.clip(a, 1e-4, 1.0 - 1e-4) for a in guess)
        recovered, recovered_probs = recover_configurations(
            bitstring_matrix,
            probabilities,
            clipped,
            n_protons,
            n_neutrons,
            rand_seed=None if seed is None else seed + iteration,
        )

        new_p, new_n = half_configurations(
            recovered, recovered_probs, sp, n_protons, n_neutrons
        )
        for config, weight in new_p.items():
            weights_p[config] = weights_p.get(config, 0.0) + weight
        for config, weight in new_n.items():
            weights_n[config] = weights_n.get(config, 0.0) + weight

        def order(w):
            return sorted(w, key=lambda c: (-w[c], c))

        basis, kept_p, kept_n = grow_subspace(
            sp,
            kept_p,
            kept_n,
            order(weights_p),
            order(weights_n),
            n_protons,
            n_neutrons,
            max_dimension=max_dimension,
            **targets,
        )
        energy, vector = ground_state(inter, basis)

        history.append(
            dict(
                iteration=iteration + 1,
                energy=energy,
                dimension=len(basis),
                protons=len(kept_p),
                neutrons=len(kept_n),
                recovered=len(recovered),
                survivors=len(survivors),
            )
        )
        print(
            f"  iteration {iteration + 1}: {len(kept_p)} proton x {len(kept_n)} neutron "
            f"halves -> dimension {len(basis)}, E = {energy:.6f} MeV"
        )

        if best is None or energy < best[0]:
            best = (energy, basis, vector)
            guess = occupancies(
                sp, basis, vector
            )  # the self-consistent update
        if (
            len(history) > 1
            and abs(history[-2]["energy"] - energy) < energy_tol
        ):
            break

    return dict(
        energy=best[0], basis=best[1], vector=best[2], history=history
    )
Backend, Budget und Laufparameter
Jeder folgende Lauf verwendet dasselbe Backend, dieselben Pass-Manager und dasselbe Tiefenbudget, sodass die drei direkt vergleichbar sind. Das Budget verbindet sie: Jeder Circuit in jedem Ensemble muss hineinpassen, und es entscheidet, wie viel von einem Pool überhaupt gesampelt werden kann.
Die hier verwendeten Werte wurden durch Messung der transpilierten Kosten gegenüber einem Heron-Ziel gewählt. Bei einer Zwei-Qubit-Tiefe von 300 und 16 Circuits liegen sowohl die 24-Qubit- als auch die 40-Qubit-Ensembles deutlich unter 100 Mikrosekunden pro Circuit, gegenüber Kohärenzzeiten von einigen hundert Mikrosekunden. Eine Erhöhung des Budgets bezieht mehr vom Pool ein, erhöht aber die Circuit-Dauer. Miss diesen Zielkonflikt für dein Backend.
# This example assumes you have saved your IBM Quantum Platform account locally.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=40
)

pass_manager = generate_preset_pass_manager(
    optimization_level=3, backend=backend, seed_transpiler=42
)
costing_manager = generate_preset_pass_manager(
    optimization_level=1, backend=backend, seed_transpiler=42
)

DEPTH_BUDGET = 300  # two-qubit depth per circuit
N_CIRCUITS = 16  # circuits per ensemble
SHOTS = 10_000  # shots per circuit
MAX_DIMENSION = 4_000  # largest subspace the dense solver here will build
JOB_TAGS = ["TUT_SBQDNH"]  # initials of the title's content words

# derive the two-qubit basis gate from the target by arity, not from a hard-coded name
two_qubit_basis = sorted(
    name
    for name in backend.target.operation_names
    if backend.target.operation_from_name(name).num_qubits == 2
)
if not two_qubit_basis:
    raise RuntimeError(
        f"{backend.name} exposes no two-qubit gate; pick another backend"
    )

print(
    f"{backend.name}: {backend.num_qubits} qubits, two-qubit basis gate {two_qubit_basis[0]}"
)
print(
    f"two-qubit depth budget {DEPTH_BUDGET}, {N_CIRCUITS} circuits x {SHOTS:,} shots per run"
)
print(
    f"three runs: {3 * N_CIRCUITS} circuits, {3 * N_CIRCUITS * SHOTS:,} shots in total"
)
ibm_phoenix: 120 qubits, two-qubit basis gate cz
two-qubit depth budget 300, 16 circuits x 10,000 shots per run
three runs: 48 circuits, 480,000 shots in total
Kleinmaßstäbliches Hardware-Beispiel
Dieser Abschnitt folgt dem vierstufigen Workflow auf einer QPU und verwendet dasselbe Backend und dasselbe Gate-Budget wie die großmaßstäblichen Läufe. Das kleinere Problem liefert eine exakte Referenz zur Überprüfung des Ergebnisses.
Das kleinmaßstäbliche Problem ist : zwei Valenzprotonen und zwei Valenzneutronen in der -Schale über einem -Kernrumpf, mit der USDA-Wechselwirkung [2]. Drei Orbitale pro Spezies ergeben 24 Qubits, und die vollständige symmetrieerlaubte Basis besteht aus 640 Determinanten, klein genug, um die Energieschätzungen mit der exakten Antwort zu vergleichen.
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Lies die Wechselwirkung ein, baue das Register auf und konstruiere die Referenzdeterminante. Die folgende Tabelle zeigt die Registerinformationen aus dem Hintergrund, direkt aus der Wechselwirkungsdatei gelesen.
N_PROTONS, N_NEUTRONS = 2, 2

ms_sd = read_snt(DATA / "usda.snt", N_PROTONS, N_NEUTRONS)
sp_sd = m_scheme_states(ms_sd)
inter_sd = Interaction(ms_sd, sp_sd)
occ_sd = reference_determinant(sp_sd, inter_sd, N_PROTONS, N_NEUTRONS)

# post-selection splits the register in half, so the two species must contribute equally
n_proton_states = sum(1 for s in sp_sd if s.tz == -1)
if n_proton_states != len(sp_sd) - n_proton_states:
    raise ValueError(
        "this workflow needs equal proton and neutron state counts"
    )

SHELL_LABEL = {0: "s", 1: "p", 2: "d", 3: "f", 4: "g"}
print(
    f"core Z={ms_sd.core_z} N={ms_sd.core_n} plus {N_PROTONS}p + {N_NEUTRONS}n valence "
    f"->  A={ms_sd.mass_number} on {len(sp_sd)} qubits"
)
print(
    f"interaction: {len(ms_sd.tbmes)} J-coupled matrix elements, fitted at "
    f"A_ref={ms_sd.a_ref}, rescaled by (A/A_ref)^{ms_sd.mass_exponent:g} = "
    f"{ms_sd.mass_factor:.6f}\n"
)

print(
    f"{'orbital':>9}  {'SPE (MeV)':>10}  {'proton qubits':>14}  {'neutron qubits':>15}"
)
for o in (o for o in ms_sd.orbitals if o.tz == -1):
    twin = next(
        t
        for t in ms_sd.orbitals
        if t.tz == +1 and (t.n, t.ell, t.j2) == (o.n, o.ell, o.j2)
    )
    qp = [q for q, s in enumerate(sp_sd) if s.orb == o.idx]
    qn = [q for q, s in enumerate(sp_sd) if s.orb == twin.idx]
    print(
        f"{f'{o.n}{SHELL_LABEL[o.ell]}{o.j2}/2':>9}  {ms_sd.spes[o.idx]:>10.4f}  "
        f"{f'{qp[0]}-{qp[-1]}':>14}  {f'{qn[0]}-{qn[-1]}':>15}"
    )

print(f"\nreference determinant occupies qubits {occ_sd}")
print(
    f"  M_J = {sum(sp_sd[i].mj2 for i in occ_sd) / 2:g}, "
    f"parity = {(-1) ** (sum(sp_sd[i].ell for i in occ_sd) % 2):+d}, "
    f"energy = {matrix_element(inter_sd, occ_sd, occ_sd):.6f} MeV"
)
core Z=8 N=8 plus 2p + 2n valence ->  A=20 on 24 qubits
interaction: 158 J-coupled matrix elements, fitted at A_ref=18, rescaled by (A/A_ref)^-0.3 = 0.968886

  orbital   SPE (MeV)   proton qubits   neutron qubits
    0d3/2      2.1117             0-3            12-15
    0d5/2     -3.9257             4-9            16-21
    1s1/2     -3.2079           10-11            22-23

reference determinant occupies qubits (4, 9, 16, 21)
  M_J = 0, parity = +1, energy = -29.765549 MeV
Führe zwei Überprüfungen des Hamiltonians durch, bevor du fortfährst. Beide sind kostengünstig und können Rückkopplungsfehler aufdecken, die eine einzelne Energieberechnung möglicherweise nicht erkennt.
Ein rotationsinvarianter Hamiltonian ordnet seine Eigenzustände in -Multipletts, sodass jeder Eigenwert des -Sektors auch im -Spektrum bei derselben Energie erscheinen muss. Die Lücke zwischen dem Grundzustand und dem niedrigsten Zustand mit ist die -Anregungs- energie, die gemessen wurde: MeV für [6]. Von einer empirischen -Schalen-Wechselwirkung wird erwartet, dass sie innerhalb weniger hundert keV übereinstimmt.
basis_exact_sd = full_basis(sp_sd, N_PROTONS, N_NEUTRONS)
if len(basis_exact_sd) != count_basis(sp_sd, N_PROTONS, N_NEUTRONS):
    raise AssertionError("the basis counter disagrees with the enumeration")
E_REF_SD = matrix_element(inter_sd, occ_sd, occ_sd)
E_EXACT_SD, _ = ground_state(inter_sd, basis_exact_sd)

# the M_J = 2 sector: its spectrum must be contained in the M_J = 0 spectrum
basis_mj2 = full_basis(sp_sd, N_PROTONS, N_NEUTRONS, mj2_target=4)
spectrum_0 = np.linalg.eigvalsh(
    subspace_hamiltonian(inter_sd, basis_exact_sd)
)
spectrum_2 = np.linalg.eigvalsh(subspace_hamiltonian(inter_sd, basis_mj2))
contained = sum(
    1 for e in spectrum_2 if np.min(np.abs(spectrum_0 - e)) < 1e-7
)
if contained != len(spectrum_2):
    raise AssertionError(
        f"rotational invariance broken: only {contained}/{len(spectrum_2)} "
        "M_J=2 eigenvalues appear in the M_J=0 spectrum"
    )

print(
    f"rotational invariance: all {contained} M_J=2 eigenvalues found in the M_J=0 spectrum"
)
print(
    f"E(2+) - E(0+) = {spectrum_2[0] - E_EXACT_SD:.3f} MeV     (experiment: 1.634 MeV)\n"
)
print(f"reference determinant       {E_REF_SD:11.6f} MeV")
print(
    f"exact diagonalization       {E_EXACT_SD:11.6f} MeV   (dimension {len(basis_exact_sd)})"
)
print(f"correlation energy to find  {E_EXACT_SD - E_REF_SD:11.6f} MeV")
rotational invariance: all 497 M_J=2 eigenvalues found in the M_J=0 spectrum
E(2+) - E(0+) = 1.747 MeV     (experiment: 1.634 MeV)

reference determinant        -29.765549 MeV
exact diagonalization        -40.472331 MeV   (dimension 640)
correlation energy to find   -10.706782 MeV
Als Nächstes konstruiere den Operatorpool. Das Anwenden der beiden Auswahlregeln liefert ein wichtiges Ergebnis: Für diese Referenz gibt es in diesem Modellraum überhaupt keine erlaubten Einzelanregungen.
Der Grund ist konkret und überprüfbar. Eine -Anregung erhält nur, wenn der Teilchenzustand dasselbe wie das Loch hat. Die Referenz besetzt die beiden Zustände mit dem größten im niedrigsten Orbital ( von ), und kein anderes Orbital in der -Schale erreicht , da bei und bei endet. Daher überlebt keine Einzelanregung, und die Korrelation wird vollständig von -Anregungen getragen. Dies ist eine Eigenschaft der Referenz und der Schale, kein allgemeines Gesetz; die folgende Zelle zählt es, statt es anzunehmen.
raw_pool_sd = excitation_pool(sp_sd, occ_sd)
pool_sd = [op for op in raw_pool_sd if conserves_symmetry(sp_sd, op)]
ranked_sd = rank_pool(inter_sd, occ_sd, pool_sd)

singles_sd = [
    (h, v)
    for h in occ_sd
    for v in range(len(sp_sd))
    if v not in occ_sd and sp_sd[h].tz == sp_sd[v].tz
]
singles_mj_sd = [
    (h, v) for h, v in singles_sd if sp_sd[h].mj2 == sp_sd[v].mj2
]

print(
    f"1p1h: {len(singles_sd):4d} raw  ->  {len(singles_mj_sd):3d} conserve M_J"
)
print(
    f"2p2h: {len(raw_pool_sd):4d} raw  ->  {len(pool_sd):3d} conserve M_J and couple to a common J\n"
)

print(
    f"{'rank':>4}  {'holes':>9}  {'particles':>11}  {'<ref|H|a> (MeV)':>16}  {'amplitude':>10}"
)
for r, (op, coupling, amplitude) in enumerate(ranked_sd[:8], start=1):
    print(
        f"{r:>4}  {f'{op[0]},{op[1]}':>9}  {f'{op[2]},{op[3]}':>11}  "
        f"{coupling:>16.4f}  {amplitude:>10.4f}"
    )

# what is the best this ansatz could possibly do?  Apply every excitation once and recombine.
reachable = {occ_sd}
for op, _, _ in ranked_sd:
    h1, h2, v1, v2 = op
    reachable |= {
        tuple(sorted(set(d) - {h1, h2} | {v1, v2}))
        for d in reachable
        if {h1, h2} <= set(d) and not {v1, v2} & set(d)
    }
ceiling = product_subspace(
    sp_sd,
    {tuple(i for i in d if sp_sd[i].tz == -1) for d in reachable},
    {tuple(i for i in d if sp_sd[i].tz == +1) for d in reachable},
    N_PROTONS,
    N_NEUTRONS,
)
print(
    f"\nthe pool reaches {len(reachable)} determinants, whose product subspace spans "
    f"{len(ceiling)} of {len(basis_exact_sd)}"
)
1p1h:   40 raw  ->    0 conserve M_J
2p2h:  490 raw  ->   78 conserve M_J and couple to a common J

rank      holes    particles   <ref|H|a> (MeV)   amplitude
   1        4,9          0,3           -1.8714      0.1375
   2      16,21        12,15           -1.8714      0.1375
   3       4,21         3,12            1.6775     -0.1029
   4       9,16         0,15            1.6775     -0.1029
   5        4,9        10,11           -0.8728      0.1168
   6      16,21        22,23           -0.8728      0.1168
   7       4,21         3,17            1.0622     -0.0882
   8       4,21         8,12           -1.0622      0.0882

the pool reaches 412 determinants, whose product subspace spans 640 of 640
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren
Die Transpilation zeigt die Hardwarekosten der Jordan-Wigner--Ketten und die Einsparungen durch die Verwendung von Qubit-Anregungen. Die erste Zelle misst beide Konstruktionen gegenüber dem realen Backend- Ziel und überprüft die im Setup eingeführte Behauptung, dass das Weglassen der -Ketten die Amplituden ändert, aber nicht die Menge der Determinanten, die der Circuit erreichen kann.
Vergleiche zwei Konsequenzen dieser Substitution. Eine Qubit-Anregung kostet unabhängig vom Abstand zwischen ihren Indizes dasselbe, sodass Proton-Neutron-Anregungen, die die Grenze zwischen den beiden Hälften des Registers überspannen und den Großteil des Pools ausmachen, diese zusätzlichen Kosten nicht mehr haben. Der gesamte Pool passt dann in das Budget, was bedeutet, dass die Grenze für das Ergebnis das Sampling ist und nicht die Circuit-Tiefe.
# 1. do the two constructions reach the same determinants?
# Apply one block to the reference on the window it spans and read off which basis states
# acquire amplitude.  Column 0 of the unitary is the image of |0...0>, and the X gates that
# place the reference are part of the circuit, so that column is exactly what is wanted.
# A fermionic block's window is its whole span, and building a unitary on it costs 4^n, so
# probe the narrowest excitations in the pool rather than the highest-ranked ones.
PROBE_SPAN = 12
narrow = sorted(ranked_sd, key=lambda row: max(row[0]) - min(row[0]))
probes = [op for op, _, _ in narrow if max(op) - min(op) + 1 <= PROBE_SPAN][
    :3
]
if len(probes) < 2:
    raise RuntimeError(
        f"no excitation spans {PROBE_SPAN} qubits or fewer; raise PROBE_SPAN"
    )

print(
    f"{'excitation':>16}  {'span':>5}  {'reachable determinants':>22}  {'same as fermionic?':>19}"
)
for probe_op in probes:
    probe_window = list(range(min(probe_op), max(probe_op) + 1))
    probe_local = tuple(probe_window.index(i) for i in probe_op)
    probe_occ = tuple(
        probe_window.index(i) for i in occ_sd if i in probe_window
    )

    supports = {}
    for parity in (True, False):
        unitary = Operator(
            excitation_ansatz(
                len(probe_window),
                probe_occ,
                [probe_local],
                [0.7],
                measure=False,
                parity=parity,
            )
        ).data
        supports[parity] = frozenset(
            np.flatnonzero(np.abs(unitary[:, 0]) > 1e-10).tolist()
        )

    if len(supports[True]) < 2:
        raise AssertionError(
            f"{probe_op}: the block did not move any amplitude, so this "
            "comparison would be vacuous"
        )
    if supports[True] != supports[False]:
        raise AssertionError(
            f"{probe_op}: the two constructions reach different determinants"
        )
    print(
        f"{str(probe_op):>16}  {len(probe_window):>5}  {len(supports[True]):>22}  {'yes':>19}"
    )

print(
    "\n-> identical support; the amplitudes differ, and pooled SQD only consumes the support\n"
)

# 2. what does each one cost on this backend?
cost_qeb = excitation_costs(
    len(sp_sd), ranked_sd, costing_manager, parity=False
)
cost_jw = excitation_costs(
    len(sp_sd), ranked_sd, costing_manager, parity=True
)

def species(op):
    return "same" if len({sp_sd[i].tz for i in op}) == 1 else "pn"

print(
    f"{'excitation':>10}  {'count':>5}  {'QEB 2q depth':>14}  {'fermionic 2q depth':>19}"
)
for group in ("same", "pn"):
    q = [
        c
        for (op, _, _), c in zip(ranked_sd, cost_qeb)
        if species(op) == group
    ]
    j = [
        c for (op, _, _), c in zip(ranked_sd, cost_jw) if species(op) == group
    ]
    print(
        f"{group:>10}  {len(q):>5}  {f'{min(q)}-{max(q)}':>14}  {f'{min(j)}-{max(j)}':>19}"
    )
print(
    f"{'pool total':>10}  {len(ranked_sd):>5}  {sum(cost_qeb):>14}  {sum(cost_jw):>19}"
)
print(
    f"\nfermionic / qubit-excitation cost ratio: {sum(cost_jw) / sum(cost_qeb):.2f}x"
)
print(
    f"\nensemble capacity: {N_CIRCUITS} circuits at two-qubit depth {DEPTH_BUDGET}"
)
excitation   span  reachable determinants   same as fermionic?
    (4, 9, 5, 8)      6                       2                  yes
(16, 21, 17, 20)      6                       2                  yes
    (4, 9, 6, 7)      6                       2                  yes

-> identical support; the amplitudes differ, and pooled SQD only consumes the support

excitation  count    QEB 2q depth   fermionic 2q depth
      same     26           40-48               48-144
        pn     52           48-48               48-256
pool total     78            3728                 9112

fermionic / qubit-excitation cost ratio: 2.44x

ensemble capacity: 16 circuits at two-qubit depth 300
circuits_sd, bins_sd, isa_sd = pack_to_budget(
    len(sp_sd),
    occ_sd,
    ranked_sd,
    cost_qeb,
    DEPTH_BUDGET,
    N_CIRCUITS,
    pass_manager,
)

PACKED_SD = sum(len(b) for b in bins_sd)
worst_sd = max(two_qubit_depth(c) for c in isa_sd)
worst_count_sd = max(two_qubit_count(c) for c in isa_sd)

print(
    f"packed {PACKED_SD} of {len(ranked_sd)} excitations into {N_CIRCUITS} circuits"
)
print(f"  excitations per circuit  {[len(b) for b in bins_sd]}")
print(f"  two-qubit depth          {[two_qubit_depth(c) for c in isa_sd]}")
print(f"  two-qubit gates          {[two_qubit_count(c) for c in isa_sd]}")
print(
    f"\nworst circuit: two-qubit depth {worst_sd} of a {DEPTH_BUDGET} budget, "
    f"{worst_count_sd} two-qubit gates"
)
packed 78 of 78 excitations into 16 circuits
  excitations per circuit  [5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 4, 4]
  two-qubit depth          [228, 182, 177, 220, 214, 220, 226, 224, 222, 222, 181, 179, 136, 179, 171, 181]
  two-qubit gates          [234, 231, 227, 228, 225, 225, 233, 229, 233, 226, 230, 223, 232, 226, 176, 185]

worst circuit: two-qubit depth 228 of a 300 budget, 234 two-qubit gates
Schritt 3: Ausführung mit Qiskit-Primitives
Reiche einen Job pro Problem ein, wobei das gesamte Ensemble als eine einzige Liste von Circuits übergeben wird. Gate- und Messwerttwirling sowie dynamische Entkopplung sind aktiviert, um die Auswirkungen von Hardware-Rauschen zu reduzieren. Ihr Nutzen hängt vom Circuit und Backend ab.
Die ID jedes Jobs wird ausgegeben. Verwende service.job("JOB_ID"), um den abgeschlossenen Job und seine
Ergebnisse abzurufen, ohne zusätzliche QPU-Zeit zu verwenden.
def sample(isa_circuits, shots, tags):
    """Submit one Sampler job; return the per-circuit bit arrays and the measured QPU seconds."""
    sampler = SamplerV2(mode=backend)
    sampler.options.environment.job_tags = tags
    sampler.options.twirling.enable_gates = True
    sampler.options.twirling.enable_measure = True
    sampler.options.dynamical_decoupling.enable = True
    sampler.options.dynamical_decoupling.sequence_type = "XY4"

    job = sampler.run(isa_circuits, shots=shots)
    print(
        f"job {job.job_id()}: {len(isa_circuits)} circuits x {shots:,} shots "
        f"on {backend.name}"
    )
    return [pub.data.meas for pub in job.result()]

def pool_samples(bit_arrays, sp):
    """Merge the ensemble's bit arrays into one bitstring matrix and probability vector."""
    matrices, weights, total = [], [], 0
    for bit_array in bit_arrays:
        matrix, probabilities = bit_array_to_arrays(bit_array)
        matrices.append(matrix)
        weights.append(probabilities * bit_array.num_shots)
        total += bit_array.num_shots
    counts = np.concatenate(weights)
    matrix = np.vstack(matrices)
    # the same bitstring can appear in more than one circuit; merge duplicate rows
    unique, inverse = np.unique(matrix, axis=0, return_inverse=True)
    merged = np.zeros(len(unique))
    np.add.at(merged, inverse.ravel(), counts)
    return unique, merged / merged.sum(), total
bit_arrays_sd = sample(isa_sd, SHOTS, JOB_TAGS + ["20Ne"])
matrix_sd, probs_sd, shots_sd = pool_samples(bit_arrays_sd, sp_sd)

survivors_sd, _ = postselect_by_hamming_right_and_left(
    matrix_sd,
    probs_sd.copy(),
    hamming_right=N_PROTONS,
    hamming_left=N_NEUTRONS,
)
shot_survival_sd = float(
    probs_sd[
        (matrix_sd[:, len(sp_sd) // 2 :].sum(axis=1) == N_PROTONS)
        & (matrix_sd[:, : len(sp_sd) // 2].sum(axis=1) == N_NEUTRONS)
    ].sum()
)

reference_bits = "".join(
    "1" if q in occ_sd else "0" for q in range(len(sp_sd))
)[::-1]
print(f"\n{shots_sd:,} shots  ->  {len(matrix_sd):,} distinct bitstrings")
print(
    f"  {shot_survival_sd:6.1%} of shots carry the right proton and neutron numbers"
)
print(f"  {len(survivors_sd):,} distinct bitstrings do")

order = np.argsort(-probs_sd)
half = len(sp_sd) // 2
print(f"\n{'neutrons':>{half}} | {'protons':<{half}}   share")
for i in order[:4]:
    bits = "".join("1" if b else "0" for b in matrix_sd[i])
    tag = "   <- reference determinant" if bits == reference_bits else ""
    print(f"{bits[:half]} | {bits[half:]}  {probs_sd[i]:6.2%}{tag}")

if len(survivors_sd) == 0:
    raise RuntimeError(
        "no shot carried the right nucleon numbers; check the backend and "
        "the transpiled circuits before spending more QPU time"
    )
job dap30qtr85ps73fg21p0: 16 circuits x 10,000 shots on ibm_phoenix

160,000 shots  ->  17,221 distinct bitstrings
   31.5% of shots carry the right proton and neutron numbers
  973 distinct bitstrings do

    neutrons | protons        share
001000010000 | 001000010000  20.08%   <- reference determinant
000000010000 | 001000010000   2.25%
001000010000 | 001000000000   2.19%
001000010000 | 000000010000   1.93%
Schritt 4: Nachverarbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
Wandle die Quanten-Samples anhand der im Abschnitt Background beschriebenen Kern-Symmetrie-Beschränkungen in eine Energieabschätzung um.
Die Konfigurationswiederherstellung repariert die beiden Nukleonenzahlen. recover_configurations nimmt jeden Shot, der die falsche Anzahl an Protonen oder Neutronen hat, und kippt die Bits, die am wenigsten mit der aktuellen Schätzung der durchschnittlichen Orbitalbesetzungen übereinstimmen, anstatt ihn zu verwerfen. Im ersten Durchlauf stammt die Besetzungsschätzung von den Shots, die bereits überlebt haben; danach stammt sie vom Eigenvektor des vorherigen Unterraums, was das Verfahren selbstkonsistent macht.
und die Parität werden den rekombinierten Produkten auferlegt, nicht ganzen Shots. Jeder reparierte Shot trägt eine Protonenhälfte und eine Neutronenhälfte bei, und der Unterraum wird von jedem Produkt einer gesampelten Protonenkonfiguration mit einer gesampelten Neutronenkonfiguration aufgespannt, das bei mit der richtigen Parität landet. Würde man stattdessen ganze Shots nach dem Gesamt- filtern, würde man zwei gute Hälften wegen einer Quantenzahl verwerfen, die zu ihrer Kombination gehört.
Die vier Quantenzahl-Prüfungen verwerfen unterschiedliche Anteile der Samples. Die beiden Nukleonenzahlen sind für den Großteil der Filterung verantwortlich. Die Parität ist innerhalb einer einzelnen Hauptschale automatisch erfüllt: Jedes -Orbital hat gerades und jedes -Orbital ungerades , sodass die Parität nicht falsch sein kann, sobald die Nukleonenzahlen stimmen. Die Paritätsprüfung wird beibehalten, weil ein schalenübergreifender Modellraum sie zu einer unabhängigen Beschränkung machen würde. Die -Prüfung hält Produkte im angestrebten Drehimpulssektor. Der Wert von vier exakten Quantenzahlen liegt darin, dass sie billig und exakt sind, nicht darin, dass jede einzelne ein großer Filter ist.
Die Diagonalisierung liefert eine variationelle obere Schranke. Da der Unterraum jeder Iteration den vorherigen enthält, fällt die Folge der Energien monoton, und jeder Eintrag darin ist eine strenge obere Schranke für die wahre Grundzustandsenergie, unabhängig vom Rauschen in den Samples, die sie erzeugt haben.
result_sd = recovery_loop(
    inter_sd,
    sp_sd,
    matrix_sd,
    probs_sd,
    occ_sd,
    N_PROTONS,
    N_NEUTRONS,
    max_iterations=4,
    max_dimension=MAX_DIMENSION,
    seed=42,
)

E_SQD_SD = result_sd["energy"]
recovered_sd = 100 * (E_SQD_SD - E_REF_SD) / (E_EXACT_SD - E_REF_SD)

print(f"\nreference determinant   {E_REF_SD:11.6f} MeV")
print(
    f"pooled SQD upper bound         {E_SQD_SD:11.6f} MeV   "
    f"(subspace dimension {len(result_sd['basis'])} of {len(basis_exact_sd)})"
)
print(f"exact diagonalization   {E_EXACT_SD:11.6f} MeV")
print(f"\ncorrelation energy recovered: {recovered_sd:.1f}%")

energies_sd = [h["energy"] for h in result_sd["history"]]
if any(b > a + 1e-9 for a, b in zip(energies_sd, energies_sd[1:])):
    raise AssertionError(
        "the subspaces are not nested; the bound should never rise"
    )
if E_SQD_SD < E_EXACT_SD - 1e-7:
    raise AssertionError(
        f"pooled SQD returned {E_SQD_SD:.6f}, below the exact {E_EXACT_SD:.6f}; "
        "a subspace bound cannot beat the full diagonalization"
    )
iteration 1: 66 proton x 66 neutron halves -> dimension 640, E = -40.472331 MeV
  iteration 2: 66 proton x 66 neutron halves -> dimension 640, E = -40.472331 MeV

reference determinant    -29.765549 MeV
pooled SQD upper bound          -40.472331 MeV   (subspace dimension 640 of 640)
exact diagonalization    -40.472331 MeV

correlation energy recovered: 100.0%
Ergebnisse auswerten
Verwende die folgenden Prüfungen, um deine Ergebnisse auf einem Backend der Heron-Klasse mit diesen Einstellungen auszuwerten:
-
Das Shot-Überleben bei den beiden Nukleonenzahlen misst den Anteil der Shots mit der korrekten Protonen- und Neutronenzahl. Es kann sinken, wenn das Register wächst. Eine Überlebensrate nahe null kann auf ein Problem bei der Circuit-Ausführung hinweisen. Überprüfe die ISA-Tiefe in Schritt 2 und die Kalibrierung des Backends, nicht die Nachverarbeitung.
-
Die Wiederherstellungsschleife sollte eine Unterraumdimension ausgeben, die konstant bleibt oder wächst, und eine Energie, die mit jeder Iteration konstant bleibt oder fällt. Wenn Iteration 1 bereits
MAX_DIMENSIONerreicht, ist der klassische Solver und nicht das Sampling die bindende Einschränkung. -
Der wiederhergestellte Anteil für sollte hoch sein, weil die in Schritt 1 berechnete Ansatz-Obergrenze der vollständige 640-Determinanten-Raum ist; in diesem Durchlauf ist das Sampling, nicht die Ausdrucksstärke, das einzige Hindernis.
-
Die beiden Assertions in der vorangehenden Zelle prüfen die variationellen Schranken. Eine steigende Schranke bedeutet, dass die Unterräume nicht mehr geschachtelt sind, und eine Schranke unterhalb der exakten Energie bedeutet, dass etwas mit dem Hamiltonian nicht stimmt, nicht mit der Hardware.
Kontraintuitiv kann ein verrauschteres Backend eine etwas bessere Schranke liefern als ein sauberes, weil Fehler gültige Halbkonfigurationen erzeugen, die der ideale Circuit nie gesampelt hätte, und weil das Erweitern eines variationellen Unterraums dessen niedrigsten Eigenwert nicht erhöhen kann. Verrauschte Simulation kann denselben Effekt zeigen; dieses Tutorial zeigt ihn mit Hardware-Samples.
# IBM Carbon palette: Blue 60 and Blue 80 for data, Gray 100/70/30 for ink and rules
SURFACE, INK, MUTED, RULE = "#ffffff", "#161616", "#6f6f6f", "#c6c6c6"
SERIES, DEEP, PURPLE = "#0f62fe", "#002d9c", "#6929c4"

def convergence_plot(
    history, e_ref, e_exact, title, colour=SERIES, full_dim=None
):
    """Energy against subspace dimension, scaled to the data rather than to the full window.

    A good run lands within a fraction of a percent of the exact answer, so an axis spanning
    reference-to-exact would squash every point onto one line.  The axis is therefore scaled to
    the data (plus the exact line, when there is one), and the right-hand axis carries the
    fraction of the correlation energy so the absolute and relative readings sit side by side.
    """
    dimensions = [h["dimension"] for h in history]
    energies = [h["energy"] for h in history]

    fig, ax = plt.subplots(figsize=(7.4, 4.3), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    ax.plot(
        dimensions,
        energies,
        "-o",
        color=colour,
        linewidth=2,
        markersize=8,
        markeredgecolor=SURFACE,
        markeredgewidth=1.5,
        zorder=3,
    )
    stacked = {}
    for h in history:
        # a converged loop repeats the same point; stack the labels so they do not overprint
        key = (round(h["dimension"]), round(h["energy"], 9))
        offset = 12 + 11 * stacked.get(key, 0)
        stacked[key] = stacked.get(key, 0) + 1
        ax.annotate(
            str(h["iteration"]),
            xy=(h["dimension"], h["energy"]),
            xytext=(0, offset),
            textcoords="offset points",
            ha="center",
            fontsize=8,
            color=MUTED,
        )

    span = (max(dimensions) - min(dimensions)) or max(1, max(dimensions) // 4)
    x_left, x_right = (
        min(dimensions) - 0.14 * span,
        max(dimensions) + 0.40 * span,
    )
    ax.set_xlim(x_left, x_right)

    floor = min(energies) if e_exact is None else min(min(energies), e_exact)
    height = max(max(energies) - floor, 1e-3)
    ax.set_ylim(floor - 0.30 * height, max(energies) + 0.42 * height)

    if e_exact is not None:
        ax.axhline(
            e_exact, color=MUTED, linestyle="--", linewidth=1, zorder=1
        )
        label = "exact" + (f", {full_dim:,} determinants" if full_dim else "")
        ax.annotate(
            f"{label}   {e_exact:.3f} MeV".replace("-", "\u2212"),
            xy=(x_left, e_exact),
            xytext=(3, 5),
            textcoords="offset points",
            ha="left",
            va="bottom",
            color=MUTED,
            fontsize=9,
        )

    # the reference determinant is far off this scale; state it rather than plotting it
    ax.annotate(
        f"reference determinant {e_ref:.3f} MeV".replace("-", "\u2212")
        + f"   ({e_ref - max(energies):+.2f} MeV off the top of this axis)".replace(
            "-", "\u2212"
        ),
        xy=(x_right, max(energies) + 0.42 * height),
        xytext=(-3, -12),
        textcoords="offset points",
        ha="right",
        va="top",
        color=MUTED,
        fontsize=8.5,
    )

    if e_exact is not None and abs(e_exact - e_ref) > 1e-9:
        right = ax.twinx()
        low, high = ax.get_ylim()

        def to_percent(e):
            return 100 * (e - e_ref) / (e_exact - e_ref)

        right.set_ylim(to_percent(low), to_percent(high))
        right.set_ylabel("correlation energy recovered (%)", color=MUTED)
        right.tick_params(colors=MUTED)
        for side in ("top", "left"):
            right.spines[side].set_visible(False)
        right.spines["right"].set_color(MUTED)
        right.spines["bottom"].set_color(MUTED)

    ax.set_xlabel("subspace dimension", color=MUTED)
    ax.set_ylabel("ground-state energy (MeV)", color=MUTED)
    ax.set_title(title, color=INK, fontsize=11.5, loc="left", pad=12)
    ax.grid(axis="y", color=RULE, alpha=0.55)
    ax.tick_params(colors=MUTED)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("bottom", "left"):
        ax.spines[side].set_color(MUTED)
    fig.tight_layout()
    return fig

convergence_plot(
    result_sd["history"],
    E_REF_SD,
    E_EXACT_SD,
    f"$^{{20}}$Ne: the bound falls as configuration recovery widens the subspace\n"
    f"({backend.name}, {N_CIRCUITS} circuits x {SHOTS:,} shots)",
    full_dim=len(basis_exact_sd),
)
plt.show()
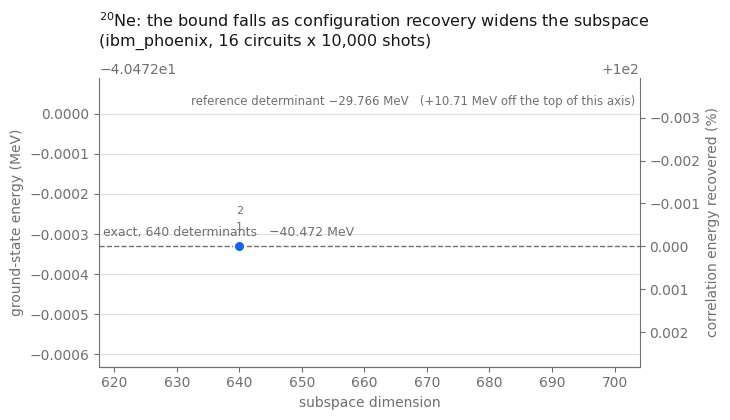
Großmaßstäbliches Hardware-Beispiel
Das Hochskalieren ändert nur die Eingaben, daher besteht der nächste Schritt darin, die vier Stufen in einer Funktion zu kombinieren und sie zweimal auszuführen, beide Male auf einem 40-Qubit-Register in der -Schale über einem -Kern mit der GXPF1-Wechselwirkung [3].
Die beiden Durchläufe veranschaulichen unterschiedliche Aspekte der Skalierung:
-
mit zwei Valenzprotonen und zwei Valenzneutronen hat eine Basis aus 4.000 Determinanten. Das Register umfasst 40 Qubits, aber das Problem ist noch klein genug, um es auf einem Laptop exakt zu diagonalisieren, sodass du das Hardware-Ergebnis nach der Vergrößerung des Registers mit einer exakten Referenz vergleichen kannst.
-
mit vier Valenzprotonen und vier Valenzneutronen hat 1.963.461 symmetrieerlaubte Determinanten in denselben 40 Qubits. Der dichte Solver des Tutorials kann diesen vollständigen Raum nicht diagonalisieren, daher liefert der Durchlauf eine strenge obere Schranke und die Referenzdeterminante, die sie verbessert.
Achte auf zwei Größen über die beiden Durchläufe hinweg. Der Anteil des Pools, der in das feste Gate-Budget passt, schrumpft, während der Pool wächst, und pack_ensemble meldet, wie viel davon einbezogen wird. Der Unterraum wird nicht mehr durch das Sampling begrenzt, sondern durch MAX_DIMENSION, die größte Matrix, die der dichte klassische Solver hier aufbaut. In diesem Maßstab würde eine Produktionsberechnung einen Solver für selected configuration interaction (selected-CI) verwenden.
Schritte 1–4 kombinieren
Die folgende Funktion ruft dieselben Stufen wie im Walkthrough auf, in derselben Reihenfolge.
def sqd_run(snt_file, n_protons, n_neutrons, name, exact=True):
    """The whole workflow for one nucleus.  Returns a record of every stage."""
    # -------------------------Step 1-------------------------
    ms = read_snt(DATA / snt_file, n_protons, n_neutrons)
    sp = m_scheme_states(ms)
    inter = Interaction(ms, sp)
    if sum(1 for s in sp if s.tz == -1) * 2 != len(sp):
        raise ValueError(
            f"{name}: post-selection needs equal proton and neutron state counts"
        )
    reference = reference_determinant(sp, inter, n_protons, n_neutrons)
    e_ref = matrix_element(inter, reference, reference)

    raw = excitation_pool(sp, reference)
    ranked = rank_pool(
        inter, reference, [op for op in raw if conserves_symmetry(sp, op)]
    )
    print(
        f"{name}: {len(sp)} qubits, {n_protons}p + {n_neutrons}n, A = {ms.mass_number}"
    )
    print(
        f"  2p2h pool {len(raw)} raw -> {len(ranked)} symmetry-allowed; "
        f"reference energy {e_ref:.6f} MeV"
    )

    # -------------------------Step 2-------------------------
    costs = excitation_costs(len(sp), ranked, costing_manager)
    circuits, bins, isa = pack_to_budget(
        len(sp),
        reference,
        ranked,
        costs,
        DEPTH_BUDGET,
        N_CIRCUITS,
        pass_manager,
    )
    packed = sum(len(b) for b in bins)
    worst = max(two_qubit_depth(c) for c in isa)
    worst_count = max(two_qubit_count(c) for c in isa)
    print(
        f"  packed {packed} of {len(ranked)} excitations; worst circuit two-qubit depth "
        f"{worst}, {worst_count} two-qubit gates"
    )

    # -------------------------Step 3-------------------------
    # a unique tag per run, so the jobs are findable later
    bit_arrays = sample(isa, SHOTS, JOB_TAGS + [name])
    matrix, probabilities, shots = pool_samples(bit_arrays, sp)
    survival = float(
        probabilities[
            (matrix[:, len(sp) // 2 :].sum(axis=1) == n_protons)
            & (matrix[:, : len(sp) // 2].sum(axis=1) == n_neutrons)
        ].sum()
    )
    print(
        f"  {shots:,} shots -> {len(matrix):,} distinct bitstrings, "
        f"{survival:.1%} of shots with the right nucleon numbers"
    )
    if survival == 0.0:
        raise RuntimeError(
            f"{name}: no shot carried the right nucleon numbers"
        )

    # -------------------------Step 4-------------------------
    result = recovery_loop(
        inter,
        sp,
        matrix,
        probabilities,
        reference,
        n_protons,
        n_neutrons,
        max_iterations=4,
        max_dimension=MAX_DIMENSION,
        seed=42,
    )
    energy = result["energy"]

    full_dim = count_basis(sp, n_protons, n_neutrons)  # cheap, even when huge
    e_exact = None
    if exact:
        full = full_basis(sp, n_protons, n_neutrons)
        if len(full) != full_dim:
            raise AssertionError(
                f"{name}: counted {full_dim} determinants but enumerated "
                f"{len(full)}"
            )
        e_exact, _ = ground_state(inter, full)

    print(f"  reference {e_ref:11.6f} MeV     pooled SQD {energy:11.6f} MeV")
    if e_exact is not None:
        print(
            f"  exact     {e_exact:11.6f} MeV  (dimension {full_dim})  ->  "
            f"{100 * (energy - e_ref) / (e_exact - e_ref):.1f}% of the correlation energy"
        )
        if energy < e_exact - 1e-7:
            raise AssertionError(
                f"{name}: pooled SQD bound is below the exact energy"
            )
    else:
        print(
            f"  no exact reference: the symmetry-allowed basis is {full_dim:,} determinants"
        )
        print(
            f"  the bound captures {energy - e_ref:.6f} MeV of correlation energy"
        )
    print()

    return dict(
        name=name,
        qubits=len(sp),
        pool=len(ranked),
        packed=packed,
        two_qubit=worst,
        two_qubit_gates=worst_count,
        shots=shots,
        distinct=len(matrix),
        survival=survival,
        dimension=len(result["basis"]),
        full_dim=full_dim,
        e_ref=e_ref,
        e_sqd=energy,
        e_exact=e_exact,
        history=result["history"],
        # the subspace and its eigenvector cannot be reconstructed from the summary --
        # they depend on the sampled shots -- so keep them for the scaling analysis
        interaction=inter,
        states=sp,
        reference=reference,
        ranked=ranked,
        basis=result["basis"],
        vector=result["vector"],
    )

pretty = {"20Ne": "$^{20}$Ne", "44Ti": "$^{44}$Ti", "48Cr": "$^{48}$Cr"}

small_scale = dict(
    name="20Ne",
    qubits=len(sp_sd),
    pool=len(ranked_sd),
    packed=PACKED_SD,
    two_qubit=worst_sd,
    two_qubit_gates=worst_count_sd,
    shots=shots_sd,
    distinct=len(matrix_sd),
    survival=shot_survival_sd,
    dimension=len(result_sd["basis"]),
    full_dim=len(basis_exact_sd),
    e_ref=E_REF_SD,
    e_sqd=E_SQD_SD,
    e_exact=E_EXACT_SD,
    history=result_sd["history"],
    interaction=inter_sd,
    states=sp_sd,
    reference=occ_sd,
    ranked=ranked_sd,
    basis=result_sd["basis"],
    vector=result_sd["vector"],
)
: derselbe Workflow auf einem 40-Qubit-Register
Die -Schale über hat vier Orbitale pro Spezies und jeweils 20 magnetische Unterzustände, sodass das Register 40 Qubits umfasst. Zwei Valenzprotonen und zwei Valenzneutronen ergeben mit 4.000 symmetrieerlaubten Determinanten — etwa das Sechsfache der -Basis, bei Verwendung von 40 statt 24 Qubits.
Dies ist das größere der beiden Beispiele, die das Notebook exakt lösen kann, sodass du das Hardware-Ergebnis mit einer exakten Referenz vergleichen kannst.
large_scale_verified = sqd_run("gxpf1.snt", 2, 2, "44Ti", exact=True)
44Ti: 40 qubits, 2p + 2n, A = 44
  2p2h pool 1602 raw -> 174 symmetry-allowed; reference energy -44.309387 MeV
  packed 96 of 174 excitations; worst circuit two-qubit depth 272, 285 two-qubit gates
job dap31a02fm4c73f67dp0: 16 circuits x 10,000 shots on ibm_phoenix
  160,000 shots -> 48,170 distinct bitstrings, 18.6% of shots with the right nucleon numbers
  iteration 1: 187 proton x 189 neutron halves -> dimension 3891, E = -47.849086 MeV
  iteration 2: 190 proton x 190 neutron halves -> dimension 4000, E = -47.876666 MeV
  iteration 3: 190 proton x 190 neutron halves -> dimension 4000, E = -47.876666 MeV
  reference  -44.309387 MeV     pooled SQD  -47.876666 MeV
  exact      -47.876666 MeV  (dimension 4000)  ->  100.0% of the correlation energy
: jenseits der exakten Diagonalisierungskapazität des Tutorials
Das Hinzufügen von zwei Protonen und zwei Neutronen nutzt dasselbe 40-Qubit-Register (4, 4 für ) und vergrößert die Basisgröße um einen Faktor von etwa 491 auf 1.963.461 symmetrieerlaubte Determinanten. Diese Matrix liegt weit jenseits von allem, was dieses Tutorial aufbauen wird, daher exact=False: Es gibt keine exakte Referenzenergie, nur die variationelle Schranke und die Referenzdeterminante, die sie verbessert.
Zwei Dinge ändern sich in diesem Maßstab, und beide sind in der Ausgabe sichtbar. Der Pool wächst auf mehrere Hundert erlaubte Anregungen an, sodass das feste Gate-Budget nun nur einen Bruchteil davon abdeckt statt alles. Außerdem ist der Produkt-Unterraum, den die Samples aufspannen, größer als MAX_DIMENSION, sodass der dichte Solver ihn nach gesampeltem Gewicht abschneidet. Die Schranke bleibt streng, kann aber weniger genau sein als eine Schranke, die aus allen gesampelten Konfigurationen berechnet wird. Eine Produktionsberechnung würde die Samples behalten und einen Solver verwenden, der einen größeren Unterraum unterstützt.
large_scale_unverified = sqd_run("gxpf1.snt", 4, 4, "48Cr", exact=False)
48Cr: 40 qubits, 4p + 4n, A = 48
  2p2h pool 5536 raw -> 582 symmetry-allowed; reference energy -93.041237 MeV
  packed 96 of 582 excitations; worst circuit two-qubit depth 224, 279 two-qubit gates
job dap32a02fm4c73f67eog: 16 circuits x 10,000 shots on ibm_phoenix
  160,000 shots -> 55,436 distinct bitstrings, 18.6% of shots with the right nucleon numbers
  iteration 1: 223 proton x 223 neutron halves -> dimension 3977, E = -96.481598 MeV
  iteration 2: 223 proton x 223 neutron halves -> dimension 3977, E = -96.481598 MeV
  reference  -93.041237 MeV     pooled SQD  -96.481598 MeV
  no exact reference: the symmetry-allowed basis is 1,963,461 determinants
  the bound captures -3.440361 MeV of correlation energy
Ein Ergebnis ohne exakte Referenz auswerten
Der -Durchlauf hat innerhalb dieses Tutorials keine exakte Referenz. Verwende die vorhandenen Samples, um die Konvergenz zu beurteilen und mit der klassischen Auswahl-Baseline zu vergleichen, ohne zusätzliche QPU-Zeit oder Diagonalisierung des vollständigen Raums.
Ist es konvergiert? Ordne die beibehaltenen Determinanten nach ihrem Gewicht im konvergierten Eigenvektor neu, dann werden die Unterräume geschachtelt, sodass das Diagonalisieren des führenden -Blocks für eine Leiter von den Abstieg der Schranke über zwei Größenordnungen der Unterraumgröße nachzeichnet. Wenn sie beim größten noch steil abfällt, ist die Dimensionsobergrenze des klassischen Solvers die bindende Einschränkung, und MAX_DIMENSION ist der Parameter, den man erhöhen sollte. Wenn sie sich abgeflacht hat, bringt das Hinzufügen weiterer beibehaltener Determinanten kaum Verbesserung; weiterer Fortschritt erfordert möglicherweise das Sampling zusätzlicher Konfigurationen. Der Hamiltonian wird einmal in voller Größe aufgebaut, und jede Sprosse ist ein Hauptblock davon, sodass der gesamte Durchlauf einen Matrixaufbau kostet statt einen pro Sprosse.
Wie schneidet Quanten-Sampling im Vergleich zur klassischen Auswahl ab? Vergleiche mit einem Unterraum derselben Größe, der durch das klassische Auswahlverfahren gewählt wurde: Nimm den nach Störungstheorie in Score-Reihenfolge gerankten Pool, lasse den Produkt-Unterraum auf dieselbe Dimension wachsen und diagonalisiere stattdessen diesen. Beide Kurven sind strenge obere Schranken für denselben Hamiltonian, daher hat diejenige, die bei gleicher Dimension niedriger liegt, die besseren Determinanten gewählt. Dieser Vergleich entscheidet, ob das Hardware-Sampling die Energieabschätzung im Vergleich zu dieser klassischen Baseline verbessert.
Dieser Unterraum ist nicht für angeregte Zustände ausgewählt. Die Konfigurationswiederherstellung steuert den Unterraum anhand der Besetzungen des Grundzustands, sodass die höheren Eigenwerte viel weiter von der Konvergenz entfernt sind als der niedrigste, und die erste Anregungsenergie fällt deutlich höher aus als der gemessene -Wert. Um angeregte Zustände richtig zu erreichen, braucht man einen Unterraum, der für sie ausgewählt wurde.
def subspace_scaling(
    inter, basis, vector, points=18, smallest=32, largest=None
):
    """Nested Rayleigh-Ritz sweep: the lowest eigenvalue of the leading d x d block, for a ladder of d.

    Reordering the basis by descending weight in the converged eigenvector makes every subspace in
    the ladder a subset of the next, so the energies fall monotonically and each one is a valid
    variational bound.  H is built once at full size; each rung is a principal block.
    """
    order = np.argsort(-(np.abs(vector) ** 2))
    ordered = [basis[i] for i in order]
    weights = (np.abs(vector) ** 2)[order]
    if (
        largest is not None
    ):  # cap the ladder so two subspaces end at a common dimension
        ordered, weights = ordered[:largest], weights[:largest]
    H = subspace_hamiltonian(inter, ordered)
    dimensions = np.unique(
        np.geomspace(smallest, len(ordered), points).astype(int)
    )
    rows = [
        (
            int(d),
            float(
                eigh(H[:d, :d], eigvals_only=True, subset_by_index=[0, 0])[0]
            ),
        )
        for d in dimensions
    ]
    return rows, np.cumsum(weights)

def classical_selection(
    inter, sp, reference, ranked, target, n_protons, n_neutrons
):
    """The subspace classical perturbative ranking would pick, grown to `target` dimension.

    Same product construction as the sampled subspace, and the same truncation discipline -- half
    configurations are offered to `grow_subspace` in order of importance and it takes as many as
    fit.  The only difference from the sampled path is where the ordering comes from: PT2 score
    here, measured sampling weight there.  So the comparison isolates *which determinants got
    chosen* and nothing else.

    Truncating by any other rule would not be a fair baseline.  Slicing an arbitrarily ordered
    list, for instance, keeps determinants by accident rather than by importance and makes the
    classical subspace look worse than classical selection really is.
    """
    p_ref = tuple(i for i in reference if sp[i].tz == -1)
    n_ref = tuple(i for i in reference if sp[i].tz == +1)
    reached = {reference}
    proton_order, neutron_order = [p_ref], [n_ref]
    seen_p, seen_n = {p_ref}, {n_ref}
    product_budget = 4 * target

    for op, _, _ in ranked:  # ranked is already in descending PT2 score
        h1, h2, v1, v2 = op
        fresh = {
            tuple(sorted(set(d) - {h1, h2} | {v1, v2}))
            for d in reached
            if {h1, h2} <= set(d) and not {v1, v2} & set(d)
        }
        reached |= fresh
        for det in fresh:  # first appearance fixes a half's rank
            half_p = tuple(i for i in det if sp[i].tz == -1)
            half_n = tuple(i for i in det if sp[i].tz == +1)
            if half_p not in seen_p:
                seen_p.add(half_p)
                proton_order.append(half_p)
            if half_n not in seen_n:
                seen_n.add(half_n)
                neutron_order.append(half_n)
        if len(proton_order) * len(neutron_order) > product_budget:
            # Half-configuration products over-count the subspace, because only the
            # symmetry-allowed ones survive `product_subspace`.  Stopping on the product
            # count alone can therefore leave the basis far short of `target`, so check
            # the dimension actually realized and widen the budget if it falls short.
            trial, _, _ = grow_subspace(
                sp,
                [p_ref],
                [n_ref],
                proton_order,
                neutron_order,
                n_protons,
                n_neutrons,
                max_dimension=target,
            )
            if len(trial) >= target:
                break
            product_budget *= 2

    basis, _, _ = grow_subspace(
        sp,
        [p_ref],
        [n_ref],
        proton_order,
        neutron_order,
        n_protons,
        n_neutrons,
        max_dimension=target,
    )
    return basis

run = large_scale_unverified
if "basis" not in run:
    raise RuntimeError(
        "this cell needs the subspace and eigenvector that sqd_run now returns; "
        "re-run the sqd_run definition and the 48Cr cell"
    )

print(
    f"{run['name']}: sweeping nested subspaces of the sampled basis "
    f"(dimension {run['dimension']})"
)
sampled_rows, cumulative = subspace_scaling(
    run["interaction"], run["basis"], run["vector"]
)

print(
    f"{run['name']}: building the classically selected subspace at the same dimension"
)
classical_basis = classical_selection(
    run["interaction"],
    run["states"],
    run["reference"],
    run["ranked"],
    run["dimension"],
    4,
    4,
)
# Both subspaces must be scored at the same dimension.  Symmetry filtering can still leave
# the classical construction short of the target when the ranked pool runs out, so take the
# dimension both actually reach, cap both ladders there, and verify they agree.
common_dim = min(sampled_rows[-1][0], len(classical_basis))
if common_dim < sampled_rows[-1][0]:
    sampled_rows, _ = subspace_scaling(
        run["interaction"], run["basis"], run["vector"], largest=common_dim
    )
classical_rows, _ = subspace_scaling(
    run["interaction"],
    classical_basis,
    ground_state(run["interaction"], classical_basis)[1],
    largest=common_dim,
)
if sampled_rows[-1][0] != classical_rows[-1][0]:
    raise RuntimeError(
        f"comparison dimensions differ: sampled {sampled_rows[-1][0]}, "
        f"classical {classical_rows[-1][0]}"
    )

advantage = sampled_rows[-1][1] - classical_rows[-1][1]
direction = "lower" if advantage < 0 else "higher"
verdict = "beats" if advantage < 0 else "does not beat"
descent = next(
    e for d, e in reversed(sampled_rows) if d <= sampled_rows[-1][0] / 2
)
for fraction in (0.90, 0.99):
    count = int(np.searchsorted(cumulative, fraction) + 1)
    print(
        f"  {fraction:.0%} of the eigenvector norm sits on {count} determinants "
        f"({count / run['full_dim']:.1e} of the {run['full_dim']:,}-determinant space)"
    )
print(
    f"  bound still falling {1000 * (sampled_rows[-1][1] - descent):+.1f} keV "
    f"over the last doubling of dimension"
)
print(
    f"  sampled {sampled_rows[-1][1]:.6f} MeV vs classically selected "
    f"{classical_rows[-1][1]:.6f} MeV at a verified common dimension of "
    f"{classical_rows[-1][0]:,}"
)
print(
    f"  -> the sampled subspace is {abs(advantage) * 1000:.0f} keV {direction}"
)
48Cr: sweeping nested subspaces of the sampled basis (dimension 3977)
48Cr: building the classically selected subspace at the same dimension
  90% of the eigenvector norm sits on 107 determinants (5.4e-05 of the 1,963,461-determinant space)
  99% of the eigenvector norm sits on 593 determinants (3.0e-04 of the 1,963,461-determinant space)
  bound still falling -15.6 keV over the last doubling of dimension
  sampled -96.481598 MeV vs classically selected -95.314510 MeV at a verified common dimension of 3,957
  -> the sampled subspace is 1167 keV lower
fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.0), facecolor=SURFACE)

# left: two nested convergence curves on the same axes
ax = axes[0]
ax.set_facecolor(SURFACE)
ax.plot(
    [d for d, _ in sampled_rows],
    [e for _, e in sampled_rows],
    "-o",
    color=SERIES,
    linewidth=2,
    markersize=5,
    markeredgecolor=SURFACE,
    markeredgewidth=1,
    zorder=4,
    label="sampled on the QPU",
)
ax.plot(
    [d for d, _ in classical_rows],
    [e for _, e in classical_rows],
    "--s",
    color=MUTED,
    linewidth=1.6,
    markersize=4,
    markeredgecolor=SURFACE,
    markeredgewidth=1,
    zorder=3,
    label="classically selected, same size",
)
ax.axhline(run["e_ref"], color=RULE, linestyle=":", linewidth=1.2, zorder=1)
ax.annotate(
    f"reference determinant {run['e_ref']:.2f} MeV".replace("-", "\u2212"),
    xy=(sampled_rows[-1][0], run["e_ref"]),
    xytext=(-2, 4),
    textcoords="offset points",
    ha="right",
    va="bottom",
    color=MUTED,
    fontsize=8,
)

# mark the gap between the two curves at the largest dimension, not either curve alone
edge = sampled_rows[-1][0]
ax.plot(
    [edge, edge],
    [classical_rows[-1][1], sampled_rows[-1][1]],
    "-",
    color=SERIES,
    linewidth=1.0,
    alpha=0.7,
    zorder=2,
)
ax.annotate(
    f"{abs(advantage) * 1000:.0f} keV {direction}\nat equal dimension",
    xy=(edge, 0.5 * (classical_rows[-1][1] + sampled_rows[-1][1])),
    xytext=(-8, 0),
    textcoords="offset points",
    ha="right",
    va="center",
    color=SERIES,
    fontsize=8.5,
)

ax.set_xscale("log")
ax.set_xlim(sampled_rows[0][0] * 0.75, edge * 1.5)
ax.set_xlabel("subspace dimension", color=MUTED)
ax.set_ylabel("variational upper bound (MeV)", color=MUTED)
ax.set_title(
    f"{pretty[run['name']]}: the bound, and the subspace it {verdict}",
    color=INK,
    fontsize=11,
    loc="left",
    pad=10,
)
legend = ax.legend(frameon=False, fontsize=8.5, loc="lower left")
for text in legend.get_texts():
    text.set_color(MUTED)

# right: why a few thousand determinants can bound two million
ax = axes[1]
ax.set_facecolor(SURFACE)
ranks = np.arange(1, len(cumulative) + 1)
ax.plot(ranks, 100 * cumulative, "-", color=DEEP, linewidth=2, zorder=3)
for fraction, style, label_y in ((0.90, ":", 46), (0.99, "--", 24)):
    count = int(np.searchsorted(cumulative, fraction) + 1)
    ax.axvline(count, color=MUTED, linestyle=style, linewidth=1, zorder=1)
    ax.annotate(
        f"{fraction:.0%} of the norm\non {count} determinants",
        xy=(count, label_y),
        xytext=(7, 0),
        textcoords="offset points",
        ha="left",
        va="center",
        color=MUTED,
        fontsize=8.5,
    )
ax.set_xscale("log")
ax.set_xlim(0.8, len(cumulative) * 2.6)
ax.set_ylim(0, 104)
ax.set_xlabel("determinants, ordered by weight", color=MUTED)
ax.set_ylabel("cumulative share of the eigenvector (%)", color=MUTED)
ax.set_title(
    f"Sparsity: {run['full_dim']:,} determinants in the sector",
    color=INK,
    fontsize=11,
    loc="left",
    pad=10,
)

for ax in axes:
    ax.grid(axis="y", color=RULE, alpha=0.55)
    ax.tick_params(colors=MUTED, labelsize=8.5)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("bottom", "left"):
        ax.spines[side].set_color(MUTED)
fig.tight_layout()
plt.show()
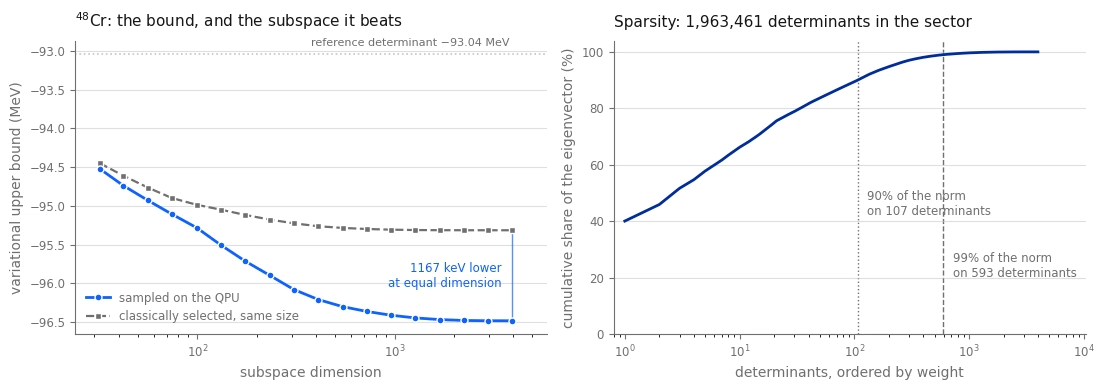
Die drei Durchläufe vergleichen
Absolute Energien sind zwischen verschiedenen Kernen und verschiedenen Wechselwirkungen nicht vergleichbar, daher konzentriere dich auf den Anteil der wiederhergestellten Korrelationsenergie über die Durchläufe hinweg, wo eine exakte Referenz verfügbar ist. Vergleiche außerdem die Circuit-Tiefe und den Anteil der verworfenen Shots.
runs = [small_scale, large_scale_verified, large_scale_unverified]

print(
    f"{'run':>6}  {'qubits':>6}  {'pool':>9}  {'2q depth':>8}  {'2q gates':>8}  "
    f"{'shots kept':>10}  {'dim':>6}  {'of':>9}  {'% corr':>7}"
)
for r in runs:
    fraction = (
        "--"
        if r["e_exact"] is None
        else f"{100 * (r['e_sqd'] - r['e_ref']) / (r['e_exact'] - r['e_ref']):.1f}%"
    )
    coverage = "{}/{}".format(r["packed"], r["pool"])
    print(
        f"{r['name']:>6}  {r['qubits']:>6}  {coverage:>9}  "
        f"{r['two_qubit']:>8}  {r['two_qubit_gates']:>8}  {r['survival']:>9.1%}  "
        f"{r['dimension']:>6}  {(r['full_dim'] or 0):>9,}  {fraction:>7}"
    )

print()
for r in runs:
    exact = (
        f"exact {r['e_exact']:11.6f}"
        if r["e_exact"] is not None
        else "exact  unavailable"
    )
    print(
        f"{r['name']:>6}   reference {r['e_ref']:11.6f}   pooled SQD {r['e_sqd']:11.6f}   {exact} MeV"
    )
run  qubits       pool  2q depth  2q gates  shots kept     dim         of   % corr
  20Ne      24      78/78       228       234      31.5%     640        640   100.0%
  44Ti      40     96/174       272       285      18.6%    4000      4,000   100.0%
  48Cr      40     96/582       224       279      18.6%    3977  1,963,461       --

  20Ne   reference  -29.765549   pooled SQD  -40.472331   exact  -40.472331 MeV
  44Ti   reference  -44.309387   pooled SQD  -47.876666   exact  -47.876666 MeV
  48Cr   reference  -93.041237   pooled SQD  -96.481598   exact  unavailable MeV
# Left: how much of the correlation energy was recovered, where the exact answer is known.
# Right: the bound itself for the run that has nothing to score against.
scored = [r for r in runs if r["e_exact"] is not None]

fig, ax = plt.subplots(figsize=(6.4, 3.9), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
labels = [
    f"{pretty[r['name']]}\n{r['qubits']} qubits\n{r['full_dim']:,} determinants"
    for r in scored
]
fractions = [
    100 * (r["e_sqd"] - r["e_ref"]) / (r["e_exact"] - r["e_ref"])
    for r in scored
]
shades = [SERIES, DEEP, PURPLE]
bars = ax.bar(
    labels, fractions, width=0.46, color=shades[: len(scored)], zorder=3
)
for bar, fraction, r in zip(bars, fractions, scored):
    ax.annotate(
        f"{fraction:.1f}%",
        xy=(bar.get_x() + bar.get_width() / 2, fraction),
        xytext=(0, 5),
        textcoords="offset points",
        ha="center",
        va="bottom",
        color=INK,
        fontsize=10,
    )
    ax.annotate(
        f"dim {r['dimension']:,}",
        xy=(bar.get_x() + bar.get_width() / 2, 3),
        ha="center",
        va="bottom",
        color=SURFACE,
        fontsize=8.5,
    )
ax.axhline(100, color=MUTED, linestyle="--", linewidth=1, zorder=1)
ax.annotate(
    "exact diagonalization",
    xy=(-0.45, 100),
    xytext=(0, 4),
    textcoords="offset points",
    ha="left",
    va="bottom",
    color=MUTED,
    fontsize=8.5,
)
ax.set_ylim(0, 118)
ax.set_ylabel("correlation energy recovered (%)", color=MUTED)
ax.set_title(
    f"Where the exact answer is known ({backend.name})",
    color=INK,
    fontsize=11,
    loc="left",
    pad=10,
)
ax.grid(axis="y", color=RULE, alpha=0.55)
ax.tick_params(colors=MUTED, labelsize=8.5)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("bottom", "left"):
    ax.spines[side].set_color(MUTED)
fig.tight_layout()
plt.show()

# the same convergence view as the walkthrough, for the run with no exact reference
convergence_plot(
    large_scale_unverified["history"],
    large_scale_unverified["e_ref"],
    None,
    f"{pretty[large_scale_unverified['name']]}: "
    f"{large_scale_unverified['full_dim']:,} determinants, no exact answer to score against\n"
    f"({backend.name}, {N_CIRCUITS} circuits x {SHOTS:,} shots)",
    colour=DEEP,
)
plt.show()

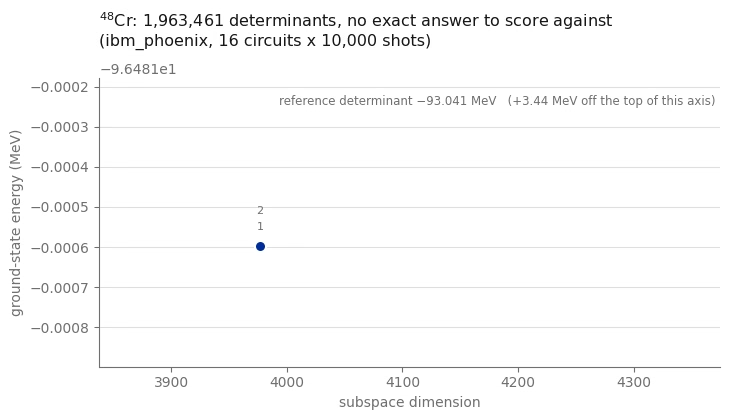
Zusammenfassung
Ein Workflow, unverändert bis auf seine Eingaben, lief auf einer QPU bei drei Problemgrößen: einem 24-Qubit-Problem, das du exakt überprüfen kannst, einem 40-Qubit-Problem, das du noch exakt überprüfen kannst, und einem 40-Qubit-Problem mit fast zwei Millionen Basiszuständen, das jenseits der exakten Diagonalisierungskapazität dieses Tutorials liegt.
Die drei Durchläufe veranschaulichen die folgenden Punkte:
-
Der Quantenschritt muss nur Determinanten vorschlagen. Der Circuit ist fest, wird aus Störungstheorie zweiter Ordnung initialisiert und niemals optimiert. Nichts im Workflow benötigt genaue Amplituden, nur einen nützlichen Support. Die klassische Diagonalisierung im ausgewählten Unterraum liefert eine variationelle obere Schranke, obwohl die Schranke mit den gesampelten Konfigurationen variiert.
-
Qubit-Anregungen reduzieren die Circuit-Tiefe. Da nur der Support zählt, können die fermionischen Anregungsblöcke durch Qubit-Anregungen ersetzt werden, deren Kosten nicht mit dem Abstand zwischen den verbundenen Orbitalen wachsen. Schritt 2 hat die Einsparung auf dem tatsächlichen Backend gemessen, was den Unterschied zwischen einem Circuit ausmacht, der bequem innerhalb der Kohärenz liegt, und einem, der das nicht tut.
-
Die Konfigurationswiederherstellung nutzt verrauschte Samples wieder. Jeder Shot mit falscher Protonen- oder Neutronenzahl wird anhand der aktuellen Besetzungsschätzung repariert, statt verworfen zu werden, und jede reparierte Halbkonfiguration kann dem Unterraum Konfigurationen hinzufügen. Das Erweitern eines variationellen Unterraums kann dessen niedrigsten Eigenwert nicht erhöhen. Dieses Tutorial demonstriert die Konfigurationswiederherstellung anhand von Hardware-Samples.
-
Die bindende Einschränkung verschiebt sich mit der Skalierung. Bei 24 Qubits konnte der Ansatz die exakte Antwort erreichen, und nur das Sampling stand im Weg. Bei 40 Qubits mit vier Valenznukleonen pro Spezies deckt das Gate-Budget nur einen Bruchteil des Pools ab, und der dichte klassische Solver begrenzt den Unterraum. Zu wissen, welche der drei Einschränkungen dich limitiert, ist die praktische Fähigkeit, die dieser Workflow vermittelt.
Nächste Schritte
Entdecke diese verwandten Ressourcen:
-
Sample-basierte Quanten-Diagonalisierung eines Chemie-Hamiltonians: derselbe Algorithmus angewendet auf die elektronische Struktur, unter Verwendung des selected-CI-Solvers des SQD-Addons.
-
SQD-Addon-Dokumentation: Utilities für Post-Selection, Subsampling und Konfigurationswiederherstellung.
-
Quanten-Diagonalisierungsalgorithmen: ein vollständiger Kurs zur Unterraum-Diagonalisierung, einschließlich Krylov-Varianten.
-
Einführung in die Transpilation: die Pass-Manager-Optionen, die wichtig sind, wenn ein Circuit von Zwei-Qubit-Gates dominiert wird.
-
Ausführungsmodi: Entdecke den Batch-Modus zum Planen unabhängiger Jobs.
Zu erwägende Erweiterungen
-
Ersetze den dichten Solver.
MAX_DIMENSIONist im -Maßstab die Obergrenze für alles, undnp.linalg.eighauf einer dichten Matrix ist der Grund dafür. Den Aufbau desselben projizierten Hamiltonians als dünnbesetzte Matrix und die Verwendung eines iterativen Eigenlösers wiescipy.sparse.linalg.eigsh, oder eines Davidson- oder selected-CI-Solvers, der für nukleare Zweikörper-Wechselwirkungen ausgelegt ist, könnten größere Unterräume unterstützen. Die praktische Grenze hängt von der Matrix-Sparsity, dem verfügbaren Speicher und der Solver-Konvergenz ab, und dieses Tutorial benchmarkt diese Erweiterung nicht. Dasqiskit_addon_sqd.fermion.solve_scides SQD-Addons ist kein direkter Ersatz: Es umhüllt einen Solver für elektronische Struktur und erwartet Ein- und Zweikörper-Integrale in dieser Form, sodass die gemeinsame Proton--Neutron-Produktstruktur allein nicht ausreicht. Es zu verwenden würde bedeuten, die Schalenmodell-Wechselwirkung aus Gleichung (1) in diese Integrale abzubilden und das Ergebnis gegen die exakten Energien zu validieren, die dieses Notebook bereits berechnet. -
Füge Batching und Subsampling hinzu. Der veröffentlichte gepoolte SQD-Workflow diagonalisiert mehrere unabhängige Subsamples pro Iteration und behält das beste. Dieses Tutorial verwendet einen Batch pro Iteration, was für die variationelle Schranke unschädlich ist, aber nicht die Varianzinformation liefert, die anzeigt, ob mehr Shots helfen würden.
-
Angeregte Zustände und andere Sektoren. Die höheren Eigenwerte jedes Unterraum-Hamiltonians sind obere Schranken für angeregte Zustände im selben Symmetriesektor, und ein Durchlauf bei erreicht andere Sektoren. Die -Prüfung in Schritt 1 ist bereits die halbe Berechnung.
-
Ein schalenübergreifender Modellraum. Die Parität ist innerhalb einer einzelnen Hauptschale automatisch erfüllt, weshalb sie hier keine Rolle spielt. Ein --Raum mischt -Paritäten, wodurch die Parität zu einer echten vierten Beschränkung wird, die weder die Hamming-Gewicht-Reparatur von SQD noch die Produktkonstruktion allein erfassen würde.
-
Kerne mit ungerader Massenzahl.
reference_determinanterfordert eine gerade Valenzzahl in jeder Spezies, weil eine zeitumgekehrte gepaarte Besetzung erzwingt. Ein ungerader Kern benötigt ein halbzahliges -Ziel und eine ungepaarte Referenz.
Anhang
Dieser Abschnitt erklärt die Überlegungen hinter den im Abschnitt Setup eingeführten Hilfsfunktionen.
Warum die Massenabhängigkeits-Skalierung nicht optional ist
Empirische Schalenmodell-Wechselwirkungen werden bei einer Masse angepasst und über eine Kette von Isotopen hinweg angewendet, wobei die Zweikörper-Matrixelemente als skaliert werden. Beide Wechselwirkungsdateien tragen , mit für die USD-Familie und für GXPF1. In der Zweikörper-Kopfzeile einer .snt-Datei stehen diese beiden Zahlen dort, wo plausibel eine Oszillatorfrequenz und eine Kernenergie stehen würden, was sie leicht misslesbar macht; wenn man den Exponenten als konstante Kernenergie liest, fügt das jedem Diagonalelement einen falschen Offset hinzu und lässt die Skalierung entfallen, wodurch sich die Korrelationsenergie um einige Prozent ändert. Die Symmetrieprüfung in Schritt 1 verifiziert die Energieskala nicht von selbst. Der Vergleich der in MeV gemessenen -Anregungsenergie mit dem Experiment liefert eine zusätzliche Überprüfung der massenabhängigen Skalierung. Eine Anregungsenergie ist eine Differenz zwischen Niveaus, daher erkennt sie keinen konstanten Offset, der auf alle Energien angewendet wird.
Warum die Referenz durch Suche statt durch Auffüllen gefunden wird
Die naheliegende Referenz ist die Determinante, die die niedrigsten Einteilchenenergien auffüllt. Sie ist nicht die Determinante mit der niedrigsten Energie, weil die Diagonale von Gleichung (1) den Zweikörperterm enthält, und die Paarungswechselwirkung bevorzugt stark die Besetzung zeitumgekehrter -Partner beim größten verfügbaren . In der -Schale ist das der Unterschied zwischen dem -Paar und dem -Paar von , und er beträgt etwa 1 MeV; in der -Schale liegt er näher bei 2. Da die Referenzenergie den Nullpunkt der Kennzahl "wiederhergestellte Korrelationsenergie" definiert, bläht eine schlechte Wahl diese Kennzahl auf und liefert einen weniger genauen Ausgangspunkt.
Die Beschränkung auf gepaarte Besetzungen macht die erschöpfende Suche kostengünstig, mit Kandidaten pro Spezies (höchstens ein paar Tausend), und stellt sicher. In jedem Fall in diesem Tutorial, der gegen eine vollständige Aufzählung überprüft werden kann, liefert die Suche die globale Determinante mit der niedrigsten Diagonale, die auch die einzelne größte Komponente des exakten Grundzustands ist.
Warum die Amplitude erster Ordnung und nicht der exakte Zweiniveau-Winkel
Das Diagonalisieren des -Hamiltonians im Raum liefert den Mischungswinkel ; es mag verlockend sein, das als die richtige Wahl für ein isoliertes Paar von Niveaus zu bezeichnen. In diesem Ansatz wirken mehrere Dutzend Anregungsblöcke nacheinander auf dieselbe Referenz, sodass die separate Optimierung jedes Blocks nicht notwendigerweise den zusammengesetzten Circuit optimiert.
Die Rolle des Circuits bestimmt die Wahl des Winkels. Da für jedes reelle gilt, ist der exakte Winkel im Betrag immer kleiner als die Amplitude erster Ordnung , und lässt daher immer mehr Amplitude auf der Referenzdeterminante. Ein Circuit, der mehr Amplitude auf der Referenz behält, liefert die Referenz häufiger und unterschiedliche angeregte Determinanten seltener. Für gepooltes SQD ist die nützliche Ausgabe eines Shots eine Determinante, die der klassische Schritt noch nicht gesehen hat, was die Verwendung des größeren Winkels in diesem Tutorial motiviert. Keiner der beiden Winkel muss genau sein, weil die klassische Diagonalisierung die Amplituden des Circuits vollständig verwirft und ihre eigenen neu ableitet.
Warum gepooltes SQD Qubit-Anregungen verwenden kann
Die fermionische Anregung wird unter Jordan-Wigner auf acht Pauli-Strings abgebildet, von denen jeder -Operatoren auf jedem Qubit zwischen den äußersten Indizes trägt. Diese Strings kodieren das fermionische Vorzeichen, und ihre Kosten wachsen mit der Spannweite, die bei einer Proton-Neutron-Anregung das gesamte Register umfasst.
Sie zu entfernen ergibt den Qubit-Anregungsoperator von Yordanov et al. [5]. Es ist ein anderer Operator: Der Zustand, den er präpariert, unterscheidet sich vom fermionischen in den Vorzeichen seiner Amplituden, und die beiden Sampling-Verteilungen können sich erheblich unterscheiden. Was sich nicht ändert, ist, welche Determinanten eine von null verschiedene Amplitude haben, weil jeder Block weiterhin innerhalb desselben zweidimensionalen Raums für jede Determinante rotiert, auf die er wirkt, und er weiterhin beide Nukleonenzahlen, und die Parität exakt erhält. Die erreichbare Menge von Determinanten ist daher identisch, und die erreichbare Menge ist das Einzige, was gepooltes SQD nutzt; die klassische Diagonalisierung weist ohnehin ihre eigenen Amplituden zu. Schritt 2 verifiziert die Behauptung des identischen Supports an einem echten Operator aus dem Pool und misst, was die Substitution einspart.
Die Einschränkung ist, dass sich die Sampling-Gewichte unterscheiden, sodass die beiden Konstruktionen Determinanten bei endlicher Shot-Zahl nicht in derselben Reihenfolge entdecken. Da das Ranking, das entscheidet, welche Anregungen in die Circuits eingehen, klassisch und unverändert ist, und der klassische Schritt ohnehin alles neu gewichtet, ist der Unterschied in den Sampling-Gewichten ein Kompromiss für eine reduzierte Circuit-Tiefe.
Warum zur Produktstufe gehört
Post-Selektion und Konfigurationswiederherstellung wirken beide auf Hamming-Gewichte: die Anzahl der Protonen in einer Hälfte des Registers und die Anzahl der Neutronen in der anderen. hat nicht diese Form. Es ist eine Eigenschaft einer Protonenkonfiguration gepaart mit einer Neutronenkonfiguration. Ein Shot, dessen Protonenhälfte und Neutronenhälfte jeweils die richtige Nukleonenzahl tragen, enthält zwei nutzbare Halbkonfigurationen, selbst wenn sich ihre -Werte nicht aufheben, weil die Protonenhälfte bei vollkommen brauchbar ist, sobald sie mit einer Neutronenhälfte bei gepaart wird. Das Filtern ganzer Shots nach dem Gesamt- wirft beide Hälften weg, während das Auferlegen von auf die rekombinierten Produkte sie behält. Dasselbe Argument erklärt, warum recover_configurations in diesem Fall keinen Begriff von benötigt, um nützlich zu sein.
Referenzen
-
J. Robledo-Moreno, M. Motta, H. Haas, et al., "Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer", Science Advances 11, eadu9991 (2025). arXiv:2405.05068
-
B. A. Brown and W. A. Richter, "New USD Hamiltonians for the sd shell", Physical Review C 74, 034315 (2006). Die eingebettete Datei
usda.sntenthält die USDA-Parameter, wie tabelliert von W. A. Richter, S. Mkhize und B. A. Brown, "sd-shell observables for the USDA and USDB Hamiltonians", Physical Review C 78, 064302 (2008). -
M. Honma, T. Otsuka, B. A. Brown and T. Mizusaki, "Effective interaction for pf-shell nuclei", Physical Review C 65, 061301(R) (2002).
-
B. Huron, J. P. Malrieu and P. Rancurel, "Iterative perturbation calculations of ground and excited state energies from multiconfigurational zeroth-order wavefunctions", The Journal of Chemical Physics 58, 5745 (1973).
-
Y. S. Yordanov, D. R. M. Arvidsson-Shukur and C. H. W. Barnes, "Efficient quantum circuits for quantum computational chemistry", Physical Review A 102, 062612 (2020).
-
National Nuclear Data Center, Evaluated Nuclear Structure Data File, Brookhaven National Laboratory. Quelle der in Schritt 1 zitierten gemessenen -Anregungsenergien.