Transpiler-Optimierungsstufe festlegen
Paketversionen
Der Code auf dieser Seite wurde mit den folgenden Anforderungen entwickelt. Wir empfehlen, diese Versionen oder neuere zu verwenden.
qiskit[all]~=2.5.2
qiskit-ibm-runtime~=0.47.0
Echte Quantengeräte unterliegen Rauschen und Gate-Fehlern, weshalb die Optimierung von Schaltkreisen zur Reduzierung ihrer Tiefe und Gate-Anzahl die Ergebnisse, die durch das Ausführen dieser Schaltkreise erzielt werden, erheblich verbessern kann.
Die Funktion generate_preset_pass_manager hat ein erforderliches Positionsargument, optimization_level, das steuert, wie viel Aufwand der Transpiler für die Optimierung von Schaltkreisen aufwendet. Dieses Argument kann eine ganze Zahl sein, die einen der Werte 0, 1, 2 oder 3 annimmt.
Höhere Optimierungsstufen erzeugen stärker optimierte Schaltkreise auf Kosten längerer Kompilierungszeiten.
Die folgende Tabelle erläutert die Optimierungen, die mit jeder Einstellung durchgeführt werden.
| Optimierungsstufe | Beschreibung |
|---|---|
| 0 | Keine Optimierung: typischerweise für Hardware-Charakterisierung verwendet
|
| 1 | Leichte Optimierung:
|
| 2 | Mittlere Optimierung:
|
| 3 | Hohe Optimierung:
|
Optimierungsstufe in der Praxis
Da Zwei-Qubit-Gates typischerweise die bedeutendste Fehlerquelle sind, können wir die „Hardware-Effizienz“ der Transpilierung annäherungsweise quantifizieren, indem wir die Anzahl der Zwei-Qubit-Gates im resultierenden Schaltkreis zählen. Hier probieren wir die verschiedenen Optimierungsstufen auf einem Eingangsschaltkreis aus, der aus einer zufälligen unitären Matrix gefolgt von einem SWAP-Gate besteht.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.circuit.library import UnitaryGate
from qiskit.quantum_info import Operator, random_unitary

UU = random_unitary(4, seed=12345)
rand_U = UnitaryGate(UU)

qc = QuantumCircuit(2)
qc.append(rand_U, range(2))
qc.swap(0, 1)
qc.draw("mpl", style="iqp")

Das Mock-Backend FakeSherbrooke aus qiskit_ibm_runtime wird in diesen Beispielen verwendet, du kannst es aber mit jedem Qiskit-kompatiblen echten oder simulierten Backend ausprobieren. Deine Ergebnisse könnten abweichen.
Zuerst transpilieren wir mit Optimierungsstufe 0.
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime.fake_provider import FakeSherbrooke

backend = FakeSherbrooke()

pass_manager = generate_preset_pass_manager(
    optimization_level=0, backend=backend, seed_transpiler=12345
)
qc_t1_exact = pass_manager.run(qc)
qc_t1_exact.draw("mpl", idle_wires=False)
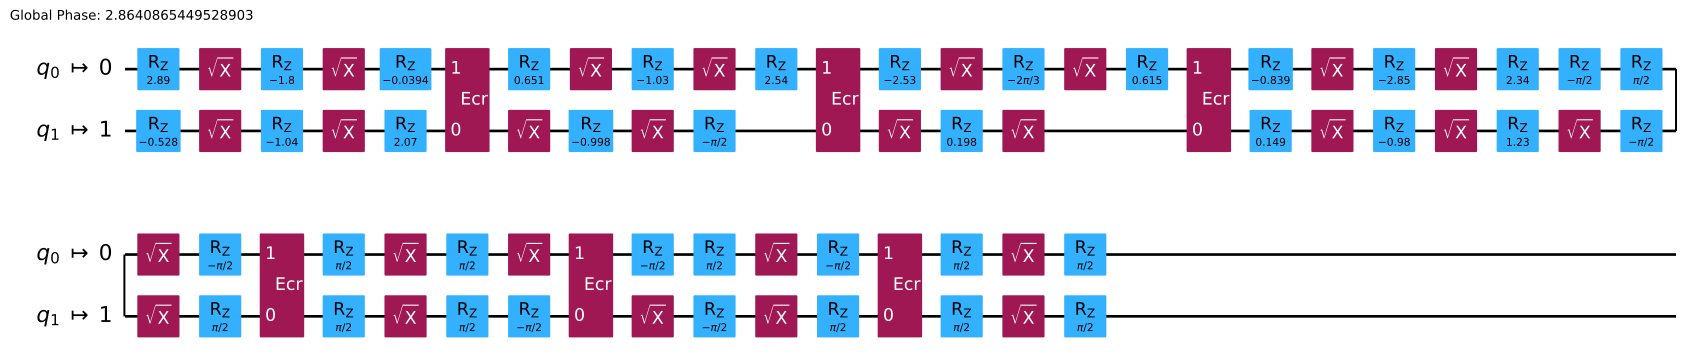
Der transpilierte Schaltkreis hat sechs Zwei-Qubit-ECR-Gates.
Wiederholen wir das für Optimierungsstufe 1:
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime.fake_provider import FakeSherbrooke

backend = FakeSherbrooke()

pass_manager = generate_preset_pass_manager(
    optimization_level=1, backend=backend, seed_transpiler=12345
)
qc_t1_exact = pass_manager.run(qc)
qc_t1_exact.draw("mpl", idle_wires=False)
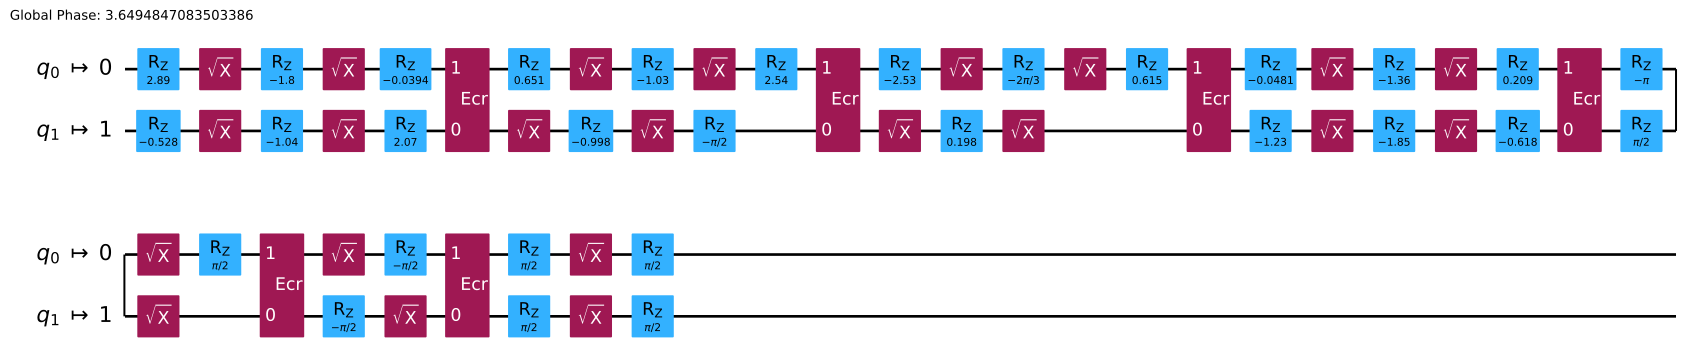
Der transpilierte Schaltkreis hat immer noch sechs ECR-Gates, aber die Anzahl der Einzel-Qubit-Gates hat sich verringert.
Wiederholen wir das für Optimierungsstufe 2:
pass_manager = generate_preset_pass_manager(
    optimization_level=2, backend=backend, seed_transpiler=12345
)
qc_t2_exact = pass_manager.run(qc)
qc_t2_exact.draw("mpl", idle_wires=False)
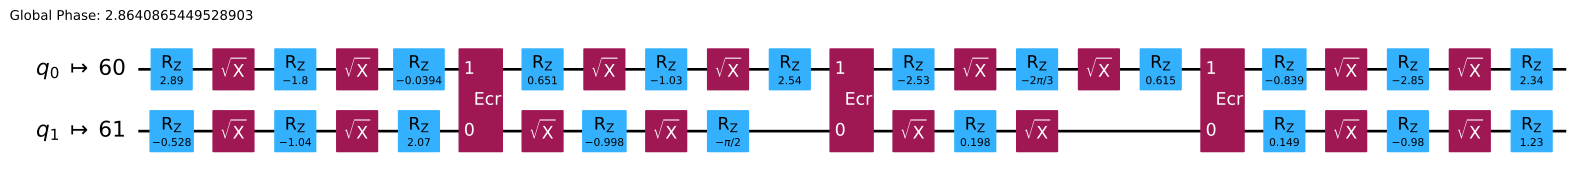
Das ergibt dieselben Ergebnisse wie Optimierungsstufe 1. Beachte, dass eine Erhöhung der Optimierungsstufe nicht immer einen Unterschied macht.
Und noch einmal, diesmal mit Optimierungsstufe 3:
pass_manager = generate_preset_pass_manager(
    optimization_level=3, backend=backend, seed_transpiler=12345
)
qc_t3_exact = pass_manager.run(qc)
qc_t3_exact.draw("mpl", idle_wires=False)
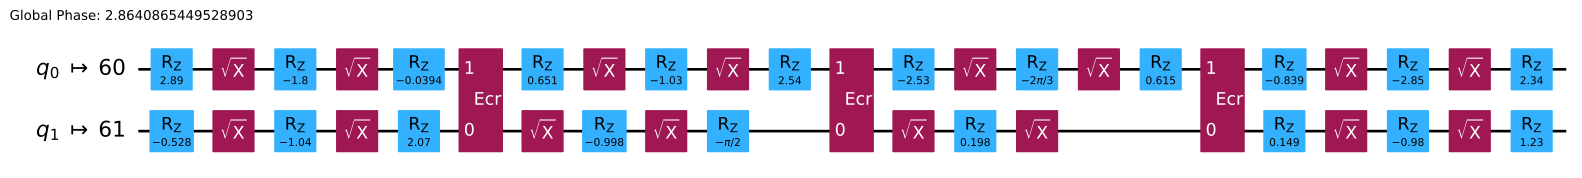
Jetzt gibt es nur noch drei ECR-Gates. Dieses Ergebnis erhalten wir, weil Qiskit bei Optimierungsstufe 3 versucht, Zwei-Qubit-Gate-Blöcke neu zu synthetisieren, und jedes Zwei-Qubit-Gate mit höchstens drei ECR-Gates implementiert werden kann. Wir können sogar noch weniger ECR-Gates erhalten, wenn wir approximation_degree auf einen Wert kleiner als 1 setzen, sodass der Transpiler Näherungen vornehmen darf, die möglicherweise einen gewissen Fehler in der Gate-Zerlegung einführen (siehe Häufig verwendete Parameter für die Transpilierung):
pass_manager = generate_preset_pass_manager(
    optimization_level=3,
    approximation_degree=0.99,
    backend=backend,
    seed_transpiler=12345,
)
qc_t3_approx = pass_manager.run(qc)
qc_t3_approx.draw("mpl", idle_wires=False)
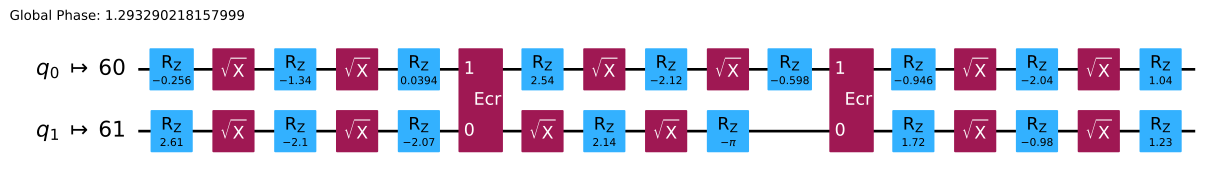
Dieser Schaltkreis hat nur zwei ECR-Gates, ist aber ein Näherungsschaltkreis. Um zu verstehen, wie sich seine Wirkung vom exakten Schaltkreis unterscheidet, können wir die Fidelität zwischen dem unitären Operator, den dieser Schaltkreis implementiert, und dem exakten unitären Operator berechnen. Vor der Berechnung reduzieren wir zunächst den transpilierten Schaltkreis, der 127 Qubits enthält, auf einen Schaltkreis, der nur noch die beiden aktiven Qubits enthält.
import numpy as np

def trace_to_fidelity_2q(trace: float) -> float:
    return (4.0 + trace * trace.conjugate()) / 20.0

# Reduce circuits down to 2 qubits so they are easy to simulate
qc_t3_exact_small = QuantumCircuit.from_instructions(qc_t3_exact)
qc_t3_approx_small = QuantumCircuit.from_instructions(qc_t3_approx)

# Compute the fidelity
exact_fid = trace_to_fidelity_2q(
    np.trace(np.dot(Operator(qc_t3_exact_small).adjoint().data, UU))
)
approx_fid = trace_to_fidelity_2q(
    np.trace(np.dot(Operator(qc_t3_approx_small).adjoint().data, UU))
)
print(
    f"Synthesis fidelity\nExact: {exact_fid:.3f}\nApproximate: {approx_fid:.3f}"
)
Synthesis fidelity
Exact: 1.000+0.000j
Approximate: 0.992+0.000j
Das Anpassen der Optimierungsstufe kann auch andere Aspekte des Schaltkreises verändern, nicht nur die Anzahl der ECR-Gates. Beispiele dafür, wie das Festlegen der Optimierungsstufe das Layout verändert, findest du unter Quantencomputer darstellen.
Nächste Schritte
- Um mehr über die Funktion
generate_preset_passmanagerzu erfahren, beginne mit dem Thema Standardeinstellungen und Konfigurationsoptionen für die Transpilierung. - Lerne weiter über die Transpilierung mit dem Thema Transpiler-Phasen.
- Probiere die Anleitung Transpiler-Einstellungen vergleichen aus.
- Probiere das Tutorial Wiederholungscodes erstellen aus.
- Sieh dir die Transpile-API-Dokumentation an.