Verrauschte Quantenzustände mit klassischen Shadows lernen
Nutzungsschätzung: 34 Minuten auf einem Heron-r2-Prozessor (HINWEIS: Dies ist nur eine Schätzung. Deine Laufzeit kann abweichen.)
Lernziele
-
Randomisierte Messungen auf einem IBM® Quantenprozessor mit Julia erfassen und für die spätere Analyse speichern
-
Die Messdaten vor dem Lernen auf fehlerhafte Qubits und Gates prüfen
-
Ein Matrixproduktoperator-Modell (MPO) eines verrauschten Zustands an klassische Shadows anpassen
-
Das Modell an zurückgehaltenen Messungen validieren und mit dem idealen Circuit vergleichen
Voraussetzungen
-
Klassische Shadows, wie im Tutorial Shadow-Tomographie des Greenberger-Horne-Zeilinger-Zustands (GHZ) eingeführt
-
Dichtematrizen und gemischte Zustände, behandelt in Grundlagen der Quanteninformation
-
Ausführen von Circuits mit Julia unter Verwendung von
Qiskit.jlundQiskitIBMRuntime.jl, eingeführt im Tutorial Zeitentwicklung des Ising-Modells im transversalen Feld simulieren
Hintergrund
Auf einem realen Quantenprozessor verwandelt Rauschen den reinen Zustand , den ein Circuit vorbereiten soll, in einen gemischten Zustand . Die vollständige Quantenzustandstomographie kann rekonstruieren, aber die Anzahl der dafür nötigen Messungen wächst exponentiell mit der Zahl der Qubits. Votto et al. [1] haben stattdessen aus randomisierten Messungen ein kompaktes Modell von für bis zu 96 Qubits gelernt. Dieses Tutorial folgt ihrem Workflow.
Bei einer randomisierten Messung [2] wird jedes Qubit mit einer unabhängigen zufälligen Unitären rotiert und dann in der Rechenbasis gemessen. Eine Ziehung der Rotationen heißt Messeinstellung, und jede Einstellung wird für Shots wiederholt. Ein Shot mit den Ergebnisbits ergibt den klassischen Shadow [3]
dessen Mittelwert über Einstellungen und Shots ist. Das Voraussetzungs-Tutorial zieht jedes aus den drei Pauli-Basen; dieses Tutorial zieht sie, wie das Paper, gleichverteilt aus allen Einzel-Qubit-Unitären (Haar-zufällig), und dieselbe Formel gilt.
Shadows schätzen Eigenschaften weniger Qubits gleichzeitig ab. Das Paper kombiniert sie zu einem Matrixproduktoperator (MPO), der die Dichtematrix als Kette kleiner Tensoren schreibt, einen pro Qubit; verrauschte Zustände mit kurzreichweitigen Korrelationen benötigen nur kleine Bindungen zwischen benachbarten Tensoren. Wie beim Algorithmus der Dichtematrix-Renormierungsgruppe (DMRG) läuft der Lernalgorithmus die Kette entlang und aktualisiert jeweils einen Tensor, sodass das Modell die Shadows auf dem Fenster aus Qubits, zentriert um diesen Tensor, reproduziert (Gleichung 4 des Papers). Die Bonddimension bleibt bei diesen Aktualisierungen fest, sodass der Lernalgorithmus das Modell nie abschneidet. Weil die Daten nur über diese Fenster eingehen, wächst die Zahl der benötigten Einstellungen nicht mit der Länge der Kette.
Die Einstellungen werden in eine Trainingsmenge und eine Testmenge aufgeteilt. Auf der Testmenge schätzt das Paper die maximale Fidelity zwischen und dem Modell ,
direkt zu messen würde exponentiell viele Messungen erfordern. Stattdessen nimmt das Paper die approximative Faktorisierungsbedingung (AFC) an: Korrelationen in klingen innerhalb weniger Qubits ab, sodass globale Überlappungen und Reinheiten in Terme auf Blöcken aus benachbarten Qubits faktorisieren. Die Reinheit liefert auch die Rényi-2-Entropie , die misst, wie gemischt der Zustand ist.
Das Paper bereitet den Kicked-Ising-Zustand der Tiefe vor
auf 96 Qubits von ibm_brisbane, einem Eagle-Prozessor, mit 2.048 Einstellungen zu je 1.024 Shots für . Abbildung 1(c,d) des Papers berichtet zwei Ergebnisse für :
-
Das gelernte Modell erreicht mit dem experimentellen Zustand bei , weit über der Überlappung des idealen Zustands mit dem Experiment.
-
Die Entropie wächst linear, , und die Entropie des Modells stimmt mit einer unabhängigen Schätzung aus der Testmenge überein.
Dieses Tutorial prüft beide Ergebnisse, zuerst in einer Simulation mit acht Qubits, bei der die exakten Antworten bekannt sind, und dann in einem neuen 96-Qubit-Lauf auf ibm_fez, einem Heron-r2-Prozessor. Der Lernalgorithmus ist eine unabhängige Julia-Implementierung der Gleichungen im Paper und seinem Supplement.
Anforderungen
Dieses Tutorial erfordert macOS oder Linux, da Qiskit.jl Windows noch nicht unterstützt (Qiskit.jl issue #15). Außerdem benötigst du Folgendes:
-
Julia 1.11, von der Julia-Downloadseite oder mit
juliaup add 1.11, und das PaketIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Für das Hardware-Beispiel ein IBM Quantum® Platform-Konto mit Zugriff auf eine QPU mit mindestens 96 Qubits sowie gespeicherte Zugangsdaten. Ohne Konto kannst du das Hardware-Beispiel mit den gespeicherten Messungen des Laufs auf
ibm_fezausführen, der die Ergebnisse in diesem Tutorial geliefert hat. Die anderen Abschnitte laufen ohne Konto.
Das Notebook verwendet Qiskit.jl und QiskitIBMRuntime.jl, um Circuits zu erstellen und auszuführen, RandomMeas.jl [4] für randomisierte Messungen (es stellt auch ITensors.jl und ITensorMPS.jl bereit) sowie NPZ.jl, JSON.jl und Plots.jl. Dieses Tutorial ist mit Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 und RandomMeas.jl 0.3.1 getestet.
Es gibt zwei Möglichkeiten, die Umgebung einzurichten:
-
Option 1: Installiere die neuesten kompatiblen Versionen der Pakete in eine temporäre Umgebung. Führe die folgende Zelle unverändert aus.
-
Option 2: Reproduziere die getestete Umgebung exakt. Setze
download_toml_files = truein der folgenden Zelle. Die Zelle lädtProject.tomlundManifest.tomlaus dem Dokumentations-Repository in einen Ordnerenv_tutorial/classical-shadows/neben diesem Notebook herunter und installiert dann die exakte Version jedes Pakets, die das Manifest verzeichnet, einschließlich indirekter Abhängigkeiten. Details findest du in der Julia-Dokumentation zu diesen Dateien.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Einrichtung
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Das Hilfsmodul mpo_learning.jl, das die Einrichtungszelle herunterlädt, implementiert den Lernalgorithmus. Das Tutorial ruft daraus die folgenden Funktionen auf:
| Funktion | Zweck |
|---|---|
kicked_ising_reference(N, D; depolarization) | Exakter MPO des idealen Kicked-Ising-Zustands oder des Zustands nach lokalem depolarisierendem Rauschen |
split_settings(group; seed, train_fraction) | Messeinstellungen zufällig Trainings- und Testmengen zuweisen (standardmäßig je zur Hälfte) |
training_marginals(train; ell, prior) | Shadow-Schätzungen jedes Lernfensters, nur aus den Trainingseinstellungen |
fitted_prior(ideal, train) | Prior für gemeinsame randomisierte Messungen (CRM), angepasst an die gemessene Reinheit jedes Fensters, wie im Paper |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Das Ein-Site-Update des Papers entlang der Kette durchlaufen, beginnend mit dem maximal gemischten Zustand |
max_fidelity(a, b), mpo_overlap(a, b) | Exaktes und zwischen zwei MPOs |
afc_estimate, afc_statistics, afc_prefix_curve | AFC-Schätzungen von und aus den Testeinstellungen, mit Jackknife-Fehlerbalken |
Der Lernalgorithmus speichert den MPO in der Pauli-Basis. Dadurch bleibt das Modell hermitesch mit Spur eins, aber es erzwingt nicht, dass das Modell positiv semidefinit ist, weshalb das Notebook berichtet, wie negativ seine Eigenwerte werden.
Beispiel mit kleinem Simulator
Beginne mit einem System, das klein genug ist, um alles exakt zu berechnen: dem Kicked-Ising-Zustand der Tiefe eins auf acht Qubits, mit 12 % lokalem depolarisierendem Rauschen, um die Hardware zu modellieren. Da der verrauschte Zustand bekannt ist, kannst du das gelernte Modell direkt mit ihm vergleichen.
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Die Funktion kicked_ising_reference liefert den exakten Zustand als MPO. Mit depolarization=0.12 schrumpft der Bloch-Vektor jedes Qubits nach dem Circuit um 12 %.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren
Dieses Beispiel zieht Messergebnisse klassisch, daher gibt es keinen Circuit zu transpilieren. Das Hardware-Beispiel behandelt diesen Schritt.
Schritt 3: Ausführung mit Qiskit-Primitiven
Verwende RandomMeas.jl, um 2.048 Haar-zufällige Messeinstellungen zu ziehen und aus jeder 256 Shots zu samplen, und teile die Einstellungen dann gleichmäßig in Trainings- und Testmengen auf. Teile nach Einstellung und nicht nach Shot auf: Shots derselben Einstellung teilen sich deren Rotationen, sind also nicht unabhängig.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Schritt 4: Nachbearbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
Lerne das Modell mit den Tiefe-eins-Parametern des Papers: Fenster, die sich Qubits zu jeder Seite des aktualisierten Tensors erstrecken, eine Bonddimension von 4 und 20 Sweeps, beginnend mit dem maximal gemischten Zustand. Der erste Sweep aktualisiert benachbarte Tensorpaare, wodurch die Bonddimension von 1 auf 4 wachsen kann; jeder spätere Sweep aktualisiert jeweils einen Tensor bei dieser festen Bonddimension.
Um das statistische Rauschen der Shadows zu verringern, verwendet das Paper gemeinsame randomisierte Messungen (CRM) [5]. Für jede Einstellung subtrahiert es den mittleren Shadow, den eine Vorabschätzung des Zustands in derselben Einstellung erzeugen würde, und addiert dann den exakten Wert des Priors wieder hinzu. Die Korrektur mittelt sich zu null, sodass der Prior die Größe des statistischen Fehlers ändert, nicht aber, was geschätzt wird. Hier ist der Prior der ideale Zustand mit 10 % lokaler Depolarisation, nahe an den wahren 12 %. Auf Hardware ist das Rauschniveau unbekannt, daher passt das Hardware-Beispiel den Prior stattdessen an gemessene Reinheiten an, wie es das Paper tut.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
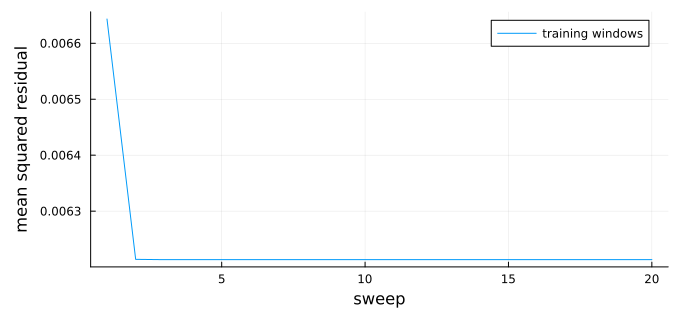
Das Residuum misst, wie weit die Fenster des Modells von den Trainings-Shadows entfernt sind. Es sinkt, wenn die Ein-Site-Updates im zweiten Sweep beginnen, und bleibt dann ungefähr konstant, statt null zu erreichen, weil die Shadows statistisches Rauschen enthalten, das ein Modell mit kleiner Bonddimension nicht reproduzieren kann.
Da dieser Zustand bekannt ist, kannst du das gelernte Modell exakt mit ihm vergleichen und außerdem die beiden einfachsten Schätzungen mit ihm vergleichen: den CRM-Prior und den idealen Zustand.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Das gelernte Modell liegt näher am verrauschten Zustand als der Prior oder der ideale Zustand, hat also das Rauschen aus den Daten gelernt. Seine kleinen negativen Eigenwerte stammen von der endlichen Anzahl an Messungen.
Auf Hardware ist der Zustand unbekannt, daher schätzt du stattdessen aus den Testeinstellungen ab. AFC teilt die Kette in Blöcke aus je Qubits und nähert die Reinheit an durch
und durch dasselbe Verhältnis lokaler Überlappungen. Mit decken die beiden Blöcke alle acht Qubits ab und die Formel ist exakt; mit stützt sie sich auf die Faktorisierungsannahme. Die Jackknife-Fehlerbalken, die jeweils eine Testeinstellung auslassen, erfassen nur den statistischen Fehler der Testdaten, nicht die Zufälligkeit des Trainings oder die AFC-Näherung.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Beide zurückgehaltenen Schätzungen stimmen innerhalb ihrer Fehlerbalken mit dem exakten Wert überein.
Hardware-Beispiel im großen Maßstab
Führe nun das Experiment auf einer 96-Qubit-Kette von ibm_fez aus, einem Heron-r2-Prozessor. Wie ibm_brisbane hat er eine Heavy-Hex-Kopplungskarte und ein ähnliches Rauschniveau.
Die Datenerfassung dauert 1.024 Sampler-Jobs und etwa 34 Minuten QPU-Zeit. Wenn du keinen Zugriff auf eine QPU mit mindestens 96 Qubits hast oder die Warteschlange lang ist, führe das Hardware-Beispiel mit den am 27. September 2026 auf ibm_fez aufgezeichneten Messungen aus, die die in diesem Tutorial gezeigten Ergebnisse geliefert haben. Mit use_saved_data = true lädt das Notebook diese Messungen (15 MB) in Schritt 1 von Zenodo [6] herunter und überspringt die Job-Übermittlung in Schritt 3. Setze den Wert auf false, um eigene Daten zu erfassen.
use_saved_data = true; # set to false to collect new measurements on hardware
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Jede Einstellung benötigt einen Circuit: den Kicked-Ising-Circuit, ein -Gate auf jedem Qubit für und eine Messung jedes Qubits. Wenn du ziehst, wobei , und gleichverteilt in sind, ist Haar-zufällig. Die Funktion u3_matrix gibt die Matrix von zurück, die Schritt 4 verwendet.
Das Budget beträgt 1.024 Einstellungen mit je 1.024 Shots, also halb so viele Einstellungen wie in der Veröffentlichung, gleichmäßig aufgeteilt auf Training und Test. Wenn gespeicherte Daten vorhanden sind, lädt die Zelle die aufgezeichneten Winkel. Andernfalls zieht sie neue Winkel und speichert sie, bevor du etwas einreichst, weil du die Ergebnisse ohne sie nicht auswerten kannst. Wenn die Datei bereits existiert, lädt die Zelle sie, sodass die Winkel auch nach einem Neustart der Session noch zu den gespeicherten Ergebnissen passen.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Schritt 2: Problem für die Ausführung auf Quantenhardware optimieren
Eine Kette ist nur so gut wie ihr schlechtestes Qubit, also wähle die 96 physischen Qubits selbst aus. Die Funktion transpile von Qiskit.jl kann noch kein festes anfängliches Layout akzeptieren, und in einem Test auf ibm_phoenix enthielt das gewählte Layout ein Qubit mit 51 % Auslesefehler. Die folgende Kette ist der 96-Qubit-Pfad in der Coupling Map von ibm_fez, den das fehlerbewusste Layout der Python-Funktion Qiskit transpile (mit optimization_level=3) aus den Kalibrierungsdaten vom 27. September 2026 ausgewählt hat. Ihr mittlerer Auslesefehler beträgt 1,6 %, aber ein Heavy-Hex-Gitter hat nur wenige 96-Qubit-Pfade, und dieser enthält Qubit 35 mit einem Auslesefehler von 15 %. Kalibrierungen ändern sich, also wähle eine neue Kette aus den aktuellen Kalibrierungsdaten, bevor du an einem anderen Tag oder auf einer anderen QPU ausführst.
Um diese Kette beizubehalten, schreibe die Circuits direkt in nativen Gates, statt sie zu transpilieren. Ein -Gate entspricht bis auf eine globale Phase . Diese Zerlegung deckt sowohl die zufälligen Rotationen als auch den Kick ab. Das Gate entspricht bis auf eine globale Phase einem CZ-Gate, gefolgt von auf beiden Qubits. Da diese -Gates diagonal sind, kommutieren sie mit den CZ-Gates, sodass jedes Qubit vor seiner Messrotation ein pro Bindung ansammelt.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Schritt 3: Mit Qiskit-Primitiven ausführen
QiskitIBMRuntime.jl führt pro Sampler-Job einen Circuit aus, daher erfordert das Sammeln der Daten 1.024 Jobs. Die folgende Zelle hält bis zu 32 Jobs in der Warteschlange und speichert die Ergebnisse jeder Einstellung, sobald ihr Job abgeschlossen ist. Jeder Shot wird als Vektor von Bits zurückgegeben, in dem Element das Ergebnis von Ketten-Qubit ist.
Du musst die Ergebnisse in derselben Session abrufen, die die Jobs eingereicht hat, weil QiskitIBMRuntime.jl einen Job noch nicht anhand seiner ID nachschlagen kann (qiskit-ibm-runtime-c issue #28). Wenn ein Job fehlschlägt, gibt die Zelle eine Warnung aus und läuft weiter. Wenn die Session endet, führe die Schritte 1 bis 3 erneut aus. Wenn du die Zelle erneut ausführst, reicht sie nur die Einstellungen ein, deren Ergebnisse fehlen. Mit use_saved_data = true reicht die Zelle nichts ein.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Schritt 4: Nachverarbeitung und Rückgabe des Ergebnisses im gewünschten klassischen Format
Dieser Schritt liest nur gespeicherte Daten: den heruntergeladenen Lauf auf ibm_fez, wenn use_saved_data wahr ist, oder andernfalls die Dateien, die Schritt 3 geschrieben hat. Du kannst ihn daher in einer neuen Session ausführen, ohne Jobs einzureichen (führe zuerst die Setup-Zelle, die Zelle use_saved_data und Schritt 1 aus). Die heruntergeladene Datei speichert die 96 Ergebnisse jedes Shots in 12 Bytes gepackt, mit dem höchstwertigen Bit zuerst, daher entpackt der Loader sie. RandomMeas.jl bezeichnet die Ergebnisse mit 1 und 2, daher addiert der Loader außerdem 1 zu jedem Bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Prüfe die Daten vor dem Lernen. Ein defektes Qubit oder ein schlecht kalibriertes Gate macht den gemessenen Zustand in seiner Umgebung deutlich gemischter und kann dazu führen, dass der Lernalgorithmus divergiert. Die Reinheit einiger benachbarter Qubits ist ein modellfreier Benchmark für dieses Rauschen: Die Funktion get_purity aus RandomMeas.jl schätzt für ein Teilsystem , indem sie Paare von Shots derselben Einstellung vergleicht. Berechne die Rényi-2-Entropie jedes Fensters aus sechs benachbarten Qubits und vergleiche sie mit demselben Fenster des idealen Zustands. Der ideale Wert ist nicht null, weil jedes Fenster mit dem Rest der Kette verschränkt ist; Rauschen erhöht ihn, und ein defektes Qubit treibt jedes Fenster, das es enthält, zum Maximum von sechs.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
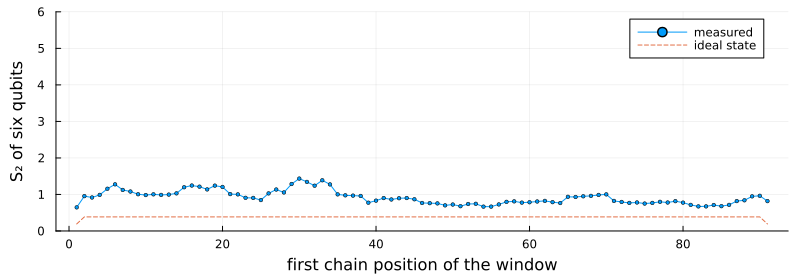
Jedes Fenster ist stärker gemischt als der ideale Zustand, um etwa ein halbes bis ein Bit, und der verrauschteste Abschnitt liegt um die Kettenpositionen 30 bis 35. Kein Fenster kommt dem Maximum von sechs nahe, daher ist kein Qubit defekt, und die Analyse verwendet die gesamte 96-Qubit-Kette. Hätten einige Fenster eine Entropie nahe sechs, würdest du das Qubit entfernen, das diese Fenster gemeinsam haben, und den längsten Teil der Kette ohne es lernen.
Dieselben Reinheiten bestimmen den CRM-Prior. Für jedes Fenster nimmt fitted_prior den idealen Zustand und passt eine lokale Depolarisationsstärke so an, dass seine Reinheit wie in der Veröffentlichung der in den Trainingseinstellungen gemessenen Reinheit entspricht.
Die Funktion learn_and_validate in der folgenden Zelle führt den Rest der Analyse durch. Sie lernt das Modell aus den Trainingseinstellungen und schätzt dann und auf den Testeinstellungen für die ersten Qubits der Kette, in Schritten von 12. Das sind die Größen in Abbildung 1(c,d) der Veröffentlichung. Der ideale Zustand wird als Baseline auf denselben Testdaten ausgewertet.
Die Zelle führt die Funktion mit aus und wiederholt sie dann mit und , um zu sehen, wie stark die Größe der Lernfenster ins Gewicht fällt. Die Bonddimension kann höchstens betragen, daher lernt einen Produktzustand: jedes Qubit für sich, ohne Korrelationen zwischen den Qubits.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
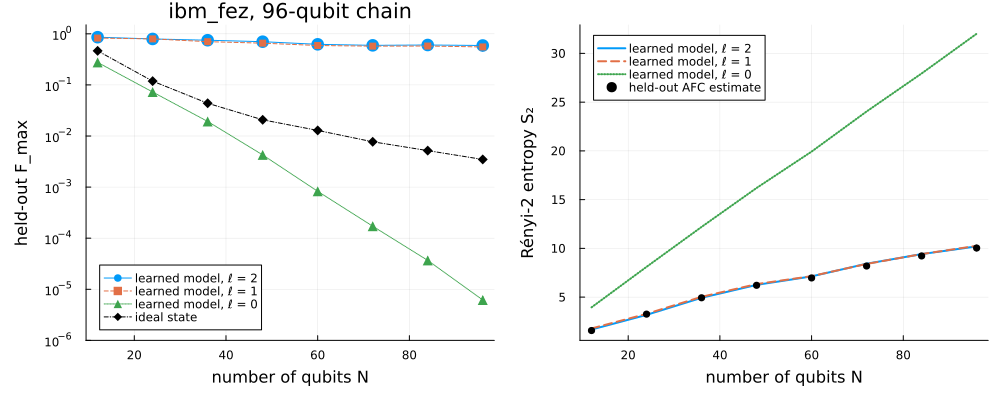
Die Ergebnisse reproduzieren beide Aussagen der Veröffentlichung auf einem anderen Prozessor:
-
Das Modell beschreibt die Daten weit besser als der ideale Zustand. Bei beträgt das zurückgehaltene des -Modells 0,59 ± 0,10, verglichen mit 0,0035 für den idealen Zustand. Die Veröffentlichung berichtet etwa 0,75 auf
ibm_brisbane. -
Die Entropie des Modells stimmt bei jedem mit den Testdaten überein. Bei beträgt sie 10,2 vom Modell und 10,0 ± 0,3 aus den Testdaten, also , verglichen mit 0,14 bis 0,15 auf dem älteren
ibm_brisbane.
Der Vergleich der Fenstergrößen zeigt, wo die Information steckt. Mit ist das Modell fast ebenso gut (), daher tragen Korrelationen jenseits weniger Qubits bei diesen Daten wenig bei. Mit verfehlt der Produktzustand die Verschränkung zwischen benachbarten Qubits: Seine Entropie wächst auf 32 statt 10, und sein fällt noch schneller als das des idealen Zustands, auf bei .
Beachte beim Lesen dieser Zahlen die folgenden Einschränkungen:
-
Trainingsaufteilung. Die Fehlerbalken decken nur den statistischen Fehler der Testdaten ab. Andere zufällige Aufteilungen derselben Einstellungen ergeben zwischen 0,49 und 0,59 bei für .
-
Letzter Durchlauf. Der Lernalgorithmus gibt immer das Modell aus dem letzten Durchlauf zurück, daher beeinflussen die Testdaten das Modell nie.
-
Positivität. Das Modell ist nicht auf positiv semidefinit beschränkt; sein negativster Eigenwert in einem Lernfenster beträgt etwa . Sein und beschreiben daher einen Operator, keine zertifizierten Eigenschaften eines physikalischen Zustands.
-
Faktorisierung. Jede zurückgehaltene Schätzung beruht auf der AFC-Annahme, die die Messungen selbst nicht zertifizieren können.
Nächste Schritte
-
Wiederhole das Experiment bei Tiefe zwei mit den Parametern der Veröffentlichung für diese Tiefe ( und eine maximale Bonddimension von 8) und bestimme, wie viele Messeinstellungen der Lernalgorithmus benötigt.
-
Lerne stattdessen mit dem Zwei-Site-Update (
update=:two_siteintraining_marginalsundlearn_mpo), das die Bonddimension nach jedem Schritt abschneidet, und sieh dir an, wie es sich mit weniger Trainingseinstellungen verhält. -
Lerne ohne den CRM-Prior (
prior=nothing) und vergleiche die zurückgehaltene Fidelity. -
Wende dieselbe Analyse auf die veröffentlichten
ibm_brisbane-Messungen der Autoren an. -
Lies das Supplement der Veröffentlichung für die Herleitung des Updates und der AFC-Schätzer.
-
Erkunde andere Protokolle für randomisierte Messungen in den
RandomMeas.jl-Beispielen.
Referenzen
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174