Instanzen und Erweiterungen
Dieses Kapitel behandelt mehrere quantenvariationelle Algorithmen, darunter
Anhand dieser Algorithmen lernen wir verschiedene Designideen kennen, die in maßgeschneiderte variationelle Algorithmen einfließen können, etwa Gewichte, Strafterme, Over-Sampling und Under-Sampling. Wir laden dich ein, mit diesen Konzepten zu experimentieren und deine Ergebnisse mit der Community zu teilen.
Das Qiskit-Patterns-Framework gilt für all diese Algorithmen – die einzelnen Schritte heben wir jedoch nur beim ersten Beispiel explizit hervor.
Variational Quantum Eigensolver (VQE)
VQE ist einer der meistgenutzten variationellen Quantenalgorithmen und dient als Vorlage für viele weitere Algorithmen.
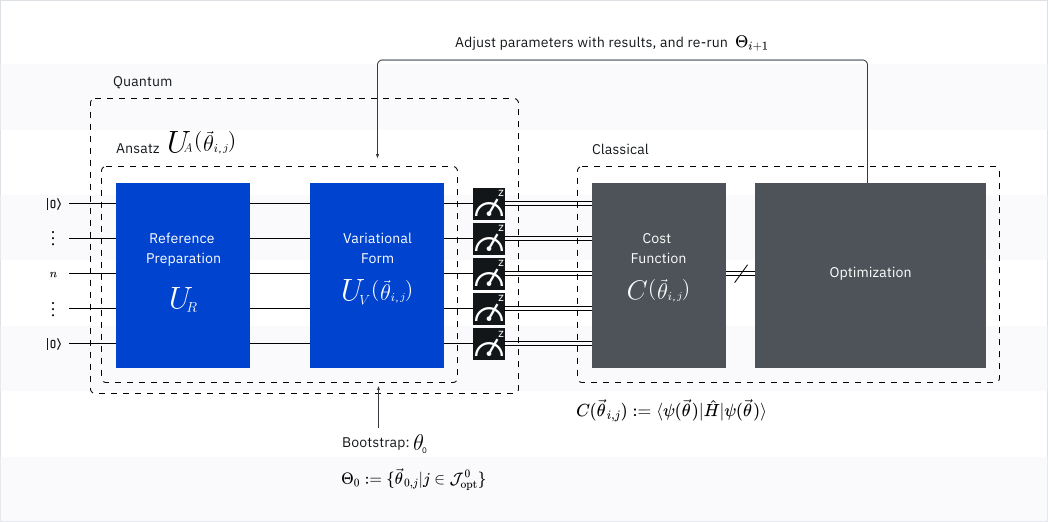
Schritt 1: Klassische Eingaben auf ein Quantenproblem abbilden
Theoretischer Aufbau
Der Aufbau von VQE ist einfach:
-
Vorbereitung der Referenzoperatoren
- Wir starten vom Zustand und gehen zum Referenzzustand über
-
Anwenden der Variationsform , um einen Ansatz zu erzeugen
- Wir gehen vom Zustand zu über
-
Bootstrapping bei , falls ein ähnliches Problem bekannt ist (typischerweise durch klassische Simulation oder Sampling gefunden)
- Jeder Optimierer wird unterschiedlich gebootstrapped, was zu einer initialen Menge von Parametervektoren führt (zum Beispiel aus einem Startpunkt ).
-
Auswerten der Kostenfunktion für alle vorbereiteten Zustände auf einem Quantencomputer.
-
Verwendung eines klassischen Optimierers zur Auswahl des nächsten Parametersatzes .
-
Wiederholung des Prozesses bis zur Konvergenz.
Dies ist eine einfache klassische Optimierungsschleife, in der wir die Kostenfunktion auswerten. Einige Optimierer benötigen möglicherweise mehrere Auswertungen, um einen Gradienten zu berechnen, die nächste Iteration zu bestimmen oder die Konvergenz zu beurteilen.
Hier das Beispiel für den folgenden Operator:
Implementierung
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import TwoLocal
import numpy as np

theta_list = (2 * np.pi * np.random.rand(1, 8)).tolist()
observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])

reference_circuit = QuantumCircuit(2)
reference_circuit.x(0)

variational_form = TwoLocal(
    2,
    rotation_blocks=["rz", "ry"],
    entanglement_blocks="cx",
    entanglement="linear",
    reps=1,
)

ansatz = reference_circuit.compose(variational_form)

ansatz.decompose().draw("mpl")

def cost_func_vqe(parameters, ansatz, hamiltonian, estimator):
    """Return estimate of energy from estimator

    Parameters:
        params (ndarray): Array of ansatz parameters
        ansatz (QuantumCircuit): Parameterized ansatz circuit
        hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
        estimator (Estimator): Estimator primitive instance

    Returns:
        float: Energy estimate
    """

    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])
    estimator_result = estimator_job.result()[0]

    cost = estimator_result.data.evs[0]
    return cost
from qiskit.primitives import StatevectorEstimator

estimator = StatevectorEstimator()
Mit dieser Kostenfunktion können wir die optimalen Parameter berechnen:
# SciPy minimizer routine
from scipy.optimize import minimize

x0 = np.ones(8)

result = minimize(
    cost_func_vqe, x0, args=(ansatz, observable, estimator), method="COBYLA"
)

result
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999982445723
       x: [ 1.741e+00  9.606e-01  1.571e+00  2.115e-05  1.899e+00
            1.243e+00  6.063e-01  6.063e-01]
    nfev: 136
   maxcv: 0.0
Schritt 2: Problem für die Quantenausführung optimieren
Wir wählen das am wenigsten ausgelastete Backend und importieren die notwendigen Komponenten aus qiskit_ibm_runtime.
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit_ibm_runtime import EstimatorV2 as Estimator
from qiskit_ibm_runtime import Session, EstimatorOptions
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)
print(backend)
<IBMBackend('ibm_brisbane')>
Wir transpilieren den Circuit mit dem voreingestellten Pass-Manager bei Optimierungslevel 3 und wenden das entsprechende Layout auf den Operator an.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pm = generate_preset_pass_manager(backend=backend, optimization_level=3)
isa_ansatz = pm.run(ansatz)
isa_observable = observable.apply_layout(layout=isa_ansatz.layout)
Schritt 3: Mit IBM Quantum Primitives ausführen
Jetzt sind wir bereit, unsere Berechnung auf IBM Quantum®-Hardware auszuführen. Da die Minimierung der Kostenfunktion hochgradig iterativ ist, starten wir eine Runtime-Session. So müssen wir nur einmal in der Warteschlange warten. Sobald der Job läuft, wird jede Iteration mit aktualisierten Parametern sofort ausgeführt.
x0 = np.ones(8)

estimator_options = EstimatorOptions(resilience_level=1, default_shots=10_000)

with Session(backend=backend) as session:
    estimator = Estimator(mode=session, options=estimator_options)

    result = minimize(
        cost_func_vqe,
        x0,
        args=(isa_ansatz, isa_observable, estimator),
        method="COBYLA",
        options={"maxiter": 200, "disp": True},
    )
session.close()
print(result)
Schritt 4: Nachverarbeitung und Rückgabe des Ergebnisses im klassischen Format
Wir sehen, dass die Minimierungsroutine erfolgreich beendet wurde, was bedeutet, dass wir die Standardtoleranz des klassischen COBYLA-Optimierers erreicht haben. Falls ein genaueres Ergebnis benötigt wird, kann eine kleinere Toleranz angegeben werden. Das könnte tatsächlich der Fall sein, da das Ergebnis mehrere Prozent von dem abwich, das der Simulator oben lieferte.
Der Wert von x ist der aktuelle beste Schätzwert für die Parameter, die die Kostenfunktion minimieren. Bei weiterer Iteration für höhere Präzision sollten diese Werte anstelle der anfänglich verwendeten x0 (ein Vektor aus Einsen) eingesetzt werden.
Abschließend sei erwähnt, dass die Funktion im Verlauf der Optimierung 96 Mal ausgewertet wurde. Das kann sich von der Anzahl der Optimierungsschritte unterscheiden, da manche Optimierer in einem einzigen Schritt mehrere Funktionsauswertungen benötigen, etwa bei der Gradientenabschätzung.
Subspace Search VQE (SSVQE)
SSVQE ist eine Variante von VQE, die es ermöglicht, die ersten Eigenwerte eines Operators mit Eigenwerten zu bestimmen, wobei . Ohne Beschränkung der Allgemeinheit nehmen wir an, dass . SSVQE führt eine neue Idee ein: das Hinzufügen von Gewichten, um die Optimierung des Terms mit dem größten Gewicht zu priorisieren.
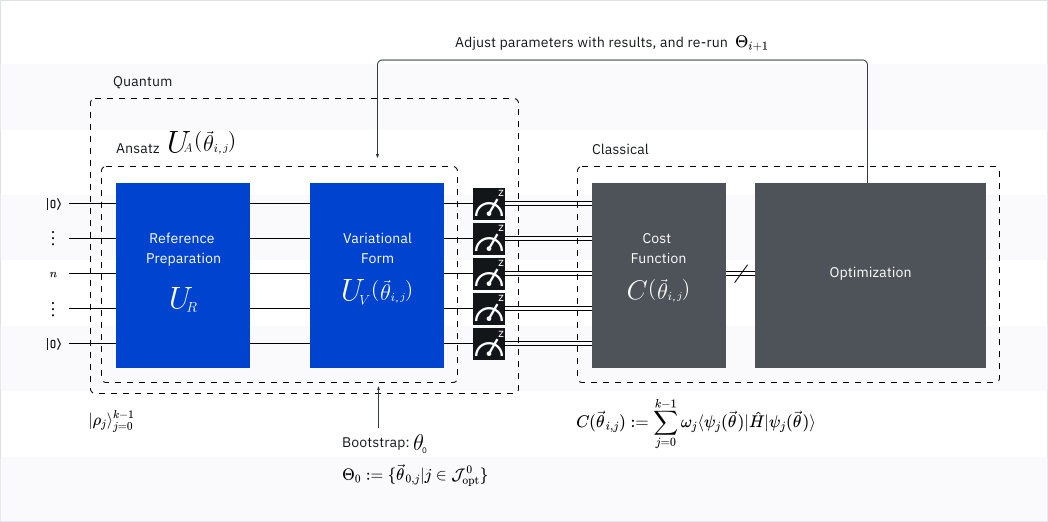
Zur Implementierung dieses Algorithmus benötigen wir gegenseitig orthogonale Referenzzustände , d.h. für . Diese Zustände können mithilfe von Pauli-Operatoren konstruiert werden. Die Kostenfunktion dieses Algorithmus lautet dann:
wobei eine beliebige positive Zahl ist, sodass für gilt , und die benutzerdefinierte Variationsform ist.
Der SSVQE-Algorithmus beruht auf der Tatsache, dass Eigenzustände zu verschiedenen Eigenwerten gegenseitig orthogonal sind. Konkret lässt sich das Skalarprodukt von und wie folgt ausdrücken:
Die erste Gleichheit gilt, weil ein Quantenoperator und daher unitär ist. Die letzte Gleichheit folgt aus der Orthogonalität der Referenzzustände . Die Tatsache, dass Orthogonalität durch unitäre Transformationen erhalten bleibt, hängt tief mit dem Prinzip der Informationserhaltung in der Quanteninformationstheorie zusammen. Aus dieser Perspektive stellen nicht-unitäre Transformationen Prozesse dar, bei denen Information entweder verloren geht oder hinzugefügt wird.
Die Gewichte helfen sicherzustellen, dass alle Zustände Eigenzustände sind. Wenn die Gewichte hinreichend verschieden sind, wird dem Term mit dem größten Gewicht () bei der Optimierung Vorrang vor den anderen eingeräumt. Infolgedessen wird der resultierende Zustand der Eigenzustand zu . Da gegenseitig orthogonal sind, sind die verbleibenden Zustände orthogonal zu ihm und liegen daher im Unterraum der Eigenwerte .
Wendet man das gleiche Argument auf die übrigen Terme an, so hat der Term mit Gewicht die nächste Priorität: wird der Eigenzustand zu , und die anderen Terme liegen im Eigenraum von .
Durch induktives Schlussfolgern ergibt sich, dass ein näherungsweiser Eigenzustand zu für ist.
Theoretischer Aufbau
SSVQE lässt sich wie folgt zusammenfassen:
-
Vorbereitung mehrerer Referenzzustände durch Anwenden eines unitären Operators U_R auf verschiedene Rechenbasiszustände
- Dieser Algorithmus erfordert gegenseitig orthogonale Referenzzustände , sodass für .
-
Anwenden der Variationsform auf jeden Referenzzustand, was den folgenden Ansatz ergibt.
-
Bootstrapping bei , falls ein ähnliches Problem verfügbar ist (üblicherweise durch klassische Simulation oder Sampling gefunden).
-
Auswerten der Kostenfunktion für alle vorbereiteten Zustände auf einem Quantencomputer.
-
Dies lässt sich aufteilen in die Berechnung des Erwartungswerts für einen Operator und die Multiplikation dieses Ergebnisses mit .
-
Anschließend gibt die Kostenfunktion die Summe aller gewichteten Erwartungswerte zurück.
-
-
Verwendung eines klassischen Optimierers zur Bestimmung des nächsten Parametersatzes .
-
Wiederholung der obigen Schritte bis zur Konvergenz.
Die Kostenfunktion von SSVQE wirst du in der Aufgabe selbst implementieren. Das folgende Snippet soll dir dabei als Orientierung dienen:
import numpy as np

def cost_func_ssvqe(
    params, initialized_anastz_list, weights, ansatz, hamiltonian, estimator
):
    # """Return estimate of energy from estimator

    # Parameters:
    #     params (ndarray): Array of ansatz parameters
    #     initialized_anastz_list (list QuantumCircuit): Array of initialised ansatz with reference
    #     weights (list): List of weights
    #     ansatz (QuantumCircuit): Parameterized ansatz circuit
    #     hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
    #     estimator (Estimator): Estimator primitive instance

    # Returns:
    #     float: Weighted energy estimate
    # """

    energies = []

    # Define SSVQE

    weighted_energy_sum = np.dot(energies, weights)
    return weighted_energy_sum
Variational Quantum Deflation (VQD)
VQD ist eine iterative Methode, die VQE erweitert, um die ersten Eigenwerte eines Operators mit Eigenwerten zu berechnen (wobei ), anstatt nur den ersten. Für den Rest dieses Abschnitts nehmen wir ohne Beschränkung der Allgemeinheit an, dass . VQD führt das Konzept eines Strafterms ein, um den Optimierungsprozess zu steuern.
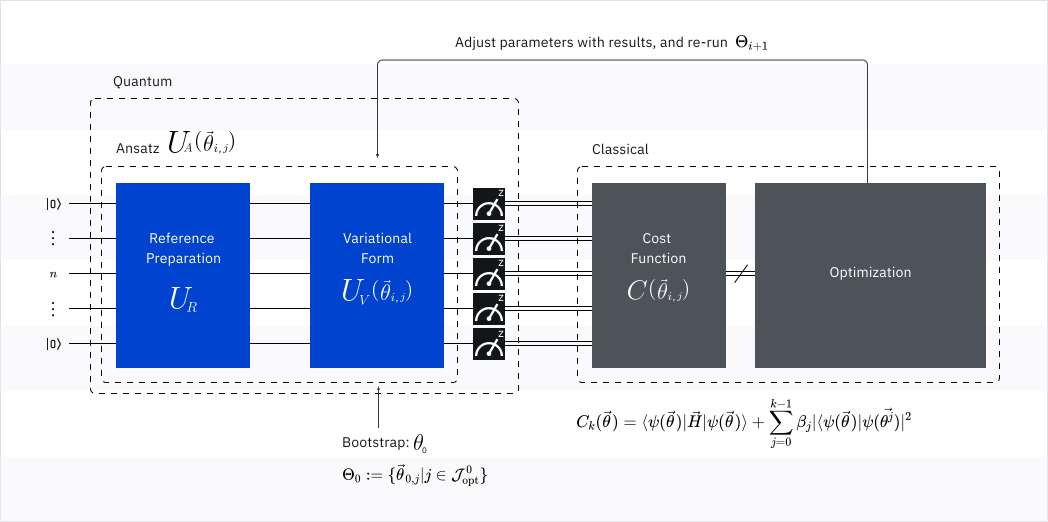 VQD führt einen Strafterm ein, um den Beitrag jedes Überlappterms zu den Kosten auszubalancieren. Dieser Strafterm bestraft den Optimierungsprozess, wenn Orthogonalität nicht erreicht wird. Wir erzwingen diese Bedingung, weil die Eigenzustände eines Operators (oder eines hermiteschen Operators) zu verschiedenen Eigenwerten stets gegenseitig orthogonal sind – oder im Fall von Entartung so gewählt werden können. Indem wir Orthogonalität zum Eigenzustand von erzwingen, optimieren wir effektiv im Unterraum der übrigen Eigenwerte . Dabei ist der kleinste Eigenwert aus dem Rest, und die optimale Lösung des neuen Problems kann mit dem Variationsprinzip gefunden werden.
Die Grundidee hinter VQD ist es, VQE wie gewohnt zu verwenden, um den kleinsten Eigenwert zusammen mit dem zugehörigen (näherungsweisen) Eigenzustand für einen optimalen Parametervektor zu erhalten. Um dann den nächsten Eigenwert zu erhalten, minimieren wir statt die folgende Kostenfunktion:
Der positive Wert sollte idealerweise größer als sein.
Dies führt zu einer neuen Kostenfunktion, die als eingeschränktes Problem betrachtet werden kann, bei dem wir unter der Bedingung minimieren, dass der Zustand orthogonal zum zuvor erhaltenen sein muss, wobei als Strafterm wirkt, falls die Bedingung nicht erfüllt ist.
Alternativ kann dieses neue Problem als VQE mit dem neuen Operator interpretiert werden:
Wenn die Lösung des neuen Problems ist, sollte der Erwartungswert von (nicht ) gleich sein. Um den dritten Eigenwert zu erhalten, lautet die zu minimierende Kostenfunktion:
wobei eine positive Konstante ist, die groß genug ist, um die Orthogonalität des Lösungszustands zu sowohl als auch zu erzwingen. Dies bestraft Zustände im Suchraum, die diese Bedingung nicht erfüllen, und schränkt den Suchraum dadurch effektiv ein. Die optimale Lösung des neuen Problems sollte also der Eigenzustand zu sein.
Wie im vorherigen Fall kann dieses neue Problem ebenfalls als VQE mit dem Operator interpretiert werden:
Ist die Lösung dieses neuen Problems , so sollte der Erwartungswert von (nicht ) gleich sein. Analog dazu würde man zur Berechnung des -ten Eigenwerts die folgende Kostenfunktion minimieren:
Zur Erinnerung: Wir haben so definiert, dass . Dieses Problem ist äquivalent zur Minimierung von unter der Bedingung, dass der Zustand orthogonal zu ist, und schränkt damit den Suchraum auf den Unterraum der Eigenwerte ein.
Dieses Problem ist äquivalent zu VQE mit dem Operator:
Wie aus dem Prozess ersichtlich wird, benötigt man zur Berechnung des -ten Eigenwerts die (näherungsweisen) Eigenzustände der vorherigen Eigenwerte, d.h. VQE muss insgesamt Mal ausgeführt werden. Die Kostenfunktion von VQD lautet daher:
Theoretischer Aufbau
Der Aufbau von VQD lässt sich wie folgt zusammenfassen:
-
Vorbereitung eines Referenzoperators
-
Anwenden der Variationsform auf den Referenzzustand, wodurch die folgenden Ansätze entstehen
-
Bootstrapping bei , falls ein ähnliches Problem bekannt ist (typischerweise durch klassische Simulation oder Sampling gefunden).
-
Auswerten der Kostenfunktion , die die Berechnung von angeregten Zuständen und ein Array von -Werten für den Überlapp-Strafterm jedes Überlappterms umfasst.
-
Berechnung des Erwartungswerts für einen Operator für jedes
-
Berechnung des Strafterms .
-
Die Kostenfunktion gibt dann die Summe dieser beiden Terme zurück
-
-
Verwendung eines klassischen Optimierers zur Auswahl des nächsten Parametersatzes .
-
Wiederhole diesen Prozess, bis Konvergenz erreicht ist.
Implementierung
Für diese Implementierung erstellen wir eine Funktion für einen Überlapp-Strafterm. Dieser Strafterm wird in der Kostenfunktion bei jeder Iteration verwendet. Dieser Prozess wird für jeden angeregten Zustand wiederholt.
from qiskit.circuit.library import TwoLocal

ansatz = TwoLocal(2, rotation_blocks=["ry", "rz"], entanglement_blocks="cz", reps=1)

ansatz.decompose().draw("mpl")

Zunächst erstellen wir eine Funktion, die die Zustandstreue berechnet – einen prozentualen Überlapp zwischen zwei Zuständen, den wir als Strafterm für VQD verwenden:
import numpy as np

def calculate_overlaps(ansatz, prev_circuits, parameters, sampler):
    def create_fidelity_circuit(circuit_1, circuit_2):
        """
        Constructs the list of fidelity circuits to be evaluated.
        These circuits represent the state overlap between pairs of input circuits,
        and their construction depends on the fidelity method implementations.
        """

        if len(circuit_1.clbits) > 0:
            circuit_1.remove_final_measurements()
        if len(circuit_2.clbits) > 0:
            circuit_2.remove_final_measurements()

        circuit = circuit_1.compose(circuit_2.inverse())
        circuit.measure_all()
        return circuit

    overlaps = []

    for prev_circuit in prev_circuits:
        fidelity_circuit = create_fidelity_circuit(ansatz, prev_circuit)
        sampler_job = sampler.run([(fidelity_circuit, parameters)])
        meas_data = sampler_job.result()[0].data.meas

        counts_0 = meas_data.get_int_counts().get(0, 0)
        shots = meas_data.num_shots
        overlap = counts_0 / shots
        overlaps.append(overlap)

    return np.array(overlaps)
Jetzt ist es Zeit, die Kostenfunktion von VQD zu schreiben. Wie zuvor bei der Berechnung nur des Grundzustands bestimmen wir den niedrigsten Energiezustand mit dem Estimator-Primitive. Wie oben beschrieben fügen wir nun jedoch einen Strafterm hinzu, um die Orthogonalität höherenergetischer Zustände sicherzustellen. Das heißt, für jeden neuen angeregten Zustand wird ein Strafterm für jeden Überlapp zwischen dem aktuellen variationellen Zustand und den bereits gefundenen niederenergetischen Eigenzuständen hinzugefügt.
def cost_func_vqd(
    parameters, ansatz, prev_states, step, betas, estimator, sampler, hamiltonian
):
    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])

    total_cost = 0

    if step > 1:
        overlaps = calculate_overlaps(ansatz, prev_states, parameters, sampler)
        total_cost = np.sum(
            [np.real(betas[state] * overlap) for state, overlap in enumerate(overlaps)]
        )

    estimator_result = estimator_job.result()[0]

    value = estimator_result.data.evs[0] + total_cost

    return value
Beachte insbesondere, dass die obige Kostenfunktion auf die calculate_overlaps-Funktion verweist, die tatsächlich einen neuen Quantencircuit erstellt. Wenn wir auf echter Hardware ausführen möchten, muss auch dieser neue Circuit transpiliert werden – idealerweise auf optimale Weise für das gewählte Backend. Beachte, dass die Transpilierung nicht in die Funktionen calculate_overlaps oder cost_func_vqd eingebaut wurde. Du kannst versuchen, den Code selbst anzupassen, um diese zusätzliche (bedingte) Transpilierung einzubauen – das wird aber auch in der nächsten Lektion für dich erledigt.
In dieser Lektion führen wir den VQD-Algorithmus mit dem Statevector Sampler und Statevector Estimator aus:
from qiskit.primitives import StatevectorEstimator as Estimator

sampler = Sampler()
estimator = Estimator()
Wir führen einen zu schätzenden Operator ein. In der nächsten Lektion werden wir diesem einen physikalischen Kontext geben, etwa den angeregten Zustand eines Moleküls. Es kann hilfreich sein, sich diesen Operator als den Hamiltonoperator eines Systems mit angeregten Zuständen vorzustellen, auch wenn er keinem bestimmten Molekül oder Atom entspricht.
from qiskit.quantum_info import SparsePauliOp

observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])
Hier legen wir die Gesamtanzahl der zu berechnenden Zustände fest (Grundzustand und angeregte Zustände, k) sowie die Strafterme (betas) für den Überlapp zwischen Zustandsvektoren, die orthogonal sein sollten. Die Folgen einer zu hohen oder zu niedrigen Wahl der betas werden in der nächsten Lektion etwas näher untersucht. Vorerst verwenden wir einfach die unten angegebenen Werte. Wir starten mit lauter Nullen als Parameter. In eigenen Berechnungen möchtest du vielleicht geschicktere Startparameter wählen, die auf deinem Wissen über das System oder auf vorherigen Berechnungen basieren.
k = 3
betas = [33, 33, 33]
x0 = np.zeros(8)
Jetzt können wir die Berechnung starten:
from scipy.optimize import minimize

prev_states = []
prev_opt_parameters = []
eigenvalues = []

for step in range(1, k + 1):
    if step > 1:
        prev_states.append(ansatz.assign_parameters(prev_opt_parameters))

    result = minimize(
        cost_func_vqd,
        x0,
        args=(ansatz, prev_states, step, betas, estimator, sampler, observable),
        method="COBYLA",
        options={
            "maxiter": 200,
        },
    )
    print(result)

    prev_opt_parameters = result.x
    eigenvalues.append(result.fun)
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999979545955
       x: [-5.150e-01 -5.452e-02 -1.571e+00 -2.853e-05  2.671e-01
           -2.672e-01 -8.509e-01 -8.510e-01]
    nfev: 131
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 4.024550284767612
       x: [-3.745e-01  1.041e+00  8.637e-01  1.202e+00 -8.847e-02
            1.181e-02  7.611e-01 -3.006e-01]
    nfev: 110
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 5.608925562838559
       x: [-2.670e-01  1.280e+00  1.070e+00 -8.031e-01 -1.524e-01
           -6.956e-02  7.018e-01  1.514e+00]
    nfev: 90
   maxcv: 0.0
Die aus der Kostenfunktion erhaltenen Werte sind ungefähr -6,00; 4,02 und 5,61. Das Wichtige an diesen Ergebnissen ist, dass die Funktionswerte ansteigen. Hätten wir einen ersten angeregten Zustand erhalten, der energetisch niedriger liegt als unsere anfängliche, unbeschränkte Berechnung des Grundzustands, hätte das auf einen Fehler irgendwo in unserem Code hingedeutet.
Die Werte von x sind die Parameter, die zu einem Zustandsvektor geführt haben, der jeweils diesen Kosten (Energien) entspricht.
Abschließend sei erwähnt, dass alle drei Minimierungen innerhalb der Standardtoleranz des klassischen Optimierers (hier COBYLA) konvergiert sind. Sie erforderten 131, 110 bzw. 90 Funktionsauswertungen.
Quantum Sampling Regression (QSR)
Eines der Hauptprobleme von VQE sind die vielen Aufrufe eines Quantencomputers, die zur Bestimmung der Parameter für jeden Schritt benötigt werden – beispielsweise , und so weiter. Dies ist besonders problematisch, wenn der Zugang zu Quantengeräten in einer Warteschlange organisiert ist. Zwar kann eine Session verwendet werden, um mehrere iterative Aufrufe zu bündeln, aber ein alternativer Ansatz ist Sampling. Durch den Einsatz mehr klassischer Ressourcen lässt sich der gesamte Optimierungsprozess in einem einzigen Aufruf abschließen. Hier kommt Quantum Sampling Regression ins Spiel. Da der Zugang zu Quantencomputern nach wie vor ein knappes Gut ist, halten wir diesen Trade-off für viele aktuelle Studien für sinnvoll und praktikabel. Dieser Ansatz nutzt alle verfügbaren klassischen Möglichkeiten voll aus und erfasst dennoch viele der inneren Abläufe und intrinsischen Eigenschaften von Quantenberechnungen, die in Simulationen nicht auftreten.
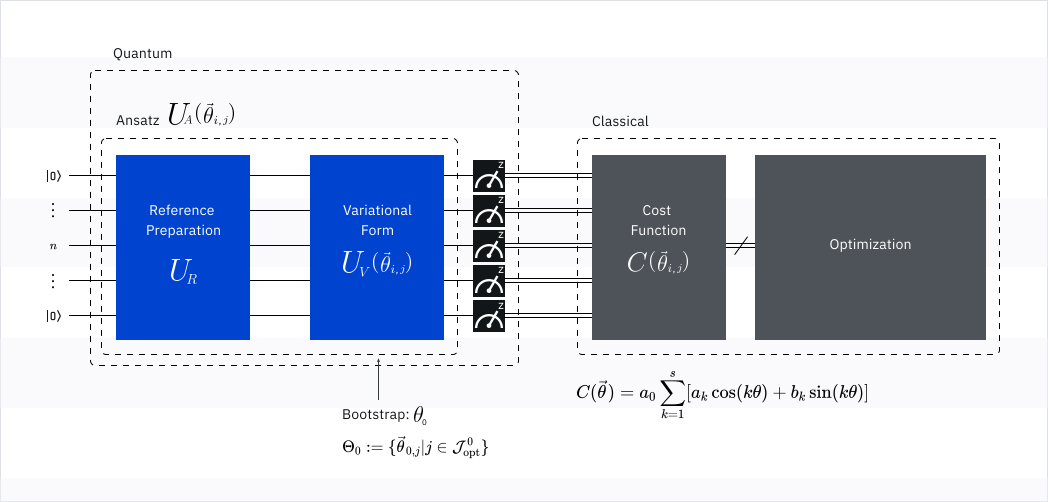
Die Idee hinter QSR ist, dass die Kostenfunktion als Fourier-Reihe folgendermaßen dargestellt werden kann:
Je nach Periodizität und Bandbreite der ursprünglichen Funktion kann die Menge endlich oder unendlich sein. Für diese Diskussion nehmen wir an, dass sie unendlich ist. Der nächste Schritt besteht darin, die Kostenfunktion mehrfach zu sampeln, um die Fourier-Koeffizienten zu erhalten. Da wir Unbekannte haben, müssen wir die Kostenfunktion Mal sampeln.
Wenn wir die Kostenfunktion für Parameterwerte sampeln, erhalten wir folgendes Gleichungssystem:
das wir als
In der Praxis ist dieses System im Allgemeinen nicht konsistent, da die Werte der Kostenfunktion nicht exakt sind. Daher ist es normalerweise sinnvoll, sie zu normalisieren, indem man sie von links mit multipliziert, was Folgendes ergibt:
Dieses neue System ist stets konsistent, und seine Lösung ist eine Least-Squares-Lösung des ursprünglichen Problems. Wenn wir Parameter statt nur einem haben und jeder Parameter sein eigenes für besitzt, dann ist die insgesamt benötigte Anzahl an Samples:
wobei . Darüber hinaus eröffnet die Anpassung von als einstellbaren Parameter (anstatt ihn abzuleiten) neue Möglichkeiten, wie zum Beispiel:
-
Over-Sampling zur Genauigkeitssteigerung.
-
Under-Sampling zur Leistungssteigerung durch Reduzierung des Laufzeit-Overheads oder Eliminierung lokaler Minima.
Theoretischer Aufbau
Der Aufbau von QSR lässt sich wie folgt zusammenfassen:
-
Vorbereitung der Referenzoperatoren .
- Wir gehen vom Zustand zum Referenzzustand über
-
Anwenden der Variationsform , um einen Ansatz zu erzeugen.
- Bestimmung der Bandbreite jedes Parameters im Ansatz. Eine obere Schranke ist ausreichend.
-
Bootstrappe bei , wenn ein ähnliches Problem vorliegt (typischerweise durch klassische Simulation oder Sampling gefunden).
-
Sampeln der Kostenfunktion mindestens Mal.
-
-
Entscheidung, ob Over-Sampling/Under-Sampling genutzt werden soll, um Geschwindigkeit und Genauigkeit durch Anpassung von abzuwägen.
-
-
Berechnung der Fourier-Koeffizienten aus den Samples (d.h. Lösung des normalisierten linearen Gleichungssystems).
-
Bestimmung des globalen Minimums der resultierenden Regressionsfunktion auf einem klassischen Rechner.
Zusammenfassung
In dieser Lektion hast du mehrere variationelle Instanzen kennengelernt:
-
Allgemeiner Aufbau
-
Einführung von Gewichten und Straftermen zur Anpassung einer Kostenfunktion
-
Exploration von Under-Sampling vs. Over-Sampling für den Trade-off zwischen Geschwindigkeit und Genauigkeit
Diese Ideen lassen sich zu einem maßgeschneiderten variationellen Algorithmus kombinieren, der zu deinem Problem passt. Wir laden dich ein, deine Ergebnisse mit der Community zu teilen. Die nächste Lektion zeigt, wie man einen variationellen Algorithmus zur Lösung einer konkreten Anwendung einsetzt.