Postselektion mit Prüfungen auf nicht-Markov'sche Fehler
Diese Anleitung erklärt, was Prüfungen auf nicht-Markov'sche Fehler sind und wie du sie mit qiskit-mitigation in Software umsetzt. Du beginnst mit einem kleinen Zwei-Qubit-Beispiel, um die Prüfungen zu visualisieren und zu besprechen, wie sie funktionieren. Nachdem du ein Gefühl dafür entwickelt hast, probierst du ein 20-Qubit-Beispiel aus, in dem du Prüfungen implementierst und verschiedene Postselektionsstrategien vergleichst.
Was sind Prüfungen auf nicht-Markov'sche Fehler?
Prüfungen auf nicht-Markov'sche Fehler sind messbasierte Tests, ob der Zustand eines Qubits wahrscheinlich durch eine nicht-Markov'sche Fehlerquelle verfälscht ist. Dieser Test wird durchgeführt, indem zu Beginn eines Circuits auf jedes Qubit ein Bit-Flip-Gate mit verlängerter Dauer (xslow oder eine Reihe von rx-Gates mit dem Winkel ) gesetzt wird, gefolgt von einem regulären XGate und einer Messung, um sicherzustellen, dass der Zustand erfolgreich von umgekippt wurde. Dieser Test kann auch am Ende des Circuits nach jeder abschließenden Messung durchgeführt werden, um sicherzustellen, dass das Gerät den gemessenen Zustand des Qubits erfolgreich von umkippen kann. Samples, die zu fehlgeschlagenen Prüfungen gehören, können als unzuverlässig betrachtet werden, und die Postselektion nur der Samples, die alle Prüfungen bestehen, kann die Fidelität der verrauschten Verteilung steigern.
Strategien zur Postselektion anhand von Prüfungen auf nicht-Markov'sche Fehler
-
Knotenbasierte Postselektion: Postselektiere nur Samples, bei denen jedes Qubit seine Prüfung(en) bestanden hat. Das ist die strengste Strategie und führt in der Regel dazu, dass mehr Samples verworfen werden.
-
Kantenbasierte Postselektion: Stelle für jede Kante im Kopplungsgraphen der Qubits sicher, dass mindestens ein Qubit die Prüfung(en) besteht. Diese Strategie ist nachsichtiger; wenn ein Qubit eine Prüfung nicht besteht, kann das Sample dennoch behalten werden, wenn alle seine Nachbarn ihre Prüfungen bestehen.
Spectator-Qubits
Man kann „Spectator“-Ancilla-Qubits angeben, die an die Qubits angrenzen, die zur Ausführung des ursprünglichen Circuits verwendet werden. Auf diesen Spectators können Prüfungen auf nicht-Markov'sche Fehler platziert werden, was mehr Abdeckung gegen das nicht-Markov'sche Rauschen bietet, das diese Prüfungen erkennen sollen.
Teil 1. Visualisiere Prüfungen auf nicht-Markov'sche Fehler
Bevor du die Technik auf einer QPU demonstrierst, erstellst du einen kleinen Zwei-Qubit-Circuit und fügst Prüfungen hinzu, um zu visualisieren, wie sie funktioniert. Beginne mit einem Bell-Zustand, der für die QPU des Backends ibm_kingston transpiliert wurde.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

Füge am Anfang des Circuits einige Prüfungen auf nicht-Markov'sche Fehler hinzu. Prüfungen werden nur auf Qubits platziert, die mit einer Messung abgeschlossen werden. Diese Prüfungen stellen sicher, dass das Gerät den Anfangszustand des Qubits erfolgreich von umkippen kann, und die Messungen dieser Prüfungen werden in einem neuen klassischen Register namens meas_pre ausgelesen.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

Ebenso kannst du am Ende des Circuits nach jeder abschließenden Messung Prüfungen hinzufügen. Diese Prüfungen stellen sicher, dass das Gerät den Zustand des Qubits von umkippen kann, und ihre Messungen werden in einem neuen klassischen Register namens meas_ps ausgelesen.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

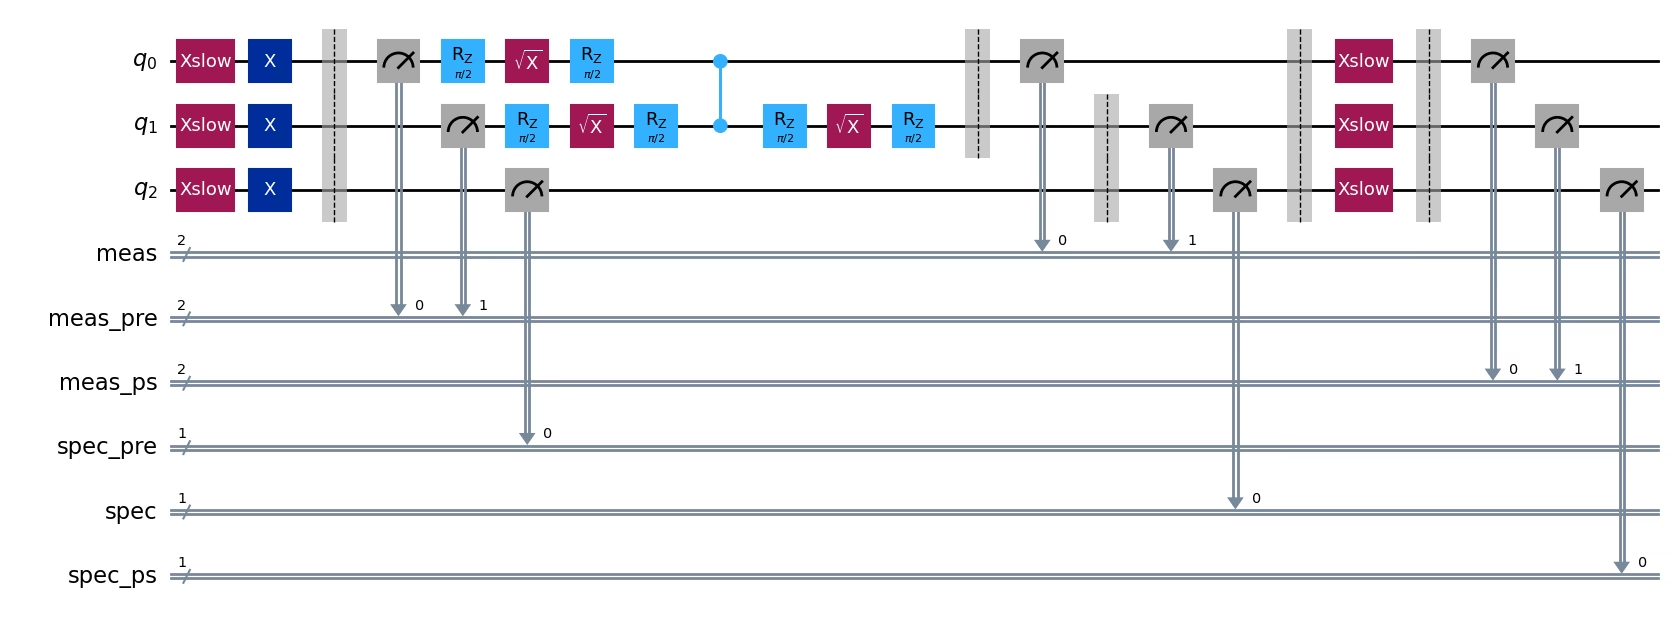
Wie in der Einleitung erwähnt, kannst du Ancilla-Qubits, die an die Daten-Qubits angrenzen, als "Zuschauer" (Spectators) verwenden, um mehr Fehlerabdeckung zu erhalten. Füge Spectator-Prüfungen vor und nach dem Circuit hinzu. Du kannst sehen, dass das physische Qubit 2 auf ibm_kingston an das Daten-Qubit 1 angrenzt, deshalb wurde es als Spectator hinzugefügt, und es wurden Prüfungen vor und nach dem Circuit ergänzt. Die Spectator-Messungen wurden in neue klassische Register namens spec_pre und spec geschrieben.
Ein solcher Circuit enthält alle möglichen nicht-markovschen Fehlerprüfungen. Das Sampling aus diesem Circuit gibt Nutzern daher die Möglichkeit, auf Basis jeder beliebigen Kombination aus Prüfungen [vor/nach] dem Circuit und Postselektionsstrategien [knoten-/kantenbasiert] zu postselektieren. In Teil 2 dieser Anleitung siehst du, wie das auf Quantenhardware funktioniert.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Teil 2: Nicht-markovsche Fehlerprüfungen auf einer QPU demonstrieren und Postselektionsstrategien vergleichen
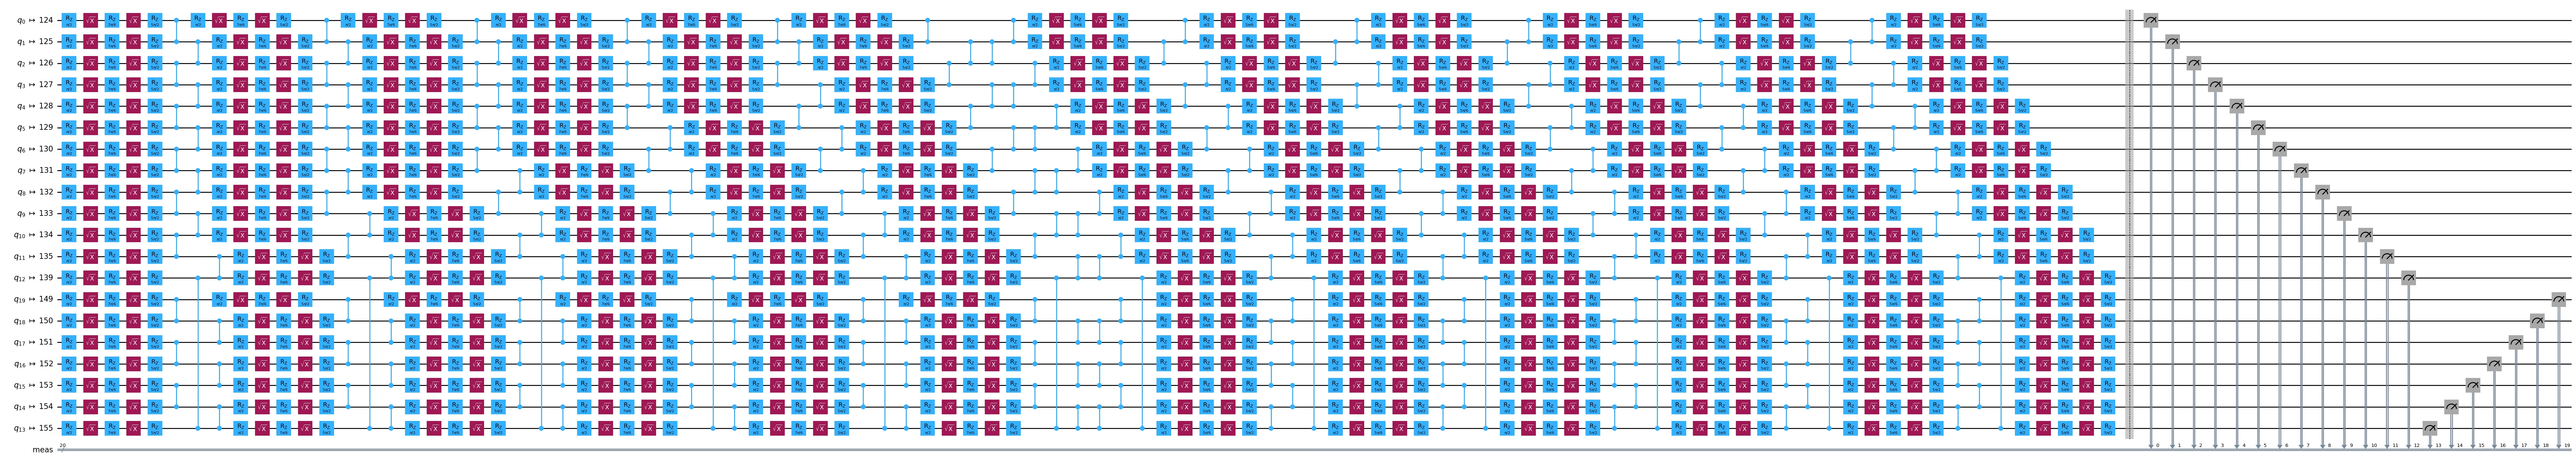
Jetzt, da du verstehst, was nicht-markovsche Fehlerprüfungen sind und wie sie in Software umgesetzt werden, kannst du ein größeres Beispiel auf einer QPU ausführen und sehen, wie es funktioniert. Bereite zunächst einen Circuit vor. Die Wahl des Circuits ist nicht sehr wichtig; du brauchst lediglich einen Circuit, dessen Ausgabe sich leicht überprüfen lässt. Hier wählen wir einen gespiegelten 1D-Ising-Circuit mit 20 Qubits. Dieser Circuit ist auf Hardware nicht trivial auszuführen und sollte von nicht-markovschen Fehlern betroffen sein, wodurch sich die Wirksamkeit der nicht-markovschen Fehlerprüfungen demonstrieren lässt. Außerdem erlaubt die gespiegelte Struktur, die verrauschten Erwartungswerte ganz einfach mit den exakten Werten zu vergleichen.
In diesem Experiment berechnen wir Erwartungswerte von Observablen. Auch die Wahl der Observablen ist nicht wichtig, daher wählen wir einfach die mittlere Magnetisierung pro Gitterplatz .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
Nun fügen wir Prüfungen vor und nach dem Circuit auf jedem Qubit hinzu, einschließlich der sieben angrenzenden Spectator-Qubits. Wenn du alle möglichen Prüfungen zu einem Circuit hinzufügst, kannst du während der Nachbearbeitung entscheiden, welche Postselektionsstrategie du verwendest.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Verwende das Executor-Primitive, um den Circuit mit den Prüfungen zu samplen.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
Die Klasse PostSelector kennt die creg-Struktur der Prüfungen und kann daher jedes Bit in den Samples der zugehörigen Circuit-Messung zuordnen. Mit ihrer Methode compute_mask lässt sich eine Maske über eine Folge von Samples erstellen, gegeben die Postselektionsstrategie (Knoten oder Kante) und die Art der zu betrachtenden nicht-markovschen Fehlerprüfungen (vor oder nach dem Circuit). Um Strategien vor und nach dem Circuit zu einer einzigen Maske zu kombinieren, können ihre Masken unabhängig berechnet und anschließend mit der Operation AND verknüpft werden. Hier verwenden wir den PostSelector, um Masken für alle verschiedenen Strategien zu erstellen, und betrachten die Ergebnisse für jede verfügbare Kombination von Strategien.
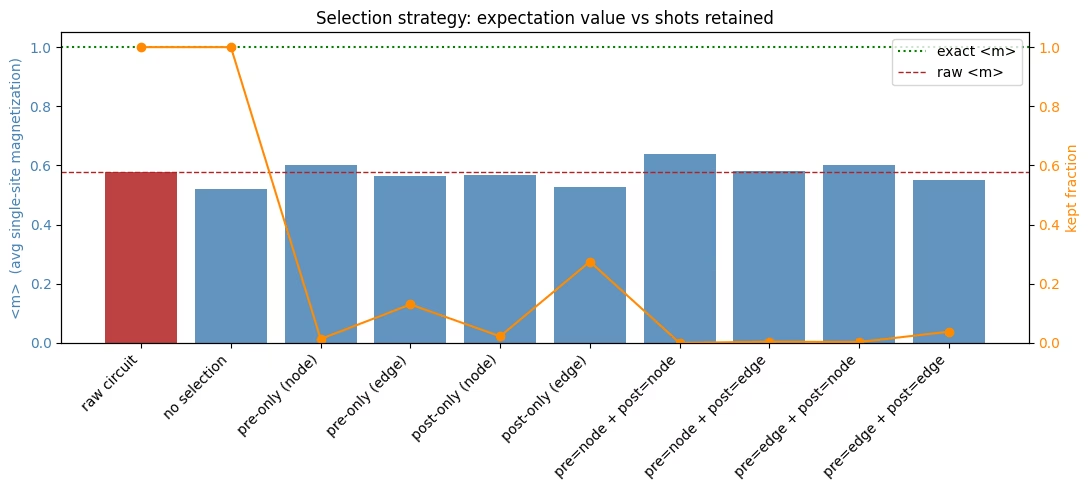
In der folgenden Visualisierung siehst du, wie die Postselektionsstrategie sowohl die Postselektionsrate als auch die Qualität der Antwort beeinflusst. Wie erwartet führten die Strategien mit knotenbasierter Postselektion zu den niedrigsten Postselektionsraten. Die kantenbasierten Strategien sind nachsichtiger und führen tendenziell zu höheren Postselektionsraten. Nutzer sollten die verschiedenen Strategien an ihrem Problem ausprobieren, um das richtige Gleichgewicht zwischen Postselektionsrate und Qualität der gesampelten Verteilung zu finden. In diesem Beispiel lieferte die knotenbasierte Postselektion mit Prüfungen vor und nach dem Circuit die beste Antwort bei einer Postselektionsrate von .028%. Einige der Strategien schnitten nicht besser ab als der Roh-Circuit. Du siehst außerdem, dass das Hinzufügen der Prüfungen ohne deren Verwendung (Balken "no selection" im Diagramm unten) am schlechtesten abschneidet.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)