PEC mit SLC
Probabilistic error cancellation (PEC) ist eine Technik zur Minderung von Quantenrauschen bei der Berechnung von Erwartungswerten von Observablen. Sie ermöglicht es dir, eine unverzerrte Schätzung der Erwartungswerte zu berechnen. Die Technik funktioniert, indem ein Ensemble verrauschter Circuits ausgeführt wird, in die das Inverse eines gelernten Rauschmodells eingespeist wurde. Das Rauschmodell wird dann mittels Pauli-Twirling (auch bekannt als randomized compiling) durch einen Pauli-Kanal approximiert. Solche Rauschmodelle lassen sich effizient lernen und mit PEC mitigieren (siehe Probabilistic error cancellation with sparse Pauli-Lindblad models on noisy quantum processors für weitere Details).
PEC erfordert einen exponentiellen Shot-Overhead, um eine unverzerrte Schätzung zu berechnen. Shaded Lightcones (SLC) ist eine Technik, die klassische Ressourcen nutzt, um die Empfindlichkeit gegenüber Fehlern im gesamten Circuit zu beschränken. Mithilfe dieser Schranken kann der Nutzer den Bias der Observablen-Schätzung kontrolliert einstellen.
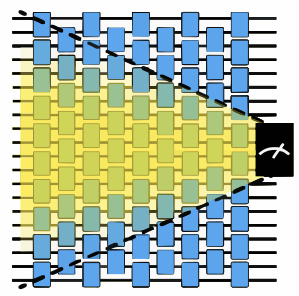
Diese Anleitung zeigt, wie du PEC kombiniert mit SLC verwendest, um Gate-Rauschen mit geringerem Shot-Overhead als bei Standard-PEC zu mindern.
Der Workflow sieht so aus:
- Lege einen Circuit und eine Observable fest.
- Berechne verrauschte, nicht mitigierte Erwartungswerte.
- Berechne Vorwärts- und Rückwärtsschranken für den Bias.
- Lerne das Rauschen der verschränkenden Schichten mit qiskit-noise-learning.
- Nutze das gelernte Rauschen, um die berechneten Schranken zu einer Matrix lokaler Skalen zusammenzuführen.
- Wähle die gewünschte Bias-Schranke anhand des Zielkonflikts zwischen Shot-Overhead und Bias.
- Bereite ein PEC + SLC-Programm vor, führe es aus und verarbeite die Ergebnisse nach.
- Vergleiche die mitigierten Erwartungswerte und den Shot-Overhead.
Lege einen Circuit und eine Observable fest
Bereite einen Spiegel-Circuit einer Trotter-Zeitentwicklung eines 1D-Ising-Ketten-Hamiltonians auf acht Qubits vor. Spiegle den Circuit, um seine Unitäre aufzuheben und einen Identitäts-Circuit zu bilden, sodass der ideale Erwartungswert jeder Observablen bekanntermaßen 1 ist, ohne ihn berechnen zu müssen. Außerdem verdoppelt das Spiegeln die Circuit-Tiefe, was wiederum den Einfluss des Rauschens verdoppelt.
Verwende den Winkel , um die Dynamik nicht-Clifford zu machen.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_slc": "qiskit-addon-slc", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "qiskit_noise_learning": "qiskit-noise-learning", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
from qiskit.circuit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_mitigation.utils import get_measurement_bases

warnings.filterwarnings("ignore")

def construct_ising_circuit(
    num_qubits: int,
    num_trotter_steps: int,
    rx_angle: float,
) -> QuantumCircuit:
    circuit = QuantumCircuit(num_qubits)

    for _ in range(num_trotter_steps):
        circuit.rx(rx_angle, range(num_qubits))
        for first_qubit in (1, 2):
            for idx in range(first_qubit, num_qubits, 2):
                # equivalent to Rzz(-pi/2):
                circuit.sdg([idx - 1, idx])
                circuit.cz(idx - 1, idx)

    return circuit

def prepare_basis(
    circuit: QuantumCircuit, basis: list[int]
) -> QuantumCircuit:
    # basis is a list of integer values from 0 to 3. These map to the basis measurement as:
    # 0 = I; 1 = Z; 2 = X; 3 = Y
    assert len(basis) == circuit.num_qubits

    out_circ = circuit.copy_empty_like()
    for qb, bas in enumerate(basis):
        if bas == 2:
            out_circ.h(qb)
        elif bas == 3:
            out_circ.rx(-np.pi / 2, qb)

    out_circ.barrier()
    out_circ.compose(circuit, inplace=True)
    return out_circ

def mirror_circuit(circuit: QuantumCircuit) -> QuantumCircuit:
    mirror_circ = circuit.copy_empty_like()
    mirror_circ.compose(circuit.inverse(), inplace=True)
    mirror_circ.barrier()
    mirror_circ.compose(circuit, inplace=True)
    mirror_circ.measure_active()
    return mirror_circ

# define observables
num_qubits = 8  # Width of the Ising chain
# The observable to measure: one X component (on qubit 2) and one Z component (on qubit 5)
target_obs_sparse = [("XZ", [2, 5], 1.0)]
observable = SparsePauliOp.from_sparse_list(
    target_obs_sparse, num_qubits=num_qubits
)

# Determine the measurement basis each qubit requires for this observable.
bases, _ = get_measurement_bases(observable)

# Instantiate the mirrored circuit and prepend the basis-preparation gates
num_trotter_steps = 6
rx_angle = np.pi / 4
circuit = construct_ising_circuit(num_qubits, num_trotter_steps, rx_angle)
mirrored_circuit = mirror_circuit(circuit)
mirrored_circuit = prepare_basis(mirrored_circuit, bases[0])
print("Visualization of 1 mirrored Trotter step")
prepare_basis(
    mirror_circuit(construct_ising_circuit(num_qubits, 1, rx_angle)), bases[0]
).draw("mpl", scale=0.6, fold=-1)
Visualization of 1 mirrored Trotter step

Berechne verrauschte, nicht mitigierte Erwartungswerte
Ein QuantumProgram enthält einen Quantum-Circuit und ein Samplex in einem Format, das für das Executor-Primitiv geeignet ist. MitigationTask.prepare erstellt aus dem Circuit, den Observablen und den Parameterwerten ein QuantumProgram und versieht den Circuit mit den angegebenen Boxing-Optionen in Boxen. Setze die Boxing-Option measure_annotations auf "change_basis", um die Messungen in die erforderlichen Basen zu drehen, und füge add_tags: "unique_box" hinzu, damit der Simulator ein Rauschmodell auf die Boxen des Circuits abbilden kann. Das Programm wird standardmäßig Pauli-getwirlt, was auf Hardware kohärentes Rauschen in das Pauli-Rauschen umwandelt, das die Mitigationsmethoden annehmen. num_randomizations legt fest, wie viele getwirlte Instanzen jedes Circuits gesampelt werden, und shots_per_randomization legt fest, wie viele Shots jede Instanz erhält; ihr Produkt ist also das Shot-Limit pro Circuit.
Wenn du QPU-Zugang hast, kannst du das Programm mit einem Executor ausführen, der aus einem Backend des QiskitRuntimeService erstellt wird. Dieses Beispiel verwendet einen AerSimulator, um das Programm lokal auszuführen. Seine Simulatoroption layer_noise_model speist das Rauschen eines gegebenen Pauli-Lindblad-Rauschmodells auf jeder Schicht verschränkender Gates ein. Hier erzeugen wir ein zufälliges Pauli-Lindblad-Rauschmodell mit einem Fehler pro Gate-Schicht (EPLG) von 0.01, fast eine Größenordnung höher als bei typischen aktuellen Heron-QPUs, um den Effekt der Verwendung von SLC auch bei einem kleinen Problem zu verstärken.
from qiskit.circuit import CircuitInstruction
from qiskit.quantum_info import PauliLindbladMap, pauli_basis
from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import Executor
from qiskit_mitigation import MitigationTask, find_combined_unique_layers
from samplomatic import Tag
from samplomatic.utils import get_annotation

def generate_random_pauli_lindblad_noise(
    layers,
    num_qubits: int,
    eplg: float = 3e-3,
    seed: int | None = None,
) -> list[tuple[CircuitInstruction, PauliLindbladMap]]:
    """Generate random Pauli-Lindblad noise over the full Pauli basis."""
    layer_noise_model = []
    for layer in layers:
        layer_instructions = layer.operation.params[0]
        contain_measurement = any(
            inst.name.startswith("measure") for inst in layer_instructions
        )
        if contain_measurement:  # do not add measurement noise
            layer_noise = PauliLindbladMap.identity(num_qubits)
        else:
            edges = [
                (inst.qubits[0]._index, inst.qubits[1]._index)
                for inst in layer_instructions
            ]  # extract the edges of the layer

            basis_paulis = [p for p in pauli_basis(2) if np.sum(p.x + p.z)]
            rng = np.random.default_rng(seed=seed)
            num_generators = len(basis_paulis)
            rates = rng.random(len(basis_paulis)) * eplg / num_generators

            layer_noise = PauliLindbladMap.from_sparse_list(
                [
                    (pauli.to_label(), edge, rate)
                    for pauli, rate in zip(basis_paulis, rates, strict=True)
                    for edge in edges
                ],
                num_qubits=num_qubits,
            )
        layer_noise_model.append((layer, layer_noise))
    return layer_noise_model

num_randomizations = 400
shots_per_randomization = 16

boxing_options = {"add_tags": "unique_box"}

# find the unique layers to generate the layered noise for
box_layers = find_combined_unique_layers(
    [mirrored_circuit], custom_boxing_options=boxing_options
)
layer_noise_model = generate_random_pauli_lindblad_noise(
    box_layers, num_qubits, eplg=1e-2, seed=42
)

# a local noisy simulator in place of a QPU backend
noisy_executor = Executor(
    AerSimulator(),
    options={"simulator": {"layer_noise_model": layer_noise_model}},
)

task = MitigationTask()
program = task.prepare(
    circuit=mirrored_circuit,
    observables=observable,
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
)

program._semantic_role = "simulation"  # flag the program for the simulator
job_unmit_res = noisy_executor.run(program).result()
unmitigated_res = task.postprocess(job_unmit_res)

print(f"unmitigated result: {unmitigated_res.data.evs[0]}")
unmitigated result: 0.63125
Berechne Vorwärts- und Rückwärtsschranken für den Bias
Bevor QPU-Zeit für das Rauschlernen aufgewendet wird, nutzt SLC klassische Simulation, um den Beitrag jedes potenziellen Fehlers zum Bias der Observablen zu beschränken. Das geschieht in zwei sich ergänzenden Durchläufen:
-
Vorwärtspropagation: Jeder Pauli-Fehler wird durch den Rest des Circuits vorwärts propagiert, und sein Kommutator mit der Observablen wird ausgewertet. Ein Fehler, der mit der Observablen antikommutiert, ist die einzige Art, die das Ergebnis verzerren kann; dieser Durchlauf liefert also eine obere Schranke für den Vorwärtseinfluss jedes Fehlers.
-
Rückwärtspropagation: Jeder Fehler wird rückwärts zum Anfang des Circuits propagiert, und sein Kommutator mit dem Anfangszustand wird ausgewertet. Da der Circuit im Nullzustand beginnt, können Fehler, die damit kommutieren, das Ergebnis nicht beeinflussen, was die Schranke aus der anderen Richtung verschärft.
Die beiden Schranken zusammen bilden eine enge Klammer um den Worst-Case-Beitrag jedes Fehlers zum Bias. Im nächsten Schritt werden diese Schranken mit den gelernten Rauschraten zusammengeführt, um zu ordnen, welche Fehler korrigiert werden sollten und welche gefahrlos unberücksichtigt bleiben können. Die Boxing-Option inject_noise_strategy="individual_modification" ist hier erforderlich, damit jede InjectNoise-Annotation im verpackten Circuit eine eindeutige Identität hat, an die die SLC-Schranken gebunden werden können.
Bei größeren Problemen können diese Berechnungen erhebliche klassische Rechenressourcen erfordern.
from qiskit_addon_slc.bounds import (
    compute_backward_bounds,
    compute_forward_bounds,
    tighten_with_speed_limit,
)
from qiskit_mitigation import PEC

slc_boxing_options = {
    "add_tags": "unique_box",
    "inject_noise_strategy": "individual_modification",
}

slc_pec_task = PEC()

boxed_circuit, noise_model_paulis = (
    slc_pec_task.generate_slc_bounds_computation_input(
        mirrored_circuit, custom_boxing_options=slc_boxing_options
    )
)

forward_bounds = compute_forward_bounds(
    boxed_circuit, noise_model_paulis, observable
)
tighten_forward_bounds = tighten_with_speed_limit(
    forward_bounds, boxed_circuit, noise_model_paulis, observable
)
backward_bounds = compute_backward_bounds(boxed_circuit, noise_model_paulis)
Lerne das Rauschen der verschränkenden Schichten
Um abschließend abzuschätzen, wie stark jeder Fehler den Bias des Erwartungswerts beeinflusst und wie aufwendig seine Korrektur wäre, lernen wir die Rauschraten und wenden sie auf die zuvor berechneten vorhergesagten Rauschschranken an.
PEC (ebenso wie PEC+SLC) setzt für jede Schicht verschränkender Gates im Circuit ein getwirltes Rauschmodell voraus. Wenn du ein Markov-Rauschmodell annimmst, wird angenommen, dass die Tiefe des Circuits den Rauschkanal einer gegebenen verschränkenden Schicht nicht beeinflusst. Daher muss nur das Rauschmodell jeder einzigartigen Schicht verschränkender Gates gelernt werden. Der in dieser Anleitung verwendete Circuit lässt sich in zwei einzigartige Schichten aufteilen. Circuits so zu entwerfen, dass sie einen minimalen Satz einzigartiger verschränkender Schichten haben, ist wichtig, wenn du ein Rauschmodell lernen möchtest, da die einzigartigen Schichten unabhängig voneinander gelernt werden müssen. Wenn dein Circuit zu viele einzigartige Schichten hat, kann das Rauschlernen wegen der Sampling-Kosten für das Lernen vieler Schichten undurchführbar werden.
qiskit-noise-learning wird verwendet, um das Rauschen zu lernen. Der Lerner wiederholt jede Schicht fragment_depths-mal in seinen Lern-Circuits, twirlt jeden Circuit num_randomizations-mal und passt den Abfall der gemessenen Fidelitäten an ein Pauli-Lindblad-Modell an. Diese Parameter können die Genauigkeit des gelernten Modells beeinflussen. Je genauer das gelernte Rauschmodell ist, desto genauer wird die Rauschauslöschung sein.
Der folgende Code zeichnet das gelernte Rauschmodell, wobei die beiden Schichten in einer Karte zusammengeführt sind. Jedes Qubit ist ein Kreisdiagramm aus seinen über die beiden Schichten summierten Gewicht-1-Raten für X, Y und Z, und jede Kante zeigt die gelernten Gewicht-2-Raten. Eine Rate von 3e-4 bedeutet zum Beispiel, dass dieser Fehler bei etwa drei von 10.000 Anwendungen der Schicht auftritt.
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import PauliList
from qiskit_ibm_runtime.results import LayerError, PauliLindbladError
from qiskit_ibm_runtime.visualization.embeddings import Embedding
from qiskit_noise_learning.aer_executor import AerExecutor
from qiskit_noise_learning.noise_learner import LearningOptions, NoiseLearner
from samplomatic import InjectNoise

line_coupling = [(i, i + 1) for i in range(num_qubits - 1)]
backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cz"],
    coupling_map=line_coupling,
)

# first learn only the layers PEC will inject noise into, i.e. not the measurement layer
pec_layers = [
    layer
    for layer in slc_pec_task.find_unique_layers(
        mirrored_circuit, slc_boxing_options
    )
    if get_annotation(layer.operation, InjectNoise)
]
layers = slc_pec_task.find_unique_layers(mirrored_circuit, slc_boxing_options)

learning_options = LearningOptions(
    fragment_depths=[2, 4, 8, 16],
    num_randomizations=250,
    shots_per_randomizations=16,
)

# qiskit-noise-learning is not compatible with the Executor in local mode,
# and requires the simulator present in the package for running simulation
noise_dict = {
    get_annotation(layer.operation, Tag).ref: noise_layer
    for layer, noise_layer in layer_noise_model
}
noise_learner_simulator = AerExecutor(
    qasm_simulator=AerSimulator(), noise_dict=noise_dict
)
learner = NoiseLearner(
    backend, options=learning_options, executor=noise_learner_simulator
)
learned_noise = (
    learner.run(pec_layers).result().to_dict()
)  # keyed by InjectNoise reference

# Draw the learned model on the line, laid out as a line with the qubits in order.
# Composing the two layers' maps sums their rates, giving one map over all the edges.
embedding = Embedding(
    [(0, 0), (0, 2), (0, 4), (2, 4), (4, 4), (4, 2), (4, 0), (2, 0)],
    line_coupling,
)
first, second = learned_noise.values()
learned_model = first.compose(second).simplify()
error = PauliLindbladError(
    PauliList(
        learned_model.get_qubit_sparse_pauli_list_copy().to_pauli_list()
    ),
    learned_model.rates,
)
fig = LayerError(circuit, list(range(num_qubits)), error).draw_map(
    embedding, radius=0.4, height=460, width=620
)
fig.update_traces(
    marker={
        "cmin": 0,
        "cmax": max(learned_model.rates),
        "colorbar": {"tickformat": ".1e", "title": "rate"},
    },
    selector={"mode": "markers"},
)
fig.show()

Nutze das gelernte Rauschen, um die berechneten Schranken zu einer Matrix lokaler Skalen zusammenzuführen
Mit den klassischen Schranken (aus dem vorherigen Schritt) und den gelernten Rauschraten in der Hand können wir nun eine Matrix lokaler Skalen berechnen – ein Gewicht pro Fehler, das bestimmt, wie aggressiv PEC jeden einzelnen Rauschterm auslöschen soll.
Die Kernidee von SLC ist, dass nicht alle Fehler vollständig ausgelöscht werden müssen. Ein Fehler, dessen Vorwärts- und Rückwärtsschranke beide klein sind, hat unabhängig von seiner Rate einen vernachlässigbaren Effekt auf die Observable, sodass er teilweise oder vollständig unmitigiert bleiben kann. merge_bounds führt die klassischen Schranken mit den gelernten Pauli-Lindblad-Raten zusammen, dann weist compute_local_scales jedem Fehler eine Skala zwischen 0 (vollständig ignoriert) und 1 (vollständig ausgelöscht) zu, abhängig von einer vom Nutzer festgelegten bias_tolerance. Fehler mit einem großen geschätzten Bias-Beitrag erhalten eine Skala nahe 1 (volle PEC-Behandlung), während Fehler mit einem kleinen Beitrag eine niedrigere Skala erhalten, was den Sampling-Overhead verringert, den sie mit sich bringen.
SLC bietet einen kontinuierlichen Regler zwischen den beiden Extremen – Standard-PEC (kein Bias, höchster Overhead) und gar keine Mitigation (kein Overhead, voller Rausch-Bias). Der Parameter bias_tolerance steuert diesen Regler: Setzt du ihn auf 0, erhältst du volles PEC, während größere Werte mehr verbleibenden Bias im Austausch für einen niedrigeren Sampling-Overhead γ² zulassen.
Dieser Schritt durchläuft bias_tolerance über einen Wertebereich und berechnet jeweils den resultierenden Sampling-Overhead. Diese Punkte gegen den Overhead von vollem PEC aufzutragen hilft dir, einen Arbeitspunkt zu wählen, der zu deinem Shot-Budget passt. Zum Beispiel kann das Tolerieren eines verbleibenden Bias von 5 % den Sampling-Overhead gegenüber vollem PEC um eine Größenordnung senken, sodass die Berechnung auf heutigen QPUs machbar wird, wo sie es sonst nicht wäre.
import matplotlib.pyplot as plt
from qiskit_addon_slc.bounds import compute_local_scales, merge_bounds

merged_bounds = merge_bounds(
    boxed_circuit,
    tighten_forward_bounds,
    backward_bounds,
    noise_rates=learned_noise,
)

biases = []
costs = []
for bias in [0.0, *np.arange(0.01, 0.11, 0.01).tolist()]:
    _, cost_, bias_ = compute_local_scales(
        boxed_circuit,
        merged_bounds,
        noise_rates=learned_noise,
        bias_tolerance=bias,
    )
    biases.append(bias_)
    costs.append(cost_)

# Compute tha full PEC overhead and compare it with the overhead and bias of different SLC configurations
vanilla_gamma = slc_pec_task.calculate_gamma(
    slc_pec_task.boxed_circuit, learned_noise, 1
)

xticks = np.arange(0, 11, 2)

fig, ax = plt.subplots()
ax.scatter(
    [0], [vanilla_gamma**2], marker="D", c="tab:orange", label="full PEC"
)
ax.plot(
    100 * np.array(biases),
    np.array(costs),
    "o-",
    c="tab:blue",
    label="PEC+SLC",
)
ax.set_xticks(xticks, [f"{x:.2f}" for x in xticks])

ax.set_xlabel("Remaining bias [%]")
ax.set_ylabel(r"Sampling overhead, $\gamma^2$")
ax.grid()
ax.legend()
fig.suptitle("PEC sampling overhead reduction due to SLC")
Optimal spacetime partitioning not implemented! Just partitioning list of noisy boxes.
Text(0.5, 0.98, 'PEC sampling overhead reduction due to SLC')

Wähle die gewünschte Bias-Schranke anhand des Zielkonflikts zwischen Shot-Overhead und Bias
In dieser Anleitung wählen wir eine Bias-Toleranz von 5 %. Beachte, dass diese Bias-Berechnung auf dem gelernten Rauschmodell beruht, das nicht perfekt mit dem realen Rauschen des Geräts übereinstimmen muss.
chosen_bias_threshold = 0.05
local_scales, sampling_cost, bias = compute_local_scales(
    boxed_circuit, merged_bounds, learned_noise, bias_tolerance=bias
)
slc_pec_task.set_slc_local_scales(
    local_scales, float(np.sqrt(sampling_cost)), bias
)
Bereite ein PEC + SLC-Programm vor, führe es aus und verarbeite die Ergebnisse nach
Mit den gewählten lokalen Skalen können wir das vollständige PEC+SLC-Ausführungsprogramm erstellen. Der Aufruf PEC.prepare konstruiert ein QuantumProgram, das die Anti-Rausch-Einspeisungsstrategie in den Box-Annotationen des Circuits kodiert. Die Angabe noise_gain="slc_local_scales" weist den Executor an, die mit set_slc_local_scales gesetzten Gewichte pro Fehler zu verwenden, statt wie Standard-PEC auf jeden Fehler denselben vollen inversen Rauschgewinn anzuwenden.
Für einen fairen Vergleich wird eine zweite PEC-Task mit noise_gain=0 vorbereitet, was vollständiger PEC-Fehlerauslöschung ohne SLC-Bias-Spielraum entspricht. Beide Programme werden demselben QuantumProgram hinzugefügt, sodass sie sich einen einzigen Ausführungs-Job teilen – ihre Circuits werden verschachtelt und gemeinsam ausgeführt, sodass jede Hardware-Drift beide gleichermaßen betrifft.
Nachdem der Job abgeschlossen ist, wandelt postprocess die rohen Messbitstrings in Erwartungswerte um und wendet dabei für jede Task den passenden PEC-Reskalierungsfaktor γ an.
program_pec = slc_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=slc_boxing_options,
    noise_maps=learned_noise,  # PEC option
    noise_gain="slc_local_scales",  # PEC option. Defines the usage of SLC
    max_sampling_overhead=100,  # PEC option
)

full_pec_task = PEC()
program_pec = full_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
    quantum_program=program_pec,
    noise_maps=learned_noise,  # PEC option
    noise_gain=0,  # PEC option
    max_sampling_overhead=100,  # PEC option
)

# Execute
program_pec._semantic_role = (
    "simulation"  # flag the program for the simulator
)
job_pec_results = noisy_executor.run(program_pec).result()

# post-processing
pec_slc_res = slc_pec_task.postprocess(job_pec_results)
full_pec_res = full_pec_task.postprocess(job_pec_results)
Vergleiche die mitigierten Erwartungswerte und den Shot-Overhead
Der ideale Erwartungswert des gespiegelten Circuits ist per Konstruktion 1, daher ist der Bias jeder Schätzung einfach |1 - result|. Diese letzte Zelle gibt den Bias und die Gesamtzahl der Shots für drei Szenarien nebeneinander aus:
-
Nicht mitigiert: der rohe verrauschte Erwartungswert ohne angewendete Fehlerauslöschung.
-
Volles PEC: Fehlerauslöschung ohne Bias unter Verwendung des vollständigen inversen Rauschmodells auf jeder Schicht, mit dem vollen Sampling-Overhead γ².
-
PEC+SLC: Fehlerauslöschung, geleitet von den lokalen Skalen der Shaded Lightcones, die die gewählte
bias_toleranceim Austausch für eine wesentlich niedrigere Shot-Anzahl toleriert.
Der Vergleich der drei Zeilen zeigt den konkreten Nutzen von SLC: Der mitigierte Bias von PEC+SLC bleibt deutlich unter dem nicht mitigierten Bias, während die Gesamtzahl der Shots erheblich kleiner ist als bei vollem PEC erforderlich.
print(
    f"Unmitigated result bias: {np.abs(1 - unmitigated_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_unmit_res[0]['_meas'].shape[0] * job_unmit_res[0]['_meas'].shape[2]}"
)

print(
    f"Full PEC final result bias: {np.abs(1 - full_pec_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[1]['_meas'].shape[0] * job_pec_results[1]['_meas'].shape[2]}"
)

print(
    f"PEC+SLC final result bias: {np.abs(1 - pec_slc_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[0]['_meas'].shape[0] * job_pec_results[0]['_meas'].shape[2]}"
)
Unmitigated result bias: 36.88%, total shots ran: 6400
Full PEC final result bias: 0.97%, total shots ran: 48528
PEC+SLC final result bias: 1.46%, total shots ran: 24480