Einen LUCJ-Ansatz transpilieren
Die Konzepte in diesem Leitfaden sind nur in der Python-API verfügbar.
Der Ansatz des lokalen unitären Cluster-Jastrow (LUCJ) ist eine kompakte, hardwareeffiziente Parametrisierung einer korrelierten elektronischen Wellenfunktion. Er gehört zur allgemeineren Familie des unitären Cluster-Jastrow (UCJ) und hat die Form
wobei ein Referenzzustand ist (typischerweise Hartree-Fock), jedes eine Orbitalrotation ist und jedes ein diagonaler Coulomb-Operator ist
mit als Besetzungszahloperator auf dem räumlichen Orbital mit Spin .
ffsim baut den Ansatz-Operator; dieses Paket macht daraus einen Circuit und bildet diesen Circuit auf Qubits ab. Dieser Leitfaden handelt von der zweiten Hälfte dieses Satzes. Der Grund für den Umweg ist die Abbildung selbst: ffsims eigene Qiskit-Gates sind spezifisch für die Jordan-Wigner-Transformation, während ein FermionicCircuit keine Annahme über seine Fermion-zu-Qubit-Kodierung enthält, sodass derselbe Ansatz über jede Kodierung synthetisiert werden kann, die zum Zielgerät passt.
Der Ansatz-Operator kommt hier also fertig an, und alles Folgende beschreibt, was danach mit ihm geschieht: in was sich das Gate zerlegt, wie es über Jordan-Wigner abgesenkt wird, wie es auf eine Geräte-Kopplungskarte abgebildet wird und was eine Abbildung ohne Jordan-Wigner noch bräuchte. Zum Aufbau, zur Parametrisierung oder Simulation eines UCJ-Ansatzes selbst siehe ffsims eigene Leitfäden.
Der ffsim-Beziehungsleitfaden dazu, wie sich die beiden Pakete die Arbeit teilen, und der Transpilations-Leitfaden für die unten verwendeten Pipeline-Stufen.
1. Einen LUCJ-Operator aus ffsim beziehen
Der Ansatz wird aus den Amplituden einer Coupled-Cluster-Singles-and-Doubles-Rechnung (CCSD) initialisiert. Führe restricted Hartree-Fock und anschließend CCSD für ein Wasserstoffmolekül in der Basis 6-31g aus, mit PySCF für die Quantenchemie, und übergib die Amplituden dann an ffsims from_t_amplitudes(). Es führt eine doppelte Faktorisierung der -Amplituden durch, um die diagonalen Coulomb-Matrizen und Orbitalrotationen pro Schicht zu erhalten, und leitet aus den -Amplituden eine optionale abschließende Orbitalrotation ab. Die Anzahl der Wiederholungen ergibt sich aus dieser Faktorisierung; n_reps kürzt sie und tauscht Genauigkeit gegen einen flacheren Circuit.
>>> import ffsim
>>> import pyscf
>>> import pyscf.cc
>>>
>>> # build the molecule and run Hartree-Fock
>>> mol = pyscf.gto.Mole()
>>> mol.build(
...     atom=[["H", (0, 0, 0)], ["H", (0, 0, 0.74)]],
...     basis="6-31g",
...     symmetry="Dooh",
...     verbose=0,
... )
<pyscf.gto.mole.Mole object at ...>
>>> scf = pyscf.scf.RHF(mol).run()
>>>
>>> norb = scf.mo_coeff.shape[1]
>>> nelec = (mol.nelec[0], mol.nelec[1])
>>>
>>> # run CCSD for the t-amplitudes, then factorize them into an ansatz operator
>>> ccsd = pyscf.cc.CCSD(scf).run()
>>> t1, t2 = ccsd.t1, ccsd.t2
>>>
>>> ucj_op = ffsim.UCJOpSpinBalanced.from_t_amplitudes(t2, t1=t1, n_reps=2)
Hier hört der Ansatz auf, ein ffsim-Thema zu sein. ffsim bietet hier Wahlmöglichkeiten, die dieses Paket weder sieht noch kennen muss, etwa die variationell optimierte („komprimierte“) Faktorisierung hinter optimize=True oder die Packung der Parametervektoren, die ein variationeller Optimierer steuert. Alle erzeugen dieselbe Art von Operator, und alles Folgende funktioniert unverändert mit jedem von ihnen.
2. Den Operator in einen fermionischen Circuit umwandeln
Das Gate UCJ umhüllt den Operator und drückt ihn als Circuit über fermionische Modi aus. Das Gate ist eine reine Unitäre ohne eigene Referenz, also stelle ein InitializeModes-Gate voran (gebaut mit from_hartree_fock()), das die Hartree-Fock-Referenz liefert, auf die der Ansatz angewendet wird.
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import InitializeModes, UCJ
>>>
>>> ansatz = UCJ(ucj_op)
>>>
>>> circuit = FermionicCircuit(2 * norb)
>>> circuit.append(InitializeModes.from_hartree_fock(norb, nelec), circuit.modes)
>>> circuit.append(ansatz, circuit.modes)
Das Zerlegen des Circuits legt seine Anatomie offen, und diese Darstellung ist die, auf der der Rest des Leitfadens arbeitet. Das Gate InitializeModes bereitet die Referenzdeterminante vor, und jede Ansatzschicht trägt eine OrbitalRotation bei, dann (eine Evolution des diagonalen Coulomb-Operators ), dann , mit einer abschließenden OrbitalRotation am Ende. Die Orbitalrotationen wirken pro Spinsektor, daher wird jede unabhängig auf die Alpha-Modi 0..norb und die Beta-Modi norb..2*norb gelegt.
>>> circuit.decompose().draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
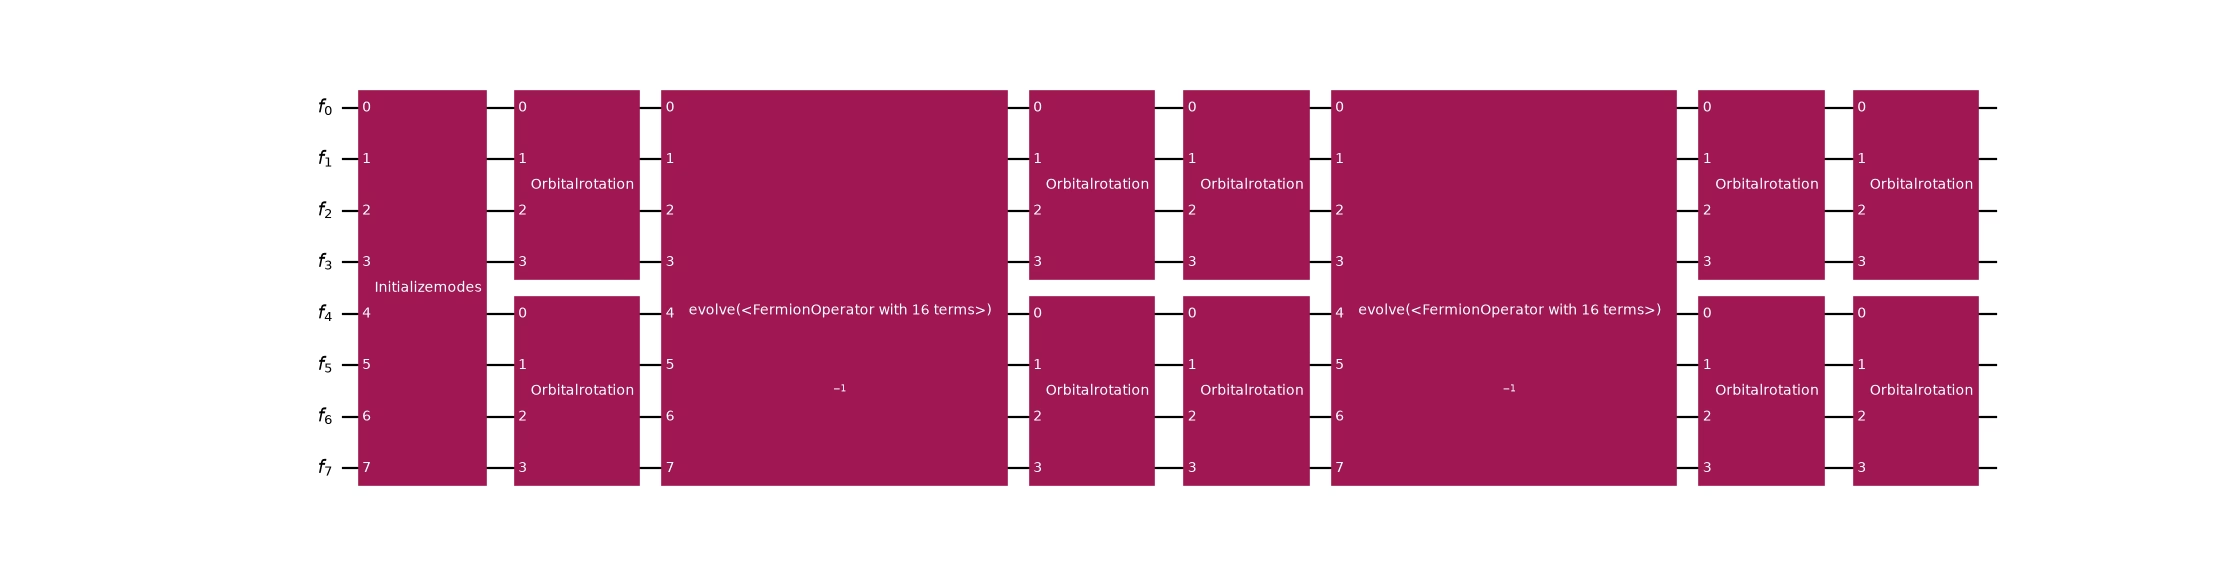
Jedes Gate in dieser Zerlegung ist noch fermionisch: OrbitalRotation und Evolution sind auf Modi definiert, und bisher ist weder ein Qubit- noch ein Pauli-Operator aufgetaucht. Das lässt die Kodierung offen, und in diesem Zustand bleibt der Ansatz, bis die Synthesestufe eine auswählt.
Jede Schicht endet mit und die nächste beginnt mit , sodass benachbarte OrbitalRotation-Gates zu einer einzigen Rotation zusammengeführt werden könnten. Ein Transpilations-Pass, der diese Verschmelzung durchführt, ist eine geplante künftige Entwicklung.
3. Eine Fermion-zu-Qubit-Kodierung wählen
Der Circuit ist noch fermionisch, und genau an dieser Stelle verdient sich dieses Paket seinen Platz im Workflow. Ein FermionicCircuit enthält keine Annahme darüber, wie Modi zu Qubits werden, die Kodierung ist also eine Entscheidung der Synthesestufe und nichts, was in den Ansatz eingebacken ist. Das ist es, was dieses Paket gegenüber ffsims eigenen Qiskit-Gates hinzufügt, die spezifisch für die Jordan-Wigner-Transformation sind.
Allein für Jordan-Wigner bräuchtest du diesen Umweg nicht: ffsim liefert UCJOpSpinBalancedJW und seine Geschwister, die einen UCJ-Operator von sich aus in einen Qubit-Circuit überführen. Der Grund, den Ansatz über einen fermionischen Circuit zu leiten, ist alles andere, was eine Kodierung dir bieten kann. Lokale Kodierungen zum Beispiel verbrauchen zusätzliche Qubits, um das Pauli-Gewicht jedes Terms zu beschränken, was die Flussmengen-Leitfäden für 1D und 2D nutzen, um die Zwei-Qubit-Tiefe eines Trotter-Schritts unabhängig von der Systemgröße zu machen.
Speziell für einen UCJ-Ansatz muss die Synthesestufe zwei Arten von Gates abdecken:
-
Die diagonale Coulomb-Evolution.
Evolutionist bereits kodierungsagnostisch:MapperFnEvolutionSynthesisnimmt eine Mapper-Funktion entgegen, sodass die Schichten über jede Kodierung abgesenkt werden, die du als solche ausdrücken kannst. Die Flussmengen-Leitfäden zeigen, wie man eine schreibt. -
Die Orbitalrotationen und die Vorbereitung der Slater-Determinante. Weder eine
OrbitalRotationnoch diePrepareSlaterDeterminant, in die das führendeInitializeModesund die Rotation verschmelzen (siehe unten), wird als solche auf Qubits abgebildet. Der PassF2FSynthesiszerlegt sie zuerst im fermionischen Raum inEvolution-Gates auf jeweils einem oder zwei Modi (und, für die Vorbereitung, einInitializeModesder Referenz), sodass jede Kodierung, die eineEvolutionabbilden kann, sie handhabt. Unter Jordan-Wigner werden die Faktoren zwischen benachbarten Modi auf Qubit-Ebene zuXXPlusYYGate-Objekten. -
Die Initialisierung. Das Plugin für
InitializeModesist nicht durch eine Kodierung parametrisiert: Es dokumentiert seine Annahme einer Besetzungsbasis-Kodierung mit einer 1-zu-1-Abbildung von Modus auf Qubit und gibt Gates direkt in dieser Basis aus. Eine andere Kodierung braucht dafür ein eigenes Plugin, und bisher wird keines mitgeliefert.
Wie UCJ-Circuits unter einer Kodierung ohne Jordan-Wigner transpiliert werden, ist eine offene Forschungsfrage, und dieses Paket stellt den Rahmen bereit, in dem sich eine solche Pipeline entwickeln lässt. Der Rest dieses Leitfadens baut als Beispiel die Transpiler-Pipeline für die Jordan-Wigner-Kodierung auf, äquivalent zu der von generate_preset_jw_pass_manager() erzeugten.
4. Über Jordan-Wigner absenken
Das Absenken geschieht in F2QSynthesis, das wie Qiskits HighLevelSynthesis arbeitet: Es geht die fermionischen Anweisungen durch und übergibt jede an ein für diesen Gate-Namen registriertes Plugin. Sein Attribut F2QSynthesis.methods enthält pro Gate-Namen ein F2QSynthesisPlugin, der Aufbau der Stufe bedeutet also, für jedes im Circuit enthaltene fermionische Gate ein Plugin zu wählen:
>>> from qiskit_fermions.mappers.library import jordan_wigner
>>> from qiskit_fermions.transpiler.passes import F2QSynthesis
>>> from qiskit_fermions.transpiler.passes.synthesis import (
...     MapperFnEvolutionSynthesis,
...     TrivialOccupationInitializeModesSynthesis,
... )
>>>
>>> synthesis = F2QSynthesis()
>>> synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(jordan_wigner)
>>> synthesis.methods["InitializeModes"] = TrivialOccupationInitializeModesSynthesis()
Das Zuweisen von Instanzen auf diese Weise ist auch der Weg, wie ein selbst geschriebenes Plugin in die Pipeline gelangt, ohne es zuvor irgendwo registrieren zu müssen.
Hier wird die Kodierung festgelegt, auf die beiden Arten, die Abschnitt 3 beschrieben hat: explizit, indem jordan_wigner() an MapperFnEvolutionSynthesis übergeben wird, und implizit, indem das andere Plugin sie bereits voraussetzt.
Diese Stufe wird dann in einen MultiStagePassManager eingesetzt, dessen Stufen in fester Reihenfolge laufen:
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.transpiler import generate_preset_pass_manager
>>> from qiskit.transpiler.passes.synthesis.high_level_synthesis import HLSConfig
>>>
>>> from qiskit_fermions.transpiler import (
...     FermionicCircuitToDAG,
...     FermionicPassManager,
...     QuantumDAGToCircuit,
... )
>>> from qiskit_fermions.transpiler.passes import (
...     F2FSynthesis,
...     HopEvolutionSynthesis,
...     MergeOrbitalRotations,
...     MergeSlaterDeterminantPreparation,
...     TrivialF2QLayout,
... )
>>>
>>> pm = MultiStagePassManager(
...     input=FermionicCircuitToDAG(),
...     optimization=FermionicPassManager(
...         [
...             MergeOrbitalRotations(),
...             MergeSlaterDeterminantPreparation(),
...             F2FSynthesis(
...                 {"OrbitalRotation": "Givens", "PrepareSlaterDeterminant": "Givens"}
...             ),
...         ]
...     ),
...     layout=FermionicPassManager(TrivialF2QLayout()),
...     synthesis=synthesis,
...     qubit=generate_preset_pass_manager(
...         hls_config=HLSConfig(PauliEvolution=[HopEvolutionSynthesis(), "default"])
...     ),
...     output=QuantumDAGToCircuit(),
... )
Die Stufe optimization läuft vor der Synthese, auf dem fermionischen Circuit, und genau das macht sie lohnend: Sie schreibt Gates um, solange sie noch fermionisch und kodierungsagnostisch sind, sodass die Einsparungen in jede nachfolgende Kodierung mitgenommen werden. MergeOrbitalRotations fasst jede Folge aufeinanderfolgender OrbitalRotation-Gates zu einem zusammen, was bei einem UCJ-Ansatz wichtig ist, weil jede Schicht mit endet und die nächste mit beginnt. MergeSlaterDeterminantPreparation verschmilzt dann das führende InitializeModes und die darauffolgende Rotation zu einer einzigen PrepareSlaterDeterminant, die die Synthese über die günstigere reduzierte Slater-Zerlegung statt über eine volle quadratische Rotation absenkt. Die Reihenfolge ist wichtig: Das Zusammenführen der Rotationen zuerst legt die einzelne Rotation unmittelbar nach der Initialisierung frei, die die Slater-Verschmelzung dann in diese hineinzieht. F2FSynthesis kommt zuletzt, weil es jede verbleibende Rotation aufbricht, und wäre es früher dran, hätten die beiden Merge-Pässe nichts mehr zu verschmelzen.
Die übrigen Stufen sind Infrastruktur. input und output konvertieren zwischen Circuits und DAGs, layout ordnet fermionische Modi Qubits zu (TrivialF2QLayout bildet Modus i auf Qubit i ab), und qubit ist ein gewöhnlicher Qiskit-Pass-Manager, der übernimmt, sobald nichts Fermionisches mehr übrig ist.
Zum Ausführen ist ein vorbereitender Schritt nötig: Das zusammengesetzte Gate UCJ muss zuerst in seine primitiven Gates zerlegt werden, damit die Optimierungsstufe die einzelnen Rotationen und Evolutionen sehen kann.
>>> transpiled = pm.run(circuit.decompose())
>>> print(dict(sorted(transpiled.count_ops().items())))
{'rz': 14, 'rzz': 12, 'x': 2, 'xx_plus_yy': 28}
Ohne Zielgerät wird auf 2 * norb Qubits mit angenommener All-to-all-Konnektivität abgebildet; die Orbitalrotationen werden zu XXPlusYYGate-Objekten synthetisiert und die diagonalen Coulomb-Evolutionen zu RZZGate-Objekten:
>>> transpiled.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
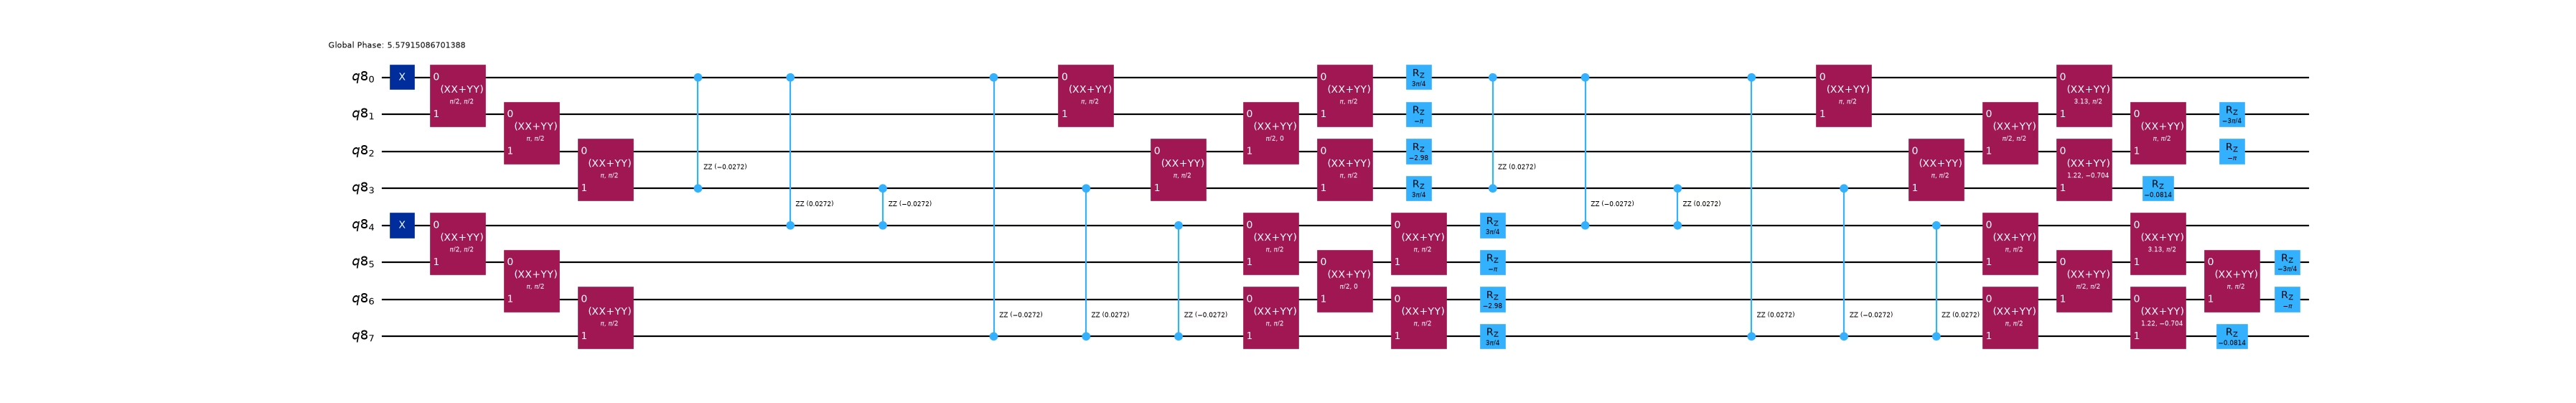
Genau diese Pipeline setzt generate_preset_jw_pass_manager() zusammen, greife also in der Praxis zum Preset und baue die Stufen von Hand, wenn du eine davon ändern musst:
>>> from qiskit_fermions.transpiler.presets import generate_preset_jw_pass_manager
>>>
>>> preset = generate_preset_jw_pass_manager()
>>> preset.run(circuit.decompose()).count_ops() == transpiled.count_ops()
True
5. Die Gerätetopologie anpassen
Ein reales Gerät hat eine eingeschränkte Qubit-Kopplungskarte, und der LUCJ-Ansatz ist so entworfen, dass er dazu passt. Die Wechselwirkungen gleichen Spins (pairs_aa) bilden zwei lineare Ketten, und die Alpha-Beta-Wechselwirkungen (pairs_ab) überbrücken sie. ffsims generate_lucj_pass_manager() baut eine geräteabhängige Qubit-Pipeline für diese Struktur und gibt die Teilmenge von pairs_ab zurück, die die Hardware tatsächlich aufnehmen kann. Setze diese Pipeline in die Stufe qubit des Presets ein und behalte dabei die eigene Fermion-zu-Qubit-Synthese des Pakets:
>>> from ffsim.qiskit import generate_lucj_pass_manager
>>> from qiskit.providers.fake_provider import GenericBackendV2
>>> from qiskit.transpiler import CouplingMap
>>>
>>> # a heavy-hex device coupling map (any BackendV2 works, e.g. a real fake_provider backend)
>>> coupling_map = CouplingMap.from_heavy_hex(5)
>>> backend = GenericBackendV2(
...     num_qubits=coupling_map.size(),
...     basis_gates=["cp", "xx_plus_yy", "p", "x", "swap"],
...     coupling_map=coupling_map,
... )
>>>
>>> # nearest-neighbor same-spin chain; let the pass manager choose the alpha-beta pairs
>>> pairs_aa = [(p, p + 1) for p in range(norb - 1)]
>>>
>>> pm = generate_preset_jw_pass_manager()
>>> hls_config = HLSConfig(PauliEvolution=[HopEvolutionSynthesis(), "default"])
>>> pm.qubit, allowed_pairs_ab = generate_lucj_pass_manager(
...     backend,
...     norb,
...     "heavy-hex",
...     (pairs_aa, None),
...     optimization_level=3,
...     seed_transpiler=0,
...     hls_config=hls_config,
... )
>>>
>>> # the alpha-beta interactions the heavy-hex connectivity can implement
>>> print(allowed_pairs_ab)
[(0, 0)]
Diese Komposition ist der Punkt: Die Stufe qubit ist geräteabhängig, während die Fermion-zu-Qubit-Synthesestufe davor die eigene dieses Pakets bleibt und damit austauschbar. Das Ersetzen der Stufe qubit verwirft tatsächlich, was das Preset dort registriert, nämlich die HopEvolutionSynthesis, die die Givens-Faktoren einer Orbitalrotation in XXPlusYYGate-Objekte umwandelt. Reiche sie wie oben über die hls_config weiter, oder die Basis des Geräts muss ohne sie erreicht werden.
Wenn pm.qubit nun auf die geräteabhängige Pipeline gesetzt ist, legt das Ausführen des Pass-Managers den Circuit auf den Qubits des Backends aus und routet ihn auf die Kopplungskarte. Beim unbeschränkten Ansatz aus Schritt 1, dessen diagonaler Coulomb-Operator noch Alpha-Beta-Terme enthält, die die Hardware nicht direkt erreichen kann, muss der Router viele SWAP-Gates einfügen, um sie zu überbrücken:
>>> naive = pm.run(circuit.decompose())
>>> naive.num_qubits  # laid out on the full heavy-hex device register
57
>>> naive_swaps = naive.count_ops()["swap"]
>>> naive_swaps  # many SWAPs to bridge the unreachable alpha-beta interactions
33
Den Ansatz auf die hardwareumsetzbaren Wechselwirkungen beschränken
Die Lösung ist, allowed_pairs_ab über das Argument interaction_pairs von from_t_amplitudes() in den Ansatzaufbau zurückzuführen, sodass der diagonale Coulomb-Operator nur Alpha-Beta-Terme enthält, die die Kopplungskarte direkt umsetzen kann. Der Ansatz passt dann zur Gerätetopologie, und der Router muss ihn kaum anfassen:
>>> restricted = UCJ(
...     ffsim.UCJOpSpinBalanced.from_t_amplitudes(
...         t2, t1=t1, n_reps=2, interaction_pairs=(pairs_aa, allowed_pairs_ab)
...     )
... )
>>>
>>> circuit = FermionicCircuit(2 * norb)
>>> circuit.append(InitializeModes.from_hartree_fock(norb, nelec), circuit.modes)
>>> circuit.append(restricted, circuit.modes)
>>>
>>> transpiled = pm.run(circuit.decompose())
>>> restricted_swaps = transpiled.count_ops()["swap"]
>>> restricted_swaps  # far fewer routing SWAPs than the unrestricted ansatz
4
Das Zeichnen nur der aktiven Qubits (idle_wires=False) zeigt den Circuit beschränkt auf die beiden Spinketten und die Alpha-Beta-Brücke, ausgedrückt in den Basis-Gates des Geräts. Layout und Routing streuen die logischen Modi über die physischen Qubits des Geräts, übergib also eine wire_order aus dem finalen Layout des Circuits (final_index_layout() listet das physische Qubit auf, auf dem jedes Eingabe-Qubit gelandet ist, in der Reihenfolge der Eingabe-Qubits), um die Leitungen in der ursprünglichen Modusreihenfolge zu zeichnen:
>>> wire_order = transpiled.layout.final_index_layout(filter_ancillas=False)
>>> transpiled.draw("mpl", idle_wires=False, fold=-1, wire_order=wire_order)
<Figure size ... with 1 Axes>
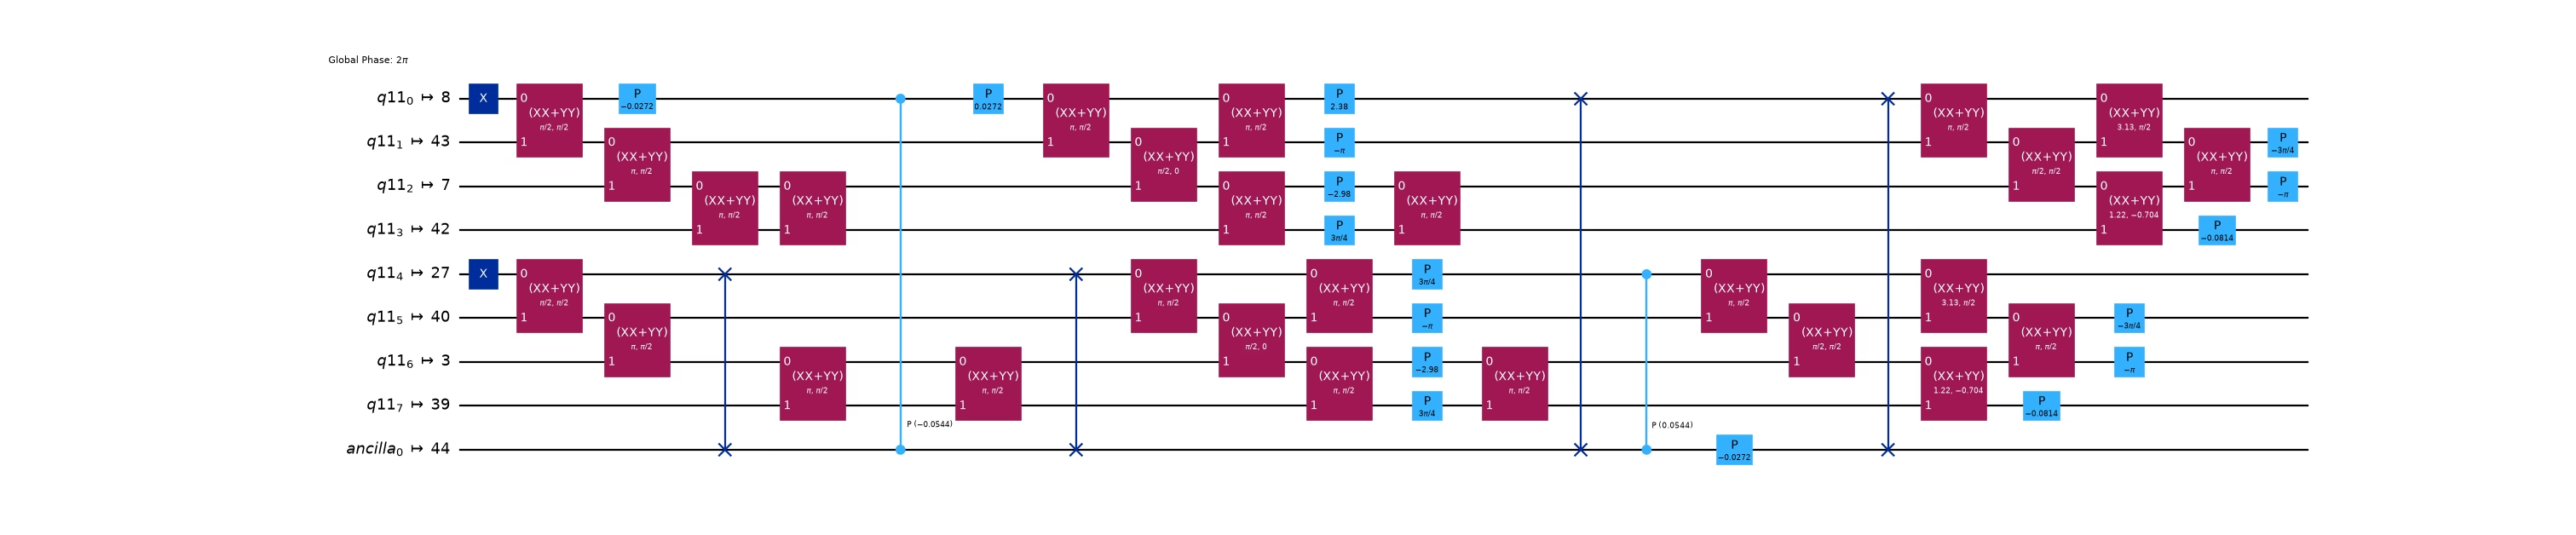
Die genaue Gate-Anzahl und Tiefe nach dem Layout hängen von den Routing-/Optimierungs-Pässen und dem gewählten Gerät ab und werden hier daher nicht wiedergegeben. Der entscheidende Punkt ist das Co-Design; den Ansatz mit einer Nächste-Nachbarn-Kette pairs_aa und hardwaregefilterten pairs_ab-Brücken auszudrücken, hält den synthetisierten Circuit nah an der Gerätetopologie und minimiert den Routing-Overhead (eingefügte SWAP-Gates). Siehe FermionicSlaterGivensDecomposition für eine verwandte Synthesewahl (minimize_2q_gate_count), die Zwei-Qubit-Gate-Anzahl gegen geroutete Tiefe abwägt.
Nächste Schritte
-
Erfahre, wie die einzelnen Gates funktionieren, in der Dokumentation zu
qiskit_fermions.circuit.libraryund im Leitfaden zum fermionischen Circuit. -
Erkunde den Erklärleitfaden zu Operatoren, um zu verstehen, wie du fermionische Operatoren und Hamiltonians direkt konstruierst.
-
Sieh dir im Transpilations-Leitfaden an, wie ein fermionischer Circuit auf Qubits abgebildet wird.
-
Lies die Dokumentation zu
F2QSynthesisfür die andere Möglichkeit, die Synthesestufe zu konfigurieren: einconfig-Dictionary, das Plugins über die Kurznamen auswählt, unter denen sie ihre Einträgeqiskit_fermions.transpiler.synthesisregistrieren, statt über Instanzen. -
Lies den ffsim-Beziehungsleitfaden, um zu verstehen, wie sich die beiden Pakete die Arbeit teilen und welche Protokolle ffsim die Simulation der Circuits dieses Pakets ermöglichen.