1D-Fermi-Hubbard-Dynamik mit Flow Sets simulieren
Die in dieser Anleitung beschriebenen Funktionen sind derzeit nur in der Python-API verfügbar. Entsprechende Funktionalität wird in einer zukünftigen Version in der C-API bereitgestellt.
Diese Anleitung baut einen Circuit für die Zeitdynamik des eindimensionalen Fermi-Hubbard-Modells, vom Aufschreiben des Hamiltonians bis zur Prüfung der entwickelten Platzdichten. Interessant wird der Weg durch eine einzige Idee aus dem Flow-Set-Framework von Gandon et al. [1], der Arbeit, die auch den Anstoß für den TransferVertexOperator in diesem Paket gab:
Anstatt Hamiltonian-Terme nach der Fermion-zu-Qubit-Abbildung zu gruppieren, gruppiere sie davor in Flow Sets, eindimensionale Teilmengen des gerichteten fermionischen Wechselwirkungsgraphen, deren Transferoperatoren untereinander kommutieren.
Diese Entscheidung bestimmt alles Weitere. Sie erfordert Folgendes:
-
Eine benutzerdefinierte Fermion-zu-Qubit-Kodierung, zugeschnitten auf die Flow Sets, die hier ein Ancilla-Qubit aufwendet, sodass die mit der Implementierung eines gegebenen Hamiltonian-Terms verbundene Qubit-Zahl nicht mehr mit der Zahl der fermionischen Moden wächst (wie es bei Jordan-Wigner (JW) der Fall ist).
-
Eine benutzerdefinierte Synthese, die die Kommutativität innerhalb jeder Menge ausnutzt. Der Gewinn ist ein Circuit, dessen Zwei-Qubit-Tiefe konstant in der Systemgröße ist, gegenüber dem linearen Wachstum einer JW-basierten Term-für-Term-Trotterisierung.
Die Maschinerie, die eine eigene Kodierung in den Transpiler bringt (CustomF2QLayout und MapperFnEvolutionSynthesis), lässt sich auf jedes Modell übertragen.
Die Transpilations-Anleitung für die durchgehend referenzierten Transpiler-Stufen und die Mapper-Anleitung für das allgemeine Rezept zum Schreiben eines eigenen Mappers.
Transferoperatoren und Flow Sets
Ein TransferVertexOperator wird aus Vertex-Operatoren und Transferoperatoren aufgebaut. In Form fermionischer Erzeugungs- und Vernichtungsoperatoren gilt
also misst die Besetzung der Mode (sie ist , wenn leer, und , wenn besetzt), während ein Fermion entlang der gerichteten Kante überträgt. Beachte, dass die beiden Indizes von nicht vertauschbar sind. Der erste Index trägt die Minus-Kombination und der zweite die Plus-Kombination, wodurch sich von unterscheidet und die Kante ihre Orientierung erhält.
Diese erfüllen gemischte Kommutationsrelationen. Zwei Transferoperatoren, die auf disjunkte Plätze wirken, kommutieren trivial, da jeder ein gerades Produkt fermionischer Operatoren ist. Der interessante Fall ist ein gemeinsamer Platz. Dort kommutieren die beiden, wenn die Pfeile durch diesen Platz fließen (einer kommt an, einer geht ab), und antikommutieren, wenn sie kollidieren (beide kommen an oder beide gehen ab).
Die Regel lässt sich am besten an einem Bild erkennen. Zeichnet man die Knoten als Vertices und jedes als Pfeil von nach , erhält man den gerichteten Wechselwirkungsgraphen, hier für die in dieser Anleitung durchgehend verwendete Vier-Platz-Kette, die beide Orientierungen jeder Bindung enthält:

Verfolge die Regel an der Abbildung. Betrachte zum Beispiel und . Ein Pfeil kommt an Platz 2 an und der andere verlässt ihn, das Fermion fließt also geradewegs hindurch und die beiden Operatoren kommutieren. Betrachte dagegen und . Beide Pfeile zeigen auf Platz 2. Sie kollidieren, und diese beiden antikommutieren.
Genau das macht Flow Sets möglich. Wähle eine Menge von Pfeilen, die einen gerichteten Pfad bilden, und jedes Paar trifft entweder Kopf-an-Schwanz aufeinander oder gar nicht, sodass die ganze Menge kommutiert, obwohl sich die einzelnen Operatoren auf gemeinsamen Plätzen überlappen. Die Evolution unter einem einzelnen Flow Set verursacht daher keinen Trotter-Fehler, und wie Schritt 7 zeigt, lässt sie sich zudem mit konstanter Circuit-Tiefe umsetzen.
1. Der Fermi-Hubbard-Hamiltonian
Das 1D-Fermi-Hubbard-Modell auf Plätzen (spinlos, offene Ränder) lautet
Nach Gl. (9) aus Ref. [1] ist der Hopping-Term . Die Wechselwirkung ist diagonal und wird daher mit durch Vertex-Operatoren ausgedrückt:
Beide Teile werden direkt als TransferVertexOperator aufgebaut. Beachte, dass als diagonaler Eintrag (j, j) gespeichert wird:
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Die inneren Plätze erhalten einen Koeffizienten von auf , weil sie in zwei Bindungen vorkommen, während die Randplätze nur in einer vorkommen. Jeder hier aufgeführte Term erscheint im oben gezeichneten Graphen. Die T(j,k)-Terme sind seine Pfeile und die V(j)-Terme seine Knoten.
2. In Flow Sets partitionieren
Beschrifte als Nächstes jeden Term mit dem Flow Set, zu dem er gehört. Dafür gibt es das Attribut groups. Ein Evolution-Gate über einem gruppierten Operator zerfällt in je ein Evolution pro Gruppe (Schritt 6 nutzt das), sodass die hier auf fermionischer Ebene getroffene Gruppierung bis in den Circuit erhalten bleibt.
Für die 1D-Kette sind die beiden Hopping-Flow-Sets die nach Osten orientierten Pfeile () und die nach Westen orientierten Pfeile (). Die diagonalen Wechselwirkungsterme kommutieren mit allem Diagonalen und bilden eine dritte Gruppe:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Die Gruppen 0 und 1 sind die beiden Flow Sets. Jede Menge ist ein gerichteter Pfad entlang der Kette, daher kommutieren nach der Flow-Eigenschaft alle Terme innerhalb einer Gruppe.
Jede Gruppe muss außerdem für sich hermitesch sein, da eine Produktformel die Gruppen getrennt exponentiert und nur ein hermitescher Faktor eine unitäre Evolution hat. groups_are_hermitian() bestätigt es:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Das verdient einen Moment Aufmerksamkeit, denn die beiden Hopping-Gruppen sind einseitig gerichtet: Gruppe 0 enthält nur nach Osten orientierte Terme und Gruppe 1 nur nach Westen orientierte. Ein solches Aufspalten eines Hamiltonians würde normalerweise die Hermitizität zerstören, da seinen konjugierten Partner neben sich braucht. Ein TransferVertexOperator vermeidet das Problem, weil bereits für sich hermitesch ist. Es ist ein Produkt zweier Majorana-Operatoren (siehe seine Definition in Schritt 1), kein bloßes , sodass sein Jordan-Wigner-Bild einen reellen statt eines imaginären Koeffizienten trägt. Die Wahl dieser Operatordarstellung ist also überhaupt erst das, was einen einseitig gerichteten Flow Set zu einem zulässigen Trotter-Faktor macht.
Die in dieser Anleitung durchgehend verwendeten Ost/West-Bezeichnungen sind geometrisch: Die Kette ist von links nach rechts gezeichnet und die Modenindizes steigen in dieser Richtung; zeigt nach Osten und nach Westen. Ref. [1] ist bei dieser Benennung in sich widersprüchlich (Text und Abbildungen stimmen nicht überein), daher folgt diese Anleitung bewusst nicht dem Text, sondern behält die Bezeichnungen aus dem Bild bei. Wenn du mit dem Paper gegenliest, ordne die Flow Sets anhand ihrer Pauli-Gewichte (unten 1 und 3) zu und nicht anhand der Himmelsrichtungen.
3. Die benutzerdefinierte Kodierung schreiben
Abschnitt IV B von Ref. [1] klassifiziert die Formen, die eine lokale Fermion-zu-Qubit-Kodierung annehmen kann, wenn sie auf ein Flow Set beschränkt ist. Reines Jordan-Wigner verwendet Qubits und bildet jeden Hopping-Term auf ein Pauli mit Gewicht 2 ab. Die Klassifikation zeigt, dass zusätzliche Qubits Struktur erkaufen in den kodierten Operatoren.
Die hier implementierte Kodierung ist die paritätsdelokalisierte Konstruktion aus Anhang B 2 (Gleichungen B4 und B5), die ein Ancilla-Qubit verwendet, also . Die fermionische Parität wird über ein Qubit-Paar delokalisiert:
Der Index im letzten Ausdruck erzwingt das zusätzliche Qubit. Die letzte Bindung der Kette hat , ihr landet also auf Qubit , eines hinter der letzten fermionischen Mode . Dieses nachlaufende Qubit ist das Ancilla-Qubit, und deshalb ist statt . Dieselbe Reichweite zeigt sich bei , dessen für auf dem Ancilla-Qubit liegt.
Der Gewinn ist sofort sichtbar: Ein ganzes Flow Set wird auf eine Summe von Paulis mit Gewicht 1 abgebildet.
Die Vorfaktoren sind durch die Normierung festgelegt, und das relative Minuszeichen zwischen den beiden Orientierungen ist durch die Produktidentität festgelegt, die die obigen Paulis erfüllen. Ist eines von beiden falsch, ergibt sich ein Operator, der die Kommutationsrelationen erfüllt, aber nicht mehr denselben Hamiltonian darstellt. Du solltest die Kodierung daher numerisch prüfen, wie in Schritt 4 gezeigt.
Die Kodierung zu schreiben bedeutet, eine Funktion zu schreiben, die einen einzelnen verallgemeinerten Transferoperator auf einen Pauli-String abbildet; map_transfer_vertex_generators() übernimmt die Iteration über die Terme und deren Komposition:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn erwartet die Signatur (operator, num_qubits), und der Rückgabetyp muss eine SparseObservable sein, wodurch sich die Funktion direkt als Transpiler-Plugin verwenden lässt. Siehe Schritt 6.
Angewandt auf den Hamiltonian aus Schritt 1 ergibt sich der kodierte Operator auf Qubits:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Es gibt 14 Terme in drei Formen: Das Hopping ist zu X und ZXZ geworden, die Wechselwirkung zu ZZ, und das führende [] ist die Identität, die nur eine globale Phase beiträgt. Beachte, dass die ZZ-Terme nächste und übernächste Nachbarn erreichen; erstreckt sich über die Qubits bis , was der Preis der Delokalisierung der Parität ist.
Die Gruppierung nach Flow Set offenbart die Asymmetrie, die die Konstruktion erkauft. Liste die in jeder Gruppe vorkommenden Pauli-Gewichte auf:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Das nach Osten orientierte Flow Set (Gruppe 0) besteht vollständig aus Paulis mit Gewicht 1. Seine Zeitentwicklung ist daher eine Schicht von Ein-Qubit-Rotationen und braucht keine verschränkenden Gates, während unter Jordan-Wigner jeder Hopping-Term Gewicht 2 hat und sie erfordert. Das ist der Raum-Zeit-Kompromiss aus Ref. [1] in seiner einfachsten Form: Ein zusätzliches Qubit wandelt die Hälfte des Hopping-Hamiltonians in Ein-Qubit-Rotationen um.
Das nach Westen orientierte Flow Set (Gruppe 1) bezahlt dafür mit Gewicht drei, und die Wechselwirkung (Gruppe 2) liegt bei Gewicht zwei, wobei der Eintrag mit Gewicht null die Identität ist. Nichts davon ist bisher eine Aussage über den Circuit; was eine Synthese aus diesen Gewichten macht, ist das Thema der Schritte 6 und 7.
4. Die Kodierung verifizieren
Eine benutzerdefinierte Kodierung ist nur nützlich, wenn sie treu ist, und eine handgeschriebene sollte geprüft werden. Da diese Kodierung Qubits verwendet, ist der Qubit-Hilbertraum doppelt so groß wie der fermionische, sodass der kodierte Hamiltonian dem Jordan-Wigner-Hamiltonian nicht Term für Term gleichen kann. Die beiden sind stattdessen durch eine Isometrie verbunden.
Woher die Isometrie kommt: Unter Jordan-Wigner ist ein Basiszustand der Besetzungsstring; Qubit hält . Diese Kodierung speichert stattdessen kumulative Paritäten. Definiere
sodass das Bit die Parität aller Besetzungen bis einschließlich Platz festhält. Es gibt solcher Bits für Besetzungen, woher das Ancilla-Qubit kommt. Die Besetzung ergibt sich als Differenz benachbarter Bits, . Ein besetzter Platz zeigt sich daher als Domänenwand zwischen zwei benachbarten Bits, weshalb dies Domänenwand-Kodierung (oder Kramers-Wannier-Kodierung) heißt. Deshalb ist auch : Das Produkt zweier benachbarter liest genau diese Differenz ab.
Wenn man diese Abbildung für einige Zustände ausschreibt, wird die Struktur konkret (beachte, dass fest ist, sodass nur die Hälfte der Qubit-Zustände im Bild liegt und es sich daher um eine Isometrie und nicht um eine unitäre Abbildung handelt):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Ein einzelnes Fermion auf Platz 0 kippt jede kumulative Parität oberhalb davon, und genau das ist die Delokalisierung in Aktion. Fasst man diese Spalten zu einer Matrix zusammen, erhält man die Isometrie , und die Kodierung ist treu, wenn sie die beiden Hamiltonoperatoren verschränkt (intertwines):
Das heißt: Einen fermionischen Zustand in den Qubit-Raum abzubilden und ihn dort zu entwickeln, muss dasselbe Ergebnis liefern, wie ihn zuerst im fermionischen Raum zu entwickeln und anschließend abzubilden.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
Die Verschränkungsrelation gilt exakt, und zwar separat für jede Flow-Menge. Diese zweite, stärkere Aussage ist es, auf die sich spätere Schritte stützen: Eine Produktformel entwickelt die Gruppen nacheinander, und ein Produkt verschränkter Faktoren ist selbst verschränkt, sodass jede aus diesen Gruppen aufgebaute Näherung in beiden Kodierungen übereinstimmt, obwohl sich die Kodierungen unterscheiden. Als Folgerung müssen die Spektren übereinstimmen, wobei jeder Jordan-Wigner-Eigenwert im größeren Raum zweimal auftritt, einmal für jeden Wert der unbeschränkten globalen Parität:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Das fermionische Circuit aufbauen
Bevor Qubits ins Spiel kommen, wird die Dynamik auf der fermionischen Ebene ausgedrückt. Ein FermionicCircuit wirkt auf fermionische Moden statt auf Qubits, und ein Evolution-Gate über den Hamiltonoperator ist das gesamte Circuit:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Es gibt eine undurchsichtige Box über alle vier Moden, und das Interessante ist, in was sie sich zerlegen lässt. Das Argument synthesis legt fest, wie: FermionicLieTrotter ist die Produktformel erster Ordnung, die den Operator anhand seiner groups aufteilt und jede Gruppe der Reihe nach entwickelt. Die Flow-Mengen-Partitionierung aus Schritt 2 ist also die Trotterisierung, und ein einziges decompose() führt sie aus und liefert ein Evolution pro Flow-Menge in Gruppenreihenfolge: Ost, West, dann die diagonale Wechselwirkung, mit jeweils 3, 3 bzw. 8 Termen.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
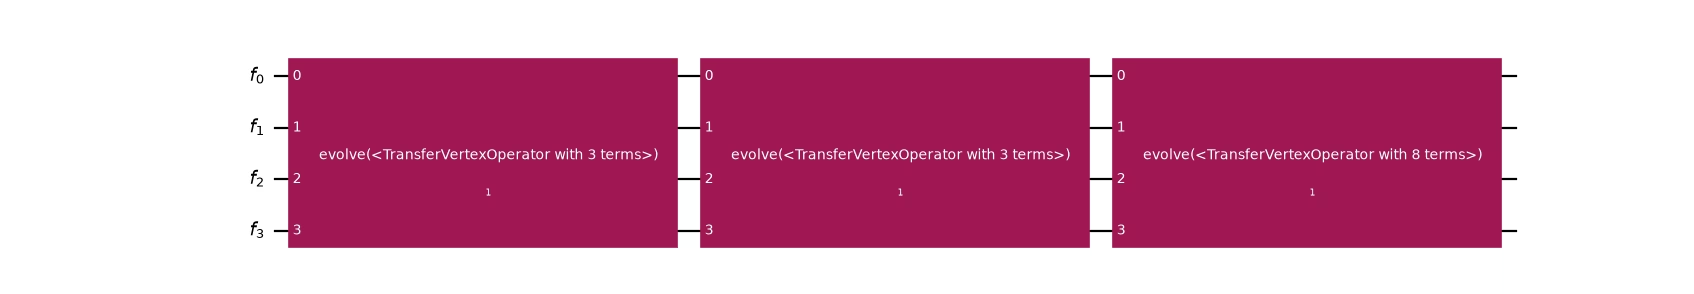
Beachte, dass dies vollständig im fermionischen Raum geschieht: Es ist noch kein Qubit erwähnt worden, und die Näherung ist bereits gemacht. Die Anzahl der Trotter-Schritte gehört daher ebenfalls hierher, nämlich als reps, das die Zeit teilt und den gesamten Durchlauf wiederholt:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Neun Gates: die drei Flow-Mengen, dreimal durchlaufen, jeweils mit einem Drittel der Zeit. Dieses Durchlaufen macht es zu einer Trotterisierung und nicht zu einer bloßen Neuaufteilung einer Gruppe. Eine einzelne Gruppe zu wiederholen würde nichts bringen, da aufeinanderfolgende Exponentialfunktionen desselben Operators kommutieren, sodass A(t/3) A(t/3) A(t/3) einfach A(t) ist. Eine Formel, die die Gruppen liest, kann sie verschachteln; eine nach der Abbildung angewandte kann das nicht, weil die Gruppierung dann bereits verloren ist.
Dies ist der Schritt, der die Gruppierung bedeutsam macht. Jedes ausgegebene Gate wird unabhängig abgebildet und synthetisiert, sodass alles Nachgelagerte auf der Partitionierung arbeitet, die auf der fermionischen Ebene festgelegt wurde. Wird die Zerlegung übersprungen, wird stattdessen der gesamte Operator an die nächste Stufe übergeben, und die Gruppierung wird ignoriert.
6. Mit der benutzerdefinierten Kodierung transpilieren
Die Kodierung ist nun bereit, vom Transpiler verwendet zu werden. Es werden noch zwei weitere Bausteine benötigt:
-
Ein Layout. Das Standard-
TrivialF2QLayoutnimmt ein Qubit pro Mode an, was in dieser Situation falsch ist.CustomF2QLayoutordnet das fermionische Register einemQuantumRegisteranderer Größe zu, und so gelangen Ancilla-Qubits in die Pipeline. -
Ein Synthese-Plugin.
MapperFnEvolutionSynthesisnimmt die Mapper-Funktion direkt entgegen, bildet damit den Hamiltonoperator desEvolution-Gates ab und gibt einPauliEvolutionGateaus, wobei die Konvention erhalten bleibt. Seineproduct_formulabestimmt, wie dieses Gate in Rotationen umgewandelt wird. Beachte, dass dies eine zweite, unabhängige Produktformel ist, die nach der Abbildung auf Qubits wirkt: Hier wird QiskitsLieTrotterübergeben, und Schritt 7 ersetzt es durch eines, das Flow-Mengen kennt.
Da jeder Vergleich unten diese Pipeline erneut ausführt, lohnt es sich, sie einmal zu kapseln:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Vier fermionische Moden sind zu einem Circuit mit fünf Qubits geworden, wobei das Ancilla durch das benutzerdefinierte Layout bereitgestellt wird.
Sieh dir nun an, was das resultierende Circuit tatsächlich enthält. Wiederholtes Zerlegen reduziert die Evolution-Gates bis hinunter auf U und CX, sodass die Zwei-Qubit-Kosten der beiden unten verglichenen Synthesestrategien in derselben Währung gemessen werden: count_ops() meldet dann die Anzahl der CX, und depth() nimmt eine Filterfunktion entgegen, um die Zwei-Qubit-Tiefe zu messen. Beachte, dass dieses reps eine Zerlegungstiefe ist und nichts mit der Anzahl der Trotter-Schritte zu tun hat, die eine Produktformel ausführt und die später in dieser Anleitung ebenfalls reps heißt:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Sechsundzwanzig CX-Gates in dreiundzwanzig Schichten, es läuft also fast nichts parallel. Das Zeichnen des Circuits zeigt, warum:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
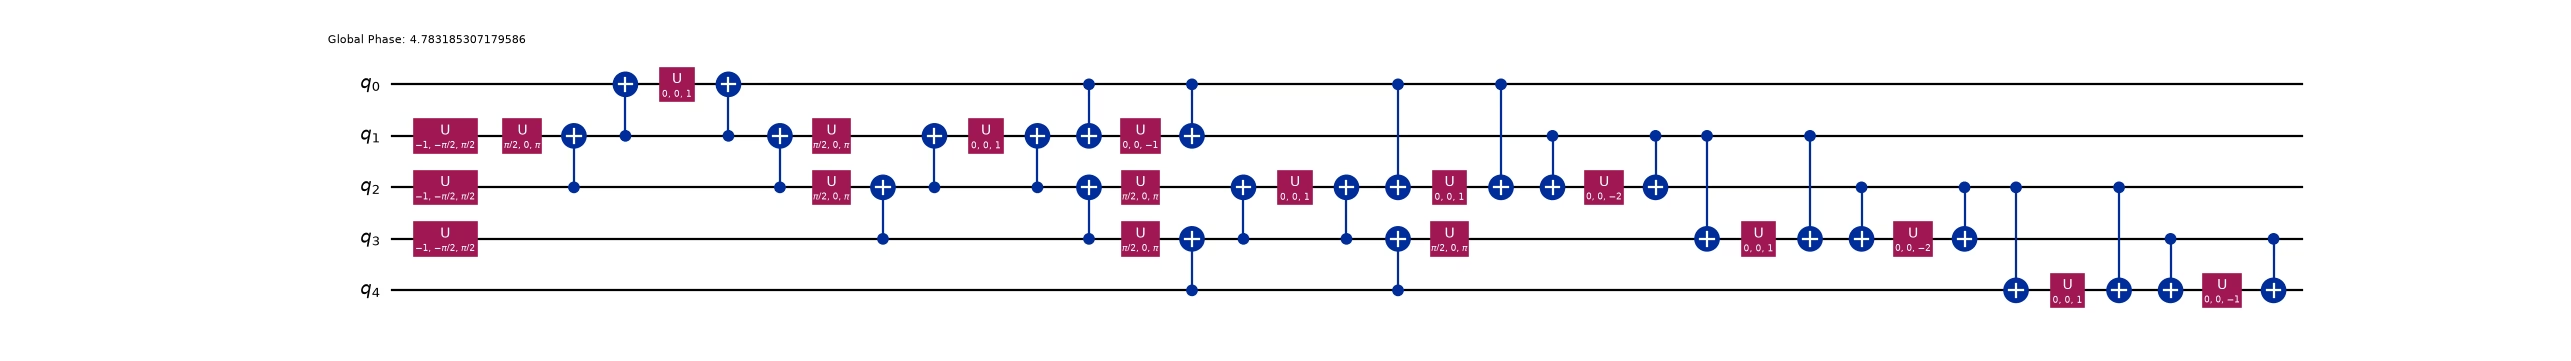
Jeder Term wurde isoliert kompiliert: ein Basiswechsel, eine CX-Leiter hinunter bis zu einer einzelnen Rotation, dann wird die Leiter wieder rückgängig gemacht. Die Flow-Menge mit Gewicht 1 ist kostenlos; ihre Terme sind einzelne Rotationen ohne Leiter drumherum, aber jeder Term mit Gewicht 3 kostet vier CX-Gates, und da die Leitern nacheinander ausgegeben werden, überlappt nichts.
Die Gruppierung übersteht also die gesamte Pipeline (drei Flow-Mengen, drei abgebildete PauliEvolutionGates) und bringt dennoch fast nichts. Die fermionische Trotterisierung aus Schritt 5 hat ihre Arbeit getan; was sie verschwendet, ist die qubitseitige Formel. LieTrotter erhält eine Menge von Termen, über die ihm zufällig nichts gesagt wird, und kompiliert jeden isoliert. Es kann nicht wissen, dass sie alle miteinander kommutieren, und serialisiert daher, was sich einen Basiswechsel teilen könnte.
Das ist die Lücke, die diese Kodierung schließen soll: Zwei Produktformeln sind am Werk, und bisher wurde nur der fermionischen die Struktur mitgeteilt. Der nächste Schritt liefert eine qubitseitige Synthese, die sie ebenfalls ausnutzt.
7. Eine Flow-Mengen-bewusste Synthese
Den Vorteil zurückzugewinnen bedeutet, der qubitseitigen Synthese die Struktur mitzuteilen. Das ist Abschnitt IV C von Ref. [1]: Da alle Terme einer Flow-Menge kommutieren, können sie durch ein einziges Clifford-Circuit gleichzeitig diagonalisiert, in einer gemeinsamen Basis rotiert und zurückrotiert werden, statt einmal pro Term.
Für diese Kodierung ist das Clifford einfach. Die Konjugation mit einer Kette von CZ-Gates auf nächsten Nachbarn bildet
gleichzeitig für jedes ab. Eine CZ-Kette verwandelt die gesamte Flow-Menge mit Gewicht 3 (West) in eine Schicht unabhängiger Einzel-Qubit--Rotationen. Die Schnittstelle EvolutionSynthesis verlangt lediglich eine Methode synthesize(), und nur diese implementiert diese Klasse. Sie trägt keine Anzahl von Trotter-Schritten, weil sie jeweils eine Flow-Menge erhält und die Evolution daher nicht über die Mengen hinweg unterteilen kann. Diese Unterteilung gehört eine Ebene höher, in den fermionischen Raum, wo ein F2FSynthesisPlugin alle auf einmal sieht (siehe Schritt 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Zwei Details übersieht man leicht. Eine benutzerdefinierte EvolutionSynthesis muss ein Attribut preserve_order bereitstellen, das der High-Level-Synthesis-Pass liest.
Beide Hilfsfunktionen geben ihre Gates in expliziten Schichten statt in Term-Reihenfolge aus, weil depth() Gates so früh wie möglich in der Reihenfolge ihres Hinzufügens einplant. Da alle Gates innerhalb einer dieser Mengen kommutieren, ist die Reihenfolge frei wählbar. Eine termweise Synthese wählt die Reihenfolge schlecht. Gibt man die überlappende CZ-Kette sequenziell aus, ergibt sich eine Tiefe, die mit der Qubit-Anzahl wächst, statt der konstanten 2, die die Hardware erreichen könnte.
Deshalb trägt die obige Synthese keine Anzahl von Trotter-Schritten. Sie erhält pro Gate eine Flow-Menge, sodass eine Wiederholung darin innerhalb einer Menge wiederholen würde, statt zwischen ihnen zu wechseln:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
Die erste Form bringt nichts: Aufeinanderfolgende Exponentialfunktionen desselben Operators kommutieren, sodass A(t/2) A(t/2) einfach A(t) ist und der Fehler auf seinem Ein-Schritt-Wert bleibt, egal wie viele Schritte angefordert werden.
Die Schrittanzahl gehört daher zum fermionischen FermionicLieTrotter aus Schritt 5, das die groups liest und sie verschachteln kann. Diese Arbeitsteilung ist der springende Punkt: Die fermionische Formel entscheidet, wie viele Schritte und in welcher Reihenfolge, und diese Klasse entscheidet, wie günstig jede resultierende Menge realisiert wird.
Um die Ordnung auszuwählen, übergib sie an MapperFnEvolutionSynthesis.product_formula, das Argument, das flow_set_pass_manager entgegennimmt. Sonst ändert sich nichts an der Pipeline (oder dem fermionischen Circuit, auf dem sie läuft):
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
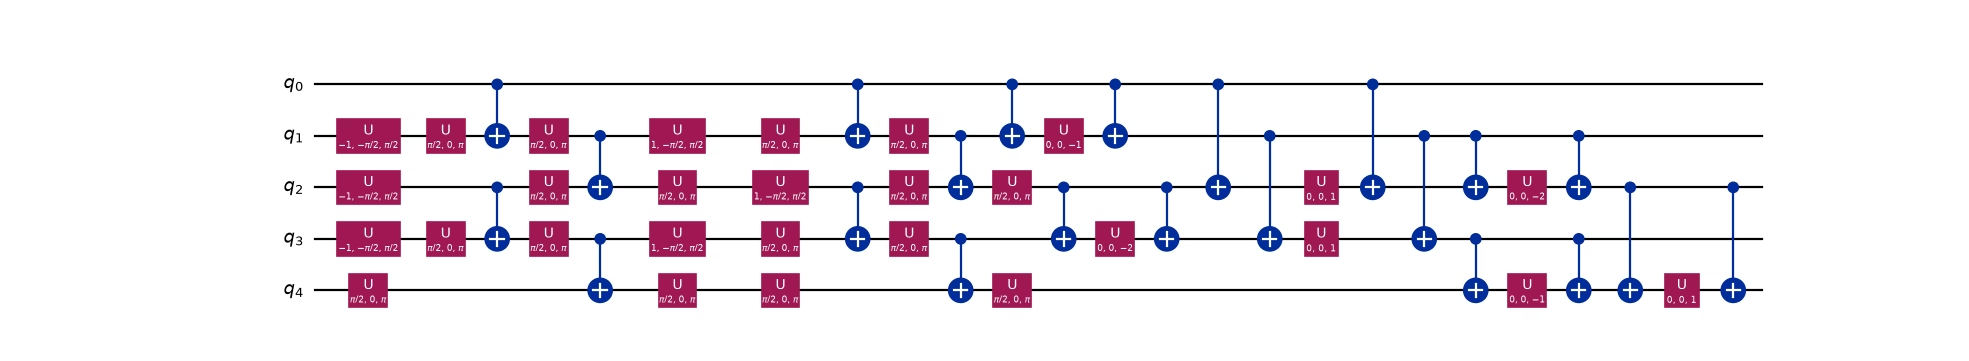
Von Tiefe 23 mit 26 CX-Gates auf Tiefe 12 mit 22 CX-Gates. Beachte, dass das weniger verschränkende Gates und fast die halbe Tiefe bedeutet. Beim Vergleich der beiden Bilder liegt der Unterschied nicht darin, dass die Gates billiger sind, sondern dass sie sich stapeln. Die seriellen Leitern sind verschwunden; verschränkende Gates liegen nun in gemeinsamen Schichten übereinander, weil die gesamte West-Flow-Menge in einer einzigen gemeinsamen Basis rotiert wird und die Wechselwirkung in Schichten disjunkter Paare ausgegeben wird.
FlowSetSynthesis gleicht absolute Qubit-Indizes per Mustervergleich ab, was hier nur sicher ist, weil jede Flow-Menge dieses Hamiltonoperators das gesamte Register umfasst. Eine fermionische Produktformel verengt jeden Faktor auf die Moden, die er tatsächlich berührt, sodass eine Gruppierung, deren Mengen nur einen Teil der Kette abdecken, umbenannt ankäme und die obigen Muster nicht passen würden.
Beide Zeichnungen zeigen das Circuit nach decompose(reps=6), das alles in die Basis U und CX umschreibt, sodass die von FlowSetSynthesis ausgegebenen Gates CZ, Rx und Rzz als solche nicht sichtbar sind. Das ist beabsichtigt: Es bringt beide Circuits in dieselbe Basis, und nur so sind die obigen Zwei-Qubit-Anzahlen und -Tiefen vergleichbar. Bemerkenswert in diesen Abbildungen ist die Schichtstruktur, nicht die Gate-Bezeichnungen.
8. Konstante Tiefe im großen Maßstab
Die interessante Frage ist nicht die Anzahl bei vier Moden, sondern wie sie skaliert. Die beiden CZ-Brickwork-Schichten wachsen nicht mit der Kettenlänge, daher sollte die Zwei-Qubit-Tiefe eines Trotter-Schritts konstant sein. Direkt gemessen am vollständigen Fermi-Hubbard-Hamiltonoperator, weit jenseits dessen, was sich per Brute Force simulieren ließe:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
Die Zwei-Qubit-Tiefe bleibt bei 12 von vier Moden bis 100, während LieTrotter linear auf 407 wächst. Die Flow-Mengen lassen es innerhalb der Pipeline ein wenig parallelisieren, aber jede Menge wird weiterhin Term für Term trotterisiert, sodass das Wachstum nur verlangsamt, nicht beseitigt wird:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Die Gate-Anzahl wächst bei beiden linear (es sind Terme anzuwenden, das ist unvermeidlich), aber die Flow-Mengen-Synthese wendet sie in einer konstanten Anzahl paralleler Schichten an. Das ist das Konstante-Tiefe-Ergebnis aus Ref. [1].
Die Tiefe 12 verteilt sich bei jeder Kettenlänge als 0 + 4 + 8 auf die drei Flow-Mengen. Die Ost-Flow-Menge trägt null bei; sie besteht aus reinen Rx-Rotationen. Die West-Flow-Menge kostet 4, durch die zwei CZ-Brickwork-Schichten hinein und die zwei hinaus; lässt man die Wechselwirkung weg, bleibt bei jeder Kettenlänge eine Zwei-Qubit-Tiefe von vier. Die verbleibenden acht entfallen auf die Wechselwirkung, deren Rzz-Terme sowohl auf nächste als auch auf übernächste Nachbarn wirken und daher vier disjunkte Schichten benötigen, die jeweils zwei CX-Gates kosten. Vier ist hier optimal: Jedes innere Qubit trägt vier Rzz-Gates (zwei zu jedem Nachbarn und zwei zu jedem übernächsten) und kann an jeweils nur einem teilnehmen, sodass kein Schedule besser sein kann.
Zwei Drittel der Tiefe entfallen auf die Wechselwirkung, was zeigt, dass diese Kodierung beim Hopping glänzt und damit bei der Dynamik einer Kette freier Fermionen. Beachte jedoch, dass die Wechselwirkung nicht mit dem Hopping kommutiert. Sie wegzulassen ist keine Näherung an Fermi-Hubbard, sondern ein anderes Modell. Wo das Gleichgewicht für ein gegebenes Problem liegt, ist es wert, erkundet zu werden.
9. Die Dynamik prüfen
Unter der Domain-Wall-Abbildung wird aus einem Besetzungsmuster eine kumulative Paritätszeichenkette, sodass der Anfangszustand anders präpariert wird als bei Jordan-Wigner. Das ist eine leicht zu übersehende praktische Folge der Delokalisierung der Parität. Die Hilfsfunktion aus Schritt 4 liefert das richtige Label:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Mit dem präparierten Zustand bleiben zwei Fragen, die man am besten getrennt stellt: Berechnet die Flow-Mengen-Synthese das Richtige, und berechnet sie es günstiger?
Zuerst die Korrektheit. FlowSetSynthesis und Qiskits LieTrotter erhalten dieselben kodierten Flow-Mengen aus derselben fermionischen Trotterisierung, daher müssen sie bis auf eine globale Phase dieselbe Unitäre realisieren. Die benutzerdefinierten Cliffords organisieren die Arbeit um; sie ändern das Ergebnis nicht. Zufällige Statevektoren decken jede Abweichung weit günstiger auf als der Aufbau der vollständigen Unitären:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Beide Hälften dieser Prüfung sind wichtig. Eine Überlappung mit Betrag eins bei einem einzelnen Zustand ist notwendig, aber nicht hinreichend: Eine Synthese, die eine zustandsabhängige Phase falsch bekommt, würde sich dennoch zeigen. Die gleiche Phase über mehrere Zufallszustände zu verlangen, schließt diese Lücke. Auch mehr als ein reps zu prüfen ist wichtig, da es bestätigt, dass die Übereinstimmung die Verschachtelung der Flow-Mengen übersteht und nicht nur für einen einzelnen Durchlauf gilt.
Die Wahl der qubitseitigen Synthese hat also keine Folgen für die Genauigkeit, und das macht einen Kostenvergleich aussagekräftig. Die verbleibende Frage ist, was die Kodierung als Ganzes gegenüber der naheliegenden Alternative bringt: reines Jordan-Wigner auf num_sites Qubits, ohne Ancilla und ohne benutzerdefinierte Cliffords. Sowohl die Kodierung als auch die qubitseitige Synthese unterscheiden sich zwischen den beiden Spalten, aber die obige Prüfung hat gezeigt, dass Letztere das Ergebnis nicht beeinflussen kann, sodass die Fidelitäten die Kodierung testen. Beide Pipelines starten außerdem von derselben fermionischen Trotterisierung, sodass jeder Unterschied in der Fidelität auf einen Fehler und nicht auf einen Zielkonflikt hindeuten würde. Die beiden Spalten sind die Kodierungen, Flow-Menge gegen Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Lies zuerst die Fidelitätsspalte: identisch, in jeder gedruckten Stelle, in zwei verschiedenen Hilbert-Räumen unter zwei verschiedenen Kodierungen. Das ist die fermionische Trotterisierung, die durchscheint. Die Näherung wurde in Schritt 5 festgelegt, bevor eine der Kodierungen gewählt wurde, sodass beide Circuits genau den Fehler einer Formel erster Ordnung über drei Flow-Mengen tragen, und er fällt bei jeder Verdopplung der Schrittzahl ungefähr um den Faktor vier.
Worin sich die Kodierungen unterscheiden, sind die Kosten, und der Zielkonflikt verdient es, klar benannt zu werden. Die Flow-Menge braucht mehr verschränkende Gates: 22 gegenüber 18 bei einem Schritt. Das Ancilla ist nicht der Grund, da es kein eigenes Zwei-Qubit-Gate trägt. Der Grund ist die Wechselwirkung, genau wie Schritt 3 warnte: Die Delokalisierung der Parität macht aus drei ZZ-Termen zwischen nächsten Nachbarn sieben, die nächste und übernächste Nachbarn überspannen, und jeder kostet zwei CX-Gates. Das ist der Preis dafür, das Hopping günstig zu machen.
Bei der Tiefe gewinnt sie in dieser Größe ebenfalls nur knapp (12 gegenüber 14), weil vier Moden zu klein sind, als dass sich die Asymptotik zeigen könnte. Entscheidend ist die in Schritt 8 gemessene Skalierung: Diese Tiefe von 12 ist konstant, während die Jordan-Wigner-Tiefe mit der Kette wächst. Bei 14 Moden steht es bereits 12 gegen 34.
Die obigen decompose()-Aufrufe sind aus zwei voneinander unabhängigen Gründen unerlässlich.
evolve() und Operator verwenden die exakte Definition eines PauliEvolutionGate und umgehen damit eine benutzerdefinierte qubitseitige Synthese. Eine Überprüfung gegen ein nicht zerlegtes Circuit meldet selbst bei einer absichtlich falschen Synthese perfekte Fidelität.
Dasselbe gilt eine Ebene höher für die fermionische Synthese. Ein Evolution-Gate, das nie zerlegt wird, geht als Ganzes an die Fermion-zu-Qubit-Stufe, die es abbildet, ohne Evolution.synthesis überhaupt zu konsultieren, sodass reps stillschweigend keine Wirkung hätte. trotter_steps aus Schritt 5 führt diese Zerlegung durch; eine Pipeline, die die Methode mit F2FSynthesis festlegt, erhält dieselbe Entwicklung stattdessen vom Pass.
Als abschließende Gegenprobe müssen die Platzdichten , im kodierten Raum berechnet, das Jordan-Wigner-Ergebnis reproduzieren. Diese Prüfung betrifft die Kodierung, nicht das Circuit, sodass keine Trotter-Näherung eingeht. Beide Zeitentwicklungen werden exakt berechnet, durch Matrixexponentiation der jeweiligen Hamiltonoperatoren. Jede Abweichung würde daher auf die Kodierung und nicht auf eine Produktformel hindeuten:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Die Dichten stimmen auf zehn Dezimalstellen überein.
Was du mitnehmen solltest
-
Vor dem Abbilden gruppieren. Flow-Mengen sind auf dem gerichteten fermionischen Wechselwirkungsgraphen definiert, sodass die Gruppierung gewählt wird, solange die Problemstruktur noch verfügbar ist. Das Attribut
groupsträgt sie ins Circuit, wo ein einzigesdecompose()sie in einEvolution-Gate pro Flow-Menge verwandelt. -
Ancillas erkaufen Struktur. Ein zusätzliches Qubit zu investieren verwandelt eine ganze Flow-Menge in Paulis mit Gewicht 1, deren Evolution keine verschränkenden Gates braucht. Ref. [1] beobachtet diesen Zielkonflikt ganz allgemein. Größere Verhältnisse von Qubits zu Fermionen erlauben flachere Evolutions-Circuits.
-
Eine benutzerdefinierte Kodierung ist eine Funktion. Bilde einen einzelnen verallgemeinerten Transferoperator auf eine Pauli-Zeichenkette ab;
map_transfer_vertex_generators()undMapperFnEvolutionSynthesiserledigen den Rest. -
Die Abbildung und die Gruppierung allein genügen nicht. Die Evolution pro Flow-Menge aufzuteilen verlangsamte nur das lineare Wachstum der Tiefe; eine termweise Synthese jeder Menge verschenkte weiterhin die Tatsache, dass ihre Terme kommutieren. Erst eine Flow-Mengen-bewusste
EvolutionSynthesismachte die Tiefe konstant. Benutzerdefinierte Kodierungen, Gruppierung und benutzerdefinierte Synthese ergänzen einander: Alle drei werden benötigt. -
Zwei Produktformeln, zwei Aufgaben.
FermionicLieTrotterlegt die Näherung im fermionischen Raum fest, wo die Gruppierung noch sichtbar ist, und bestimmt daher allein den Trotter-Fehler und die Schrittanzahl. Die qubitseitigeEvolutionSynthesisentscheidet dann nur, wie günstig jede Menge realisiert wird: Schritt 9 bestätigt, dass beide Entscheidungen dieselbe Unitäre ergeben. Die Trennung beider ermöglicht es, Genauigkeit und Kosten unabhängig voneinander einzustellen. Siehe Eine Evolution-Gate im fermionischen Raum synthetisieren. -
Überprüfe es. Eine Kodierung, die die Kommutationsrelationen erfüllt, kann dennoch einen anderen Hamiltonoperator darstellen, wenn ein Vorfaktor oder ein Vorzeichen nicht stimmt. Die Prüfung einer Verschränkungsrelation (oder, günstiger, des Spektrums) fängt das ab.
Das obige FlowSetSynthesis ist bewusst für diese Kodierung auf einer 1D-Kette geschrieben. Es gleicht die spezifischen Pauli-Labels, die die Kodierung erzeugt, per Mustervergleich ab und löst bei allem anderen einen Fehler aus, statt stillschweigend auf eine generische Produktformel zurückzufallen. Eine allgemeine Implementierung hat zwei Hälften. Die Flow-Mengen-Struktur aus den groups des Operators zu lesen ist das, was ein F2FSynthesisPlugin für eine Evolution bereits tut. Das diagonalisierende Clifford aus der Stabilisatorgruppe abzuleiten, wie in Abschnitt IV C von Ref. [1] beschrieben, ist die Hälfte, die kodierungsspezifisch bleibt.
Außerdem macht die Delokalisierung der Parität den Wechselwirkungsterm zu einem Term mit Gewicht 2 statt diagonal in einzelnen Qubits, was das Gegenstück zu den günstigeren Hopping-Termen ist.
Als Nächstes: zwei Dimensionen
Alles oben ist eindimensional, und zwar mit Absicht. Auf einer Kette sind die Flow-Mengen nur die beiden Pfeilorientierungen, und die Kodierung braucht ein einziges Ancilla. Keine dieser Vereinfachungen überlebt in zwei Dimensionen, und dort werden lokale Kodierungen benötigt.
Auf einem planaren Gitter ist eine Flow-Menge ein gerichteter Pfad (oder eine Vereinigung knotendisjunkter gerichteter Pfade) durch den Wechselwirkungsgraphen, und eine kleine Menge solcher Pfade zu finden, die jede Kante abdeckt, wird zu einem eigenständigen kombinatorischen Problem statt einer zweizeiligen Klassifikation. Auch die Kodierungen ändern ihren Charakter; statt eines einzelnen Ancillas für die ganze Kette fügen sie eines pro Gitterplatz oder Zelle hinzu. Verstraete-Cirac koppelt jeden fermionischen Platz an sein eigenes Hilfs-Qubit, ein Verhältnis von Qubits zu Moden von , während Derby-Klassen eines in die Mitte jeder ungeraden Plakette setzt, für ein Verhältnis von . Das Register-Layout hat dann echte zweidimensionale Struktur, und die Stabilisatorgruppe, auf die projiziert werden muss, ist nicht mehr trivial. Der kodierte Hamiltonoperator ist nur auf einem Unterraum treu, was sowohl die Zustandspräparation als auch das Verifikationsrezept aus Schritt 4 verändert.
Die Bausteine, die diese Anleitung aufbaut, sind jene, die übertragbar sind: CustomF2QLayout für ein Register, dessen Größe von der Modenanzahl abweicht, map_transfer_vertex_generators() für die Kodierung selbst, MapperFnEvolutionSynthesis zum Einbinden in den Transpiler und eine benutzerdefinierte EvolutionSynthesis, damit sich die Flow-Mengen-Struktur auszahlt. Nur die Kodierung und die Flow-Mengen-Zerlegung sind anders.
Die 2D-Flow-Mengen-Anleitung knüpft hier an und arbeitet die Verstraete-Cirac-Kodierung auf einem quadratischen Gitter durch: vier Flow-Mengen, ein Clifford der Tiefe 2 für jede und die Stabilisatorprojektion, die die Verifikation dann benötigt.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.