Simuliere die Bose-Hubbard-Dynamik mit frei wählbarer Kodierung
Dieser Leitfaden baut ein Circuit für die Zeitdynamik des eindimensionalen Bose-Hubbard-Modells auf, vom Aufstellen des Hamiltonoperators bis zum Vergleich der entwickelten Platzdichten mit einer exakten Referenz. Interessant wird dieser Weg durch eine einzige Idee:
Wähle beim Aufbau des Circuits keine Boson-zu-Qubit-Kodierung. Baue das Circuit auf bosonischen Moden auf und lass den Transpiler entscheiden, wie diese Moden zu Qubits werden.
Bei Bosonen musst du die Kodierung fast immer aufschieben. Eine bosonische Mode kann beliebig viele Teilchen aufnehmen, ihr Fock-Raum ist also unendlichdimensional, und es gibt keine Kodierung, bevor du nicht zuerst eine Trunkierung wählst (die Anzahl der Besetzungsniveaus, die du beibehältst). Im Code wird die Trunkierung als größte Besetzung angegeben, die eine Mode halten kann, max_occupation ; eine Mode, die die Niveaus beibehält, hat also max_occupation = 2 und .
Damit ist die Trunkierung ein Parameter der Kodierung, nicht der Physik, und es ist ein Parameter, den du variieren möchtest: Ist er zu klein, ist das Ergebnis falsch, ist er zu groß, ist das Circuit unnötig breit. Wenn du die Kodierung auf die Transpile-Zeit verschiebst, kannst du die Trunkierung durchfahren, ohne das Circuit, den Hamiltonoperator oder die Gruppierung zu ändern.
Der Operatoren-Leitfaden für die Datenstruktur der Operatoren, der Mapper-Leitfaden für die Kodierungen und das Rezept zum Schreiben eines eigenen Mappers sowie der Transpilations-Leitfaden für die durchgehend referenzierten Transpiler-Stufen.
Trunkierung und ihre Kosten
Wenn du eine Mode auf Niveaus trunkierst, verletzt du den kanonischen Kommutator auf dem höchsten beibehaltenen Niveau [1], sodass keine Kodierung ein Isomorphismus von Algebren ist: Eine bosonische Kodierung bildet Zustände und Operatoren ab, die innerhalb des trunkierten Unterraums wirken. Zwei Konsequenzen sind für alles Folgende wichtig:
-
muss die durch die Dynamik erreichbare Besetzung beschränken, nicht nur die des Anfangszustands.
-
Die Abbildung vertauscht nicht mit der Normalordnung. Entscheide daher einmal, ob dein Hamiltonoperator in normalgeordneter Form definiert ist, und bleibe dabei konsistent.
Der Mapper-Leitfaden leitet den Defekt her und zeigt beide Konsequenzen an laufendem Code.
1. Der Hamiltonoperator
Das Bose-Hubbard-Modell auf einem Gitter mit Bindungen lautet
mit . Die Wechselwirkung zählt Paare von Bosonen auf einem Platz, sodass ein Platz zwei Teilchen gleichzeitig halten muss. Normalgeordnet gilt , und das ist die im Folgenden verwendete Form.
Die Geometrie geht nur über die Kantenliste ein, daher ist nichts spezifisch für eine Kette:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Zwei Eigenschaften sind zuerst einer Prüfung wert. Der Hamiltonoperator muss hermitesch sein, damit unitär ist, und er erhält die gesamte Bosonenzahl:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Nun die bosonische Frage: Wie viele Niveaus verlangt dieser Operator?
>>> hamiltonian.max_occupation()
2
Der Wechselwirkungsterm wendet zwei Erzeugungsoperatoren auf eine Mode an, daher muss eine Mode zwei Bosonen halten können, damit der Term überhaupt wirkt. Das ist eine maximale Besetzung von 2, und diese Zahl übernimmt LevelSpec als max_occupation. Eine Mode, die die Besetzungen beibehält, hat Niveaus, sodass max_occupation >= 2 dieselbe Anforderung ist wie .
Das ist nur eine untere Schranke: Sie ergibt sich aus einer einzelnen Anwendung des Operators, und die wiederholte Anwendung über eine Zeitentwicklung kann weiter reichen. Sie schließt Cutoffs aus, die mit Sicherheit zu klein sind, und Schritt 6 klärt für dieses Modell und diesen Zustand, wie groß der Cutoff sein muss. mode_occupations() meldet die Schranke für jede Mode einzeln, womit ein Cutoff pro Mode verglichen wird.
2. Gruppieren vor dem Abbilden
Die Zeitentwicklung wird per Trotter-Zerlegung ausgeführt, und die Art der Partitionierung des Hamiltonoperators bestimmt, was der Synthese übergeben wird. Zwei Überlegungen weisen in dieselbe Richtung.
Erstens eine physikalische: Der einzelne Hüpfterm ist nicht hermitesch. Nur das Paar ist es. Wenn du unter einem einzelnen nicht hermiteschen Term entwickelst, ist die Operation nicht unitär, und der abgebildete Operator würde komplexe Koeffizienten tragen, die PauliEvolutionGate zurückweist. Die beiden Hüpfterme jeder Bindung müssen daher zusammenbleiben.
Zweitens eine der Effizienz: Alle On-Site-Wechselwirkungsterme sind in der Besetzungsbasis diagonal und kommutieren untereinander, sodass sie sich eine einzige Gruppe teilen und gemeinsam synthetisiert werden können. Dasselbe gilt für Bindungen, die keinen gemeinsamen Platz berühren. Auf einer Kette ist jede zweite Bindung eine solche Menge: Die Bindungen 0 und 2 wirken auf disjunkte Modenpaare, daher kommutieren ihre Hüpfterme und können sich eine Gruppe teilen, und Bindung 1 bildet eine eigene Gruppe. Wenn du die geraden und die ungeraden Bindungen gruppierst, brauchst du daher drei Gruppen, während eine Gruppe pro Bindung vier benötigt. Weniger Gruppen bedeuten weniger Faktoren und auch ein flacheres Circuit: Mit dem Gray-Code bei max_occupation = 2 beträgt die Zwei-Qubit-Tiefe 95 gegenüber 139. Das Gitter entscheidet, welche Bindungen sich eine Gruppe teilen können, weshalb die Partition hier gewählt wird.
Das Attribut groups trägt diese Entscheidung in das Circuit: Ein Evolution-Gate über einem gruppierten Operator zerfällt in eine Teilentwicklung pro Gruppe. Die Partition wird auf bosonischer Ebene gewählt, solange die Gitterstruktur noch sichtbar ist, und sie bleibt bei der Abbildung unberührt erhalten. Der Gruppierungs-Leitfaden behandelt die Prüfungen, die eine Gruppierung bestehen sollte.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Jede Gruppe muss selbst hermitesch sein, und genau das leistet die vorangehende Paarung. groups_are_hermitian() prüft alle Gruppen in einem Aufruf:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Um zu sehen, was jede Gruppe enthält, trenne die Gruppen:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Die Gruppierung in gerade und ungerade Bindungen ist eine Wahl, und die Alternative lässt sich leicht messen. Wenn du jeder Bindung eine eigene Gruppe gibst, brauchst du vier Gruppen, und dasselbe Circuit kostet dann mehr Zwei-Qubit-Tiefe. Die Tiefe wird gezählt, nachdem das Circuit mit dem Gray-Code bei max_occupation = 2 heruntergebrochen wurde, was Schritt 4 erklärt:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Das bosonische Circuit
Beachte, was im Circuit fehlt. Es gibt keine Trunkierung, keine Kodierung und keine Qubit-Anzahl. Es wirkt auf vier bosonische Moden:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Die Leitungen sind bosonische Moden, keine Qubits. Beachte, dass InitializeModes ganze Zahlen entgegennimmt, keine Flags: Eine Mode kann beliebig viele Bosonen halten, daher ist ein Fock-Zustand eine Liste von Besetzungszahlen.
Ein einziges decompose() macht aus der Gruppierung aus Schritt 2 ein Gate pro Gruppe:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
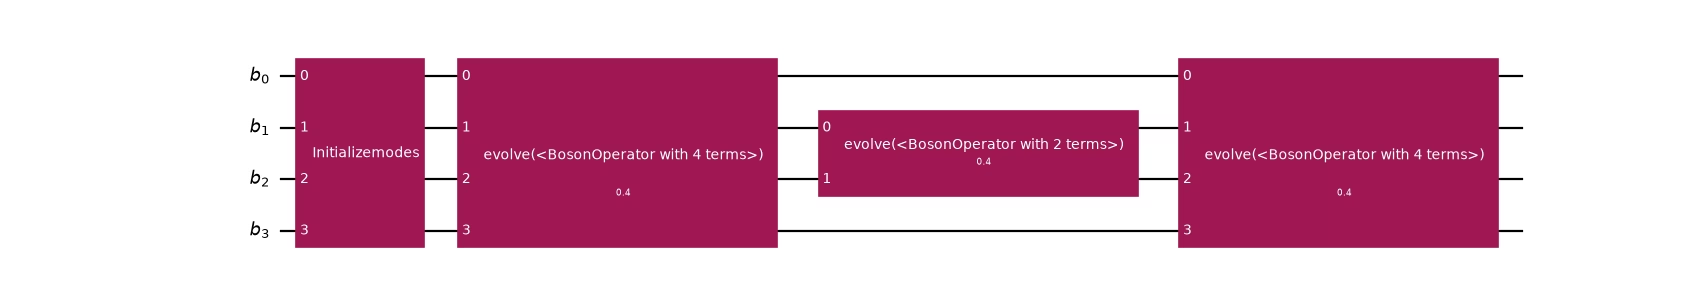
Die erste Gruppe enthält die Bindungen auf den Moden 0 und 1 sowie auf den Moden 2 und 3, daher erstreckt sich ihr Gate über alle vier Moden, und das gilt auch für die On-Site-Gruppe. Die mittlere Bindung hat ein eigenes Gate auf den Moden 1 und 2.
Überspringst du diese Zerlegung, wird die Gruppierung einfach ignoriert. Welche Methode die Aufteilung vornimmt, ist die synthesis des Gates, mit BosonicLieTrotter als Standard; Ein Evolution-Gate im bosonischen Raum synthetisieren zeigt die Alternativen.
4. Die Kodierung zur Transpile-Zeit wählen
Hier zahlt es sich aus. Dasselbe Circuit wird viermal unter vier verschiedenen LevelEncoding-Werten heruntergebrochen, indem ein Argument geändert wird. Eine LevelSpec koppelt die Kodierung mit der Trunkierung jeder Mode, und das folgende Preset leitet Layout, Zustandspräparation und Operatorabbildung aus dieser einen Spezifikation ab (siehe Die Trunkierung mit einer LevelSpec beschreiben). Ein String wie "gray" wird überall akzeptiert, wo eine LevelEncoding erwartet wird.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Diese Zahlen widersprechen einer naheliegenden Vermutung. Die unären Kodierungen verwenden Qubits pro Mode gegenüber bei den kompakten Codes, und bei gewinnen die kompakten Codes auf beiden Achsen zugleich: weniger Qubits und deutlich weniger verschränkende Gates. Die beiden unären Varianten unterscheiden sich im emittierten Operator, nicht in ihrem Layout: LevelEncoding.UNARY_PROJECTED trägt einen Projektor auf jedem zweiten Qubit einer Mode, was sie zur teuersten der vier Varianten in der Entwicklung macht, und LevelEncoding.UNARY_UNPROJECTED lässt die Projektoren weg und stimmt auf dem One-Hot-Unterraum mit ihr überein. Der Mapper-Leitfaden zeigt die beiden Operatoren nebeneinander und erklärt, warum der Gray-Code bei den Hüpftermen den Standard-Binärcode (SB) schlägt.
Sawaya et al. berichten dieselbe Rangfolge [2]:
Obwohl der Unär-Code tendenziell mehr Qubits, aber weniger Operationen benötigt, ist der SB- oder Gray-Code oft sowohl hinsichtlich der Qubit-Anzahl als auch der Anzahl der Operationen effizienter
Ihr Fazit ist, dass der beste Code vom Hamiltonoperator und von abhängt, was das stärkste Argument dafür ist, die Wahl nicht im Circuit festzulegen.
Unter einer Level-Kodierung erstreckt sich eine Mode über mehrere Qubits, daher ist das Qubit-Register breiter als das Moden-Register. Das Preset verwendet OccupationB2QLayout, das die Registerbreite aus der LevelSpec ableitet. Der Transpilations-Leitfaden führt durch die Stufen, die das Preset durchläuft.
5. Gegen die exakte Dynamik verifizieren
Keiner der vorangehenden Schritte belegt, dass das Circuit korrekt ist. Vergleiche dafür die Platzdichten nach der Entwicklung mit einer exakten Referenz, die auf dem kodierten Hamiltonoperator berechnet wird.
Die Referenz muss im selben trunkierten Raum berechnet werden, in dem das Circuit arbeitet, denn ein Vergleich mit einer untrunkierten Rechnung würde Trotter-Fehler und Trunkierungsfehler vermischen, die verschiedene Dinge sind und getrennt werden sollten (siehe Den Fock-Raum trunkieren).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Damit ergibt sich die exakte Entwicklung im trunkierten Raum:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Die Bosonen breiten sich vom besetzten Ende der Kette zum leeren hin aus, und die beiden Bosonen bleiben erhalten:
>>> bool(np.isclose(sum(reference), 2.0))
True
Nun das Circuit. Beachte, dass die vorangehende Referenz direkt aus initial aufgebaut wurde, sodass das damit verglichene Circuit nur die Zeitentwicklung enthalten darf, denn das Gate InitializeModes würde einen bereits präparierten Zustand erneut präparieren.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
Der Fehler halbiert sich, wenn sich die Schrittzahl verdoppelt, was die -Signatur einer Produktformel erster Ordnung ist. Das belegt, dass die Abweichung ein Trotter-Fehler ist und die Kodierung korrekt arbeitet.
Die Wiederholungen stammen aus der synthesis des Gates, das im bosonischen Raum trotterisiert, wo die Gruppierung noch existiert: Jeder Schritt wendet jede Gruppe einmal an, und die Schritte folgen aufeinander. Das ist etwas anderes, als ein LieTrotter mit reps > 1 an das Synthese-Plugin auf Qubit-Ebene zu übergeben. Dort ist jede Gruppe bereits ein eigenes PauliEvolutionGate, sodass die Formel nur die Terme innerhalb einer Gruppe weiter unterteilt und die Gruppen nie verschränkt abwechselt. Die Gruppen kommutieren nicht untereinander, was einen einzigen äußeren Trotter-Schritt übrig lässt, dessen Fehler nicht kleiner wird, wie groß reps auch ist. Ein Evolution-Gate im bosonischen Raum synthetisieren vergleicht die beiden und behandelt höhere Ordnungen.
Der vorangehende Aufruf von decompose() ist unerlässlich. evolve() verwendet die exakte Definition eines PauliEvolutionGate und umgeht die Produktformel vollständig. Wenn du gegen ein nicht zerlegtes Circuit verifizierst, siehst du selbst bei einer absichtlich falschen Synthese eine nahezu perfekte Übereinstimmung. Das nicht zerlegte Circuit zwingt außerdem dazu, einen dichten -Operator aufzubauen, während ein zerlegtes Circuit Gates einzeln anwendet. Andere Simulatoren können das Gate anders behandeln, daher hängt diese Prüfung vom Simulator ab, während Hardware immer die zerlegte Form benötigt.
Schließlich die zentrale Prüfung: Die Physik darf nicht davon abhängen, welche Kodierung gewählt wurde.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Die Qubit-Anzahlen, Pauli-Strukturen und Circuit-Tiefen unterscheiden sich alle, und die Physik stimmt auf zehn Dezimalstellen überein. Die Kodierung ist eine Implementierungsentscheidung, weshalb sie in den Transpiler gehört. Die beiden unären Varianten stimmen hier überein, weil der simulierte Zustand im One-Hot-Unterraum bleibt; außerhalb davon würden sie sich unterscheiden.
6. Die Trunkierung ist ein Konvergenzparameter
Der letzte Schritt ist spezifisch für Bosonen. Bisher war überall max_occupation = 2 festgelegt, also . Die Trunkierung ist jedoch keine freie Wahl: Sie ist ein Konvergenzparameter, und ein Ergebnis ist erst vertrauenswürdig, wenn es sich nicht mehr verändert (siehe Den Fock-Raum trunkieren).
Das Circuit trägt keine Trunkierung, sodass sich das Circuit selbst nicht ändert, wenn sich der Cutoff ändert: Nur die Transpilation wird wiederholt. Was sich ändert, ist die Größe des Ergebnisses, und ein Sweep ist nur deshalb so günstig wie hier, weil das System winzig ist. Die folgende Referenz ist eine exakte klassische Simulation der trunkierten Dynamik, die für vier Plätze möglich ist und exponentiell mit der Anzahl der Qubits wächst. Für ein Problem jenseits dieser Reichweite gibt es keine exakte Referenz zum Vergleich, und die Konvergenz muss mit anderen Mitteln beurteilt werden.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
Bei max_occupation = 1 () hält jeder Platz höchstens ein Boson, sodass der Wechselwirkungsterm, der zwei auf einem Platz benötigt, überhaupt nicht wirken kann und die Dichten um etwa abweichen. Fügst du das dritte Niveau hinzu, erfasst das Ergebnis die Wechselwirkung, und ab max_occupation = 3 ist das Ergebnis bis auf Maschinengenauigkeit stationär: konvergiert.
Der Grund, weshalb es bei max_occupation = 2 aufhört, ist die Teilchenzahl. Der Hamiltonoperator erhält die Anzahl der Bosonen, und dieser Zustand enthält zwei, sodass kein Platz je mehr als zwei halten kann, unabhängig von der Entwicklungszeit und davon, ob die Wechselwirkung abstoßend oder anziehend ist. Wenn du bis statt entwickelst oder das Vorzeichen von umkehrst, bleiben die Dichten bei max_occupation = 2 und höher auf unverändert.
Was die Anforderung tatsächlich nach oben treibt, ist die Anzahl der Bosonen. Drei Bosonen auf derselben Kette ändern sich nach derselben kurzen Entwicklung um etwa zwischen max_occupation = 2 und 3, und nach um etwa . Das ist eine Aussage über dieses Modell und eine Erhaltungsgröße, und es ist nur für Operatoren eine Schranke, die die Teilchenzahl erhalten; es ist keine allgemeine Regel, daher muss der Cutoff durchgefahren und nicht geraten werden.
Der Sweep hat auch auf der Circuit-Seite einen Preis, den die exakte Referenz nicht zeigt. Dasselbe bosonische Circuit, bei jedem Cutoff mit dem Gray-Code heruntergebrochen:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Jedes zusätzliche Niveau kostet Tiefe, und die Qubit-Anzahl springt, wann immer eine Zweierpotenz überschreitet. Wenn du in konvergierst, tauschst du daher Genauigkeit gegen Circuit-Größe ein, sodass der Sweep mehr ist als eine numerische Prüfung.
Beachte auch, dass nahezu richtig ist, ist ein Zufall der Observablen: Die Platz-Dichten bewegen sich kaum, während der zugrunde liegende Zustand qualitativ falsch ist (er hat keine doppelt besetzte Komponente). Wenn eine Observable konvergiert, zeigt das nicht, dass eine andere konvergiert ist.
Was du mitnehmen solltest
-
Die Kodierung ist ein Anliegen des Transpilers. Der bosonische Circuit in Schritt 3 erwähnt weder Trunkierung noch Kodierung noch eine Qubit-Anzahl. Vier Kodierungen haben ihn dann in vier verschiedene Circuits überführt, die alle dieselbe Physik reproduzieren. Vor dem Transpiler musste nichts geändert werden.
-
Bei Bosonen ist das nicht bloß bequem. Die Trunkierung ist ein Konvergenzparameter, der durchgefahren werden muss, und er steckt in der Kodierung. Ein Circuit, der gegen eine feste Kodierung gebaut wurde, müsste für jeden Wert von neu gebaut werden.
-
Gruppiere vor dem Mapping, und gruppiere im Hinblick auf Hermitizität. Ein einzelner Hopping-Term ist nicht hermitesch und lässt sich nicht exponenzieren; das Bindungspaar dagegen ist hermitesch und lässt sich daher exponenzieren. Lege die Aufteilung auf bosonischer Ebene fest, wo das Gitter noch sichtbar ist. Das ist physikalisch notwendig, und das Attribut
groupsexistiert, um die Entscheidung weiterzutragen. -
Nimm nicht an, dass die Kodierung mit niedrigem Gewicht die günstige ist. Bei schlagen die kompakten Codes beide unären Varianten gleichzeitig bei Qubits und Gates, und die projizierte Variante ist die teuerste von allen. Miss nach; der Wendepunkt hängt von ab.
-
Die Trunkierung bricht die Algebra, und zwar in quantifizierbarer Weise. Nur auf dem obersten beibehaltenen Niveau, um . Das ist auch der Grund, warum das Mapping nicht mit der Normalordnung kommutiert.
Nächste Schritte
Zwei Richtungen erweitern dieses Beispiel. Wenn du die Kantenliste der Kette durch die Bindungen eines quadratischen Gitters ersetzt, brauchst du keine weitere Änderung, da die zuvor definierte Funktion bose_hubbard bereits geometrieunabhängig ist. Eine eigene Kodierung (zum Beispiel ein Block-Unär-Code, der zwischen unär und kompakt interpoliert) lässt sich ebenfalls über dieselbe MapperFnEvolutionSynthesis-Schnittstelle einbinden, die auch das Preset verwendet.
-
Designprinzipien von Operatordarstellungen erklärt die Operator-Datenstruktur hinter dem Hamiltonian.
-
Operatordarstellungen abbilden behandelt die Kodierungen und das Schreiben eines eigenen Mappers.
-
Bosonische Circuits transpilieren führt durch die Stufen, die das Preset durchläuft.
-
Ein Evolution-Gate im bosonischen Raum synthetisieren zeigt, wie du den Trotter-Fehler im bosonischen Raum verringerst.
Jede angegebene Tiefe bezieht sich auf ein abstraktes, vollständig verbundenes Register. Das Mapping auf die reale Hardware-Konnektivität ist eine eigene Stufe, und die Qubit-Blöcke pro Mode einer Besetzungskodierung geben einem Router eine ziemlich andere Struktur zum Arbeiten als ein Qubit pro Mode.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.